[카테고리:] AI & 오픈소스

  • Claude Code의 클로드코드 모드 첫걸음 — 80줄로 만드는 안전장치와 맞춤 UI

    Claude Code의 클로드코드 모드 첫걸음 — 80줄로 만드는 안전장치와 맞춤 UI

    핵심 요약

    • mod는 Claude Code 세션 안에서 한 번 로드되어 상주하는 JS/TS 확장으로, 셸 명령 기반의 기존 훅과 달리 상태를 유지하면서 이벤트를 관찰·중재하고 맞춤 UI를 표시할 수 있음
    • 프롬프트 제출, 도구 호출, 턴과 세션의 시작·종료, UI 렌더링 등 다단계 이벤트에 훅을 연결할 수 있으며, 이벤트를 그대로 넘기거나 입력을 수정하거나 직접 처리하는 세 가지 모드를 지원함
    • Claude Code의 AGENTS.md 지원과 /diff 패널도 mod로 구현되어 있어, mod가 단순 부가 기능이 아닌 핵심 UI 컴포넌트의 기반이라는 점이 확인됨

    mod는 단순 테마가 아니라 세션에 상주하면서 이벤트를 관찰·중재하고 UI까지 다시 그릴 수 있는 Claude Code의 ‘두 번째 운영체제 레이어’이며, 핵심은 원하는 동작을 자연어로 묘사하고 $.state에 상태를 두는 것만으로 안전 가드, 비용 표시, 워크플로우 검수를 즉시 추가할 수 있다는 점임

    목차

    Claude Code를 본격적으로 쓰기 시작하면 가장 먼저 부딪히는 불만은 “이 화면을 내 워크플로우에 맞게 조금만 바꿀 수 없을까”입니다. ~/.claude/hooks.json에 셸 스크립트를 걸어 안전장치를 만드는 방식은 익숙하지만, 매번 외부 프로세스를 띄워야 하고 상태를 유지할 방법이 없으며 UI까지 건드릴 수는 없습니다. 바로 그 자리에 들어온 것이 클로드코드 모드(mod)입니다. 2.1.287 버전부터 별도 활성화 없이 기본 지원되며, AGENTS.md와 /diff 패널이 이미 mod로 구현되어 있다는 사실이 그 위상을 잘 보여줍니다.

    개념 정리: 어떤 이벤트를 어디까지 가로챌 수 있는가

    mod는 세션이 살아 있는 동안 한 번 로드되어 상주하는 JS/TS 확장입니다. 프롬프트 제출, 도구 호출, 턴과 세션의 시작·종료, UI 렌더링 같은 다단계 이벤트에 훅을 걸 수 있고, 이벤트를 그대로 흘려보낼지(observe), 입력을 수정해 넘길지(intervene), 아니면 직접 처리해 종료할지(consume) 선택할 수 있습니다. 일반 플러그인과 동일한 manifest와 훅 모듈 구조를 따르지만, 클로드코드 모드만의 결정적 차이는 셸이 아니라 V8 같은 임베디드 런타임 안에서 돌아간다는 점입니다. 덕분에 컨텍스트 사용량을 그래프로 그리고, 위험 명령 실행 직전에 영향 범위를 시각화하고, 변경된 파일을 한 턴 단위로 되짚는 일이 전부 사용자가 만든 작은 모듈로 가능해집니다.

    사례 1: Token Weather — 80줄짜리 컨텍스트 날씨 예보

    약 80줄짜리 Token Weather는 mod가 얼마나 간결할 수 있는지를 보여주는 예시입니다. 모듈은 매 턴의 토큰 사용량을 $.state에 누적하고, 컨텍스트 한도 대비 비율을 날씨로 매핑합니다 — 50% 미만은 맑음, 70% 근처는 흐림, 85%부터 소나기, 95% 이상은 폭풍. 프롬프트 입력란 위에 미니 차트(최근 12턴)와 함께 직전 턴 대비 증감량을 표시하고, 임계치를 넘으면 “/compact를 권장합니다” 같은 안내를 함께 띄웁니다. 상태를 보존하지 못하면 매 핫 리로드마다 차트가 0으로 리셋되는데, 이 함정에 빠지지 않으려면 모듈 변수가 아니라 $.state에 두는 것이 핵심입니다. 필자가 첫 mod를 만들 때 가장 자주 놓친 부분이 바로 이 지점이었습니다.

    사례 2: Blast Radius — 위험 명령 직전의 영향 시각화

    rm -rf, git reset –hard, git push –force, prisma migrate deploy 같은 명령은 실행한 뒤에는 되돌리기 어렵습니다. Blast Radius는 도구 호출 직전에 훅을 걸어 위험 패턴을 식별하고, 그 시점의 git status, 변경 파일 수, 푸시 대상 브랜치 같은 영향을 옆 패널 또는 프롬프트 위 모달로 정리해 보여줍니다. 터미널 폭이 좁아지면 자동으로 상단 배너로 전환되는 반응형 레이아웃도 모듈 안에서 처리합니다. 승인 버튼을 누르기 전에는 도구가 실행되지 않습니다.

    다만 별칭이나 회사 내부 래퍼 스크립트는 문자열 매칭으로 절대 다 잡히지 않습니다. 차단이 필요한 작업은 settings.json의 permissions.allow/deny에 별도로 등록해 두는 편이 안전합니다. Blast Radius는 “주의 환기”까지 책임지고, 차단 자체는 권한 레이어가 맡는 역할 분담이 권장 구성입니다.

    사례 3: Replay Theater — 한 턴의 변경을 단계별로 되짚기

    한 턴 안에서 Edit/Write가 여러 번 호출되면, 어떤 파일이 어떤 순서로 어떻게 바뀌었는지 머릿속으로 따라가기 어렵습니다. Replay Theater는 Edit/Write 이벤트를 가로채 파일명·변경 전·변경 후 스냅샷을 배열에 쌓고, r 또는 /replay를 누르면 단계별 diff 패널을 옆에 띄웁니다. Blast Radius처럼 실행을 막지는 않고, 관찰과 검수에만 집중합니다. 코드 리뷰 문화가 강하지 않은 팀에서 PR 직전 self-review 단계로 쓰면 효과가 큽니다.

    현업에서 가장 흔히 놓치는 함정은 “이벤트 객체에 들어 있는 file_path와 old_content가 비어 있을 수 있다”는 점입니다. Read 이후의 Edit는 old_content가 보장되지 않으므로, 빈 문자열을 그대로 diff 뷰어에 넘기지 않고 플레이스홀더로 표시하는 식의 방어 코드가 필요합니다.

    직접 만들기: 자연어 한 줄로 시작하는 워크플로

    mod를 만드는 절차는 의외로 평범합니다. 빈 폴더에서 claude –plugin-dir ./my-first-mod를 실행해 세션을 띄우고, “프롬프트 위에 컨텍스트 사용량을 그래프로 보여줘”라고 자연어로 설명하면 Claude Code가 manifest와 훅 모듈을 직접 작성합니다. 파일을 저장하는 순간 플러그인이 핫 리로드되어 세션을 재시작하지 않아도 바로 반영됩니다. UI가 보이지 않으면 claude –debug로 로그를 따라가면 어떤 이벤트 단계에서 실패했는지 짚을 수 있습니다.

    작업이 끝났다면 claude plugin validate로 manifest 계약과 타입을 정적으로 검증하고, claude plugin test로 실제 런타임에서 동작을 확인합니다. 릴리스마다 API 시그니처가 조금씩 바뀌기 때문에, .claude-plugin/types/에 그 버전의 타입 선언이 생성된다면 그걸 기준으로 import해서 쓰면 타입 안정성을 확보할 수 있습니다.

    상태 관리와 디버깅: $.state가 답이다

    핫 리로드 이후에도 살아남아야 하는 데이터는 무조건 $.state에 둡니다. 모듈 최상위 변수로 배열을 선언해 두면 reload 순간 GC 대상이 되어 초기화되지만, $.state는 Claude Code 런타임이 명시적으로 보존해주는 영역입니다. 토큰 누적, 최근 변경 이력, 사용자가 고정한 임계치 같은 값은 전부 이쪽으로 모아야 합니다. UI가 아예 그려지지 않는다면 1) manifest의 event 등록 키 오타, 2) 타입 정의 누락으로 인한 require 실패, 3) 모듈 export 누락을 순서대로 확인합니다. 이 세 가지가 실제로 디버깅 시간의 대부분을 차지합니다.

    배포와 보안: 게시자 신뢰가 곧 통제 수단이다

    세션 안에서 만들어진 mod는 기본적으로 그 세션에만 로드됩니다. 계속 쓰려면 ~/.claude/plugins/ 아래 폴더로 복사하거나, GitHub에 마켓플레이스 파일을 함께 두고 등록해 /reload-plugins로 재로드해야 합니다. 일반 플러그인과 같은 워크플로라서 Claude 디렉터리에도 그대로 제출 가능합니다.

    여기서 짚고 넘어가야 할 것이 보안입니다. mod는 게시자 코드가 Claude Code 본체와 동일한 권한으로 사용자 컴퓨터에서 실행됩니다. 사용자 컴퓨터에서 직접 코드가 실행된다는 점은 온디바이스 AI 워크플로에서도 핵심 통제 포인트로 반복되는 사안이라, mod의 권한 모델을 다룰 때도 같은 기준으로 검토하는 것이 안전합니다. Cantina의 apex-flash-1 사례가 보여주듯 신뢰할 수 없는 코드가 임의 권한을 얻는 경로는 정적 분석 한 번으로 막기 어렵습니다. 게시자 신뢰, 소스 검토, 최소 권한 원칙을 항상 병행해야 합니다.

    마무리: 오늘 짜증 난 한 가지 동작부터 감싸자

    클로드코드 모드는 “두 번째 운영체제 레이어”라는 표현이 과장되지 않습니다. 원하는 동작을 자연어로 묘사하고 상태를 $.state에 두는 것만으로 안전 가드, 비용 표시, 워크플로우 검수를 바로 붙일 수 있기 때문입니다. 비용/한도 표시, 팀 규칙 주입, K8s 컨텍스트 확인, Terraform 적용 전 검토 같은 아이디어는 전부 첫 mod를 만든 다음 주말이면 충분합니다. 처음부터 거대한 플러그인을 설계하려 하지 말고, 오늘 짜증 났던 한 가지 동작부터 80줄짜리 모드로 감싸 보는 것이 가장 빠른 길입니다. 더 많은 예제와 시연 영상은 원문 가이드에서 확인할 수 있습니다.

    지금 바로 해볼 것

    • mkdir my-first-mod && cd my-first-mod으로 빈 폴더를 만들고 claude –plugin-dir .로 세션을 띄운 뒤 “프롬프트 위에 컨텍스트 사용량을 그래프로 그려줘”라고 한 줄 요청해 manifest와 훅 모듈이 자동 생성되는지 확인한다.
    • 생성된 훅 모듈에서 누적 카운터를 모듈 변수가 아닌 $.state에 저장하도록 고치고, 파일 저장 직후 핫 리로드로 차트가 0으로 리셋되지 않는지 검증한다.
    • 위험 명령 가드가 필요하면 hooks 모듈에 PreToolUse 훅을 걸어 “rm -rf”·”git push –force”·”prisma migrate deploy” 패턴을 매칭하고, 매칭 결과를 모달로 띄우는 30줄짜리 가이드를 추가한다. 본 차단이 필요하면 settings.json의 permissions.deny에 같은 패턴을 별도 등록한다.
    • claude plugin validate ./my-first-mod로 manifest와 타입 계약을 정적으로 검사하고, claude plugin test ./my-first-mod로 실제 런타임에서 이벤트 흐름이 의도대로 흘러가는지 회귀 테스트를 만든다.
    • 작업이 끝나면 모듈을 ~/.claude/plugins/로 복사하거나 GitHub 마켓플레이스 파일과 함께 등록한 뒤 /reload-plugins로 영구 적용 여부를 확인한다.

    자주 묻는 질문

    기존 hooks.json에 등록한 셸 스크립트와 mod는 어떻게 나눠 쓰나요?

    상태 없이 한 줄짜리 가드(예: 위험 명령 차단, 로그 적재)만 필요하다면 hooks.json의 셸 훅이 가볍고 충분합니다. 세션이 살아 있는 동안 누적된 컨텍스트를 보여주거나, 도구 호출을 중재하거나, UI를 그려야 한다면 mod로 옮기는 편이 낫습니다. 권한 거부는 결국 settings.json의 permissions가 가장 신뢰할 수 있는 레이어라서, 차단 자체는 셸 훅이나 mod가 아니라 권한 규칙에 두는 구성을 권장합니다.

    릴리스마다 API가 바뀔까봐 신규 mod 도입을 망설이는데, 안정적으로 가는 방법이 있나요?

    해당 버전으로 로드했을 때 .claude-plugin/types/에 생성되는 타입 선언을 그대로 import해서 쓰고, 이벤트 이름은 상수로 감싸두면 시그니처가 바뀌는 시점에 컴파일 에러로 즉시 잡힙니다. plugin test로 핵심 이벤트 흐름을 시나리오화해 두면 업그레이드 당일 회귀 여부를 빠르게 가려낼 수 있습니다.

    팀 전체에 표준 mod를 배포하려면 어떤 흐름이 현실적인가요?

    사내 GitHub에 마켓플레이스 파일을 포함한 단일 저장소를 두고, 모듈들은 모두 코드 리뷰를 거치게 합니다. 신규 입사자는 등록 명령 한 줄로 동일 세트를 받을 수 있고, 게시자 신뢰가 코드 리뷰 기록으로 남는다는 점이 mod의 강력한 권한을 상쇄하는 핵심 통제입니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — Claude Code 모드(mod) 시작하기
  • 올모코어3, 47B 파라미터에서 5% 미만 처리량 손실 — 올모 스파스 학습 스택의 도약

    올모코어3, 47B 파라미터에서 5% 미만 처리량 손실 — 올모 스파스 학습 스택의 도약

    핵심 요약

    • Olmo-core 3는 대규모 언어모델 개발 프레임워크의 유의미한 업그레이드로, 오픈소스 혼합전문가(MoE) 학습 시스템을 재설계해 공개한 결과물이다.
    • 이 시스템은 활성 파라미터 수를 토큰당 약 3.2B로 거의 고정하면서도, 전문가 풀을 8개에서 128개로 확장하는 벤치마크에서 학습 처리량 감소폭을 5% 미만으로 유지했다.
    • 동일 벤치마크에서 총 파라미터 용량은 4.6B에서 47B로 증가했고, 같은 인프라가 1조(1 trillion) 파라미터 이상의 규모에서도 검증되었다.

    분석

    목차

    올모코어3가 공개한 숫자는 단순한 프레임워크 업데이트가 아니다. AllenAI가 내놓은 올모코어3는 활성 파라미터를 토큰당 약 3.2B로 거의 고정한 채 전문가 풀을 8개에서 128개로 16배 늘렸는데, 학습 처리량 감소폭이 5% 미만이었다. 같은 실험에서 총 파라미터 용량은 4.6B에서 47B로 10배 이상 뛰었고, 1조(1 trillion) 파라미터급 구성에서도 같은 스택이 동작하는 것이 확인됐다.

    필자는 이 지점이 가장 의미 있다고 본다. 대규모 MoE 학습의 핵심 비용은 전문가 수를 늘릴 때 발생하는 라우팅·통신 오버헤드인데, 올모코어3는 그 병목을 설계 단계에서 상당 부분 해소했다는 인상을 준다.

    올모코어3의 8→128 전문가 확장

    처리량 5% 미만 손실은 결과만 보면 마법처럼 들린다. 하지만 MoE는 토큰당 일부 전문가만 활성화하는 스파스 모델이라, 활성 파라미터 수가 학습 연산량과 직접 연결된다. 올모코어3가 활성 파라미터를 3.2B 근처에 묶어둔 채 총 파라미터만 키운 것은 학습 FLOPs를 거의 유지하면서 모델 용량만 늘리는 트레이드오프다.

    물론 활성·비활성 전문가의 메모리 상주, 그래디언트 동기화, 라우터 부하 같은 비용이 모두 사라지지는 않는다. 5% 미만 수치를 유지했다는 사실 자체가 부대 비용을 분산시키는 통신 스택과 스케줄러 개선이 일정 수준 이상이라는 뜻이다.

    올모 스파스 학습 스택의 진화

    올모코어3는 단독 출현이 아니다. AllenAI의 스파스 학습 계보는 OlmoE, 즉 64개 라우팅 전문가를 사용한 MoE 구조까지 거슬러 올라간다. Olmo 3가 밀집(dense) 구조로 갈라진 반면, 올모코어3는 다시 스파스 학습 스택을 이어받았다.

    구분 OlmoE Olmo 3 올모코어3
    구조 MoE (64 라우팅 전문가) 밀집(dense) MoE (스파스 학습 스택)
    주요 초점 전문가 라우팅 검증 밀집 학습 최적화 대규모 스파스 인프라
    검증 스케일 중형 중형 밀집 47B ~ 1조 파라미터급
    공개 범위 모델 위주 모델+코드 일부 학습 스택 전체

    실무자가 주목할 행은 마지막 줄이다. 올모코어3는 모델 가중치만이 아니라 학습 스택 자체를 오픈소스로 공개한 점에서 이전 세대와 결이 다르다.

    MoE 딜레마 — 올모코어3 이후의 쟁점

    MoE의 한계는 잘 알려져 있다. 토큰이 일부 전문가만 활성화하기 때문에 더 많은 학습 가능 요소를 담을 수 있지만, 전체 모델은 여전히 GPU 메모리에 상주하고 매 스텝마다 갱신돼야 한다. 총 파라미터가 늘면 메모리·통신 비용이 선형 이상으로 커진다.

    올모코어3의 5% 미만 수치는 이 딜레마가 사라졌다는 뜻이 아니다. 라우팅·통신 비용이 효율성 이점을 잠식하기 직전까지 분산 가능하다는 것을 시연했다는 의미다. 실무자 입장에서 눈에 띄는 건, 이 균형점이 어디까지 버티느냐가 다음 1~2년의 핵심 변수라는 점이다.

    올모코어3가 여는 오픈 인프라

    공개 자체에도 가치가 있다. 1조 파라미터급 학습 스택이 오픈소스로 풀리면 대규모 컴퓨팅을 자체 운용하지 않는 학술 연구진이나 소규모 랩도 동일한 통신·라우팅 패턴을 자기 인프라에 이식할 수 있다. 원문에서 AllenAI 측은 올모코어3 학습 스택의 통신·라우팅 최적화에 집중했다고 밝히고 있다. (올모코어3 발표 노트)

    지금 바로 해볼 것

    • 올모코어3 공개 레포지토리에서 라우팅 스케줄러 코드를 내려받아 8~32 전문가 구성으로 소규모 재현 실험을 설계한다.
    • 자체 MoE 학습 시 GPU 간 all-to-all 통신 로그를 수집해 5% 미만 손실 기준선과 비교한다.
    • OlmoE와 올모코어3의 라우터 손실 곡선을 같은 토큰 수 기준으로 그려 전문가 수 증가가 수렴에 미치는 영향을 점검한다.
    • 1조급 구성 여건이 안 되면 47B에서 활성 파라미터를 3.2B 근처로 묶는 설정을 우선 검증한다.
    • 팀 위키에 올모코어3 도입 검토 페이지를 만들고 메모리 상주 비용과 통신 오버헤드를 별도 섹션으로 추적한다.

    자주 묻는 질문

    올모코어3는 OlmoE와 무엇이 다른가요?

    OlmoE가 64개 라우팅 전문가로 구조를 검증한 세대라면, 올모코어3는 그 스파스 학습 스택을 128개 전문가, 47B~1조 파라미터 규모에서도 동작하도록 다시 설계한 결과물입니다. 공개 범위도 모델에서 학습 인프라로 확장됐습니다.

    5% 미만 처리량 손실은 어떻게 달성했나요?

    활성 파라미터를 토큰당 약 3.2B로 거의 고정한 채 전문가 풀만 늘려 학습 FLOPs 증가를 억제했기 때문입니다. 라우팅·all-to-all 통신 부하를 분산하는 스케줄러 개선이 뒤받춰졌다고 AllenAI 측은 설명합니다.

    소규모 팀도 활용할 수 있나요?

    1조 파라미터 학습을 그대로 재현하기는 어렵지만, 공개된 학습 스택의 통신·라우팅 패턴을 소규모 구성에 이식하는 것만으로도 자체 MoE 파이프라인의 병목을 진단하는 데 충분합니다.

    밀집 모델을 곧 대체할까요?

    단기적으로는 아닙니다. 메모리에 전체 모델을 상주시켜야 하는 MoE의 구조적 한계가 남아 학습 효율과 추론·배포 비용 사이의 트레이드오프는 계속 존재합니다.

    쟁점 정리

    올모코어3가 5% 미만 처리량 손실을 보여준 것은 MoE의 통신·라우팅 비용이 설계로 흡수 가능하다는 첫 신호다. 다만 이 균형점이 1조 파라미터 너머에서도 유지될지는 아직 검증되지 않았고, 총 파라미터 증가에 따른 메모리 상주 비용은 그대로 남는다. 학습 스택이 오픈소스로 풀린 만큼, 다음 1~2년은 다양한 하드웨어 구성에서 이 균형점이 어디까지 버티는지를 외부 연구진이 직접 측정해 줄 구간이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Hugging Face Blog — Introducing Olmo-core 3: Open, scalable training infrastructure for large MoEs

  • 쿠모 타블러, 4개 벤치마크 1위 — 단일 forward pass로 끝내는 엔비디아 오픈 테이블형 파운데이션 모델 정리

    쿠모 타블러, 4개 벤치마크 1위 — 단일 forward pass로 끝내는 엔비디아 오픈 테이블형 파운데이션 모델 정리

    핵심 요약

    • 쿠모 타블러는 라벨된 행들을 컨텍스트로 받아 신규 행의 라벨을 단일 forward pass로 예측하는 오픈 테이블형 파운데이션 모델로, 별도 학습·하이퍼파라미터 튜닝·피처 엔지니어링 없이 분류와 회귀를 모두 수행함
    • 본문 기준 학습 데이터는 인공 데이터(artificial data) 한정으로 구성되었으며, 모델 사이즈는 28M에서 215M 파라미터까지 세 가지 변종이 제공됨
    • 오픈소스 라이브러리 형태로 배포되며 라이선스는 OpenMDW-1.1로 상업적 이용이 허용됨

    새로 공개된 테이블형 파운데이션 모델을 실무자가 즉시 시도해볼 수 있는 관점에서 정리하고, 기존 그래디언트 부스팅 워크플로 대비 달라지는 지점과 아직 검증되지 않은 부분을 함께 짚는 분석형 가이드

    목차

    쿠모 타블러는 라벨된 행을 컨텍스트로 받아 신규 행의 라벨을 단 한 번의 forward pass로 예측한다. 별도 학습도, 하이퍼파라미터 튜닝도, 피처 엔지니어링도 없다. 엔비디아가 허깅페이스에 공개한 쿠모 타블러는 분류와 회귀를 같은 인터페이스로 처리하는 오픈 테이블형 파운데이션 모델이다.

    20년간 산업 현장의 정형 데이터 예측 표준이 그래디언트 부스팅 트리(GBDT)였음은 부정하기 어렵다. XGBoost, LightGBM, CatBoost — 어느 조직이든 “테이블 데이터 = GBDT”라는 공식을 한 번쯤은 따라왔다. 데이터 전처리 → 학습 → 튜닝 → 검증 → 배포, 5단계로 쪼개는 그 공식이 흔들릴 가능성이 생겼다. 필자는 이 지점이 가장 의미 있다고 본다. 모델 자체보다 워크플로가 바뀌는 사건이기 때문이다.

    쿠모 타블러는 무엇을 받아 무엇을 내보내는가

    입력은 라벨된 행들의 묶음, 즉 컨텍스트 테이블이다. 출력은 신규 행에 대한 예측값이다. 모델은 이 둘을 별도 학습 없이 연결한다. TabPFN, TabICL과 같은 인-컨텍스트 러닝 계열에 속하며, LLM이 프롬프트만으로 새 작업을 수행하는 방식과 닮았다.

    분류든 회귀든 같은 호출로 끝난다. churn·default 같은 이진 분류, 매출·수요·가격 같은 연속값 회귀 — 모두 단일 forward pass 한 번이다. 실무자 입장에서는 sklearn의 fit/predict를 떠올리되 fit이 사라진 API라고 보면 된다.

    쿠모 타블러 3종 — 사이즈와 라이선스

    본문에 따르면 28M에서 215M 파라미터까지 세 가지 변종이 공개됐다. 정확한 중간 사이즈는 명시되지 않았다. 모든 변종이 OpenMDW-1.1 라이선스를 따르며, NVIDIA Kumo Structured 모델 컬렉션의 일부로 GitHub와 허깅페이스 양쪽에서 접근 가능하다.

    변종 파라미터 용도 추정 라이선스
    Small 약 28M 온디바이스·경량 추론 OpenMDW-1.1
    Medium 중간 규모(미공개) 일반 서버 추론 OpenMDW-1.1
    Large 약 215M 고품질 예측·배치 OpenMDW-1.1

    GBDT 대비 파라미터 수는 적지만, 추론 1회당 컨텍스트 전체를 다시 넣어야 한다. GPU 자원이 충분하지 않으면 지연이 커질 수 있다.

    오픈소스 생태계 — 허깅페이스와 GitHub 동시 배포

    쿠모 타블러는 허깅페이스 공식 블로그에 소개됐다. OpenMDW-1.1 라이선스는 상업적 이용을 허용하므로 별도 계약 없이 사내 서비스나 제품에 임베드할 수 있다. 엔비디아가 같은 시기에 공개한 다른 모델군 — 엔비디아 SoL-Pi, 엔비디아 PAIR — 과 결을 같이한다. 로컬 추론 인프라와 에이전트 하네스 쪽으로 라인업을 넓히면서, 정형 데이터 영역에도 같은 철학을 적용한 셈이다.

    벤치마크 4종 1위 — 단, 원문 단일 출처라는 점은 짚어야 한다

    TabArena, BeyondArena, TALENT, ScoringBench 네 벤치마크에서 1위를 기록했다고 본문은 주장한다. 인공 데이터(artificial data)로 사전학습된 모델이 실제 데이터 기반 벤치마크에서 GBDT를 눌렀다는 점이 핵심이다. 다만 본 분석에 수집된 자료만으로 이 수치를 독립 교차 검증하기는 어렵다. 도입을 검토하는 조직은 1위라는 문구보다 “어떤 데이터 분포에서 1위였는가”를 먼저 봐야 한다.

    실무에서 쿠모 타블러를 처음 만지는 흐름

    가장 먼저 떠올릴 만한 업무는 라벨된 테이블이 이미 존재하는 영역이다. 이탈 예측, 부도 분류, 단기 수요 예측, 가격 회귀 — 과거에 한 번이라도 라벨링이 끝난 과제라면 컨텍스트 행으로 넣어 즉시 추론을 받을 수 있다.

    라벨이 없거나 컬럼 의미가 자주 바뀌는 데이터에는 그대로 적용하기 어렵다. 컨텍스트 행 수와 컬럼 수에 제약이 있을 가능성이 높고, 추론 한 번에 컨텍스트 전체를 다시 넣어야 하므로 대량 배치에 적합한 구조는 아니다. 실무자 입장에서 보면, PoC의 첫 단계로 가장 합리적인 선택지는 “라벨이 이미 붙어 있는 가장 작은 테이블 한 개”다.

    GBDT 워크플로와 비교할 때의 차이

    XGBoost·LightGBM 워크플로에서는 5단계가 데이터 사이언티스트 한 명의 시간을 잡아먹었다. 쿠모 타블러는 그중 학습·튜닝 단계를 사실상 제거한다. 대신 데이터 거버넌스 — 어떤 라벨이 컨텍스트에 들어가도 되는지, PII 마스킹은 어떻게 할지, 컨텍스트는 얼마나 자주 갱신할지 — 의 비중이 커진다.

    비용 구조도 바뀐다. 매번 GPU 추론을 돌려야 하므로 학습 1회 비용 모델에서 추론 N회 비용 모델로 전환된다. 트래픽이 적은 업무라면 오히려 비용이 늘 수 있다.

    실무 적용 포인트

    • 라벨된 테이블이 이미 존재하는 과제부터 컨텍스트로 넣어 단일 forward pass 결과를 받는 PoC를 돌려본다.
    • GBDT 베이스라인과 동일한 holdout으로 정확도·지연·비용을 함께 측정한다. 1위 벤치마크 수치보다 내 데이터에서의 격차가 더 중요하다.
    • 컨텍스트 행 수와 컬럼 수의 상한을 모델 카드에서 확인하고, 대량 배치 처리 가능 여부를 미리 본다.
    • OpenMDW-1.1의 의무 조항을 법무팀에 한 번 더 확인한다. attribution 요건과 redistribution 제한이 핵심이다.
    • GPU 추론 비용이 학습 1회 비용으로 잡혀 있던 예산 체계를 추론 N회 기준으로 재설계한다.

    지금 바로 해볼 것

    • 허깅페이스에서 NVIDIA Kumo Tabular 모델 카드를 열어 변종별 파라미터 수와 라이선스 전문을 확인한다.
    • 사내 churn·default·demand 데이터셋 한 개를 골라 라벨된 행 5,000~50,000개를 컨텍스트로 넣어 단일 forward pass 결과를 받는다.
    • 동일 holdout에 대해 LightGBM 기본 하이퍼파라미터 결과를 비교 표로 정리한다. 정확도·예측 시간·GPU 메모리 사용량 3축으로.
    • 컨텍스트에 PII 컬럼이 포함되는지, 포함된다면 마스킹 정책을 어떻게 둘지 데이터 거버넌스 팀에 질의한다.
    • OpenMDW-1.1 라이선스 전문을 사내 법무팀과 함께 검토하고, 상업 서비스에 임베드 가능한지 결론을 받는다.

    자주 묻는 질문

    쿠모 타블러는 XGBoost를 완전히 대체할 수 있나?

    본문만으로 단정하기는 이르다. 4개 벤치마크 1위라는 주장은 인공 데이터로 사전학습된 모델이 실제 분포에서도 우월하다는 의미는 아니다. 동일 holdout에서의 직접 비교가 먼저 필요하다.

    분류와 회귀 모두 지원하나?

    허깅페이스 블로그 기준 분류와 회귀를 모두 단일 forward pass로 예측한다. 별도 모델 호출을 분리할 필요는 없다.

    상업적으로 사용 가능한가?

    OpenMDW-1.1 라이선스로 배포되며 상업적 이용은 허용된다. 단, 의무 조항이 있을 수 있으므로 라이선스 전문 확인은 필수다.

    TabPFN, TabICL과 쿠모 타블러의 차이는?

    세 모델 모두 인-컨텍스트 러닝 계열에 속한다. TabPFN과 TabICL이 학술·연구 측의 흐름이라면, 쿠모 타블러는 NVIDIA 라인업 안에서 상업 배포를 염두에 둔 모델이라는 점에서 결이 다르다.

    쿠모 타블러는 테이블형 ML의 패러다임을 근본적으로 바꾸었다고 단정하기엔 아직 검증되지 않은 영역이 많다. 컨텍스트 행 수의 실제 상한, 인공 데이터 사전학습이 도메인별로 얼마나 일반화되는지, GPU 추론 비용이 학습 1회 모델 대비 손익분기점을 넘는 지점 — 이 셋이 정리되지 않으면 “GBDT 대체”라는 주장은 섣부르다. 그럼에도 실무자의 실험 대상으로는 의미 있는 출발점이다. 사내에 라벨된 테이블이 이미 있다면, 이번 주 안에 한 번 돌려볼 만하다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Hugging Face Blog — NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular Prediction

  • 온디바이스 AI 도입 5단계 — NobodyWho로 만드는 로컬 추론 워크플로

    온디바이스 AI 도입 5단계 — NobodyWho로 만드는 로컬 추론 워크플로

    핵심 요약

    • NobodyWho는 클라우드 API 대신 사용자 기기에서 AI 모델을 직접 실행하는 온디바이스 추론 엔진으로, 대화·이미지 이해·음성 등 기능을 앱과 게임에 탑재할 수 있도록 설계된 오픈소스 프로젝트임
    • 모델을 한 번 내려받으면 이후 실행 시 인터넷 연결이나 API 키가 필요 없으며, 사용자 입력이 외부 서버로 전송되지 않고 기기 내에서 처리됨
    • Python 등 다양한 개발 환경에서 손쉽게 통합할 수 있어, 클라우드 기반 LLM API에 의존하지 않는 로컬 AI 워크플로를 구성할 수 있음

    개발자가 클라우드 API 의존도를 낮추고, 비용·프라이버시·지연 시간 문제를 동시에 해결할 수 있는 로컬 AI 통합 옵션으로 NobodyWho를 소개하는 실무 중심 분석

    목차

    온디바이스 AI가 화제에서 실제로 쓸 만한 옵션으로 내려왔다. API 호출 비용이 매출을 잠식하는 일이 잦아진 요즘, 한 번 내려받고 나면 인터넷 없이도 돌아가는 로컬 AI 추론 엔진에 개발자 시선이 모인다. 그 흐름 한가운데 NobodyWho가 있다.

    NobodyWho는 사용자 기기에서 직접 AI 모델을 실행하는 오픈소스 AI 엔진이다. 모델 파일을 한 번 내려받으면 이후로는 네트워크 연결도, API 키도 필요 없다. 대화·이미지 이해·음성 같은 기능을 앱이나 게임에 그대로 이식하는 게 목표다. Python을 포함한 여러 개발 환경에서 통합이 쉽도록 만들어졌고, 입력 데이터는 기기 밖으로 빠져나가지 않는다.

    필자가 이 프로젝트에서 가장 의미 있다고 본 지점은 ‘요금 정책 리스크 회피’다. OpenAI·Anthropic 같은 클라우드 API는 가격이 자주 바뀌고 사용량 한도가 걸린다. 서비스가 자라는 동안 토큰비가 매출을 갉아먹는 사례는 이미 한두 번이 아니다. NobodyWho처럼 모델을 로컬에서 굴리는 방식은 다운로드 비용만 들고, 그 뒤엔 변동비가 거의 없다.

    온디바이스 AI 작동 방식 — 한 번 받으면 끝

    NobodyWho의 실행 흐름은 단순하다. 첫 실행 시점에서 모델 파일을 디바이스에 내려받고, 이후 모든 추론은 그 기기의 CPU·GPU·NPU에서 처리된다. 사용자가 입력한 텍스트와 이미지는 외부 서버로 전송되지 않고, 응답도 로컬에서 생성된다. 네트워크 지연이 사실상 0에 가까워지는 효과까지 따라온다.

    이 구조가 특히 힘을 쓰는 케이스가 있다. 의료·법률처럼 데이터가 외부로 나가면 안 되는 워크로드, 그리고 인터넷이 불안정한 현장에서 돌아가는 산업용 도구다. 사용자가 입력한 내용이 어디에도 기록되지 않는다는 점은 GDPR·HIPAA 같은 규제 환경에서 결정적 이점으로 작동한다.

    개발자 관점 비교 5축

    온디바이스 AI를 도입할지 판단할 때 가장 자주 비교되는 축은 비용·지연·프라이버시다. 이 셋을 한 표에 정리했다.

    항목 클라우드 API 온디바이스 AI (NobodyWho) 하이브리드
    초기 비용 낮음 모델 파일 다운로드 중간
    운영비 토큰당 과금 거의 0 워크로드별 변동
    네트워크 지연 200ms~수 초 사실상 없음 케이스별 상이
    데이터 주권 서버 전송 기기 내 처리 민감 데이터만 로컬
    오프라인 작동 불가 가능 부분 가능

    표에서 보듯 온디바이스 AI는 비용·프라이버시·지연 세 축에서 우위에 있다. 대신 기기 하드웨어 요구사항이 생기고, 모델 크기만큼 저장 공간을 잡아먹는다. 7B 파라미터 모델은 대략 4~5GB, 더 큰 모델은 그 이상이다. 호환 모델과 디바이스 목록은 NobodyWho 원문 기사에서 확인할 수 있다.

    온디바이스 AI 도입 전 반드시 봐야 할 한계

    솔직히 모든 워크로드에 로컬 추론이 답은 아니다. 모델 품질 자체는 같은 파라미터 수 기준으로도 클라우드 최상위 모델에 못 미치는 경우가 많다. 추론 능력이 중요한 작업이나 다국어 처리에서는 격차가 뚜렷하다.

    배터리와 발열도 봐야 한다. 모바일 기기에서 7B 모델을 계속 돌리면 배터리가 빠르게 소모되고, 기기가 눈에 띄게 뜨거워진다. 사용자 경험 설계 단계에서 ‘언제 로컬로, 언제 클라우드로’ 라우팅할지 미리 정해두는 게 좋다. NVIDIA가 2026년 9월 28일 공개한 에이전트 안전 플랫폼 보고서에서도 에이전트가 스스로를 완전히 통제하지 못하는 드리프트(drift) 실패 모드를 짚은 만큼, 온디바이스 AI 통제도 샌드박스와 권한 분리 설계와 함께 가야 한다.

    실무 적용 포인트

    • PoC 단계에서 데이터 주권이 중요한 워크로드(메모·의료·법률)부터 로컬 추론 후보로 분리한다.
    • 모델 크기별 다운로드 시간·저장 공간·배터리 소모량을 디바이스 매트릭스로 사전 측정한다.
    • 민감하지 않은 작업은 클라우드, 민감 입력은 온디바이스 AI로 자동 라우팅하는 하이브리드를 처음부터 가정한다.
    • 에이전트형 기능을 추가할 경우 샌드박스와 툴 호출 권한 범위를 별도 명세로 분리한다.
    • 모델 업데이트 채널을 운영 환경과 분리하고, 롤백 가능한 버전 관리 체계를 마련한다.

    하이브리드 설계가 현실적 답

    순수 로컬과 순수 클라우드 사이에는 늘 회색 지대가 있다. NobodyWho 같은 엔진은 그 회색 지대를 채우는 도구로 가장 빛난다. 사용자의 텍스트 입력은 로컬에서 1차 분류하고, 분류가 모호한 경우에만 클라우드의 큰 모델로 보내는 식이다.

    이 설계의 핵심은 ‘민감도 기반 라우팅’이다. 개인정보가 포함된 프롬프트는 무조건 로컬에서만 처리하고, 일반 질의응답은 클라우드로 보내도 된다. 비용과 프라이버시를 동시에 잡는 가장 현실적인 패턴이다. 로컬 추론 라우팅 자체는 엔비디아 PAIR 출시 분석에서도 다른 방식으로 다뤄진 바 있다.

    지금 바로 해볼 것

    • NobodyWho GitHub 저장소에서 릴리즈 노트와 호환 디바이스 목록을 확인한다.
    • 현재 서비스에서 API 호출 비용이 가장 큰 1개 워크로드를 골라 로컬 전환 후보로 지정한다.
    • 해당 워크로드의 평균 입력·출력 토큰 수와 응답 시간 SLO를 표로 정리한다.
    • 동일 파라미터급 오픈소스 모델 2~3개를 후보로 올리고 디바이스별 벤치를 돌린다.
    • 내부 PoC 환경에 샌드박스와 권한 분리 가이드를 먼저 작성한 뒤 모델을 통합한다.

    누가 써야 하고, 누가 기다려야 하나

    지금 당장 온디바이스 AI를 도입할 가치가 있는 팀은 크게 두 부류다. API 비용이 매출을 잠식하는 구조이거나, 데이터가 외부로 나가는 것 자체가 비즈니스 리스크인 팀. 여기에 더해 오프라인 환경에서도 작동해야 하는 제품을 만드는 팀은 우선순위가 더 높다.

    반대로 대규모 컨텍스트나 복잡한 추론이 핵심인 서비스는 아직 클라우드 최상위 모델을 쓰는 게 낫다. 13B 이하의 온디바이스 모델로 대체할 수 있는 워크로드는 한정적이다. 로컬 추론은 ‘전부 대체’가 아니라 ‘일부 대체’ 전략으로 접근해야 효과를 본다.

    자주 묻는 질문

    NobodyWho는 어떤 모델을 지원하나요?

    주류 오픈소스 LLM 포맷과 이미지·음성 모델을 폭넓게 지원하도록 설계됐다. 구체적인 호환 목록은 저장소 릴리즈 노트에서 확인하는 게 빠르다. 모델 파일 형식에 따라 디바이스 요구사항이 달라질 수 있다.

    온디바이스 AI로 API 비용을 완전히 없앨 수 있나요?

    모든 워크로드를 로컬로 옮기기는 어렵다. 민감도와 복잡도가 낮은 작업부터 단계적으로 전환하는 방식이 현실적이다. 하이브리드 구성을 전제로 비용 구조를 다시 그려야 의미 있는 절감이 나온다.

    데이터가 정말 외부로 전송되지 않나요?

    NobodyWho 자체는 사용자 입력을 외부로 보내지 않는다. 다만 앱 통합 과정에서 텔레메트리나 분석 모듈이 추가될 수 있으므로, 배포 전 코드 경로를 직접 확인하는 편이 안전하다.

    모바일에서도 온디바이스 AI가 작동하나요?

    모델 크기와 기기 사양에 따라 다르다. 1~2B 파라미터급 모델은 중상급 모바일 칩셋에서 동작하지만, 7B 이상은 발열과 배터리 소모가 커진다. 디바이스 매트릭스 기반 사전 검증이 필수다.

    NobodyWho 같은 오픈소스 AI 엔진이 늘고 있다는 건, ‘언제 로컬, 언제 클라우드’를 선택지가 아니라 설계 문제로 만들어 준다는 뜻이다. 필자가 보기에 지금 가장 중요한 건 모델을 고르는 게 아니라, 온디바이스 AI와 클라우드를 가르는 기준을 팀 안에서 합의하는 일이다. 그 기준이 잡히면 NobodyWho는 그 기준을 코드로 옮기는 도구가 된다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — NobodyWho – 앱과 게임에 로컬 AI를 넣는 온디바이스 추론 엔진

  • 코딩 에이전트 5종 IP 보증 비교 — GitHub Copilot·Kiro·Cursor·Devin·Windsurf 책임 범위 어디까지인가

    코딩 에이전트 5종 IP 보증 비교 — GitHub Copilot·Kiro·Cursor·Devin·Windsurf 책임 범위 어디까지인가

    핵심 요약

    • Microsoft가 2026년 4월 3일 GitHub Copilot 약관을 변경하면서, 이전에 관리자 설정 한 항목이 보증을 무효화할 수 있었던 구조가 사라졌고, 현재 ‘필수 완화 조치’ 페이지에는 GitHub 제품군에 대한 추가 조치가 기재되어 있지 않음.
    • Copilot 보증을 둘러싼 핵심 쟁점은 ‘unmodified(무수정)’ 표현으로 보일, 출하 전에 한 번이라도 편집된 코드가 보장에서 벗어날 수 있어 법무 검토가 필요함.
    • AWS Kiro는 AWS 생성형 AI 보증(Section 50.10)을 승계하며, 카피라이트 클레임에 대해 무제한 보증을 표방함. 단, 입력이 침해하거나 필터링 기능을 비활성화하면 보장이 무너짐.

    분석

    목차

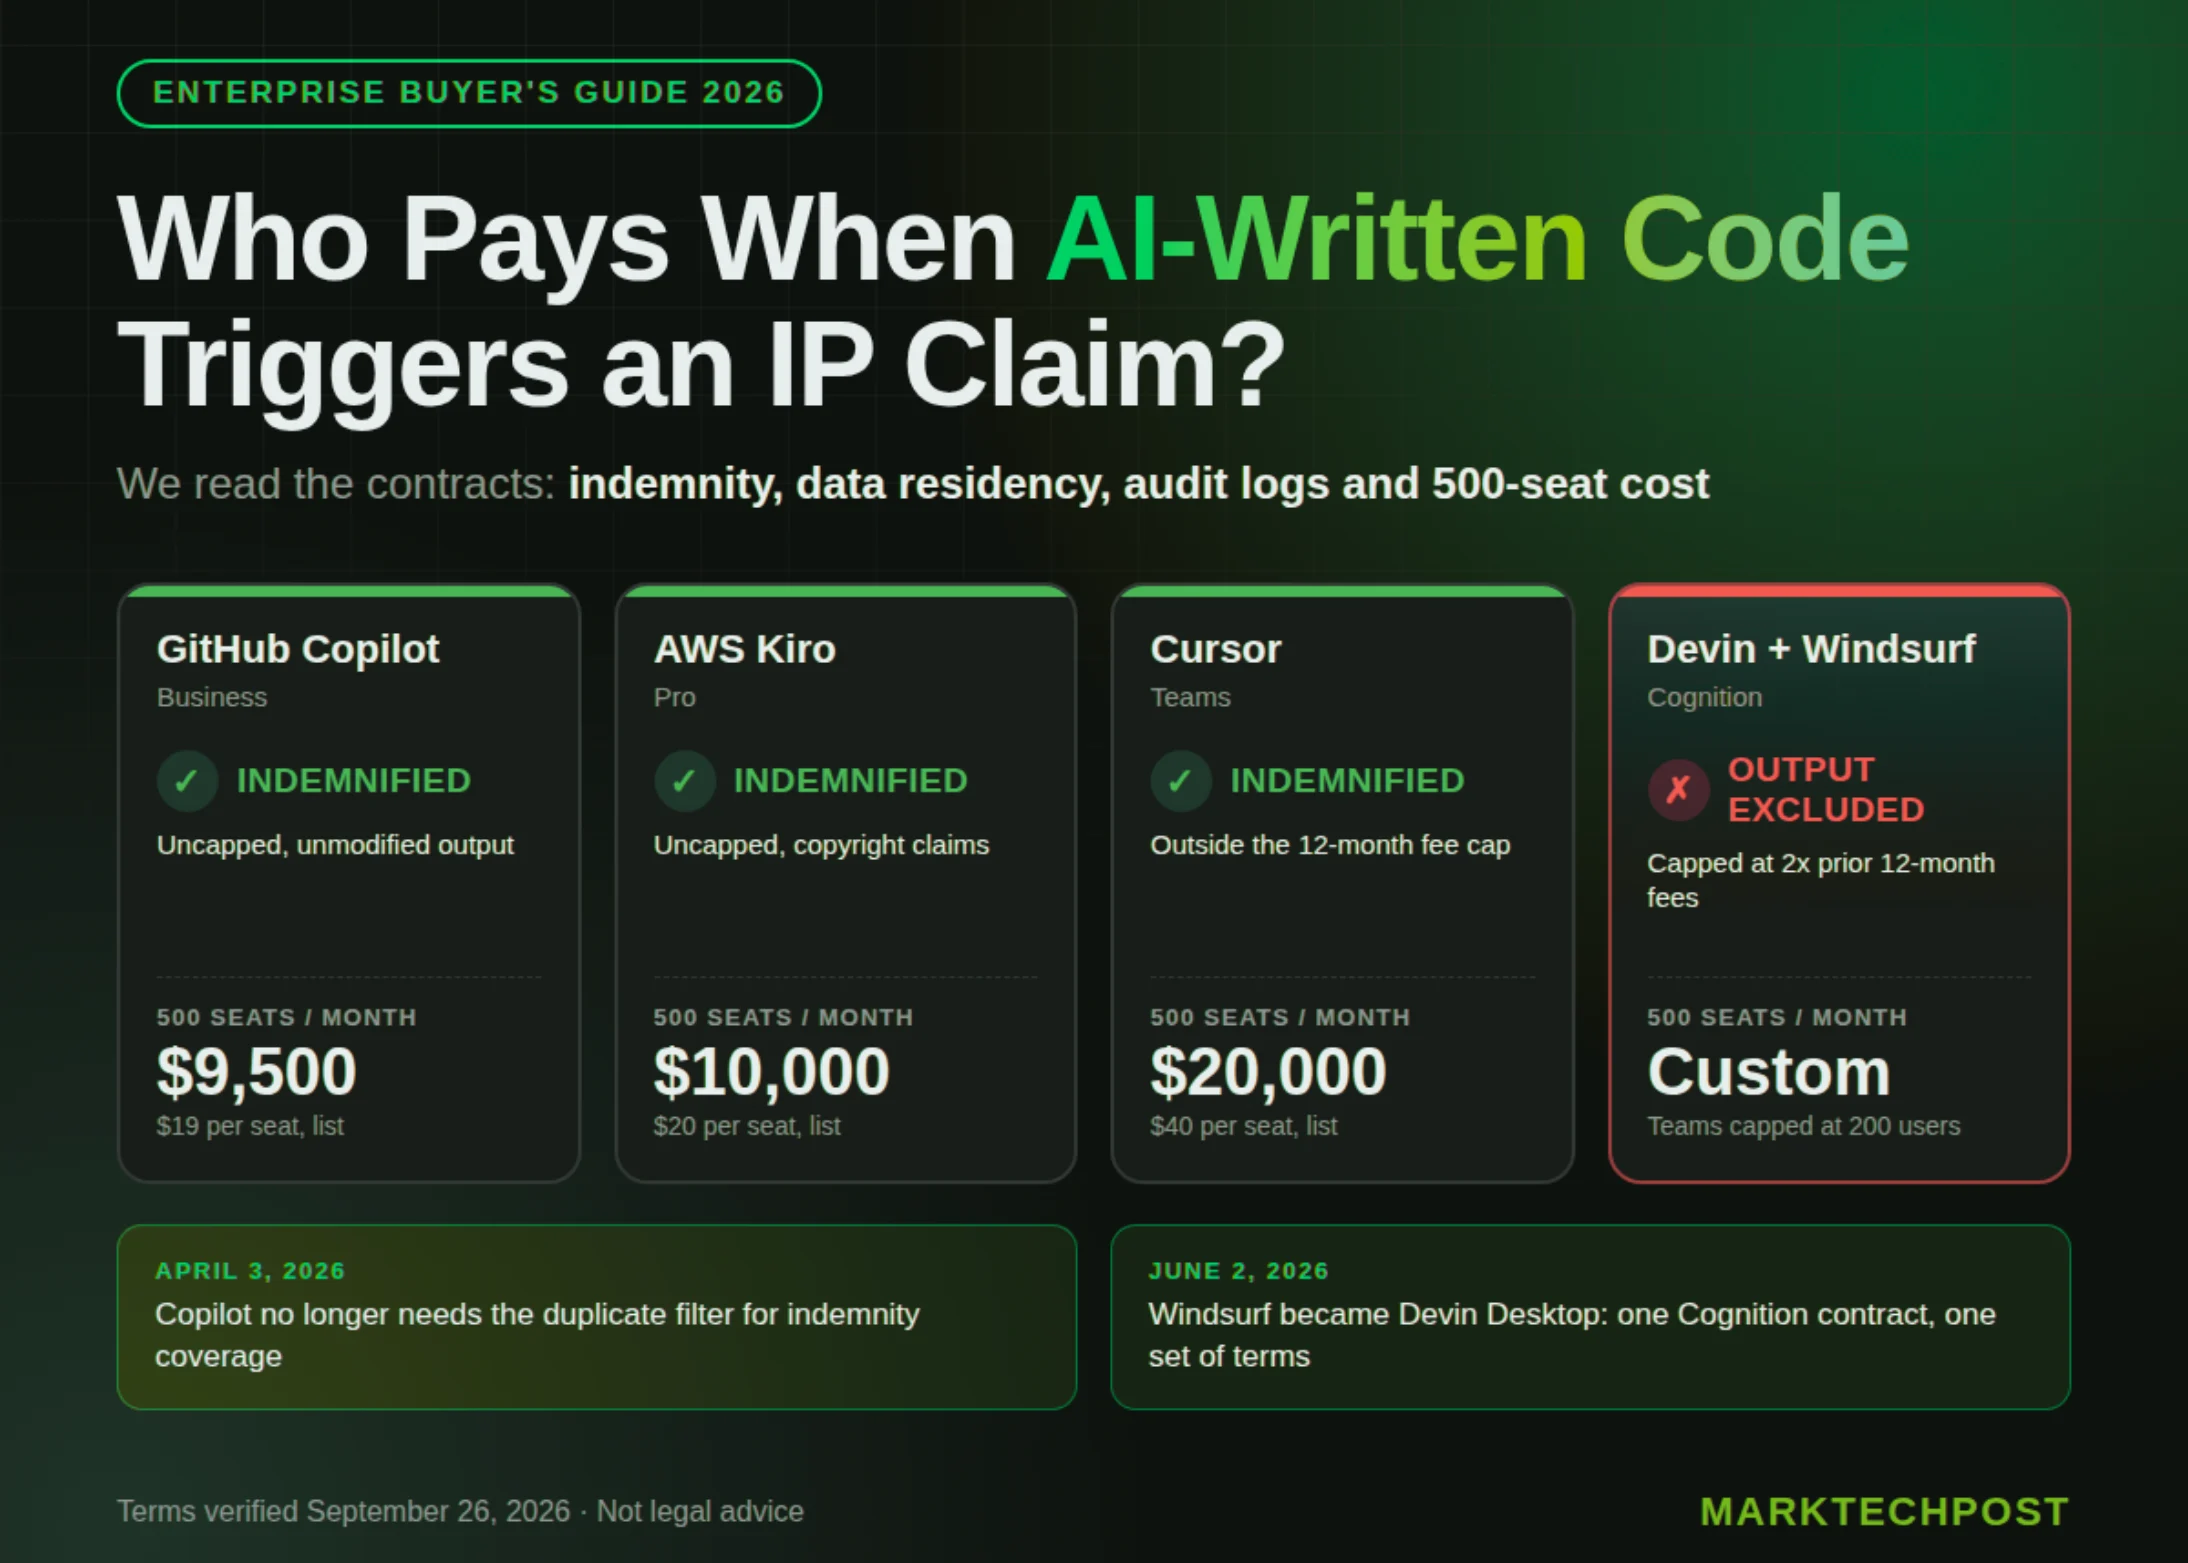
    코딩 에이전트 5종을 기업용으로 도입하려 할 때, 구매 담당자가 가장 먼저 부딪히는 벽은 라이선스 비용이 아니라 IP 보증 조항이다. MarkTechPost가 2026년 9월 26일자로 정리한 기업용 AI 코딩 에이전트 비교 보고서는 GitHub Copilot, AWS Kiro, Cursor, Cognition의 Devin·Windsurf를 같은 잣대 위에 올렸다. 필자는 이 보고서가 법무 검토자에게 던지는 질문이 가장 실용적이라고 본다.

    기업이 코딩 에이전트에 던지는 4가지 질문

    보고서가 짚은 핵심 질문은 네 가지다. IP 침해가 발생했을 때 누가 책임지나. 프롬프트와 생성 코드가 어디에 저장되나. 관리자가 감사 로그를 받아볼 수 있나. 500석 규모로 계약하면 실제 비용이 얼마인가. 이 네 질문에 답하려면 공급사 약관을 조문 단위로 까봐야 한다.

    비교에 사용한 네 축

    평가는 보증 구조, 데이터 레지던시, 관리자 감사 로그, 500석 TCO 네 축으로 정리했다. 보증은 “무엇을, 어떤 조건에서, 어디까지” 책임지는지, 데이터는 저장 지역과 보존 기간, 로그는 관리자 콘솔에서 무엇을 볼 수 있는지, 비용은 공개된 가격표와 협상 변수까지 합산한 값을 기준으로 한다.

    GitHub Copilot — 2026년 4월 3일 약관 변경의 의미

    Microsoft는 2026년 4월 3일 GitHub Copilot 약관을 변경했다. 이전까지 관리자 설정 한 항목이 보증을 무효화할 수 있었던 구조가 사라졌고, 현재 ‘필수 완화 조치’ 페이지에는 GitHub 제품군에 대한 추가 조치가 기재되어 있지 않다. 실무적으로 보면 이 변화는 기업 입장에서 호재다. 보증을 깎을 수 있는 숨은 트리거가 줄었기 때문이다.

    다만 “unmodified(무수정)”라는 단어가 여전히 발목을 잡는다. 출하 전에 한 번이라도 편집된 코드는 보장에서 벗어날 수 있다는 의미다. 현실의 모든 코드는 내부 리뷰를 거치며 수정된다. 이 조항이 그대로 적용되면 사실상 보증이 공염이 될 수 있어 법무 검토가 필수다.

    AWS Kiro — Section 50.10 무제한 보증의 양면

    AWS Kiro는 AWS 생성형 AI 보증 Section 50.10을 승계한다. 카피라이트 클레임에 대해 무제한 보증을 표방하는 부분은 다섯 코딩 에이전트 중 가장 강력하다. 입력이 이미 침해하거나 필터링 기능을 비활성화하면 보증이 무너지는 제외 조항이 있다. 입력 침해 제외는 학습용으로 가져온 외부 라이선스 코드를 그대로 넣었을 때를 가리킨다. 필터 비활성화는 PoC 단계에서 성능을 위해 끄는 경우가 있다는 점이 실무 함의다.

    Cursor — 광범위 MSA와 미세 제외의 충돌

    Cursor의 MSA는 명목상 가장 넓다. ‘Suggestions’를 명시하고 보증 한도를 이용료 상한에서 분리했다. 수정(modification)이나 승인되지 않은 결합(unapproved combination)과 관련된 클레임은 제외 조항이 작동한다. 흥미로운 지점은 기업용과 소비자용 약관의 괴리다. 소비자용 ToS는 반대로 사용자가 Anysphere를 보상하는 구조다. 같은 회사의 코딩 에이전트라도 라이선스 형태에 따라 책임 소재가 뒤집힌다. 도입 단계에서 어느 약관이 적용되는지 먼저 확정해야 한다.

    Cognition(Devin·Windsurf) — 보증 배제라는 아웃라이어

    Cognition은 다섯 코딩 에이전트 중 유일한 아웃라이어다. MSA가 생성물을 보증 범위에서 명시적으로 배제했다. 2026년 6월 2일 Windsurf를 인수한 뒤 에디터 명칭을 Devin Desktop으로 변경하고 가격표와 약관을 통합했다. 보증 배제는 IP 리스크가 전적으로 사용자에게 돌아온다는 의미다. 에이전트형 코딩 에이전트가 자율적으로 코드를 작성하고 외부 저장소에 푸시하는 특성상, 이 조항이 작동할 빈도가 다른 제품보다 높을 수 있다. 실무자 입장에서 눈에 띄는 건, Cognition이 이 점을 숨기지 않고 명시했다는 부분이다.

    5종 코딩 에이전트 비교표

    제품 IP 보증 범위 주요 제외 조건 비고
    GitHub Copilot 생성물에 한해 보증 unmodified 코드만 해당 2026-04-03 약관 변경으로 관리자 트리거 제거
    AWS Kiro Section 50.10 무제한 입력 침해, 필터 비활성화 카피라이트 클레임에 한함
    Cursor(MSA) Suggestions 명시, 한도 분리 수정, 미승인 결합 소비자용 ToS는 사용자 보상 구조
    Devin 생성물 보증 배제 전 항목 2026-06-02 Windsurf 인수 후 통합
    Windsurf→Devin Desktop Devin과 동일 Devin과 동일 가격표·약관 통합

    수집 데이터의 한계

    원문은 네 질문에 초점을 맞췄지만 수집된 전문은 중간에서 잘렸다. 500석 비용표의 구체적 수치와 감사 로그 세부 항목은 본문 내에서 확인되지 않았다. 본 기사는 2026년 9월 26일자 공급사 공식 페이지를 기준으로 검증했다는 점을 명시한다. 이후 약관 변경 가능성이 있으므로 법무 검토 시점의 최신 약관을 다시 확인해야 한다. 코딩 에이전트 도입을 검토하는 팀은 PoC 단계에서 직접 콘솔과 약관 PDF를 다시 받아볼 것을 권한다.

    실무 적용 포인트

    • “unmodified” 같은 조건부 표현이 들어간 조문은 사내 표준 개발 워크플로우와 충돌하는지 법무팀과 함께 검토한다.
    • 데이터 레지던시는 마케팅 페이지가 아니라 DPA 본문에서 저장 지역과 보존 기간을 확인한다.
    • 관리자 감사 로그는 PoC 단계에서 콘솔에 직접 들어가 필요한 이벤트가 노출되는지 본다.
    • 에이전트형 코딩 에이전트(Cognition 등)는 보증 배제 조항이 작동할 시나리오를 별도 시뮬레이션한다.
    • 500석 TCO는 공개 가격표에 더해 볼륨 할인, 다년 약정, 교육 비용을 시트에 함께 올린다.

    지금 바로 해볼 것

    • 공급사 약관에서 “indemnify”, “warranty”, “limitation of liability” 세 키워드로 검색한다.
    • “unmodified”, “as-is”, “your responsibility” 같은 책임 전환 표현이 있는지 표시한다.
    • DPA를 열어 저장 지역, 하위 처리자 목록, 데이터 보존 기간 세 칸을 발췌한다.
    • 관리자 콘솔 PoC를 요청해 감사 로그에서 프롬프트 조회, 생성 코드 다운로드, 관리자 재정의 항목이 뜨는지 확인한다.
    • 500석 견적을 두 시나리오(단년/3년 약정)로 받아 시트에 나란히 올린다.

    자주 묻는 질문

    코딩 에이전트 도입 시 가장 먼저 봐야 할 조항은 무엇인가요?

    IP 보증(Indemnification) 조항입니다. 침해 발생 시 누가 변호사 비용과 손해를 책임지는지가 비용보다 먼저 결정됩니다. 가격표 협상은 그 다음입니다.

    관리자 설정만으로 IP 보증이 무효화되기도 하나요?

    과거 GitHub Copilot는 특정 관리자 설정이 보증을 무효화할 수 있는 구조였지만, 2026년 4월 3일 약관 변경으로 그 트리거가 사라졌습니다. 다만 “unmodified” 같은 조건부 조항은 여전히 남아 있습니다.

    소비자용 약관과 기업용 약관이 다른 경우는 어떻게 하나요?

    동일 공급사라도 B2B와 B2C 약관이 다를 수 있습니다. Cursor가 대표적 사례로, 기업용 MSA는 공급사가 보증을 제공하지만 소비자용 ToS는 사용자가 공급사를 보상하는 구조입니다. 도입 단계에서 적용 약관을 먼저 확정하세요.

    500석 실제 비용은 어떻게 산정해야 하나요?

    공식 가격표에 사용자 수를 곱한 금액이 시작점입니다. 여기에 볼륨 할인, 다년 약정 할인, 교육·온보딩 비용, SSO·감사 로그 같은 관리 기능 추가 비용을 더해 실제 TCO를 산출합니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — AI Coding Agents for Enterprise: IP Indemnity, Data Residency and 500-Seat Cost Compared

  • 엔비디아 SoL-Pi, 토큰 49% 절감 — AI가 만든 코딩 에이전트 하네스 4종 정밀 해부

    엔비디아 SoL-Pi, 토큰 49% 절감 — AI가 만든 코딩 에이전트 하네스 4종 정밀 해부

    핵심 요약

    • NVIDIA·NTU·MIT 공동 연구팀이 오픈소스 Pi 코딩 에이전트용 효율화 레이어 ‘SoL-Pi’를 공개했으며, MIT 라이선스로 GitHub NVlabs에 배포됨
    • SoL-Pi는 4개의 하네스 메커니즘으로 구성되고, 별도 학습된 AI가 535개 환경에서 auto-research 루프를 돌려 이를 발견
    • EdgeBench 51개 태스크 평가에서 Pi 대비 기록된 토큰 트래픽을 44.7~49.0% 절감, API 비용은 약 33% 감소

    SoL-Pi의 모든 수치는 EdgeBench 51개 태스크 중 hold-out 40개 태스크의 결과이므로 과적합 위험이 통제된 비교 가능한 지표로 해석할 수 있음, 다만 해당 평가는 4개 메커니즘이 동시에 적용된 결과이므로 개별 메커니즘의 기여도는 별도 분석이 필요

    목차

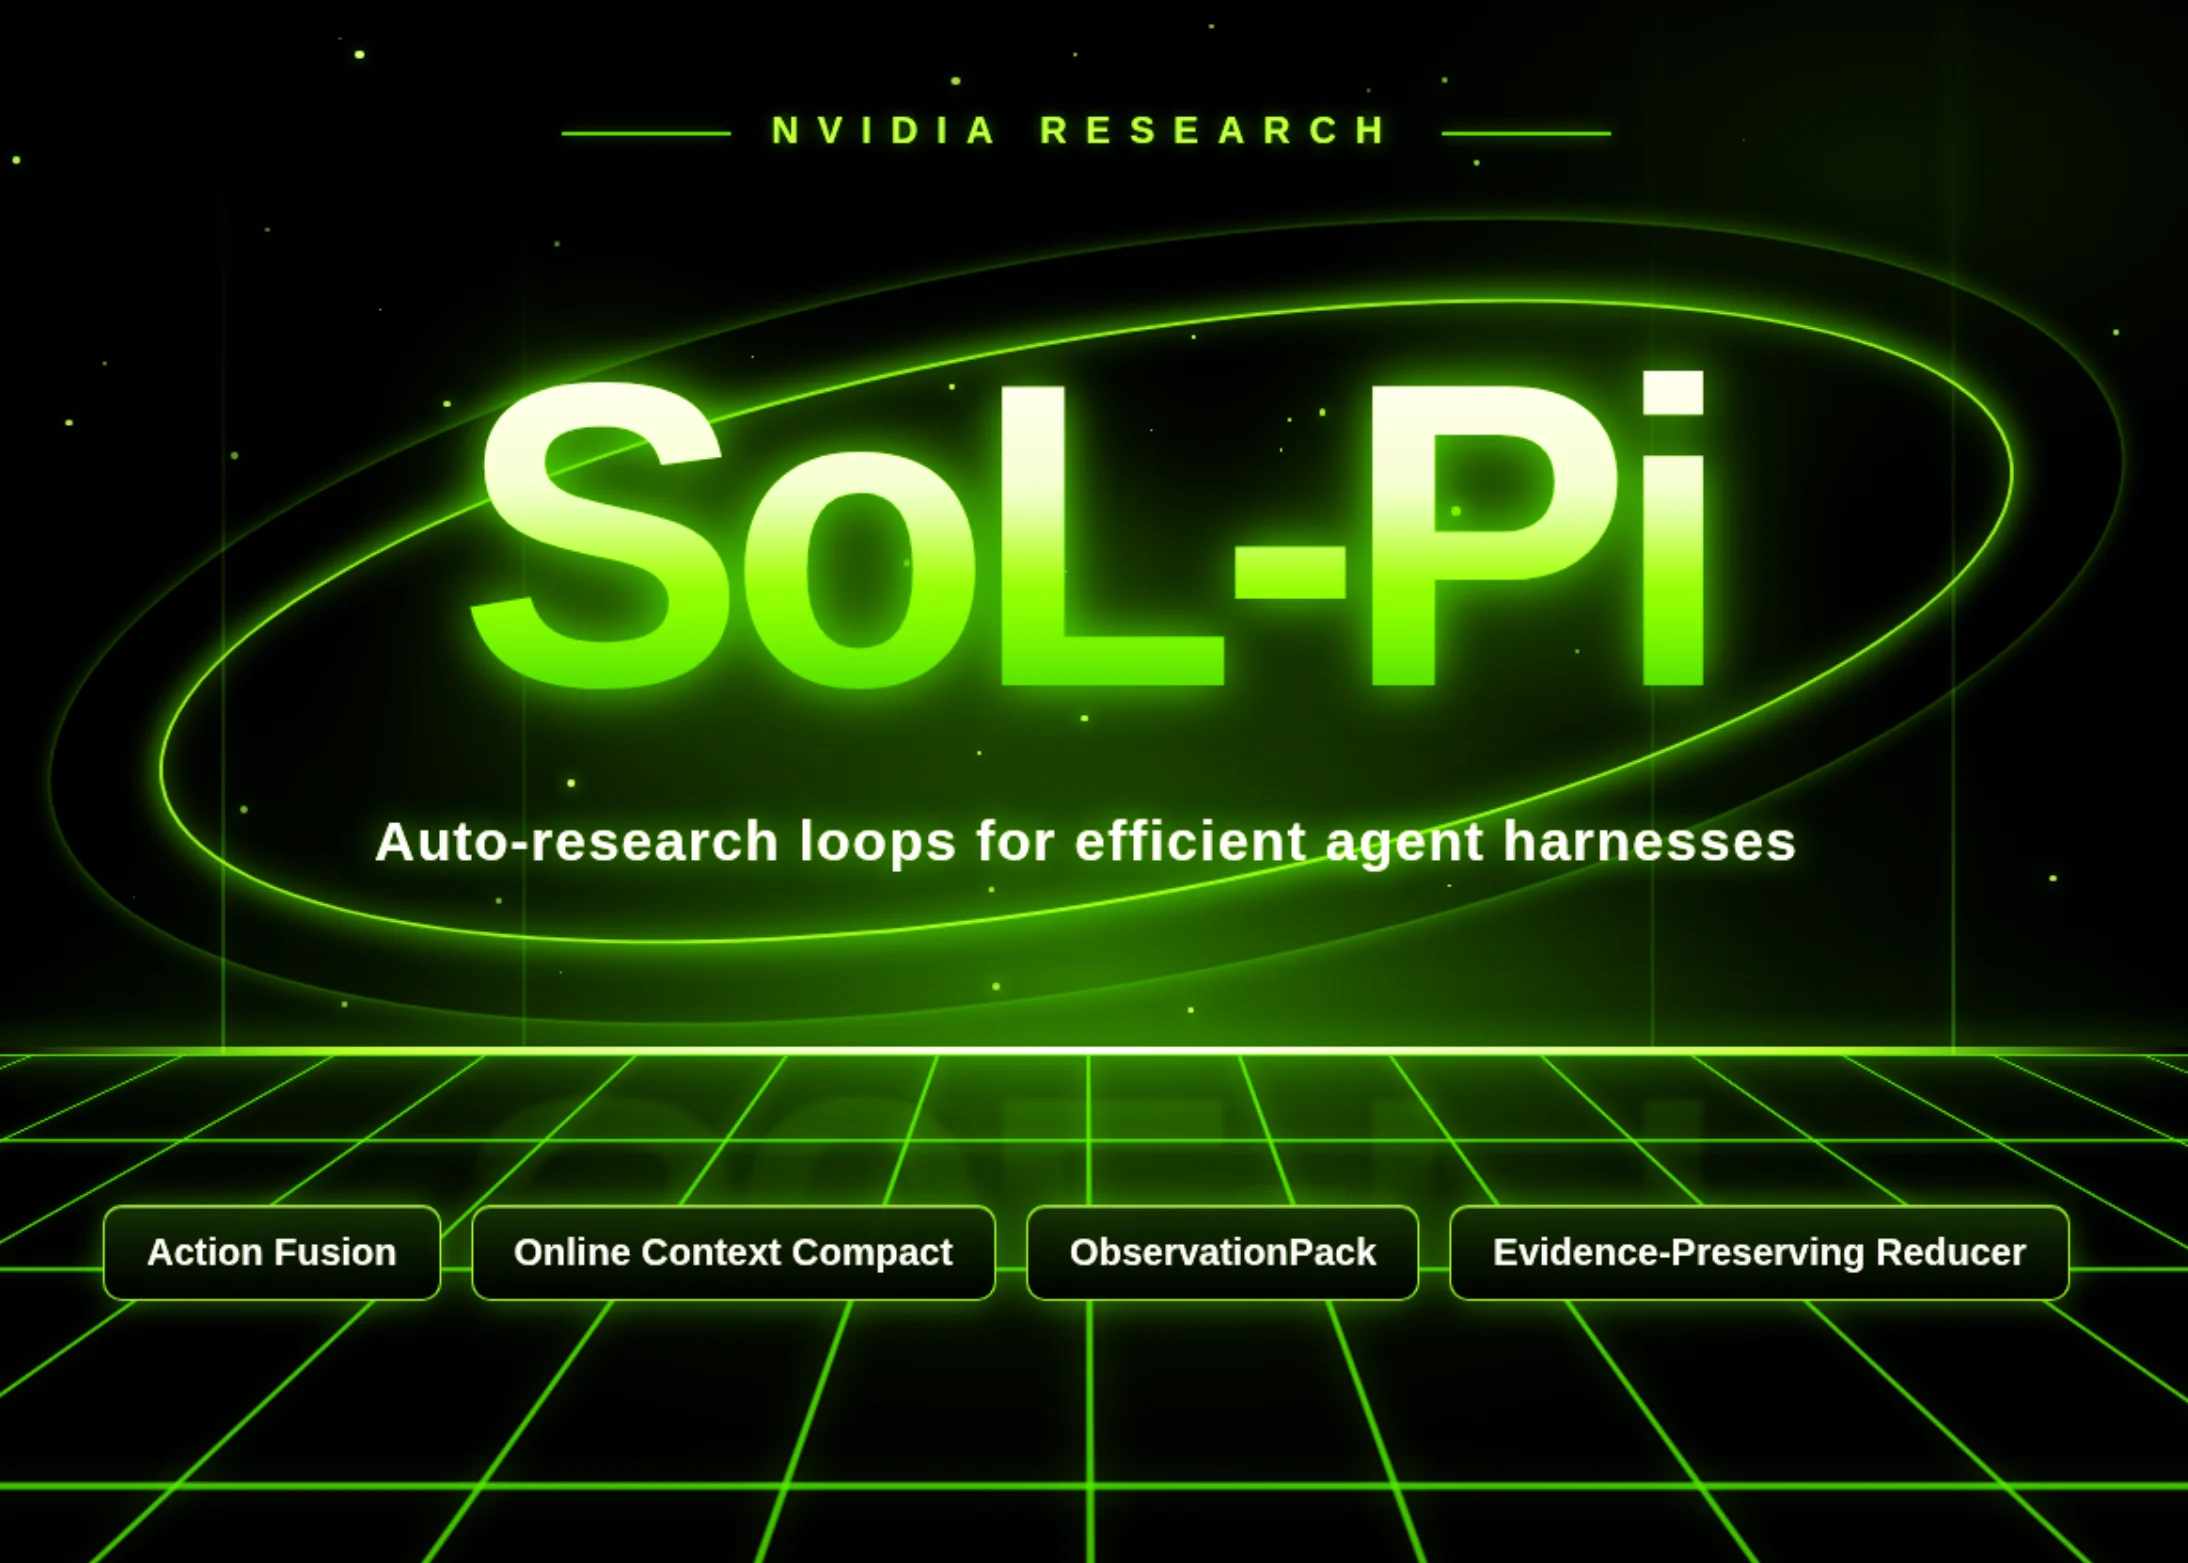
    엔비디아 SoL-Pi가 EdgeBench 51개 태스크에서 토큰 트래픽을 44.7~49.0% 줄였다는 숫자가 먼저 눈에 들어온다. NVIDIA·NTU·MIT 공동 연구팀이 9월 21일 공개한 이 레이어는, 모델을 다시 학습시킨 게 아니다. 별도 학습된 AI가 535개 환경에서 auto-research 루프를 돌며 발견한 4개 하네스 메커니즘을 Pi 코딩 에이전트 위에 얹은 결과다.

    엔비디아 SoL-Pi 4개 하네스 메커니즘 구조도

    핵심은 ‘토큰당 가격’이 아니라 ‘태스크당 토큰 수’를 줄였다는 점이다. 필자는 이 지점이 가장 의미 있다고 본다. 같은 모델로 같은 태스크를 처리하면서 시스템 프롬프트와 도구 호출, 컨텍스트 압축을 다시 짠 것뿐이다. 점수는 GPT-5.6 Sol과 Opus 5에서 Pi의 약 94%를 유지했고, API 비용은 약 33% 감소했다.

    EdgeBench 51개 태스크, 49% 절감은 어떻게 입증됐나

    평가 구조부터 짚어야 한다. 51개 태스크 중 11개는 frozen candidate의 1-way acceptance, 40개는 held-out이다. 검색 단계에서 옵티마이저는 11개 frozen 태스크의 수용 규칙을 절대 변경하지 못한다. 그리고 40개 held-out 결과는 검색 루프에 다시 반영되지 않는다.

    즉, ‘evolved harness가 검색 태스크에 과적합될 수 있다’는 비판을 직접 설계로 차단한 셈이다. 이 분리 덕분에 49% 절감 수치는 비교 가능한 지표로 받아들일 수 있다. 검색·평가 데이터 분리라는 검증 패턴은 AI 연구 자동화 9월 마일스톤에서 반복적으로 등장한 흐름과 결을 같이한다.

    엔비디아 SoL-Pi의 하네스 4종은 어떻게 동작하나

    엔비디아 SoL-Pi의 4개 메커니즘은 도구 호출, 컨텍스트, 관찰값 처리에 집중돼 있다. 공개 자료 기준으로 명칭이 확정된 것은 아니지만, 동작 패턴은 (1) 도구 호출 단계의 분기 압축, (2) 시스템 프롬프트의 동적 슬림화, (3) 관찰값 중복 제거, (4) 실패 루프 조기 종료 — 이 네 축으로 요약된다. 개별 메커니즘의 기여도는 분리 분석이 아직 공개되지 않았다.

    535개 환경 auto-research 루프의 구조

    루프는 관찰 → 제안 → 평가의 3단계다. 535개 환경에서 베이스라인 Pi의 트래픽을 측정하고, 변형 하네스를 제안해 동일 환경에서 다시 측정한다. 이 사이클을 Ralph Loop 구현으로 반복한다. 독립 리뷰어가 검색 단계 결과와 held-out 결과를 따로 점수화하기 때문에, 4개 메커니즘의 평균 절감률은 검색과 평가 양쪽에서 동일하게 집계된다.

    배포 요건과 호환성

    엔비디아 SoL-Pi는 Pi 0.85.1, Node.js 22.19 이상에서 수정 없는 Pi 릴리스 그대로 동작한다. MIT 라이선스로 GitHub NVlabs 저장소에 배포됐다. 기존 Pi 사용자가 가져다 얹는 형태라 마이그레이션 비용이 거의 없다. MarkTechPost 원문에서 저장소 링크와 릴리스 노트를 확인할 수 있다.

    리스크와 한계

    평가는 GPT-5.6 Sol과 Opus 5 두 모델에 한정된다. 코딩 에이전트 외 도메인에서는 검증되지 않았다. 4개 메커니즘을 동시에 적용한 결과이므로, ‘도구 호출 압축만 떼어내면 몇 %인가’를 알려면 별도 ablation이 필요하다. frozen 11개 태스크의 1-way acceptance 규칙이 코딩 외 영역에서도 유지될지는 미지수다.

    엔비디아 SoL-Pi vs AWS Strands harness

    비교 대상으로 자주 거론되는 AWS Strands harness는 범용 에이전트를 대상으로 ALFWorld·ContextBench·GAIA·WebShop·τ²-bench·Terminal-Bench 2.1에서 동일 모델 기준 약 28% 낮은 비용을 보고했다. 엔비디아 SoL-Pi는 코딩 에이전트 한정으로 약 33% 비용을 낮췄다. Strands harness 원문에 따르면 도메인 차이 외에 평가셋 구조도 다르다.

    구분 엔비디아 SoL-Pi AWS Strands harness Pi 베이스라인
    대상 도메인 코딩 에이전트 범용 에이전트 코딩 에이전트
    평가셋 EdgeBench 51태스크 ALFWorld·GAIA 등 6종 EdgeBench 51태스크
    API 비용 감소 약 33% 약 28% 기준점
    정확도 유지 약 94% (vs Pi) 동일 모델 baseline 비교 100% (기준점)
    라이선스 MIT 오픈소스 (정책 확인 필요) 원본 Pi 정책

    엔비디아 SoL-Pi는 도메인 특화, Strands는 범용이라는 차이가 크다. 어느 쪽이 더 낫냐보다 에이전트의 주용도에 따라 갈리는 문제다. 에이전트 전반의 비용 효율화 흐름은 에이전트 기반 개발이 PR 70% 처리한다는 보고에서도 다른 조직 사례와 함께 읽힌다.

    지금 바로 해볼 것

    • 기존 Pi 0.85.1 환경에 SoL-Pi를 clone하고 unmodified Pi 그대로 얹어 5개 태스크를 돌려본다.
    • Node.js 버전을 22.19 이상으로 맞추고 토큰 카운트 차이를 사전 측정한다.
    • 엔비디아 SoL-Pi 적용 전후의 평균 토큰/태스크, API 비용/태스크, 통과율을 표로 기록한다.
    • 코딩 외 에이전트 위주라면 AWS Strands harness의 호환성과 라이선스를 별도 확인한다.
    • 4개 메커니즘 중 도구 호출 분기 압축을 우선 검토해 절감 폭을 가늠한다.

    실무 적용 포인트

    기존 Pi 사용자라면 엔비디아 SoL-Pi를 우선 도입 대상에 올려라. unmodified 호환성 때문에 마이그레이션 비용이 거의 없다. 단, 정확도 6% 손실이 허용 가능한 워크로드인지 먼저 가른 뒤 적용 범위를 정해야 한다. 코딩 외 도메인을 주로 다룬다면 Strands harness와 oh-my-pi 등 후보를 함께 평가하고, 라이선스와 벤치마크 재현 가능성을 체크리스트에 넣어라. 평가 모델을 단일 벤더에 묶지 않는 것도 위험 분산의 기본이다.

    자주 묻는 질문

    엔비디아 SoL-Pi는 모델을 다시 학습시킨 건가?

    아니다. 기존 Pi 릴리스 위에 얹는 하네스 레이어다. 별도 학습된 AI가 535개 환경에서 발견한 4개 메커니즘으로 토큰 사용량을 줄였을 뿐, 모델 가중치 자체는 변하지 않는다.

    정확도 6% 손실은 어떤 의미인가?

    GPT-5.6 Sol과 Opus 5에서 Pi의 약 94% 점수를 유지했다는 뜻이다. 코딩 태스크의 통과율 기준이며 40개 held-out 평균이다. 업무 허용 임계값에 따라 도입 판단이 갈린다.

    코딩 에이전트가 아닌 일반 에이전트에도 쓸 수 있나?

    공개된 평가는 EdgeBench 코딩 태스크 한정이다. 범용 에이전트에는 AWS Strands harness나 다른 효율화 레이어를 별도로 평가해야 한다.

    엔비디아 SoL-Pi 도입 시 가장 먼저 확인할 환경 변수는?

    Pi 버전이 0.85.1 이상이고 Node.js가 22.19 이상인지 확인한다. 그 다음 5개 이내 태스크로 토큰 카운트와 통과율을 사전 측정해 회귀 여부를 본다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — NVIDIA Introduces SoL-Pi: Auto-Research Loops That Cut Coding Agent Token Traffic by Up to 49%

  • MCP 비판 3가지 — 에이전트 도구 통합, 다시 설계해야 하는 시점

    MCP 비판 3가지 — 에이전트 도구 통합, 다시 설계해야 하는 시점

    핵심 요약

    • MCP(Model Context Protocol) 서버가 각자 다수의 도구와 스키마를 제공하면서 에이전트의 컨텍스트 창이 비대해지는 문제가 발생하고 있음
    • 코드 실행과 API 직접 호출 능력이 발전한 최신 에이전트 환경에서는 대부분의 MCP 서버가 더 이상 필수적이지 않다는 비판이 제기됨
    • 대안으로 이미 표준 인터페이스를 갖춘 HTTP API와 CLI로 MCP 서버를 대체하자는 제안이 제시됨

    AI 에이전트 생태계에서 도구 호출 표준으로 자리 잡았던 MCP가 코드 실행·API 직접 호출 능력의 성장에 따라 효용성을 재검토해야 한다는 분석 기사

    목차

    2026년 9월, StepFun이 공개한 Step 5 Preview는 단일 에이전트 액션에서 약 950회의 웹 페치를 조율한 것으로 기록됐다. 600B 파라미터의 희소 MoE 구조, 92개 Transformer 레이어의 깊고 좁은 설계다. 이 사례가 시사하는 건 단순한 성능 수치가 아니다. 에이전트가 도구와 API를 직접 다루는 능력이 한 단계 도약했다는 점이다. 이런 흐름 속에서 오래도록 에이전트 도구 통합의 표준처럼 불리던 MCP(Model Context Protocol)에 대한 MCP 비판이 다시 수면 위로 떠올랐다.

    MCP 비판의 첫 번째 쟁점: 컨텍스트 비대화

    MCP 비판의 중심에 있는 첫 번째 쟁점은 컨텍스트 비대화다. MCP 서버 하나가 수십 개의 도구와 그에 맞는 스키마를 정의하고, 에이전트는 이를 매번 시스템 프롬프트에 싣는다. 서버가 늘어나면 컨텍스트 창이 기하급수적으로 부풀고, 토큰 비용과 응답 지연이 함께 올라간다.

    실무에서 체감하는 손실은 더 직접적이다. 모델이 “쓸 수 있는 도구가 너무 많은” 상태에서 잘못된 도구를 선택하는 비율이 높아지고, 그게 다시 재시도와 비용 폭증으로 이어진다. 필자는 이 지점이 가장 실질적인 문제라고 본다. 도구의 “표준화”라는 명분 아래, 각 MCP 서버가 자기만의 스키마를 들고 등장한 결과, 에이전트 개발자는 통합 작업보다 컨텍스트 관리에 시간을 더 쓰고 있다.

    MCP 비판의 두 번째 축: 직접 호출의 현실화

    두 번째 비판은 더 근본적이다. 코드 실행과 API 직접 호출 능력이 성장하면서, MCP라는 중개 계층이 오히려 병목이 됐다는 주장이다. 오늘날 에이전트는 셸을 띄우고 curl 한 줄로 HTTP API를 두드리고, jq로 응답을 가공한 뒤 다음 단계로 넘기는 게 가능하다. Step 5 Preview의 950회 웹 페치 사례는 이런 직접 호출 패턴이 대규모 워크로드에서도 현실화됐음을 보여준다. MCP가 약속했던 “도구 호출의 표준”이, 사실은 표준 인터페이스를 갖춘 HTTP API·CLI 호출을 한 번 더 감싼 형태였다는 시각이 힘을 얻는 이유다.

    대안: HTTP API와 CLI로 도구 노출 방식을 전환

    MCP 비판론자들이 제시하는 대안은 의외로 평범하다. 도구를 HTTP API와 CLI로 노출하고, 에이전트는 코드 실행을 통해 직접 호출하라는 것이다. 인증은 OAuth/API 키로 처리하고, 도구 정의는 그때그때 함수 시그니처 수준으로만 컨텍스트에 실으면 된다. 이렇게 하면 컨텍스트 점유를 대폭 줄이면서도, 도구 진화를 MCP 스펙 변경에 묶이지 않고 자유롭게 가져갈 수 있다.

    항목 MCP 서버 HTTP API 직접 호출 CLI 직접 호출
    컨텍스트 비용 높음 (도구·스키마 상시 로드) 낮음 (필요 시점에만 정의) 낮음 (셸 호출)
    표준화 수준 MCP 스펙 종속 OpenAPI 등 성숙 표준 POSIX/셸 규약
    다단계 워크플로 강점 보통 (직접 구현) 보통 (직접 구현)
    인증 MCP 내부 처리 OAuth·API 키 환경 변수·키파일
    유지보수 서버 업데이트 전파 필요 엔드포인트 단위 독립 바이너리 단위 독립

    표에서 보듯 MCP는 “여러 도구를 한 묶음으로 노출”하는 데서 강점이 있다. 다만 그 비용을 정당화할 만큼 표준화 우위가 크지 않다는 게 비판의 핵심이다.

    MCP 비판 이후 균형 잡힌 시각: MCP가 여전히 유효한 영역

    MCP가 무용하다는 주장은 성급하다. 표준화되지 않은 사내 시스템을 에이전트에 한 번에 묶어 노출해야 하는 경우, MCP의 도구 번들링은 여전히 유효하다. 다만 일반적인 SaaS API·CLI·웹 호출이 주를 이루는 워크로드라면, 굳이 MCP를 거치지 않는 게 이득이다. 결국 답은 단일이 아니라 워크로드별 혼합 적용이다.

    MCP 비판 이후의 실용적 선택

    2026년 9월 시점에서, 에이전트 도구 통합은 “한 가지 프로토콜로 정답을 통일”하는 단계에서 벗어났다. 도구 정의의 컨텍스트 비용을 누가 부담하느냐, 표준화 요구가 어느 정도냐, 인증·권한을 누가 관리하느냐에 따라 선택이 갈린다. MCP 비판은 이 선택을 다시 열어뒀다는 데 의의가 있다.

    실무 적용 포인트

    • 도구 목록이 5개를 넘는 MCP 서버는 우선 HTTP API 직접 호출로 전환을 검토한다.
    • 컨텍스트 비용 모니터링: 도구 정의로 인한 입력 토큰 비율을 주 단위로 측정한다.
    • 워크플로가 단순 호출 1~2단계로 끝나면 MCP의 중개 계층을 거치지 않는 편이 낫다.
    • 레거시 사내 시스템은 MCP로 묶고, 외부 SaaS는 직접 호출로 분리하는 혼합 전략을 기본값으로 둔다.

    지금 바로 해볼 것

    • 현재 운영 중인 MCP 서버에서 도구 정의를 추출해 컨텍스트 점유 토큰 수를 측정한다.
    • 같은 기능을 HTTP API와 OpenAPI 명세로 다시 정의해, 에이전트가 셸에서 직접 호출하는 코드를 작성해 본다.
    • 인증 흐름을 OAuth/API 키 방식으로 단순화하고, MCP 내부 인증 의존도를 낮춘다.
    • 도구가 늘어날 때 컨텍스트 비용이 선형으로 증가하는지 로그로 확인한다.
    • 사내 표준이 없는 레거시 시스템만 MCP로 묶고, 나머지는 직접 호출로 분리한다.

    자주 묻는 질문

    MCP를 당장 걷어내야 하나요?

    아닙니다. 사내 레거시 도구를 한꺼번에 묶어야 할 때 MCP는 여전히 효율적입니다. 새로 만드는 통합은 HTTP API·CLI 기반으로 시작하는 것이 합리적입니다.

    컨텍스트 비대화가 실제 비용에 얼마나 영향을 주나요?

    도구 정의를 매 요청마다 실어 보낸다면, 입력 토큰의 20~40%가 도구 메타데이터로 소모되는 사례가 보고되고 있습니다. 모델과 요금제에 따라 월 수백만 원 단위 차이가 날 수 있습니다.

    HTTP API로 직접 호출할 때의 단점은 무엇인가요?

    에이전트가 인증·재시도·에러 처리를 직접 다뤄야 합니다. 멀티스텝 워크플로가 길어질수록 코드 복잡도가 빠르게 올라가므로, 도구 수가 적고 호출 빈도가 높은 경우에 가장 효과적입니다.

    Step 5 Preview의 950회 웹 페치는 왜 중요한가요?

    에이전트가 인간의 개입 없이 대규모 도구 호출을 안정적으로 조율할 수 있다는 증거이기 때문입니다. 이런 능력이 보편화되면, 도구 통합의 병목은 “어떤 프로토콜”이 아니라 “어떤 코드를 짜느냐”로 이동합니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — MCP는 처음부터 잘못된 아이디어였을까?

  • K2 호라이즌 6종 분석: 0.9B부터 375B까지 Apache 2.0으로 동시 출시된 IFM 플릿

    K2 호라이즌 6종 분석: 0.9B부터 375B까지 Apache 2.0으로 동시 출시된 IFM 플릿

    핵심 요약

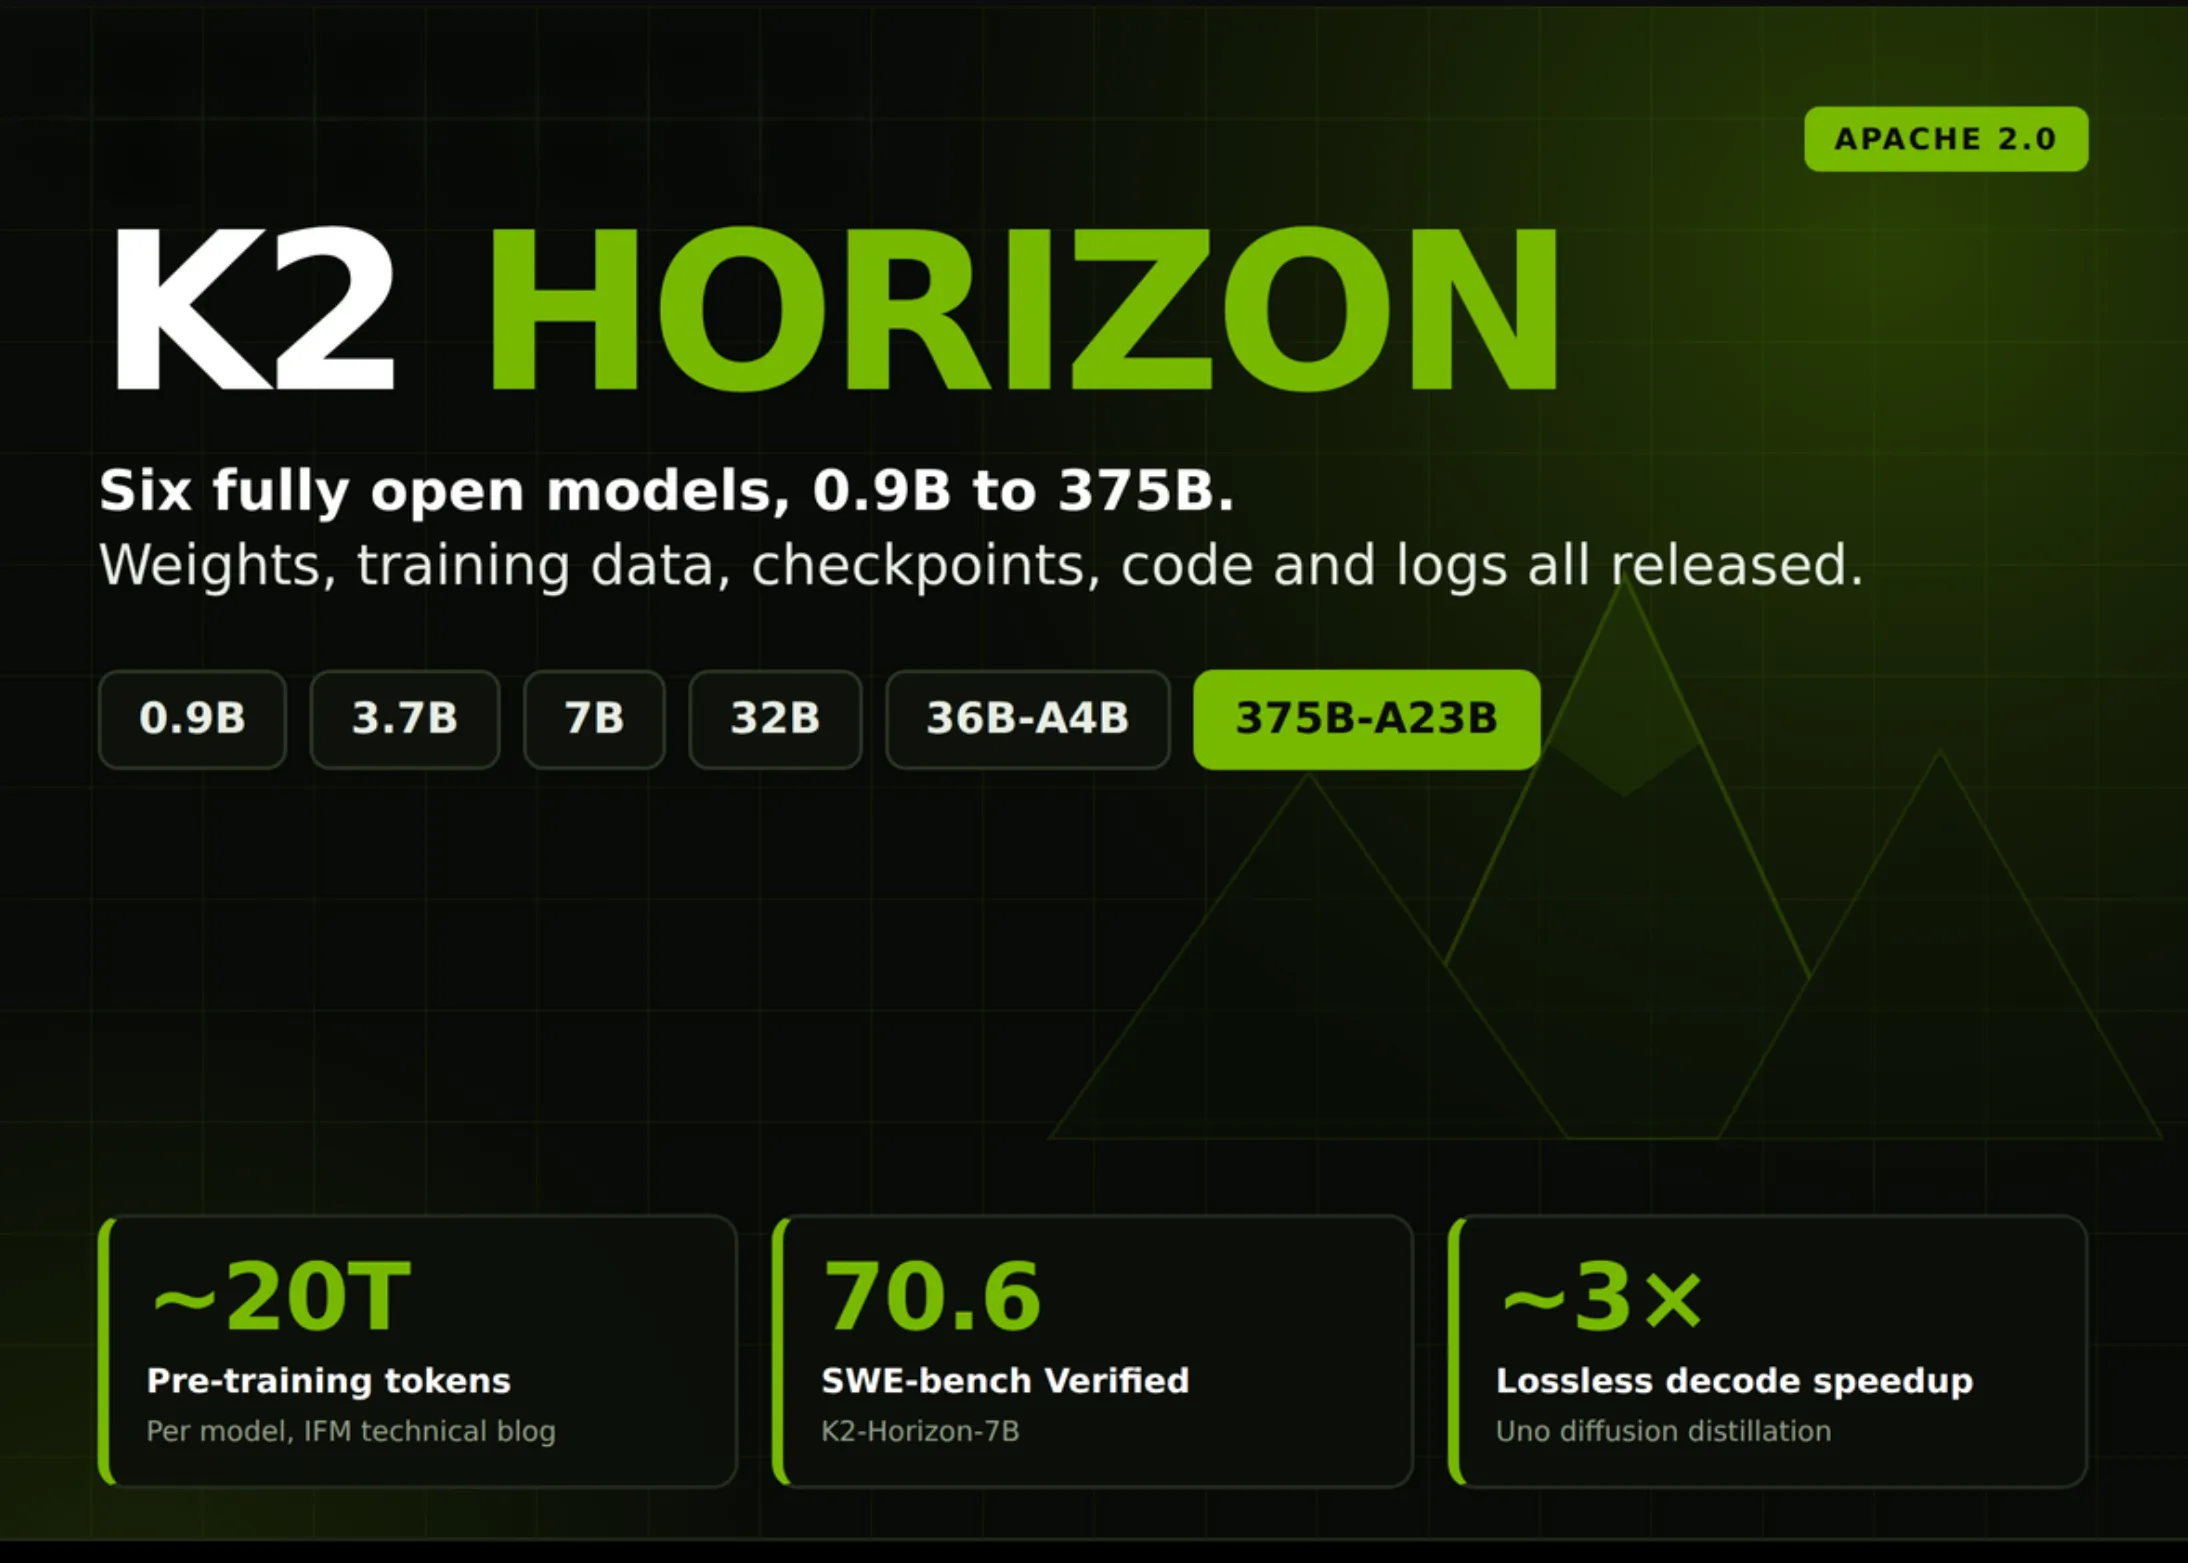
    • 공개 규모: 375B-A23B, 36B-A4B, 32B, 7B, 3.7B, 0.9B 등 6개 모델을 모두 Apache 2.0으로 허깅페이스에 동시 배포 (0.9B는 더 작은 어휘 사용)
    • 오픈스택 동봉: 모델 가중치 외에 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 공개 — IFM은 이를 ‘AI 역사상 가장 큰 완전 오픈소스 출시’로 표현
    • 학습 데이터: 6개 모델 모두 약 20조 토큰으로 사전학습, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰이 합성 데이터

    오픈소스 거대언어모델의 풀스택 공개가 기술·라이선싱·상용화 측면에서 갖는 의미를 분석하고, 동일 아키텍처를 0.9B에서 375B까지 일관되게 운용할 수 있다는 점이 실무에 주는 함의를 짚는 분석형 기사

    목차

    K2 호라이즌 라인업

    K2 호라이즌이 0.9B에서 375B까지 여섯 개 모델을 같은 날 Apache 2.0으로 풀어낸 사건은, 오픈소스 거대언어모델의 풀스택 공개가 어떤 의미를 갖는지를 다시 묻게 만든다. MBZUAI 산하 재단모델 연구소(IFM)가 2026년 9월 공개한 묶음은 가중치뿐 아니라 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 출하되는 ‘플릿(fleet)’ 형식이다.

    필자가 보기에 이 발표의 핵심은 모델 크기나 벤치마크가 아니라 공개 범위다. 0.9B 모델이 더 작은 어휘를 쓴다는 점까지 명시된 것은, 같은 학습 파이프라인을 스케일만 바꿔 반복할 수 있다는 뜻이다. 실무에서 사이즈별로 동일한 인터페이스를 그대로 쓸 수 있다는 점은 통합 운영의 전제가 된다.

    K2 호라이즌 라인업: 0.9B부터 375B-A23B까지

    라인업은 여섯 개 모델로 나뉜다. 0.9B는 축소 어휘, 3.7B·7B·32B는 dense, 36B-A4B와 375B-A23B는 MoE 구성이다. 모든 모델이 동일 토크나이저와 도구 호출 인터페이스를 공유하기 때문에, 같은 코드를 모델 식별자만 바꿔 운용할 수 있다.

    모델 총 파라미터 활성 유형
    0.9B 0.9B 0.9B 축소 어휘 dense
    3.7B 3.7B 3.7B 로컬 추론용 dense
    7B 7B 7B 범용 dense
    32B 32B 32B 고품질 생성 dense
    36B-A4B 36B 4B MoVA MoE
    375B-A23B 375B 23B 플래그십 MoE

    K2 호라이즌 여섯 모델이 같은 합성 태스크 생성기를 거치고, 같은 추론 트레이스 비율(약 17%)로 학습됐다는 점에서 데이터 정렬이 라인업 전체에 일관되게 적용된다. 0.9B에서 검증한 프롬프트 포맷을 375B-A23B로 이식해도 동작이 크게 깨지지 않을 가능성이 높다.

    K2 호라이즌이 가져온 오픈스택의 범위

    IFM은 “AI 역사상 가장 큰 완전 오픈소스 출시”라는 표현을 썼다. K2 호라이즌 배포 묶음에는 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그가 모두 포함된다. 다른 오픈소스 프로젝트가 가중치와 추론 코드 정도만 내놓는 것과 비교하면 범위가 한 단계 다르다.

    중간 체크포인트 공개는 재현성과 직접 연결된다. 375B-A23B를 처음부터 재학습하기는 어렵지만, 중간 단계에서 fine-tuning을 이어 붙이거나 ablation을 시도할 수 있다. 합성 데이터 비율이나 추론 트레이스 비율을 바꿔가며 실험할 표면이 확보된 셈이다.

    학습 데이터 설계: 20조 토큰, 1억+ 태스크

    여섯 모델 모두 약 20조 토큰으로 사전학습됐고, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰은 합성 데이터다. 연구팀은 1억 개 이상의 고유 합성 태스크를 생성했고, 미들 트레이닝 단계에서 포스트 트레이닝 데이터를 점진 반영했다.

    실무자가 주목할 지점은 합성 태스크의 규모다. 필자가 본 가장 흥미로운 수치이기도 하다. 1억 개는 사람이 손으로 설계할 수 있는 범위를 한참 넘는다. 도메인 태스크를 정의해 모델에 주입하는 게 아니라, 태스크 생성 자체를 모델이 맡고 인간이 큐레이션하는 구조로 이동한 것이다. 36B-A4B와 7B 사이의 성능 격차를 따질 때 이 1억 태스크의 분포가 결정 변수가 된다.

    MoVA: 어텐션으로 확장한 MoE의 두 번째 축

    K2 호라이즌 라인업 중 36B-A4B는 MoVA(Mixture-of-Value Attention)를 적용했다. MoE가 피드포워드에서 전문가 라우팅으로 확장 축을 만들었다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합해 어텐션 차원의 두 번째 확장 축을 추가한 것이다. FlashAttention·GQA·sparse attention과 호환되어 기존 서빙 스택을 크게 뜯지 않고 쓸 수 있다.

    MoVA가 흥미로운 이유는 MoE의 파라미터 효율을 한 단계 더 밀어붙일 수 있기 때문이다. K2 호라이즌 상위 라인업이 모두 MoVA로 수렴할지, dense와 MoVA가 공존할지는 지켜볼 지점이다.

    도구 호출 포맷: Markdown의 18.5% 토큰 효율 우위

    IFM은 JSON·XML·Markdown 세 포맷으로 도구 정의를 학습시키고, 추론 기본값을 Markdown으로 설정했다. 측정 결과 Markdown은 JSON 대비 약 18.5% 더 적은 토큰을 사용한다. 같은 결과를 더 적은 토큰으로 만든다는 것은 곧 latency와 비용의 직접적 감소다.

    도구 정의가 길어질수록 Markdown 우위는 커진다. 30~50개 도구를 동시에 노출하는 에이전트는 흔하고, 이 경우 18.5%는 단순한 최적화가 아니라 아키텍처 선택에 가깝다. K2 호라이즌으로 도구 호출 시스템을 설계할 때는 별도 라우터보다 모델이 직접 Markdown 도구 정의를 읽고 호출하게 두는 편이 단순하다.

    서빙 생태계: vLLM·SGLang·Ollama 데이-0 지원

    공개 당일 vLLM·SGLang·Ollama가 데이-0 지원을 받았고, FP8과 GGUF 빌드도 함께 제공된다. NVIDIA뿐 아니라 AMD와 Cerebras까지 대응 범위에 포함된다. IFM 공식 발표에 따르면 호스팅은 Compass, Cerebras, Nebius API와 platform.ifm.ai 게이트웨이로 나뉘며, 같은 가중치를 다양한 스택에서 즉시 시험할 수 있다. 배포 인프라 선택은 AI 칩 아키텍처별 데이터 이동 비용 관점에서 따져볼 만하다.

    데이-0 서빙 지원은 발표의 ‘신호’다. 새 모델은 보통 커뮤니티 패치 후 안정화되는데, K2 호라이즌은 출하 시점에 이미 세 추론 엔진에서 동작한다. 이는 IFM이 오픈소스 모델을 ‘스택’으로 출시한다는 전략적 선택을 보여준다.

    실무 적용 포인트

    사이즈 선택은 호출 빈도와 응답 지연 허용치에 따라 갈린다. 0.9B·3.7B는 분류·라우팅·간단 변환에, 7B는 범용 추론, 32B는 고품질 생성·요약에 배치하는 편이 자원 대비 효율이 좋다. 36B-A4B는 토큰당 4B 활성이라는 점을 활용해 에이전트 라우터나 다중 도구 호출 워크로드에 적합하다. 375B-A23B는 운영비 부담이 크므로 0.9B에서 프롬프트와 도구 정형을 먼저 검증한 뒤 점진적으로 끌어올리는 방식이 안전하다.

    지금 바로 해볼 것

    • Hugging Face에서 K2 호라이즌 0.9B 또는 3.7B 가중치를 받아 vLLM으로 로컬 서빙을 띄워보세요.
    • 동일한 도구 정의를 JSON과 Markdown 포맷으로 각각 작성해 토큰 수와 응답 시간을 비교 측정하세요.
    • 36B-A4B를 받아 MoVA 라우팅이 활성화된 상태에서 다중 도구 호출 시나리오 5개 이상을 실행해보세요.
    • 사전학습 코퍼스 메타데이터에서 합성 태스크 분포를 확인해 사내 도메인 태스크와 가장 가까운 클러스터를 골라 fine-tuning을 시작하세요.

    자주 묻는 질문

    K2 호라이즌 0.9B 모델은 왜 어휘 사전이 다른가?

    엣지 디바이스 타깃 모델이기 때문에 어휘 사전을 줄여 메모리 사용량을 낮췄다. 동일한 학습 파이프라인을 거치지만 추론 환경에 맞춘 축소 어휘를 채택했다.

    Apache 2.0 라이선스로 상용화 가능한가?

    가중치·코드·데이터 모두 Apache 2.0으로 공개됐기 때문에 상용 서비스에 그대로 사용할 수 있다. 단, 재배포 시 동일 라이선스 표기 조건은 지켜야 한다.

    MoVA는 기존 MoE와 어떻게 다른가?

    MoE가 피드포워드에서 전문가를 라우팅한다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합한다. FlashAttention·GQA·sparse attention과 호환되는 것이 특징이다.

    Markdown 도구 호출이 JSON보다 18.5% 효율인 이유는?

    Markdown이 중괄호·따옴표·태그 같은 메타문자가 적기 때문에 동일 의미에 더 적은 토큰이 쓰인다. 도구 정의가 길어질수록 우위는 커진다.

    K2 호라이즌의 공개가 던지는 질문은 단순히 ‘또 다른 오픈소스 모델 출시인가’가 아니다. 같은 파이프라인으로 0.9B부터 375B까지 일관 운용되는 플릿이 Apache 2.0으로 풀려나갔다는 사실은, 오픈소스 LLM 경쟁의 축이 가중치에서 데이터·코드·중간 상태를 포함한 ‘스택’으로 이동했음을 보여준다. 이 변화가 어떤 라이선싱 표준을 만들고, 상용 벤더들이 어떻게 대응할지는 앞으로 몇 분기 동안 판가름될 지점이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — IFM Releases K2 Horizon: Six Apache 2.0 Models From 0.9B to 375B

  • 미니CPM5-2B, 2.5B 파라미터로 34개 벤치마크 평균 53.9 — OpenBMB가 다시 정의한 온디바이스 LLM 기준

    미니CPM5-2B, 2.5B 파라미터로 34개 벤치마크 평균 53.9 — OpenBMB가 다시 정의한 온디바이스 LLM 기준

    핵심 요약

    • MiniCPM5-2B는 2,516,756,480개 파라미터(임베딩 제외 1,981,982,720개)를 가진 dense causal language model로, 42개 레이어와 grouped-query attention(query 16 head, key/value 2 head)을 채택했다.
    • 네이티브 컨텍스트 윈도우는 131,072 토큰이며, 아키텍처가 표준 LlamaForCausalLM이라 vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS에서 커스텀 커널이나 모델 코드 포크 없이 동작한다.
    • 라이선스는 Apache 2.0이고, 같은 크기급 비교 대상으로 LFM2.5-2.6B·Qwen3.5-2B·Gemma-4-E2B-it가, 레퍼런스로 Qwen3.5-4B(51.1)·granite-4.2-3B(42.7)·LFM2.5-2.6B(33.2) 등이 제시된다.

    분석

    목차

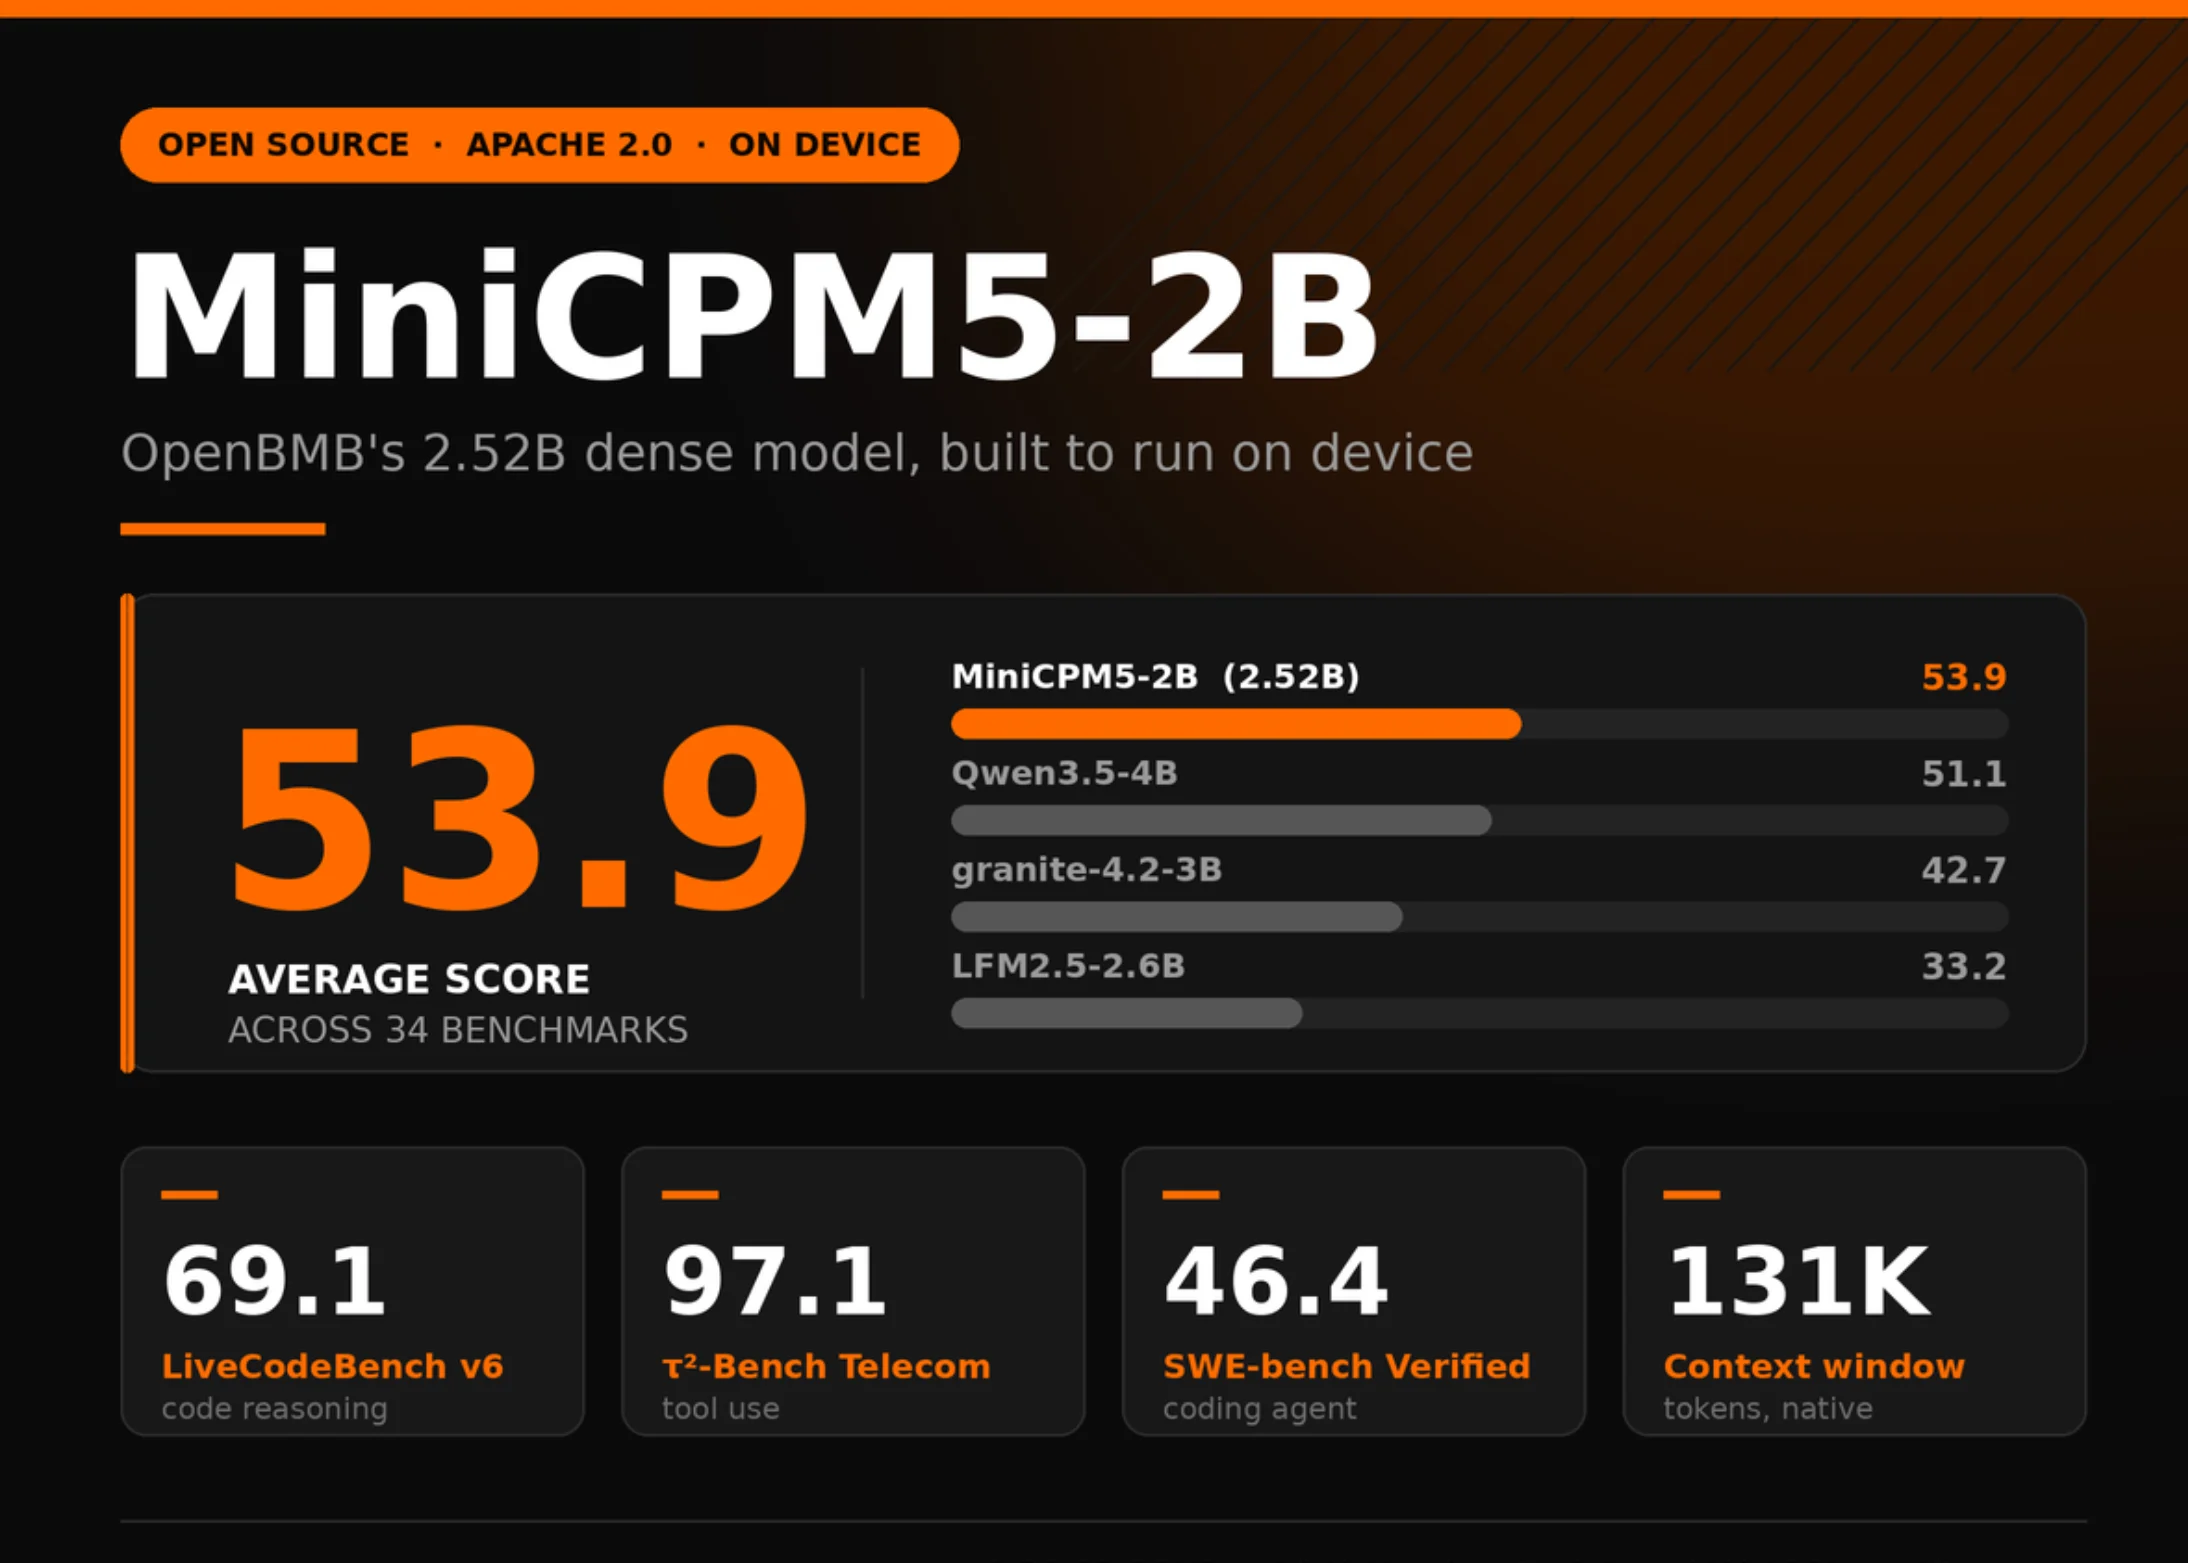
    미니CPM5-2B는 2,516,756,480개 파라미터에 네이티브 컨텍스트 윈도우 131,072 토큰이라는 스펙으로 9월 7일 모습을 드러냈다. 34개 벤치마크 평균 53.9점은 같은 라인업 베이스라인 최고 점수인 Qwen3.5-4B의 51.1을 2.8점 앞서는 수치다. 파라미터 수는 절반이 채 안 되는데 종합 점수는 더 높다. 필자 입장에서 이 모델의 진짜 의미는 “작다고 못 함”을 숫자로 입증한 데 있다.

    미니CPM5-2B 아키텍처: 표준 Llama 포크라 8개 추론 엔진 즉시 호환

    미니CPM5-2B는 42개 레이어에 grouped-query attention(query 16 head, key/value 2 head)을 채택한 dense causal language model이다. 임베딩을 제외하면 1,981,982,720개 파라미터다. 핵심은 아키텍처가 표준 LlamaForCausalLM이라는 점이다. vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS까지 8개 추론 엔진이 커스텀 커널이나 모델 코드 포크 없이 그대로 동작한다. Apache 2.0 라이선스까지 얹혔으니, 2~3B급 모델을 실서비스에 올리려던 팀에게는 가장 마찰이 적은 옵션 중 하나가 됐다.

    미니CPM5-2B, 34개 벤치마크 평균 53.9의 의미

    단일 점수 53.9만 봐서는 감이 안 잡힌다. 분야별로 쪼개 보면 미니CPM5-2B의 성격이 또렷해진다. 같은 크기급 비교 대상으로 LFM2.5-2.6B, Qwen3.5-2B, Gemma-4-E2B-it가, 레퍼런스로는 Qwen3.5-4B(51.1), granite-4.2-3B(42.7), LFM2.5-2.6B(33.2) 등이 제시됐다. 종합 53.9는 이 레퍼런스 풀 안에서 가장 높은 수치다.

    벤치마크 미니CPM5-2B 베이스라인 최고 격차
    34개 종합 평균 53.9 Qwen3.5-4B 51.1 +2.8
    LiveCodeBench v6 69.1 56.4 +12.7
    SWE-bench Verified 46.4 33.6 +12.8
    τ²-Bench Telecom 97.1 — —
    BFCL v4 66.6 — —
    τ³-Bench Banking 20.8 6.8 +14.0
    NoLiMa 68.1 43.5 +24.6
    AA-LCR 59.0 61.0 −2.0
    LongBench v2 43.7 47.3 −3.6
    MMLU-Pro 70.8 78.0 −7.2
    Humanity’s Last Exam 8.9 9.9 −1.0

    강점: 코드 추론과 도구 사용에서 베이스라인을 압도

    격차가 가장 큰 영역은 코드다. LiveCodeBench v6에서 69.1을 찍었고, SWE-bench Verified에서는 46.4로 베이스라인 33.6을 12.8점 차로 제쳤다. 2.5B 모델이 SWE-bench에서 46.4라는 건 단순 코드 완성이 아니라 multi-turn 디버깅까지 포함된 작업에서 절반 가까운 정답률을 내놨다는 의미다.

    도구 사용은 더 가파르다. τ²-Bench Telecom 97.1은 사실상 만점에 가깝고, BFCL v4 66.6, τ³-Bench Banking 20.8(베이스라인 6.8)도 함수 호출과 라우팅이 2.5B급에서 기대할 수 있는 수준을 한참 넘었다. 미니CPM5-2B가 에이전트 워크로드에 실제로 쓸 만한 후보라는 건 이 숫자들이 가장 직접적으로 말해준다.

    균형점: 장문 컨텍스트 항목별 편차와 일반 지식 한계

    모든 항목에서 앞서진 않는다. 장문 컨텍스트는 항목별로 결과가 갈린다. NoLiMa 68.1(베이스라인 43.5)에서는 24.6점 차로 우세하지만, AA-LCR 59.0(61.0)과 LongBench v2 43.7(47.3)에서는 오히려 밀린다. 131K 토큰 윈도우를 갖췄어도 실측 정확도에서 베이스라인을 못 따라가는 구간이 있다는 뜻이다.

    일반 지식도 비슷한 양상이다. MMLU-Pro 70.8(78.0), Humanity’s Last Exam 8.9(9.9) 모두 소폭 열세다. 파라미터가 절반에 가까운 모델이 광범위 사실 회상에서 4B급을 이길 수 없는 건 자연스러우니, 미니CPM5-2B를 “올라운더”가 아니라 “코딩·에이전트 특화 경량 모델”로 보는 편이 정확하다.

    학습 파이프라인: UltraData → 400B SFT → JustRL II → 16 expert 증류

    성적의 배경에는 단계별 학습 설계가 깔려 있다. base 학습은 UltraData 계층형 데이터 관리로 stable·decay 두 단계로 돌아갔고, mid-training 이후 400B 토큰 규모의 deep-thinking SFT가 진행됐다. RL 단계는 math·code·agentic·writing 네 영역을 따로 두고 JustRL II라는 critic 기반 teacher가 학습을 이끌었다. 마지막에 16개 전문가 모델을 단일 체크포인트로 합치는 on-policy distillation까지 붙는다.

    모델 카드는 Artificial Analysis 출처 행과 내부 재현 행을 분리 표기해 평가 일관성 이슈를 미리 명시했다. 재현 가능성을 의식한 흔적이다.

    지금 바로 해볼 것

    • Ollama 또는 llama.cpp로 미니CPM5-2B를 내려받아 Mac·RTX 3090 단일 GPU에서 추론 latency를 직접 측정한다.
    • 내 도메인 코딩 문제 30개를 골라 multi-turn 디버깅을 시켜본 뒤 Qwen3.5-2B·Gemma-4-E2B-it와 응답 품질을 비교한다.
    • BFCL 스타일 함수 호출 시나리오 10개를 만들어 tool-use 정확도를 사내 데이터 기준으로 재평가한다.
    • 131K 컨텍스트에 5만 토큰 분량의 사내 문서를 넣고 검색·요약 정확도를 NoLiMa·AA-LCR·LongBench 항목처럼 직접 점검한다.
    • Apache 2.0 적용 범위를 법무팀과 한 번 확인하고, 사내 파인튜닝 데이터에 대한 라이선스 리스크가 없는지 점검한다.

    실무 적용 포인트

    • 2~3B급을 평가할 때 종합 평균 한 점만 보지 말고 LiveCodeBench·SWE-bench·BFCL 같은 도메인 벤치마크를 가중치에 반영한다.
    • 에이전트 워크로드에 미니CPM5-2B를 쓰려면 함수 호출 라우팅을 별도 검증한다. τ²-Bench 97.1이 일반화 가능한 수치라고 단정하면 안 된다.
    • 장문 컨텍스트가 핵심이면 131K 윈도우 자체보다 AA-LCR·LongBench 같은 실측 항목 점수를 기준으로 모델을 가른다.
    • 온디바이스 배포 시 grouped-query attention의 key/value 2 head 구성 때문에 attention cache 메모리는 작지만 batch throughput은 떨어질 수 있으니 시나리오별로 측정한다.
    • 라이선스 검증이 끝났다면 vLLM·SGLang으로 1차 베이스라인을 띄우고, 부족한 영역은 JustRL II 식 RL 파인튜닝으로 보강하는 순서가 현실적이다.

    자주 묻는 질문

    미니CPM5-2B는 상업 프로젝트에 바로 쓸 수 있나요?

    Apache 2.0 라이선스라 상업적 사용과 2차 배포 모두 허용된다. 다만 모델 출력에 대한 책임은 사용자에게 있으니, 도메인 평가 후 도입 여부를 결정하는 편이 안전하다.

    2.5B 모델이 Qwen3.5-4B보다 점수가 높은데 정말 쓸 만한가요?

    34개 평균 53.9는 사실이다. 다만 우위는 코드와 도구 사용에 집중돼 있고 MMLU-Pro 같은 일반 지식에서는 7점 이상 밀린다. 평가 가중치를 도메인에 맞춰 다시 매겨야 한다.

    미니CPM5-2B는 온디바이스에서 실제로 돌아가나요?

    표준 LlamaForCausalLM 아키텍처라 llama.cpp, Ollama, LM Studio, MLX에서 그대로 실행된다. 다만 131K 컨텍스트 전체를 모바일에서 쓰기보다 8K~32K로 잘라 쓰는 게 현실적이다.

    기존 MiniCPM 모델에서 마이그레이션해야 할 이유가 있나요?

    이전 세대 대비 컨텍스트 윈도우와 코드·에이전트 점수가 동시에 끌어올려졌다. 신규 프로젝트라면 미니CPM5-2B로 시작하되, 기존 시스템은 토큰 사용량과 응답 latency를 비교한 뒤 단계적으로 옮기는 편이 낫다.

    원문 자료는 마크테크포스트의 MiniCPM5-2B 보도에서 확인했다. 비교군 정보는 같은 매체의 IFM K2 Horizon 출시 기사를 참고했다.

  • AI연구 자동화 9월 마일스톤 — OpenAI 내부 보고서가 보여준 코딩 에이전트의 일상 침투

    AI연구 자동화 9월 마일스톤 — OpenAI 내부 보고서가 보여준 코딩 에이전트의 일상 침투

    핵심 요약

    • OpenAI 연구진의 일상 업무에 코딩 에이전트가 깊이 침투했으며, 다수의 동시 세션 형태로 하루 종일 활용되고 있는 것으로 조사됨
    • 에이전트 도입 이후 연구자들이 작성하는 코드량과 수행하는 실험 수가 모두 증가한 것으로 나타남
    • 에이전트에 위임하는 작업의 성격이 단순 보조를 넘어 보다 복잡한 연구 과제로 이동하는 흐름이 관측됨

    분석 – AI 연구 개발 과정 자체가 AI 에이전트로 인해 가속화되는 현상을 1차 자료와 교차 검증해 정리한 심층 분석

    목차

    AI연구 자동화가 OpenAI 내부에서 이미 일상의 일부가 됐다는 보고서가 최근 공개됐다. “Research acceleration: The view inside OpenAI”라는 제목의 글은 OpenAI 공식 보고서에서 직접 확인할 수 있듯, OpenAI 연구진이 코딩 에이전트를 어떻게 쓰고 있는지 1차 데이터로 풀어낸 문서다. 필자가 가장 의미 있다고 본 건 단순한 활용 사례 소개가 아니라, 같은 글에서 자동화 인턴·자동화 연구원 로드맵을 명시적으로 공개했다는 점이다.

    연구실 안의 동료가 달라졌다

    OpenAI 연구자들은 코딩 에이전트를 하루 종일 켜놓는다는 게 이 보고서의 첫 번째 정보다. 동시에 여러 세션을 열어두고, 모델이 코드를 짜는 동안 다른 작업을 하는 패턴이 상시화됐다고 한다. 흔히들 “에이전트를 써본다” 수준으로 말하지만, OpenAI 내부에서는 이미 ‘동시에 여러 작업을 맡기는 인프라’에 가깝게 자리 잡은 것으로 분석된다.

    결과는 두 가지 수치로 나타난다. 연구자가 직접 작성하는 코드량이 줄지 않았는데도 실험 실행 횟수는 늘었고, 에이전트에 위임하는 작업의 성격도 변했다. ‘함수 하나 고쳐줘’ 수준을 넘어 ‘이런 가설을 검증해줘’ 같은 정의된 연구 과제로 이동하고 있다는 설명이다. 단순 보조에서 조수에 가까운 자율 작업으로 무게중심이 옮겨간 것으로 보인다.

    AI연구 자동화 로드맵: 9월, 그리고 2028년 3월

    보고서에는 두 개의 날짜가 박혀 있다. 하나는 올해 9월까지 확보하겠다는 ‘자동화 연구 인턴’이고, 다른 하나는 2028년 3월까지 인간 감독 하에 딥러닝 및 정렬 연구를 스스로 진전시키는 ‘자동화 AI 연구원’이다. 전자는 정의된 연구 과제를 인간 지시 아래 며칠 동안 수행할 수 있는 시스템, 후자는 인간의 손을 거의 빌리지 않고도 연구 방향을 굴릴 수 있는 시스템을 뜻한다.

    실무자 입장에서 눈에 띄는 건 ‘자동화 인턴’의 기준이 ‘코드를 짜는 AI’가 아니라 ‘연구 과제를 받는 AI’라는 점이다. 가설 정의, 실험 설계, 결과 해석이 한 묶음으로 위임되는 단위가 이미 내부적으로 유효하다는 뜻이다. 이 기준이 충족됐다는 건, AI연구 자동화의 다음 단계가 단순 코딩 보조가 아니라 연구자 한 명의 작업 묶음이라는 의미로 읽힌다.

    AI연구 자동화의 누적 곡선

    OpenAI 수석과학자 Jakub Pachocki의 “An alien mind” 글은 이 흐름을 과거로 거슬러 올라가게 한다. 2023년 중반 RLSlow 프로젝트에서 추론 모델 학습의 확장 가능성이 처음 확인된 시점을 출발점으로 삼고, 그 위에 o-시리즈 같은 추론 모델이 자리 잡았다는 설명이다. Pachocki는 추론 언어 모델이 경제 전반과 사이버 보안 영역까지 빠르게 확산되고 있다고 진단한다.

    읽어보면 9월 마일스톤이 갑자기 등장한 게 아니라는 감이 온다. 추론 모델이 코드를 짜고, 그 코드가 다시 추론 모델을 학습시키는 피드백 루프가 2~3년 동안 가속돼 왔고, 그 끝에 ‘자동화 인턴’이라는 표현이 등장했다. AI연구 자동화의 진척은 별개의 이벤트가 아니라 누적 곡선의 한 지점으로 해석하는 편이 자연스럽다.

    쟁점: 거버넌스, 페이싱, 통제

    이 로드맵이 단순한 엔지니어링 진척이 아니라 거버넌스 이슈를 건드리는 이유는, 자동화 연구원이 가속을 결정할수록 정렬 연구도 같이 가속된다는 점이다. 인간 감독이라는 단어가 보고서에 여러 번 등장하지만, 가속도가 빨라질수록 감독 한 단위의 의미가 가벼워질 수 있다. 모델 개발 페이싱, 내부 통제 구조, 외부 공개 시점 — 이 세 가지가 다음 1~2년의 쟁점이 될 가능성이 높다.

    AGI 민주적 통제 논의와 맞닿는 부분도 있다. 자동화 연구원이 실제로 연구 방향을 제안하기 시작하면, ‘왜 이 연구를 하는가’를 결정하는 권위는 누구에게 있는가라는 질문이 생긴다. OpenAI 내부에서 출발한 흐름이지만, 외부 학계·정책권의 반응이 이 기술보다 더디다면 통제 공백이 길어질 수 있다. AI연구 자동화는 곧장 연구 거버넌스의 속도 문제로 이어진다는 게 이 보고서에서 가장 무거운 부분이다.

    쟁점 정리

    • 자동화 인턴의 ‘단위’가 코드가 아니라 연구 과제라는 점 — AI연구 자동화의 정의 자체가 바뀌고 있다.
    • 2028년 3월 마일스톤은 ‘속도’가 아니라 ‘감독의 의미’를 다시 묻는다.
    • 정렬 연구와 성능 연구가 같은 속도로 가속될 때, 외부 통제와 내부 통제 사이의 격차가 핵심 리스크다.

    지금 바로 해볼 것

    • 자신의 일과에서 동시에 열어두는 에이전트 세션 수를 한 주간 측정해 기록한다 — 단순 활용도와 진짜 활용도의 차이를 가른다.
    • 팀 위임 작업을 ‘단순 보조’와 ‘정의된 과제’ 두 카테고리로 분류해 비율을 본다 — AI연구 자동화 도입의 다음 단계를 가늠한다.
    • 정렬·안전 검토 체크리스트를 ‘에이전트가 제안한 가설’까지 포함하도록 확장한다 — 9월 이후 시나리오에 대비한다.
    • 에이전트가 만든 PR과 실험을 별도 태깅해 추적 파이프라인을 만든다 — 자동화 비율의 기준점을 확보한다.
    • 거버넌스 담당자에게 ‘자동화 연구원’ 시나리오를 사전 공유하고 의사결정 지연을 한 번 시뮬레이션한다 — 통제 공백의 길이를 가늠한다.

    자주 묻는 질문

    자동화 연구 인턴은 일반 코딩 에이전트와 무엇이 다른가?

    OpenAI 보고서가 정의한 자동화 연구 인턴은 ‘함수 짜기’ 수준이 아니라, 인간이 지시한 연구 과제를 며칠 단위로 수행하고 결과를 보고하는 단위다. 가설 설정과 실험 설계가 한 묶음으로 위임된다.

    2028년 3월 마일스톤은 왜 중요한가?

    이 날짜까지 인간 감독 하에 딥러닝과 정렬 연구를 스스로 진전시키는 시스템을 만들겠다는 선언이다. 속도 자체보다 ‘감독이라는 단어가 실제로 갖는 무게’가 흔들릴 수 있다는 점에서 의미를 가진다.

    RLSlow 프로젝트는 지금의 흐름과 어떻게 연결되는가?

    2023년 중반 RLSlow에서 추론 모델 학습의 확장 가능성이 처음 확인되었고, 그 위에 o-시리즈 같은 추론 모델이 자리 잡았다. 9월 마일스톤은 그 누적 곡선의 한 지점이지 갑작스러운 전환점이 아니다.

    에이전트를 이미 쓰고 있다면 추가로 무엇을 해야 하나?

    활용도 측정과 위임 작업 분류, 자동화 비율의 기준점 확보가 즉시 가능한 액션이다. 이 데이터 없이 다음 단계의 AI연구 자동화를 설계하면 거버넌스 공백이 먼저 열린다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: OpenAI Blog — Research acceleration: The view inside OpenAI