
핵심 요약
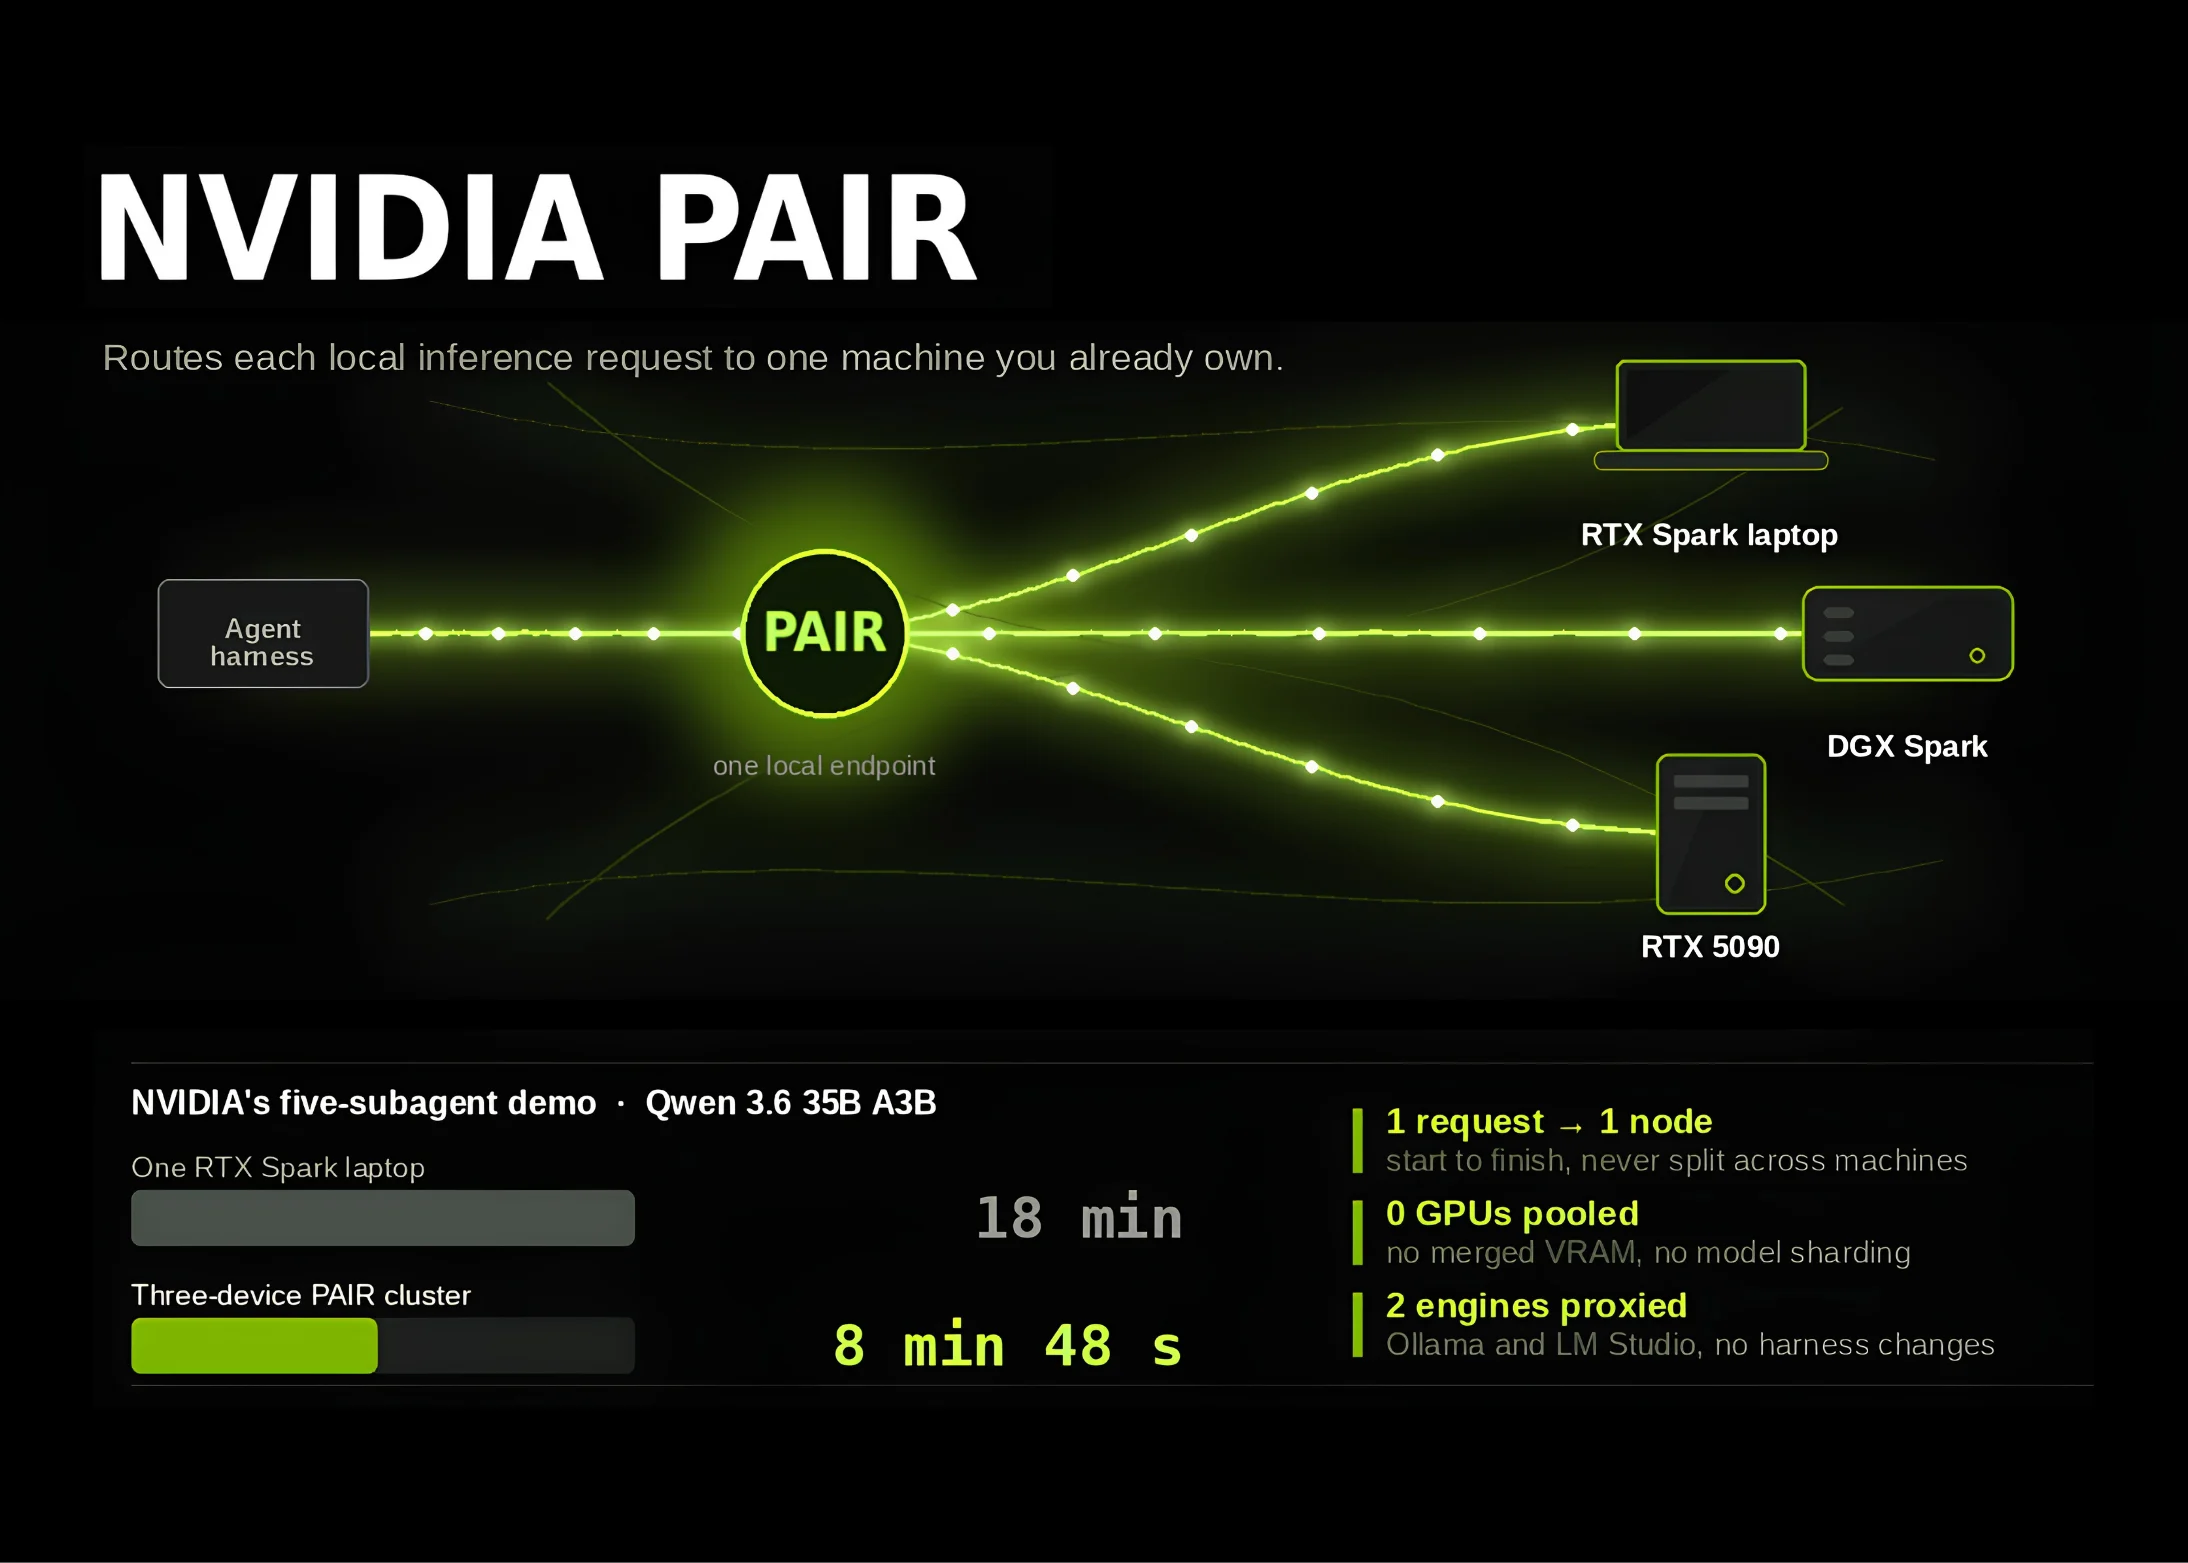
- PAIR는 신규 추론 엔진이 아니라 기존 Ollama/LM Studio 엔진을 로컬 네트워크상에서 분산 라우팅하는 가상 추론 라우터임
- 공개 베타 v0.1.1로 공개됐으며 Windows·macOS·Linux용 서명 설치본이 제공되고 GitHub에는 Apache 2.0 라이선스로 전체 소스가 공개됨
- PAIR는 클러스터용 신규 API를 도입하지 않고 Ollama 호환·LM Studio 호환·OpenAI 호환 엔드포인트를 프록시해 기존 에이전트 하네스의 변경을 최소화함
분석
목차
책상 위에 RTX 한 대, 서재에 Mac mini 한 대, 거실에 DGX Spark 한 대. 이렇게 흩어진 GPU를 한 군데로 묶어 단일 엔드포인트처럼 쓸 수 있게 해주는 것이 엔비디아 PAIR다. 핵심부터 말하면 엔비디아 PAIR는 새로운 추론 엔진이 아니다. 기존 Ollama, LM Studio 같은 엔진을 로컬 네트워크에서 분산 라우팅하는 가상 계층이다.
“왜 라우터만 따로 만들었을까”라는 의문이 먼저 든다. 필자가 보기에 답은 멀티에이전트 워크플로우의 성장에 있다. 서브에이전트가 5~10개로 늘면 한 머신의 GPU는 금방 막히고, 에이전트 하네스는 매번 엔드포인트를 바꿔 달라는 요구를 받아왔다. 엔비디아 PAIR는 Ollama·LM Studio·OpenAI 호환 세 엔드포인트를 모두 프록시한다. 기존 코드를 거의 건드리지 않고 트래픽을 분산시킬 수 있다는 뜻이다.
엔비디아 PAIR 배포 형태 — 서명 설치본과 Apache 2.0
공개 베타 v0.1.1이 Windows, macOS, Linux용 서명 설치본으로 배포됐다. GitHub에는 Apache 2.0으로 전체 소스가 공개돼 있어 상용 빌드를 그대로 쓸 수 없는 조직도 검토 대상으로 올라온다. 사양과 다운로드 경로는 MarkTechPost의 1차 보도에서 확인된다.
노드 관리 — mDNS 탐지와 6자리 PIN, mTLS
엔비디아 PAIR는 같은 서브넷의 기기를 mDNS로 먼저 탐지한다. 탐지가 실패하면 IP를 수동으로 더할 수 있고, 페어링은 6자리 PIN 한 번이면 끝난다. 이후 트래픽은 생성형 인증서 기반 mTLS로 암호화된다. VPN 없이 사무실 LAN에서 굴려도 평문 노출 우려가 줄어든다는 점이 운영자에게 매력적이다.
실무자 입장에서 눈에 띄는 건 셋업 자동화다. 페어링된 노드에는 원격으로 엔진 설치와 모델 다운로드를 트리거할 수 있다. 30GB 임베딩 모델을 다섯 대에 일일이 받아두던 수작업이 사라진다. 첫 부팅 한 대만 운영자가 잡아주면 엔비디아 PAIR가 나머지를 채운다.
엔비디아 PAIR 호환성 — 하네스 무변경 전략
엔비디아 PAIR가 클러스터용 새 API를 들고 오지 않은 점이 중요하다. 에이전트 하네스가 이미 Ollama나 OpenAI 엔드포인트를 알고 있다면 라우터 주소만 가리키게 바꿔주면 그대로 동작한다. 같은 흐름은 로컬 에이전트 워크플로 확장을 다룬 글에서도 같은 방향으로 읽힌다.
| 엔드포인트 | 기반 엔진 | 대표 활용처 |
|---|---|---|
| Ollama 호환 | Ollama | 레거시 에이전트, 커스텀 도구 |
| LM Studio 호환 | LM Studio | 데스크톱 GUI 워크플로 |
| OpenAI 호환 | 다수 백엔드 | LangChain, LlamaIndex 계열 |
성능 시사점 — 5서브에이전트 데모
보도된 5서브에이전트 데모에서 단일 RTX Spark 노드 기준 평균 18분이던 작업이 다중 노드 분산 시 약 8분대까지 단축됐다고 한다. 보도된 수치의 후행 비교 문맥은 확인되지 않지만, “워크플로우 단위 시간”이 줄었다는 정황은 의미 있다. 서브에이전트 수를 늘리면서도 응답성을 유지할 여지가 생긴 셈이다.
다만 이 수치는 특정 모델·프롬프트 조합의 결과다. 실무 도입 시에는 자사 워크플로우로 마이크로벤치를 돌려 보는 편이 안전하다. 엔비디아 PAIR의 가치는 신규 GPU를 사는 것보다 이미 책상 위에 있는 기기를 다시 살리는 데 있다는 관점이 현실적이다. 데이터 거버넌스 측면에서도 로컬에 머무는 트래픽이 늘어난다는 점에서 의의가 있다.
실무 적용 포인트
- 기존 Ollama·LM Studio 인스턴스를 그대로 두고 라우터만 얹는 도입 경로를 우선 검토한다.
- 6자리 PIN과 mTLS 인증서가 자동 발급되는 흐름을 사내 보안 가이드라인과 미리 정렬한다.
- 멀티에이전트 워크플로우의 서브에이전트 수와 모델 크기에 맞춰 분산 후보 노드 목록을 사전에 정의한다.
- 원격 모델 다운로드 트리거를 켜기 전에 사내 프록시·대역폭 정책과 충돌 여부를 확인한다.
지금 바로 해볼 것
- GitHub에서 v0.1.1 릴리스 노트를 받아 서명된 설치본 해시를 검증한다.
- 데스크톱 한 대에서 Ollama 또는 LM Studio를 띄우고 엔비디아 PAIR 라우터 주소로 프록시되는지 확인한다.
- LAN 안의 두 번째 노드를 mDNS로 자동 탐지되는지 확인하고, 안 잡히면 IP 수동 추가까지 시험한다.
- 6자리 PIN 페어링 후 mTLS 인증서가 양쪽 노드에 정상 발급되는지 로그로 검증한다.
- 자주 쓰는 에이전트 하네스를 OpenAI 호환 엔드포인트로 가리키게 바꾸고 응답 라운드트립을 측정한다.
자주 묻는 질문
엔비디아 PAIR는 새로운 추론 엔진인가요?
아니다. 엔비디아 PAIR 자체는 모델을 실행하지 않는다. 기존 Ollama, LM Studio 엔진을 찾아 트래픽을 보내주는 라우터일 뿐이다. 따라서 기존에 쓰던 모델과 프롬프트는 그대로 유지된다.
클러스터 전용 새 API를 배워야 하나요?
배울 필요는 없다. Ollama, LM Studio, OpenAI 호환 엔드포인트를 모두 프록시하므로 에이전트 하네스에서는 라우터 주소를 가리키게 한 줄만 바꾸면 끝이다.
외부 인터넷이 차단된 사무실에서도 동작하나요?
mDNS와 mTLS로 노드 간 통신이 모두 끝나기 때문에 LAN 안에서 폐쇄적으로 운영할 수 있다. 다만 초기 모델 다운로드는 한 번은 외부로 나가야 한다.
라이선스 부담은 어느 정도인가요?
GitHub의 소스는 Apache 2.0으로 공개돼 있다. 사내에서 컴파일, 수정, 재배포가 모두 가능하고 저작권 표시와 변경 고지 의무만 지키면 된다.
답글 남기기