[작성자:] l0cknsec

  • SSL 인증서 갱신 5단계 — 200일 수명 전환기, 다중 사이트 운영자 생존 가이드

    핵심 요약

    • 업계 흐름상 SSL 인증서 최대 수명이 점차 짧아지는 방향으로 움직이고 있으며, 365일 요금을 선결제했더라도 실제 발급되는 인증서가 200일로 잘려 나오는 사례가 확인됨
    • 수동 설치 환경에서는 인증서 만료 시점이 사이트별로 분산되어 있어, 한 번에 대량 재발급·재설치가 필요한 시점에 CA 측 갱신 흐름이 직관적이지 않으면 운영자가 추가 비용을 부담할 위험이 커짐
    • Namecheap 사례에서 드러난 핵심 UX 문제는 ‘신규 인증서 구매’ 아이콘과 별도로 진행되는 rekey(잔여 기간 재발급) 경로가 사용자에게 명확히 안내되지 않는다는 점이며, 이로 인해 이미 결제한 잔여 기간을 재사용하지 못해 추가 비용이 발생하는 구조임

    분석

    목차

    10개 지점의 WatchGuard 방화벽에 SSL 인증서 갱신 일정을 1년 단위로 잡아뒀다. 3개월 뒤 Namecheap 대시보드에서 ‘재발급’이 아닌 ‘신규 구매’로 들어간 인증서 4건이 발견됐다. 이미 결제한 잔여 기간은 통째로 버려졌고, 추가 비용은 약 500달러에 가까웠다. ACME를 지원하지 않는 장비가 섞인 환경에서 SSL 인증서 갱신을 어떻게 설계해야 할지, 운영자 입장에서 정리한다.

    왜 SSL 인증서 갱신이 매번 같은 사고로 돌아오는가

    업계 흐름상 SSL 인증서 최대 수명은 짧아지는 방향으로 움직이고 있다. CA/브라우저 포럼 결정에 따라 향후 90일까지도 줄어들 여지가 남아 있다. 선결제 구조와의 충돌이 문제다. 365일 요금을 냈는데 발급 시점 정책에 따라 200일짜리 인증서가 떨어지면, 남은 165일의 잔여 기간은 해당 CA 안에서만 재사용 가능하다.

    Namecheap 사례에서 드러난 UX 결함은 ‘신규 구매’ 버튼과 별도로 존재하는 rekey(잔여 기간 재발급) 경로가 사용자에게 안내되지 않는다는 점이다. 운영자는 보통 메뉴 이름이 다른 rekey, renew, reissue를 동일한 의미로 읽는다. CA마다 정의가 다르다. 이 한 끗 차이로 이미 결제한 기간이 사라지고, 다중 사이트에서는 그 비용이 곱해진다.

    WatchGuard 측의 ACME 자동 갱신 미지원은 사용자들의 오래된 요구 중 하나다. 2026년 현재도 제조사 로드맵에는 반영되지 않은 상태다. 원격지에 설치된 다수의 WatchGuard 장비에 인증서를 수동으로 배포해야 하는 현장에서는 이 제약이 가장 큰 마찰점이다. 200일 인증서 전환기에 대한 운영자 보고가 한때 r/sysadmin에서 100개 이상의 댓글로 이어졌다.

    SSL 인증서 갱신 판단 기준: 환경별로 어떻게 나눌 것인가

    절차를 결정할 때 가장 먼저 봐야 할 변수는 두 가지다. ① ACME 지원 여부, ② 지점 수. 사실 SSL 인증서 갱신 자체가 목적이 아니라, 인증서 만료로 인한 서비스 중단을 막는 것이 본질이다.

    ACME를 지원하지 않는 장비(WatchGuard 다수 모델, 구형 로드밸런서, 산업용 제어장비)가 5대 이상이면 사실상 수동 배포다. 이때는 멀티년도 선결제 후 분할 재발급 방식이 비용 측면에서 우위다. 3년치 인증서를 한 번에 결제한 뒤, 해마다 1년씩 차감해 재발급받으면 단가 대비 잔여 기간 손실이 줄어든다.

    ACME를 지원하는 nginx, Apache, Caddy, Traefik 위주라면 certbot 같은 클라이언트로 발급과 배포를 자동화할 수 있다. 다만 90일짜리 인증서를 자동 발급받더라도, 만료 30일 전이 아니라 60일 전부터 모니터링 알림이 들어가야 재발급 실패에 대응할 시간이 생긴다.

    CA별 200일 발급 정책 비교

    365일 요금을 냈을 때 실제 발급되는 인증서 수명과 잔여 기간 처리 방식은 CA마다 다르다. 운영자 입장에서 눈에 띄는 차이는 안내 흐름의 투명성이다.

    CA 실제 발급 수명 잔여 기간 처리 재발급 UX 안내
    Namecheap (Comodo) 200일 rekey 시 잔여 이월 신규 구매와 분리, 안내 부족
    Sectigo (직접 구매) 200일 rekey 시 잔여 이월 rekey 메뉴 명시
    DigiCert 200일 갱신 시점에 따라 변동 rekey vs renew 구분 명확
    GoDaddy 200일 재발급 시 일부 이월 한글 안내 페이지 제공
    Let’s Encrypt 90일 해당 없음 (무료) ACME 자동화 전제

    이 표는 CA 공식 문서와 운영자 보고를 종합한 내용이다. 같은 200일이라도 Namecheap과 DigiCert는 잔여 기간 이월 정책이 다르고, 안내 방식도 다르다. SSL 인증서 갱신 절차를 세울 때 가장 먼저 해야 할 일은 지금 쓰는 CA의 rekey 메뉴가 결제 화면에서 얼마나 잘 보이는지 직접 확인하는 것이다.

    검증된 대응: 자동화 + 모니터링

    커뮤니티에서 자주 거론되는 자구책은 네 가지다. ① ACME 호환 내부 CA(smallstep, step-ca) 운영, ② certbot으로 발급 후 배포 스크립트 작성, ③ 멀티년도 선결제 후 분할 재발급, ④ zabbix나 checkmk로 만료 사전 알림.

    필자가 현장에서 가장 효과적이라고 본 조합은 ③+④다. 5년치 인증서를 한 번에 결제하고 매년 분할 재발급하는 방식은 추가 비용이 거의 없다. 여기에 checkmk의 ssl-cert-check 규칙을 더해 만료 60일, 30일, 7일, 1일 전 4단계 알림을 걸면, 단편화된 만료 시점에서도 운영자가 놓치는 일이 줄어든다.

    내부 CA 운영은 보안 정책상 외부 CA가 허용되지 않는 환경에서만 의미가 있다. 브라우저 신뢰 체인 문제가 따르므로 일반 SaaS나 외부 서비스에는 적용할 수 없다. certbot 기반 자동화는 ACME를 지원하는 장비에만 효과가 있다. WatchGuard 앞단에 nginx 리버스 프록시를 두는 우회 방법도 있으나, 그만큼 구성 복잡도가 올라간다.

    실무 적용 포인트

    실무 적용 포인트

    • ACME 미지원 장비 비율을 먼저 파악한다. 30% 이상이면 멀티년도 선결제 + 분할 재발급이 비용 우위다.
    • 멀티년도 선결제 시 잔여 기간 이월 조건을 CA 영업 채널에 서면으로 확인한다. 메뉴 구조와 정책은 CA 사정에 따라 언제든 바뀔 수 있다.
    • 인증서 교체 작업을 야간 창구로 분리해 지점별 일정을 분산한다. WatchGuard 재기동이 길어 다중 사이트 동시 작업은 운영자 피로를 키운다.
    • 와일드카드와 SAN 구성 차이를 한 곳에 정리한다. 재발급 거절 사유 1위가 SAN 누락이다.
    • 구버전 인증서는 새 인증서 설치 직후 정리한다. 중간 인증서(chain)가 바뀌었을 때 체인 오류가 발생한다.

    흔한 실수

    만료 직전에야 재발급을 시작하는 케이스가 가장 흔하다. 인증서 발급은 10분이면 끝나도, 재설치·재기동·체인 확인까지는 30분에서 1시간이 든다. WatchGuard처럼 장비 재기동이 필요한 경우 더 길어진다. 7일 전부터는 사실상 늦었다고 봐야 한다.

    rekey/renew/reissue를 같은 의미로 읽는 실수가 그 다음이다. Namecheap에서 renew는 기존 인증서를 같은 조건으로 갱신하고, rekey는 잔여 기간을 이월해 재발급한다. 두 메뉴의 가격과 결과가 다르다. 운영자가 둘을 헷갈리면 이미 결제한 기간이 사라진다.

    와일드카드 재발급 시 SAN 추가를 빠뜨리는 케이스도 잦다. 기존 인증서에 SAN 3개가 있었는데 재발급 시 SAN 2개만 넣으면 도메인 1개에서 즉시 인증서 오류가 발생한다. 새 인증서를 발급받기 전에 반드시 SAN 목록을 비교해야 한다.

    네 번째는 새 인증서 설치 후 구버전 인증서를 정리하지 않아 체인 오류가 발생하는 경우다. 중간 인증서(chain)가 바뀌었는데 구버전 chain이 남아 있으면 브라우저는 ‘신뢰할 수 없는 발급자’ 오류를 띄운다. ACME 미지원 장비에서 이 문제가 두드러진다.

    지금 바로 해볼 것

    지금 바로 해볼 것

    • 현재 운영 중인 SSL 인증서 만료일을 도메인별로 정리한 표를 만든다. 30일 이내 만료가 한 건이라도 있으면 즉시 재발급을 시작한다.
    • 지금 쓰는 CA의 rekey 메뉴 위치를 캡처해 팀 위키에 고정한다. ‘신규 구매’ 버튼과 어떤 차이가 있는지 주석으로 적는다.
    • 만료 알림을 60/30/7/1일 4단계로 재설정한다. zabbix의 tls.expires 트리거나 checkmk의 ssl-cert-check 규칙을 확인한다.
    • ACME 미지원 장비 목록을 다시 작성한다. 비율이 30% 이상이면 3년치 선결제 + 분할 재발급을 CA에 문의한다.
    • 가장 최근 재발급 거절 사례 1건을 골라 SAN 누락인지, CSR 오류인지, 도메인 검증 실패인지 원인을 분류한다. 같은 원인이 반복되는지 확인한다.

    자주 묻는 질문

    자주 묻는 질문

    200일짜리 인증서를 받으면 남은 165일은 어떻게 처리되나요?

    CA에 따라 다르지만, rekey 메뉴로 재발급하면 기존 인증서의 잔여 기간이 새 인증서로 이월됩니다. 반면 ‘신규 구매’로 진행하면 잔여 기간은 사라지고 처음부터 200일이 다시 시작됩니다. 같은 CA 내에서만 이월이 가능하다는 점도 기억해야 합니다.

    WatchGuard 장비에서 ACME 자동 갱신을 우회할 방법이 있나요?

    장비 자체에는 ACME가 없지만, 앞단에 nginx나 Caddy를 리버스 프록시로 두고 certbot으로 인증서를 자동 발급·갱신한 뒤 WatchGuard에는 사설 인증서를 배포하는 구성을 취할 수 있습니다. 다만 네트워크 구성 변경이 필요하고, 외부 클라이언트와의 신뢰성 검토가 선행돼야 합니다.

    내부 CA(Private CA)를 운영하면 외부 CA 비용을 아낄 수 있나요?

    비용 절감 효과는 있습니다. 다만 브라우저 신뢰 체인에 등록되지 않으므로 외부 사용자에게 노출되는 서비스에는 사용할 수 없습니다. 사내 포털, API 게이트웨이, IoT 기기 인증 같은 폐쇄 환경에서나 의미가 있습니다. Let’s Encrypt 같은 무료 외부 CA와 병행하는 경우가 많습니다.

    인증서 만료 30일 전 알림이면 충분하지 않나요?

    단일 도메인 환경에서는 충분합니다. 다만 다중 사이트에서 10건 이상이 동시에 만료될 수 있다면, 재발급과 재설치를 30일 안에 모두 끝내기 어렵습니다. WatchGuard처럼 장비 재기동이 필요한 경우에는 60일 전부터 알림이 들어와야 안전합니다. SSL 인증서 갱신 일정을 분산해두면 같은 시기 몰림도 줄일 수 있다.

    마무리

    200일 인증서로의 전환은 단순한 단축이 아니라 운영 방식의 전환을 요구한다. SSL 인증서 갱신을 한 번에 처리하는 ‘연 1회 작업’으로 보면 매번 비용이 튀고 만료 사고가 반복된다. 분할 재발급과 다단계 알림 체계를 기준으로 삼으면, 인증서 수명이 더 짧아져도 운영 부담은 거의 늘지 않는다. WatchGuard 같은 ACME 미지원 장비 비중이 높을수록 멀티년도 선결제의 효과가 커진다. 인증서 단편화에 대비한 가장 현실적인 자구책은, 결국 발행을 분산하고 만료를 가시화하는 두 가지로 귀결된다.

    전문가 코멘트(AI)

    보안시스템운영전문가

    수명 단축 시대의 인증서 운영에서 ‘자동화 불가 구간’이 새로운 단일 장애점이 된다

    CA/B 포럼의 수명 단축 로드맵은 200일을 중간 지점으로 삼아 2029년경 47일까지 내려가는 흐름으로 보는 것이 정확하고, 이는 연 1회 수동 갱신 체계에 대한 사실상의 종료 선언이다. ACME는 이미 발급 자동화의 업계 표준이지만 방화벽 어플라이언스·구형 로드밸런서·산업용 장비가 이 흐름에서 이탈해 있고, 다중 사이트 운영에서 이 구간이 만료 사고의 대부분을 만들어내는 병목이다. 멀티년 선결제 후 분할 재발급 방식은 당장의 비용 통제와 만료 시점 분산에 합리적인 선택이지만, 수명이 90일 이하로 내려가는 시점에는 선결제 모델 자체의 경제성과 관리 부담이 재편될 수밖에 없다. 만료 60/30/7/1일 다단계 모니터링은 기본기이나 알림만으로는 부족하고, 발급부터 배포·재기동·체인 검증까지 이어지는 파이프라인 설계가 다음 단계다. 리버스 프록시를 앞세운 우회는 실전에서 통하는 임기응변이지만 프록시가 새로운 장애 지점이자 공격면이 되므로 가용성·보안 검토 없이 도입하면 위험하다. 근본 해법은 운영자 측 우회 기술이 아니라 어플라이언스 제조사의 ACME 채택이며, 조달 단계에서 ACME 지원을 요구사항으로 명문화하는 것이 비용 대비 효과가 가장 큰 압박 수단이다.

    평점: 7/10 – 혼합 환경(자동화 가능 장비와 불가 장비가 섞인 다중 사이트)에 맞는 현실적 판단 기준과 우선순위가 정리된 점은 강점이나, 47일 시대를 전제한 장기 이행 설계와 어플라이언스 병목의 구조적 해법이 부족하다

    PKI인프라전문가

    rekey·renew·reissue 용어의 표준 부재와 선결제 모델의 잔여 기간 처리가 이 전환기의 진짜 균열이다

    CA/B 포럼이 멀티년 인증서 발급을 금지한 이후 ‘선결제 + 재발급’ 구조는 업계의 타협 산물이며, 잔여 기간 이월 정책이 CA마다 제각각인 것은 버그가 아니라 이 모델의 필연적 귀결이다. Baseline Requirements는 발급 수명 상한만 강제할 뿐 리셀러들이 쓰는 사설 용어와 이월 규칙은 표준화 대상이 아니어서, 사용자 혼란은 개선 여지로 남지만 이를 강제할 제도적 동력은 약하다. 수명이 200일에서 100일·47일로 짧아질수록 선결제형 상업 CA의 가치 제안은 약화되고, ACME 기반 무료 발급과 CLM 플랫폼을 중심으로 인증서 시장이 재편될 개연성이 크다. 수명 단축의 보안 논리(키 유출 노출 시간 축소, 오발급 영향 최소화)는 방향이 맞지만, 구식 키 보관 관행을 전제할 때만 설득력이 있고 하드웨어 키 보호·자동 로테이션이 보급된 환경에서는 한계 효용이 급감한다. 기업 입장의 현실적 대응은 CA별 UX 비교가 아니라 CLM 도구 도입, 발급 자동화, 폐쇄 구간의 사설 CA·트러스트 관리로 이원화하는 것이다. 다만 어플라이언스와 폐쇄망 구간은 이러한 재편의 혜택에서 가장 늦게 배제되므로, 제조사들의 ACME 채택이 향후 5년 PKI 생태계의 최대 난제로 남을 것이다.

    평점: 6/10 – 200일 전환 자체는 보안 강화라는 올바른 방향이지만, 수명 단축의 실익을 뒷받침할 키 관리·검증 체계 개선과 재발급 절차 표준화가 동반되지 않으면 운영 비용만 증가하는 형식적 규제에 그칠 위험이 있다

    비판적 분석가

    수명 단축의 승자는 미리 정해져 있다 — 자동화 인프라를 통제하는 자다

    표면적 내러티브는 ‘짧은 수명이 곧 더 안전’이지만, 이면을 들여다보면 이 변화의 최대 수혜자는 ACME·CLM 인프라를 이미 갖춘 대형 CA와 클라우드·자동화 생태계이고, 최대 비용 부담자는 수동 갱신에 의존하던 중소 운영자다. 왜 하필 지금인가에 대한 답은 기술보다 시장에 가깝다 — 수명이 짧아질수록 발급·재발급 횟수가 곱절로 늘어나고, 이는 발급 단가 경쟁에서 자동화 규모의 경제를 가진 주체에 구조적으로 유리하다. 어플라이언스 제조사가 수년간 공개 포럼에 쌓인 ACME 요구에도 로드맵에 반영하지 않는다면, 그것은 기술 난이도보다 갱신 마찰이 유지보수 계약과 전문 서비스 매출로 이어지는 유인 구조 때문으로 읽힌다. 리셀러 콘솔에서 rekey 경로가 신규 구매 버튼 뒤로 가려진 것도 순수한 UX 결함이라기보다, 갱신 유입 고객의 신규 구매 전환율이 매출 지표로 묶여 잔여 기간 이월 안내에 반대 인센티브가 작동하는 구조의 산물일 가능성이 크다. 보안 논리 자체를 틀렸다고 할 수는 없지만, 비용과 리스크가 자동화 역량에 따라 비대칭적으로 전가된다는 사실은 어디에서도 공식적으로 다뤄지지 않는다. 우리가 진짜 주목해야 할 질문은 ‘수명이 왜 짧아지는가’가 아니라, ‘이 전환으로 누가 시장 지분을 가져가고 누가 그 비용을 치르는가’다.

    물밑 시나리오

    • 수명 단축 일정은 브라우저 벤더와 대형 CA의 영향력이 큰 CA/B 포럼 표결 구조에서 통과됐을 개연성이 높으며, 자동화 인프라가 없는 소형 CA와 리셀러의 시장 퇴출을 앞당기는 재편 장치로 기능할 수 있다 — 표결 이해관계의 분포가 그 정황 증거다.
    • 리셀러 콘솔에서 rekey가 신규 구매 버튼과 분리되고 안내가 약한 것은 우연한 UI 실수가 아니라, 갱신 고객의 신규 구매 전환을 높이는 매출 구조가 반영된 결과일 가능성이 있다 — 어떤 회사에서도 잔여 기간 이월 안내가 앞면에 오지 않는 반복 패턴이 이를 뒷받침한다.
    • 방화벽 제조사의 ACME 미지원 장기화는 기술 지연이 아니라, 인증서 갱신 마찰이 연간 유지보수 계약 갱신율과 전문 서비스 수요를 끌어올리는 이해관계와 맞물렸을 가능성이 있다 — 사용자 요구가 수년간 축적됐는데도 로드맵 부재가 유지되는 점이 정황이다.
    공식 설명 설득력: 5/10 – ‘보안 강화를 위한 수명 단축’이라는 공식 명분 자체는 그럴듯하지만, 운영 비용의 비대칭적 전가, 자동화 역량 격차에 따른 시장 재편 효과, 리셀러·어플라이언스 생태계의 이해관계에 대한 설명은 사실상 공백이다

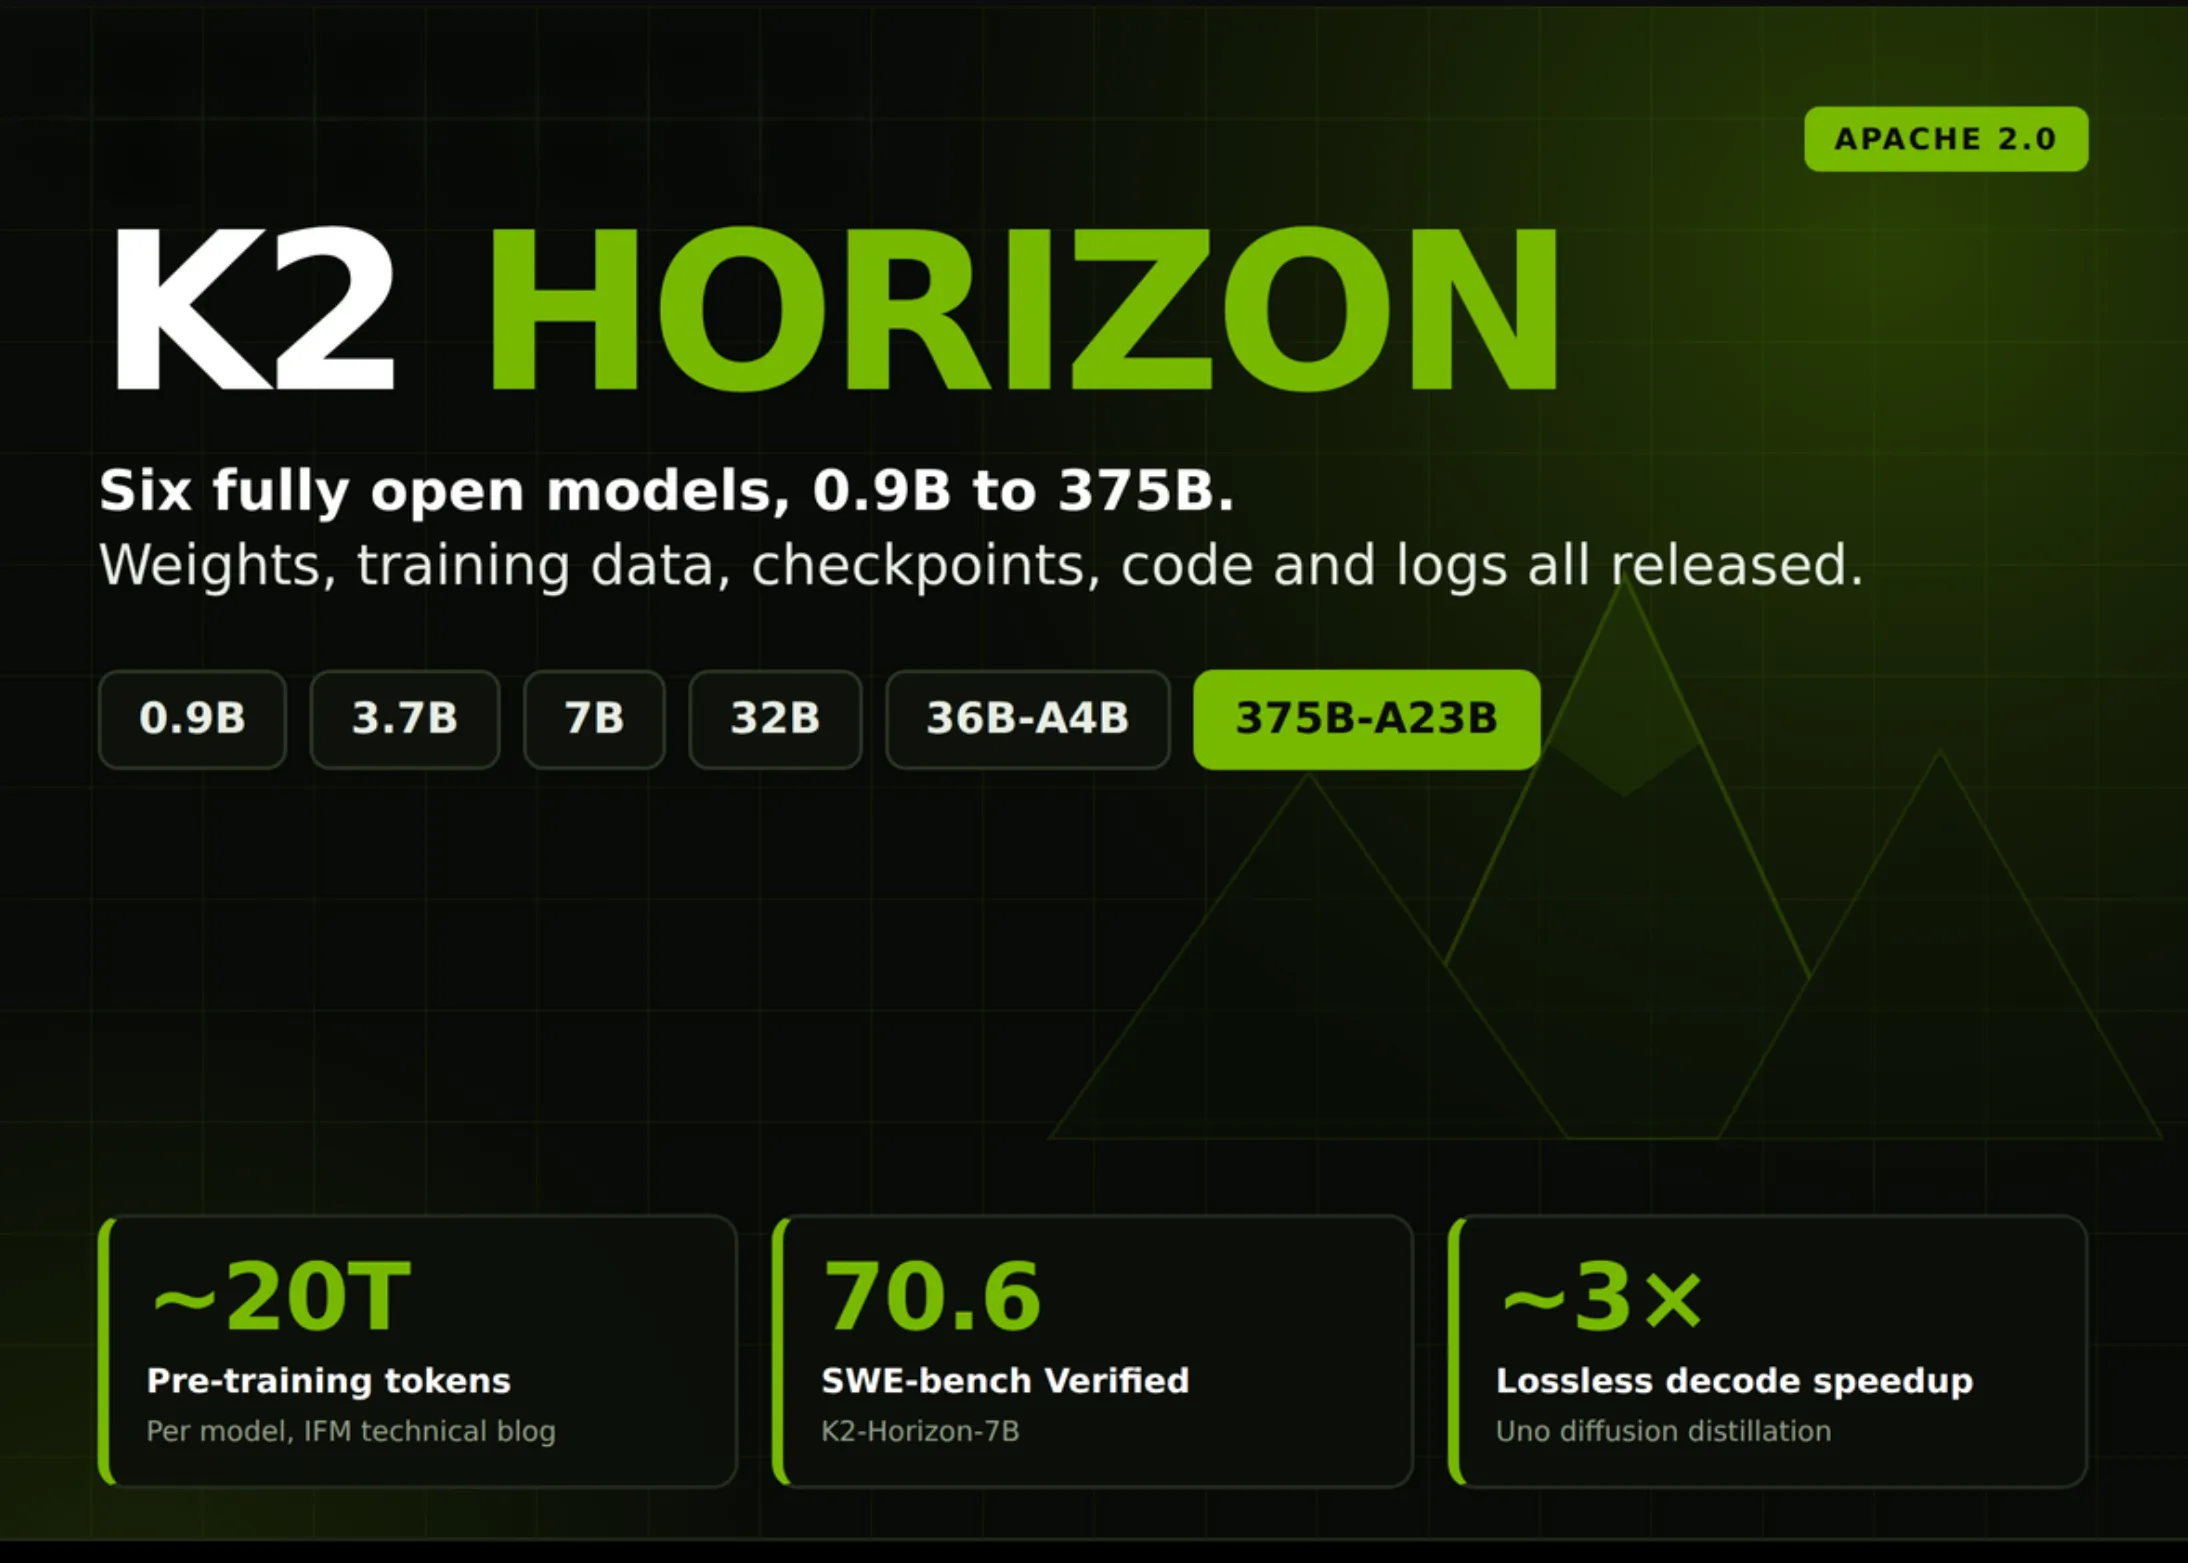
  • K2 호라이즌 6종 분석: 0.9B부터 375B까지 Apache 2.0으로 동시 출시된 IFM 플릿

    K2 호라이즌
    IFM(MBZUAI 산하 재단모델 연구소)이 K2 호라이즌 라인업 6종(0.9B~375B)을 Apache 2.0으로 공개하며 사전학습 코퍼스·중간 체크포인트·학습 코드까지 함께 ships

    핵심 요약

    • 공개 규모: 375B-A23B, 36B-A4B, 32B, 7B, 3.7B, 0.9B 등 6개 모델을 모두 Apache 2.0으로 허깅페이스에 동시 배포 (0.9B는 더 작은 어휘 사용)
    • 오픈스택 동봉: 모델 가중치 외에 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 공개 — IFM은 이를 ‘AI 역사상 가장 큰 완전 오픈소스 출시’로 표현
    • 학습 데이터: 6개 모델 모두 약 20조 토큰으로 사전학습, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰이 합성 데이터

    오픈소스 거대언어모델의 풀스택 공개가 기술·라이선싱·상용화 측면에서 갖는 의미를 분석하고, 동일 아키텍처를 0.9B에서 375B까지 일관되게 운용할 수 있다는 점이 실무에 주는 함의를 짚는 분석형 기사

    목차

    K2 호라이즌 라인업

    K2 호라이즌이 0.9B에서 375B까지 여섯 개 모델을 같은 날 Apache 2.0으로 풀어낸 사건은, 오픈소스 거대언어모델의 풀스택 공개가 어떤 의미를 갖는지를 다시 묻게 만든다. MBZUAI 산하 재단모델 연구소(IFM)가 2026년 9월 공개한 묶음은 가중치뿐 아니라 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 출하되는 ‘플릿(fleet)’ 형식이다.

    필자가 보기에 이 발표의 핵심은 모델 크기나 벤치마크가 아니라 공개 범위다. 0.9B 모델이 더 작은 어휘를 쓴다는 점까지 명시된 것은, 같은 학습 파이프라인을 스케일만 바꿔 반복할 수 있다는 뜻이다. 실무에서 사이즈별로 동일한 인터페이스를 그대로 쓸 수 있다는 점은 통합 운영의 전제가 된다.

    K2 호라이즌 라인업: 0.9B부터 375B-A23B까지

    라인업은 여섯 개 모델로 나뉜다. 0.9B는 축소 어휘, 3.7B·7B·32B는 dense, 36B-A4B와 375B-A23B는 MoE 구성이다. 모든 모델이 동일 토크나이저와 도구 호출 인터페이스를 공유하기 때문에, 같은 코드를 모델 식별자만 바꿔 운용할 수 있다.

    모델 총 파라미터 활성 유형
    0.9B 0.9B 0.9B 축소 어휘 dense
    3.7B 3.7B 3.7B 로컬 추론용 dense
    7B 7B 7B 범용 dense
    32B 32B 32B 고품질 생성 dense
    36B-A4B 36B 4B MoVA MoE
    375B-A23B 375B 23B 플래그십 MoE

    K2 호라이즌 여섯 모델이 같은 합성 태스크 생성기를 거치고, 같은 추론 트레이스 비율(약 17%)로 학습됐다는 점에서 데이터 정렬이 라인업 전체에 일관되게 적용된다. 0.9B에서 검증한 프롬프트 포맷을 375B-A23B로 이식해도 동작이 크게 깨지지 않을 가능성이 높다.

    K2 호라이즌이 가져온 오픈스택의 범위

    IFM은 “AI 역사상 가장 큰 완전 오픈소스 출시”라는 표현을 썼다. K2 호라이즌 배포 묶음에는 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그가 모두 포함된다. 다른 오픈소스 프로젝트가 가중치와 추론 코드 정도만 내놓는 것과 비교하면 범위가 한 단계 다르다.

    중간 체크포인트 공개는 재현성과 직접 연결된다. 375B-A23B를 처음부터 재학습하기는 어렵지만, 중간 단계에서 fine-tuning을 이어 붙이거나 ablation을 시도할 수 있다. 합성 데이터 비율이나 추론 트레이스 비율을 바꿔가며 실험할 표면이 확보된 셈이다.

    학습 데이터 설계: 20조 토큰, 1억+ 태스크

    여섯 모델 모두 약 20조 토큰으로 사전학습됐고, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰은 합성 데이터다. 연구팀은 1억 개 이상의 고유 합성 태스크를 생성했고, 미들 트레이닝 단계에서 포스트 트레이닝 데이터를 점진 반영했다.

    실무자가 주목할 지점은 합성 태스크의 규모다. 필자가 본 가장 흥미로운 수치이기도 하다. 1억 개는 사람이 손으로 설계할 수 있는 범위를 한참 넘는다. 도메인 태스크를 정의해 모델에 주입하는 게 아니라, 태스크 생성 자체를 모델이 맡고 인간이 큐레이션하는 구조로 이동한 것이다. 36B-A4B와 7B 사이의 성능 격차를 따질 때 이 1억 태스크의 분포가 결정 변수가 된다.

    MoVA: 어텐션으로 확장한 MoE의 두 번째 축

    K2 호라이즌 라인업 중 36B-A4B는 MoVA(Mixture-of-Value Attention)를 적용했다. MoE가 피드포워드에서 전문가 라우팅으로 확장 축을 만들었다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합해 어텐션 차원의 두 번째 확장 축을 추가한 것이다. FlashAttention·GQA·sparse attention과 호환되어 기존 서빙 스택을 크게 뜯지 않고 쓸 수 있다.

    MoVA가 흥미로운 이유는 MoE의 파라미터 효율을 한 단계 더 밀어붙일 수 있기 때문이다. K2 호라이즌 상위 라인업이 모두 MoVA로 수렴할지, dense와 MoVA가 공존할지는 지켜볼 지점이다.

    도구 호출 포맷: Markdown의 18.5% 토큰 효율 우위

    IFM은 JSON·XML·Markdown 세 포맷으로 도구 정의를 학습시키고, 추론 기본값을 Markdown으로 설정했다. 측정 결과 Markdown은 JSON 대비 약 18.5% 더 적은 토큰을 사용한다. 같은 결과를 더 적은 토큰으로 만든다는 것은 곧 latency와 비용의 직접적 감소다.

    도구 정의가 길어질수록 Markdown 우위는 커진다. 30~50개 도구를 동시에 노출하는 에이전트는 흔하고, 이 경우 18.5%는 단순한 최적화가 아니라 아키텍처 선택에 가깝다. K2 호라이즌으로 도구 호출 시스템을 설계할 때는 별도 라우터보다 모델이 직접 Markdown 도구 정의를 읽고 호출하게 두는 편이 단순하다.

    서빙 생태계: vLLM·SGLang·Ollama 데이-0 지원

    공개 당일 vLLM·SGLang·Ollama가 데이-0 지원을 받았고, FP8과 GGUF 빌드도 함께 제공된다. NVIDIA뿐 아니라 AMD와 Cerebras까지 대응 범위에 포함된다. IFM 공식 발표에 따르면 호스팅은 Compass, Cerebras, Nebius API와 platform.ifm.ai 게이트웨이로 나뉘며, 같은 가중치를 다양한 스택에서 즉시 시험할 수 있다. 배포 인프라 선택은 AI 칩 아키텍처별 데이터 이동 비용 관점에서 따져볼 만하다.

    데이-0 서빙 지원은 발표의 ‘신호’다. 새 모델은 보통 커뮤니티 패치 후 안정화되는데, K2 호라이즌은 출하 시점에 이미 세 추론 엔진에서 동작한다. 이는 IFM이 오픈소스 모델을 ‘스택’으로 출시한다는 전략적 선택을 보여준다.

    실무 적용 포인트

    사이즈 선택은 호출 빈도와 응답 지연 허용치에 따라 갈린다. 0.9B·3.7B는 분류·라우팅·간단 변환에, 7B는 범용 추론, 32B는 고품질 생성·요약에 배치하는 편이 자원 대비 효율이 좋다. 36B-A4B는 토큰당 4B 활성이라는 점을 활용해 에이전트 라우터나 다중 도구 호출 워크로드에 적합하다. 375B-A23B는 운영비 부담이 크므로 0.9B에서 프롬프트와 도구 정형을 먼저 검증한 뒤 점진적으로 끌어올리는 방식이 안전하다.

    지금 바로 해볼 것

    • Hugging Face에서 K2 호라이즌 0.9B 또는 3.7B 가중치를 받아 vLLM으로 로컬 서빙을 띄워보세요.
    • 동일한 도구 정의를 JSON과 Markdown 포맷으로 각각 작성해 토큰 수와 응답 시간을 비교 측정하세요.
    • 36B-A4B를 받아 MoVA 라우팅이 활성화된 상태에서 다중 도구 호출 시나리오 5개 이상을 실행해보세요.
    • 사전학습 코퍼스 메타데이터에서 합성 태스크 분포를 확인해 사내 도메인 태스크와 가장 가까운 클러스터를 골라 fine-tuning을 시작하세요.

    자주 묻는 질문

    K2 호라이즌 0.9B 모델은 왜 어휘 사전이 다른가?

    엣지 디바이스 타깃 모델이기 때문에 어휘 사전을 줄여 메모리 사용량을 낮췄다. 동일한 학습 파이프라인을 거치지만 추론 환경에 맞춘 축소 어휘를 채택했다.

    Apache 2.0 라이선스로 상용화 가능한가?

    가중치·코드·데이터 모두 Apache 2.0으로 공개됐기 때문에 상용 서비스에 그대로 사용할 수 있다. 단, 재배포 시 동일 라이선스 표기 조건은 지켜야 한다.

    MoVA는 기존 MoE와 어떻게 다른가?

    MoE가 피드포워드에서 전문가를 라우팅한다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합한다. FlashAttention·GQA·sparse attention과 호환되는 것이 특징이다.

    Markdown 도구 호출이 JSON보다 18.5% 효율인 이유는?

    Markdown이 중괄호·따옴표·태그 같은 메타문자가 적기 때문에 동일 의미에 더 적은 토큰이 쓰인다. 도구 정의가 길어질수록 우위는 커진다.

    K2 호라이즌의 공개가 던지는 질문은 단순히 ‘또 다른 오픈소스 모델 출시인가’가 아니다. 같은 파이프라인으로 0.9B부터 375B까지 일관 운용되는 플릿이 Apache 2.0으로 풀려나갔다는 사실은, 오픈소스 LLM 경쟁의 축이 가중치에서 데이터·코드·중간 상태를 포함한 ‘스택’으로 이동했음을 보여준다. 이 변화가 어떤 라이선싱 표준을 만들고, 상용 벤더들이 어떻게 대응할지는 앞으로 몇 분기 동안 판가름될 지점이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — IFM Releases K2 Horizon: Six Apache 2.0 Models From 0.9B to 375B

    전문가 코멘트(AI)

    LLM 인프라 엔지니어

    토크나이저·도구 인터페이스를 통합한 플릿 설계는 운영 단순화에 실리지만, MoVA의 서빙 스택 성숙도가 상용화의 관문

    0.9B부터 375B-A23B까지 하나의 토크나이저와 도구 호출 인터페이스를 공유하는 플릿 설계는 사이즈별 통합·테스트·롤백 절차를 단일화할 수 있어 에이전트 워크로드의 운영 비용을 실질적으로 낮춘다. vLLM·SGLang·Ollama의 데이-0 지원과 FP8·GGUF 빌드 동시 제공은 도입 마찰을 제거하는 요소로, 출하 시점부터 안정 서빙이 가능한 상태로 진입했다는 점이 강점이다. 다만 MoVA가 어텐션 헤드에 라우팅을 넣는 방식은 KV 캐시 구성과 연속 배칭에 새로운 복잡도를 얹는다 — FlashAttention·GQA 호환 주장이 커널 레벨에서 실증돼야 서빙 스택 선택지가 넓어진다. Markdown 도구 호출의 18.5% 토큰 절감은 메타문자 구성상 타당한 방향이지만, 스키마 검증과 오류 처리 부담이 애플리케이션 층으로 이전된다는 트레이드오프를 감수해야 한다. 또한 0.9B의 축소 어휘는 ‘완전히 동일한 인터페이스’라는 명제에 토큰 수준 균열을 만들므로, 사이즈 간 프롬프트 이식성은 실측 검증이 필요하다.

    평점: 8/10 – 통합 플릿 설계와 데이-0 생태계 대응은 실무 도입에 유리하나, 어텐션 라우팅 방식의 서빙 성숙도 검증이 앞서지 못한 단계

    오픈소스 전략·라이선싱 전문가

    가중치를 넘어 데이터·코드·체크포인트까지 Apache 2.0 공개는 경쟁 축을 ‘스택’으로 옮기는 선언이지만, 데이터 권리 체인 검증이 남은 과제

    가중치에 사전학습 코퍼스·중간 체크포인트·학습 코드·로그까지 Apache 2.0으로 묶어 공개한 사례는 기존 오픈웨이트 관행인 ‘가중치+추론 코드’ 선을 크게 넘어, 재현성 연구와 데이터 믹스 감사가 가능해진다는 점에서 의미가 크다. 합성 데이터 비중이 높은(약 10조 토큰) 코퍼스는 웹 크롤링 기반 저작권 리스크를 상당 부분 회피하지만, Apache 2.0 표기만으로 원저작물의 권리 체인이 정리되는 것은 아니므로 출처·라이선스 메타데이터의 공개 수준이 상용 도입의 관문이 된다. 퍼미시브 라이선스 선택은 폐쇄 경쟁자도 이 스택을 흡수할 수 있도록 허용하는 대가로 시장을 강제 개방하는 전략으로 읽히며, 경쟁 랩들이 공개 범위를 따라오도록 압박하는 효과가 있다. 중간 체크포인트 공개는 ablation과 fine-tuning 실험 표면을 넓혀 학계에 실익이 크지만, 안전성 평가를 거친 체크포인트인지 선별 공개인지 판별 기준이 없으면 신뢰가 반감된다. 전반적으로 오픈소스 경쟁의 기준선을 끌어올린 선제적 행보이나, 데이터 권리 검증과 라이선스 모범 사례 정립이 뒤따르지 않으면 ‘완전 공개’의 실질 가치는 크게 훼손된다.

    평점: 8/10 – 오픈소스 공개의 기준선을 ‘가중치’에서 ‘스택’으로 끌어올렸으나, 코퍼스 데이터 권리 체인 검증 장치가 아직 미완

    비판적 분석가

    ‘완전 오픈소스’라는 포장 뒤에는 규격 표준 장악과 상용 게이트웨이 수익화라는 계산이 깔려 있다

    먼저 cui bono부터 따져야 한다: 여섯 사이즈가 하나의 토크나이저·포맷·서빙 레시피를 공유하면, 이 생태계 위에서 무언가를 만드는 개발자는 사실상 IFM의 규격 위에 서게 되고, ‘개방’은 표준 장악의 도구로 기능할 가능성이 높다. Markdown 도구 호출을 추론 기본값으로 밀어붙인 것도 우연이 아닐 수 있다 — 효율 수치가 사실이더라도, 그 포맷이 커뮤니티 표준이 되는 순간 IFM은 표준화 기구 없이 에이전트 상호운용 규격을 소유하게 된다. 가중치는 공짜로 풀고 수익은 platform.ifm.ai 게이트웨이와 호스팅 파트너에서 거두는 구조는 전형적인 오픈코어이며, ‘역사상 가장 큰 완전 오픈소스 출시’라는 문구는 동시에 대규모 고객 유입 캠페인으로 읽힌다. 세 주요 추론 엔진의 데이-0 동시 지원은 몇 달에 걸친 사전 협조 없이는 불가능한데, 이는 진입 타이밍이 경쟁사 출시 일정과 맞춰진 계획 행보였을 개연성을 높인다. 375B급 모델을 20조 토큰으로 학습시킨 컴퓨트 비용을 누가 떠안았는지, 그리고 아부다비 기반 연구소로서 주권 AI 서사에 이 공개가 어떻게 활용되는지가 배경에 있을 수 있다. 공개 자체는 실질적이고 학계에 주는 이익도 분명하지만, 오늘 그들의 Markdown 포맷 위에 에이전트 스택을 올리려는 사람이라면 내일 그 포맷의 요금표를 누가 쓰는지부터 의심해봐야 한다.

    물밑 시나리오

    • IFM이 효율 논리를 앞세워 Markdown 도구 호출 포맷을 사실상 표준으로 만들고, 에이전트 생태계가 IFM 규격에 종속되는 구조를 설계했을 가능성이 있다 — 공식 발표가 포맷별 토큰 효율 수치를 정면 내세운 점이 정황 증거다.
    • ‘역사상 가장 큰 오픈소스 출시’의 시점은 경쟁 랩의 대형 출시 일정에 맞춘 시장 선점 수순일 수 있다 — 세 추론 엔진의 데이-0 동시 지원은 사전 협조 없이는 불가능하다는 점이 그 근거다.
    • 무료 가중치는 platform.ifm.ai 유료 게이트웨이로 트래픽을 모으는 오픈코어형 고객 유입 장치일 가능성이 있다 — 발표에서 호스팅 파트너 목록이 이례적으로 상세하게 강조된 점이 뒷받침한다.

    공식 설명 설득력: 6/10 – 공개 범위와 데이-0 대응의 물질적 근거는 설득력 있으나, 포맷 기본값·상용 게이트웨이·출시 타이밍이 만드는 이해관계 구조가 공식 서사에서 설명되지 않음

  • 가상 태권도 2026 아시안게임 데뷔 — 정식 종목 1호의 논쟁

    핵심 요약

    • 비접촉식 가상 태권도가 올해 아시안게임에서 정식 종목으로 처음 출전한다.
    • 대상 종목은 한국 무술인 태권도의 새로운 변형 형태로, 실제로 신체 접촉이 발생하지 않는다.
    • 비평가들은 이 종목이 ‘화려한 비디오 게임(glorified video game)’에 불과하다고 평가한다.

    아시안게임이라는 메이저 무대에서 전통 무술이 비접촉 포맷으로 편입되는 과정이 спор의 정체성·e스포츠화·미디어 콘텐츠화 논쟁과 어떻게 겹치는지를 정리한 쟁점형 분석

    목차

    가상 태권도가 올해 아시안게임에서 정식 종목으로 처음 출전한다. 한국 무술 태권도의 새로운 변형인 이 경기는 한 가지 결정적 차이가 있다. 실제로 상대에게 차거나 맞는 일이 없다는 점이다. 발차기 동작과 자세는 살아 있지만, 몸과 몸이 부딪히는 순간은 화면 안에서만 존재한다.

    접촉이 없다. 이 한 줄이 모든 논쟁의 출발점이다.

    9월 7일자 뉴욕타임스 보도에 따르면, 비접촉식 가상 태권도는 센서를 단 선수가 시합을 펼치고 채점 시스템이 동작을 판독해 점수를 매긴다. 보호대도, 주심의 호각도, 쿵 소리도 없다. 채점의 무게중심이 어디까지 사람의 눈에 머무느냐가 이 종목의 정체성 논쟁을 결정한다.

    왜 아시안게임이 ‘가상 태권도’를 골랐나

    국제 대회는 종목 채택에서 늘 두 가지 압력을 받는다. 하나는 안전·접근성이고, 다른 하나는 TV 중계와 디지털 플랫폼 친화도다. 비접촉 포맷은 특히 두 번째에서 강하다. 짧은 세트, 명확한 점수, 화려한 영상 연출 — 이 세 요소는 e스포츠와 OTT 콘텐츠에 최적화된 조건이다.

    필자가 주목하는 건 도입 배경이 아니라 “어디서 먼저 등장하느냐”다. 무술의 본산이라 불리는 한국을 포함한 아시안 무대에서 이 종목이 데뷔했다는 사실 자체가, 전통 무술이 더 이상 “격투”의 영역에 머물지 않는다는 신호로 읽힌다.

    가상 태권도에 쏟아지는 비판 — ‘화려한 비디오 게임’

    반대 목소리는 거세다. 뉴욕타임스 기사에 인용된 비평가들의 표현은 단호하다. 가상 태권도는 전통적 의미의 무술이 아니라 “화려한 비디오 게임(glorified video game)”에 불과하다는 것이다. 타격이 사라지면 태권도가 아니라는 주장은 단순한 보수주의가 아니다. 채점이 사실상 소프트웨어가 읽는 동작 정확도로 환원되면, 운동의 강도와 리스크가 사라지고 “경기”의 의미 자체가 흔들린다는 우려가 깔려 있다.

    또한 e스포츠와 가깝게 자리 잡을수록, 기존 태권도 선수층과는 다른 유형의 인재 — 반응속도와 영상 리터러시를 가진 젊은 선수 — 가 두드러질 가능성이 커진다. 실무자 입장에서 가장 불안한 부분은, 종목 정체성을 둘러싼 합의가 없는데도 국제 대회가 먼저 출발해 버렸다는 점이다.

    가상 태권도 이후, 전통 무술의 디지털 분화

    이번 아시안게임에서 비접촉식 가상 태권도가 어떻게 채점되고 어떤 시청 반응을 얻느냐에 따라, 국제올림픽위원회(IOC)·각국 연맹의 후속 결정이 크게 달라질 것으로 보인다. 이 흐름은 태권도에만 머물지 않는다. 검도·유도·쿵푸 같은 다른 무술도 “비접촉 디지털 버전”이라는 화두를 피할 수 없게 됐다. 안전 논란, 젊은 관객 확보, OTT·메타버스 중계 — 이 세 축이 겹치는 곳에서 전통 무술은 계속해서 갈라질 것이다.

    다만 분명한 건, 가상 태권도의 성공 여부가 곧 원래 태권도의 위상을 자동으로 끌어올리지는 않는다는 사실이다. 같은 이름 아래 있지만 평가 기준·선수 풀·시청 경험이 다르다. 같은 이름이 둘로 갈라지는 현상 자체가 이 시기 스포츠 산업의 특징으로 굳어지고 있다.

    쟁점 정리

    • 정체성 충돌: 비접촉 포맷이 가져오는 “경기인가 콘텐츠인가” 질문이 공식 채택 이전에 해결되지 않았다.
    • 채점 권한 이동: 인간 주심에서 알고리즘·센서 중심으로 채점이 이동하면서, 전통 심판 문화와의 마찰이 커진다.
    • 선수 구조 변화: 격투 실력보다 동작 정확도·반응속도가 두드러지는 선수상이 자연스럽게 떠오를 가능성이 높다.
    • 확산 시그널: 가상 태권도가 아시안게임을 거쳐 올림픽·다른 무술로 퍼지면, 전통 종목의 형태가 근본적으로 재편될 수 있다.

    지금 바로 해볼 것

    • 아시안게임 공식 중계 페이지에서 비접촉식 가상 태권도 일정과 채점 기준을 직접 확인해 보세요.
    • 세계태권도 연맹·대한태권도협회 측 입장문을 찾아 이 종목 도입 배경을 읽어보세요.
    • e스포츠 채점 시스템과 기존 스포츠 심판 방식을 비교한 짧은 메모를 작성해 보세요.
    • 비접촉 포맷 논쟁이 검도·유도 같은 다른 무술에 어떻게 적용될지 한 문단으로 정리해 보세요.
    • 관람 후 가상 태권도 영상 한 편을 골라 “스포츠인가 콘텐츠인가”를 자기 입으로 한 줄 평가해 보세요.

    자주 묻는 질문

    가상 태권도는 어디서 처음 정식 종목이 됐나요?

    2026년 아시안게임에서 처음으로 정식 종목으로 채택됐습니다. 국제 올림픽 무대가 아닌 아시안 무대를 거쳐 데뷔한 점이 눈에 띄는 변화입니다.

    비접촉식 가상 태권도는 어떻게 채점되나요?

    센서를 단 선수의 동작을 판정 시스템이 읽어 점수를 매기는 방식입니다. 신체 접촉이 없기 때문에 채점의 상당 부분이 알고리즘과 영상 데이터에 의존하게 됩니다.

    왜 “화려한 비디오 게임”이라는 비판이 나오나요?

    실제 격투가 사라지고 동작 정확도와 시각적 연출이 핵심이 되면서, 전통적 의미의 무술과 거리감이 생겼다는 지적이 제기되고 있습니다.

    기존 태권도 선수도 가상 태권도에 나올 수 있나요?

    기술적 기반은 공유하지만, 센서 친화적 동작 설계와 반응속도·영상 리터러시가 더해지면서 요구되는 선수상이 달라질 가능성이 큽니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: NY Times Tech — Virtual Taekwondo Takes the Contact Out of a Combat Sport

    전문가 코멘트(AI)

    스포츠공학전문가

    센서 기반 비접촉 채점은 기술 성숙도가 높아졌으나, 채점 신뢰성과 ‘스포츠다움’을 동시에 확보하는 것이 남은 과제다

    센서와 모션 판정 시스템으로 동작을 채점하는 방식은 태권도 전자호갱(PSS) 이후 축적된 기술 계보 위에 있어, 점수 산정의 재현성과 객관성이라는 강점은 분명하다. 접촉이 없는 구조는 부상 리스크를 크게 줄이고 학교·지역 체육관 수준까지 진입장벽을 낮춰 저변 확대에 유리하다. 다만 고난도 발차기의 급격한 관절 각도 변화, 센서 착용 위치 오차, 회전 동작에서의 폐색(occlusion) 상황에서는 채점 오차가 커질 수 있고, 대회마다 센서 규격과 알고리즘 버전이 달라지면 같은 동작이 다른 점수를 받는 문제가 생긴다. 특히 알고리즘이 ‘완성도’를 어떤 기준으로 계산하는지 비공개라면, 무술적 완성도 대신 인식률이 좋은 동작을 훈련하는 ‘센서 게이밍’ 현상이 나타날 위험이 있다. 채점 알고리즘의 독립적 검증, 표준 캘리브레이션 절차, 오심에 대한 재심 프로세스가 정착해야 이 포맷이 스포츠로 자리 잡을 수 있다. 기술 자체는 준비됐지만 신뢰를 뒷받침하는 제도적 장치는 아직 초기 단계다.

    평점: 7/10 – 모션 인식·전자 채점 기술의 준비도는 이미 검증됐으나, 대회 간 표준화와 알고리즘 투명성이라는 신뢰 인프라가 갖춰지지 않은 단계

    국제스포츠정책전문가

    아시안게임 채택은 젊은 시청층과 디지털 중계를 노린 합리적 실험이지만, 종목 정체성 합의 없는 선(先)출범이 갈등의 씨앗이 된다

    e스포츠의 아시안게임 편입 이래 이어진 ‘젊은 관객과 디지털 플랫폼 확보’ 전략의 연장선에서 비접촉 가상 태권도 채택은 방향성이 타당하다. 짧은 세트, 즉각적 점수, 영상 친화적 연출은 OTT와 소셜 유통에 최적화되어 대회의 미디어 가치를 높이는 효과가 기대된다. 반면 기존 태권도의 선수 등록·국가대표 선발·지도자 자격 체계와 어떻게 공존할지에 대한 거버넌스 설계가 공백인 상태에서 대회가 먼저 출범했다는 점은 구조적 리스크다. 같은 이름 아래 채점 기준과 요구되는 선수상이 다른 두 종목이 병존하면 연맹 자원 배분, 도장 생태계, 국제 대회 출전 로드맵에서 혼란이 커질 수 있다. IOC의 올림픽 e스포츠 확대 기조를 고려하면 이번 시도는 올림픽 프로그램 진입 교두보로서 전망은 밝은 편이다. 다만 정체성 합의와 종목 분리 원칙 없이 확산되면 ‘전통 종목 몸값 하락’이라는 부작용이 뒤따를 것이다.

    평점: 6/10 – 젊은 관객 확보와 안전이라는 채택 논리는 타당하나, 기존 체육관 생태계와 선수 체계를 보호할 거버넌스 준비가 채택 속도를 따라가지 못함

    비판적 분석가

    ‘젊은 층과 안전’이라는 공식 명분 뒤에는 센서 기술 생태계의 시장 개화와 올림픽 프로그램 생존 전략이 교차해 있다

    공식 설명은 안전, 접근성, 젊은 관객 확보를 내세우지만 이면을 들여다보면 가장 큰 수혜자는 채점 플랫폼과 센서 기술을 보유한 기업, 그리고 자기 기술을 ‘국제 공인’ 단계로 끌어올리고 싶은 연맹 측일 가능성이 높다. 태권도는 올림픽 프로그램 내 인기·방송가치 경쟁에서 늘 축소 압박에 노려온 종목이고, 비접촉 가상 포맷은 격투 종목이 직면한 안전·인기 논란을 우회하며 브랜드를 유지하는 헤지 수단으로 읽힌다. 아시안게임이라는 무대를 사실상 ‘기술 인증식’으로 활용해 이후 올림픽 e스포츠 계열로 확장하려는 로드맵이 타이밍상 겹친다. 우리가 진짜 주목해야 할 점은 채점 알고리즘과 경기 데이터를 누가 소유하느냐다 — 판정 권한이 특정 기업의 소프트웨어로 이동하면 오심 항의조차 ‘기업의 알고리즘 수정 요청’으로 바뀐다. 그리고 왜 종목 내부 논쟁이 정리되기 전에 대회 일정이 먼저 발표됐는지는 공식 담변 어디에서도 설명되지 않는다. 스포츠인지 콘텐츠인지를 묻기 전에, 이 경기의 데이터 권리와 판정 주권이 누구에게 있는지부터 의심해 볼 필요가 있다.

    물밑 시나리오

    • 채점 시스템 개발사가 종목 채택 결정 이전부터 개최 조직위·연맹과 기술 파트너십을 맺고 있었을 가능성이 있다 — 아시안게임은 신규 채점 플랫폼에 세계적 인증을 부여하는 최적의 무대이며, 종목 채택과 기술 선정이 별도 공개 심사 없이 함께 발표되는 패턴이 반복돼 왔다.
    • 태권도 진영이 격투 종목에 대한 올림픽 프로그램 축소 압박에 대비해 ‘접촉 없는 브랜드 보험’을 미리 깔았을 가능성이 있다 — IOC가 올림픽 e스포츠를 공식화하는 흐름과 비접촉 종목의 아시안게임 선점 타이밍이 맞아떨어진다.

    공식 설명 설득력: 5/10 – 안전과 젊은 층 확보라는 명분은 그럴듯하지만, 기술 선정 절차, 채점 데이터 소유권, 내부 합의 이전의 대회 일정 선(先)발표에 대한 설명이 비어 있다

  • PEEP 백도어 5가지 위험 — 브라우저 확장 프로그램으로 위장한 공격의 작동 원리

    PEEP 백도어
    크롬·엣지 확장 프로그램으로 위장한 백도어 'PEEP'의 동작 방식과 위협 분석

    핵심 요약

    • 보안 기업 소크레이더가 크롬과 엣지 확장 프로그램 형태를 위장한 공격 도구를 ‘PEEP’으로 명명하고 분석 결과를 공개했다.
    • PEEP은 사용자 계정 정보와 세션 쿠키를 탈취하는 데 그치지 않고, 감염 PC에서 명령을 실행하는 기능까지 갖추고 있다.
    • 해당 도구는 초기 침투용이 아니라, 이미 관리자 권한 또는 명령 실행 권한을 확보한 공격자가 시스템에 발판을 마련한 뒤 자리를 굳히기 위한 후속(Post-exploitation) 도구로 분류된다.

    analysis

    목차

    PEEP 백도어가 크롬과 엣지 확장 프로그램으로 둔갑해 사용자 모르게 브라우저를 장악하는 방식이 공개됐다. 보안 기업 소크레이더가 이 도구를 분석해 명명한 PEEP 백도어는 단순한 정보 탈취용 악성코드가 아니다. 이미 시스템 권한을 확보한 공격자가 브라우저를 발판으로 삼는 후속 도구라는 점에서 위협 수준이 다르다.

    필자가 이 사건에서 가장 의미 있다고 본 부분은 ‘설치 단계’다. 일반 사용자는 자기가 확장 프로그램을 설치했다는 사실조차 인지하지 못할 가능성이 높기 때문이다.

    1. PEEP 백도어의 정체 — 소크레이더가 명명한 도구, 무엇을 하는가

    소크레이더는 PEEP 백도어를 ‘이미 권한을 가진 공격자가 시스템에 더 깊이 뿌리내리기 위한 도구’로 분류했다. 초기 침투용 악성코드와 달리, PEEP 백도어는 한 번 관리자 권한이 확보된 PC에서 동작하며 브라우저를 감시·명령 실행 플랫폼으로 전환한다.

    크롬 웹스토어와 마이크로소프트 애드인 마켓을 완전히 우회한다는 점이 핵심이다. 공격자는 사용자의 PC에 직접 확장 파일을 내려받아 등록하며, 브라우저가 평소 표시하는 ‘이 확장을 추가하시겠습니까?’ 팝업도 뜨지 않는다.

    2. 무결성 값 위조 — 정상 설치처럼 보이게 만드는 기술

    크로미엄 기반 브라우저는 확장 설정 파일(preferences)의 변조 여부를 확인하기 위해 해시 기반 무결성 값을 저장한다. PEEP 백도어는 이 값을 정상 값으로 위조해 검사 단계 자체를 무력화한다. 결과적으로 브라우저는 ‘정상적인 방식으로 설치된 확장’으로 판단하고 아무 경고도 띄우지 않는다.

    이 패턴은 소크레이더 분석을 소개한 보안뉴스 원문에서 설명한 그대로다. 정상적인 템플릿 메커니즘을 역이용해 백도어를 심는 시도는 과거에도 반복됐다. 매그ento 환경의 StyleSmuggler 제로데이가 그 예다 — StyleSmuggler 제로데이 분석 기사처럼 정상 우회 경로를 악용해 백도어를 심는 공격은 웹·브라우저 영역에서 계속 진화하고 있다.

    3. PEEP 백도어가 빼가는 것 — 계정에서 PC 제어까지

    수집 가능한 정보의 범위가 넓다. 기본적으로 사용자가 로그인한 웹사이트의 세션 쿠키와 계정 정보가 대상이다. 여기서 더 나아가 감염 PC에서 임의 명령을 실행하는 기능까지 갖추고 있어, 사실상 브라우저가 원격 제어 콘솔로 변한다고 봐도 과언이 아니다.

    실무자 입장에서 눈에 띄는 건 ‘거주(persistence)’ 기능이다. 한 번 심어진 PEEP 백도어는 브라우저가 다시 시작돼도 살아남으며, 공격자에게 안정적인 진입 통로를 제공한다.

    4. 왜 초기 침투 도구가 아닌가 — 공격 단계상 위치의 의미

    PEEP 백도어는 처음 PC에 침투할 때 쓰는 1차 도구가 아니다. 피싱이나 취약점 공격으로 이미 관리자 권한을 잡은 공격자가 ‘다음 단계’로 활용하는 도구다. 즉, PEEP 백도어만 단독으로 발견됐다면 그 PC에는 이미 더 큰 문제가 있었다고 봐야 한다.

    다만 이 단계의 도구들이 정교해질수록, 기업 입장에서 평소 확장 프로그램 목록을 점검하는 일상의 중요성이 커진다. 초기 침투를 막지 못했더라도, PEEP 백도어와 같은 2차 도구를 빨리 발견하면 피해 확산을 줄일 수 있다.

    5. 쟁점 — 웹스토어 정책과 무결성 검증의 한계

    이 사건이 시사하는 구조적 문제는 두 가지다. 첫째, 공식 스토어를 우회한 확장은 사실상 검은 시장과 다크웹에서만 거래되며 일반 사용자가 사전에 알 방법이 없다. 둘째, 무결성 검증 체계 자체가 ‘정상 파일을 정상으로 보이게 만드는’ 공격을 구분하지 못한다.

    단순히 사용자 경각심만으로 해결되는 문제가 아니라는 점에서, 브라우저 벤더의 정책 재설계가 필요해 보인다. 확장 설치 시 단순 팝업을 넘어 파일 해시와 출처를 강제 검증하는 방식이 도입되지 않으면 PEEP 백도어와 유사한 공격은 계속 등장할 가능성이 높다.

    쟁점 정리

    • 공식 스토어 우회 설치는 사용자 인지 영역 밖에서 일어난다
    • 무결성 값 위조는 브라우저 보안 모델의 구조적 한계를 드러낸다
    • PEEP 백도어는 단독 도구가 아닌 ‘거주’ 단계 도구이므로 발견 시 더 큰 침투가 있었음을 전제해야 한다
    • 확장 프로그램 점검은 EDR 도입 기업에서도 형식적으로 끝나는 경우가 많다

    지금 바로 해볼 것

    • 크롬(chrome://extensions)과 엣지(edge://extensions)에 등록된 확장 목록을 지금 열어 출처가 불분명한 항목을 제거한다
    • 그룹 정책(GPO) 또는 관리 콘솔로 비공식 확장 설치를 차단하는 정책을 적용한다
    • EDR 솔루션에서 브라우저 프로세스(Chrome.exe, msedge.exe)의 자식 프로세스 실행을 모니터링하도록 룰을 점검한다
    • 관리자 권한 계정의 평소 사용을 줄이고 일상 업무는 표준 사용자 권한으로 전환한다
    • 주기적으로 브라우저 업데이트를 적용해 무결성 검증 체계 자체의 개선분을 받는다

    자주 묻는 질문

    PEEP 백도어는 일반 사용자도 감염될 수 있나요?

    단독으로는 어렵습니다. PEEP 백도어는 이미 관리자 권한을 가진 공격자가 심는 도구이므로, 별도의 1차 침투(피싱, 취약점 공격 등)가 먼저 일어났을 가능성이 높습니다.

    크롬 웹스토어에서 받은 확장도 안전한가요?

    웹스토어를 거친 확장은 비교적 검증을 받지만 100% 안전하지는 않습니다. 가능하면 출처가 명확한 제작사의 확장만 설치하고, 설치 후에도 권한을 주기적으로 확인하는 것이 좋습니다.

    어떤 증상이 나타나면 PEEP 백도어를 의심해야 하나요?

    특정 확장 프로그램이 종료해도 다시 나타나는 경우, 브라우저가 비정상적으로 느려지거나 알 수 없는 프로세스가 자식 프로세스를 생성하는 로그가 보인다면 PEEP 백도어 포함 2차 침투 단계를 의심해야 합니다.

    기업에서는 어떤 정책이 가장 효과적인가요?

    비공식 확장 설치를 차단하는 그룹 정책과 브라우저 프로세스의 이상 행위를 탐지하는 EDR 룰 조합이 가장 실효성이 높습니다. 단일 통제만으로는 우회 시도가 빠르기 때문입니다.

    전문가 코멘트(AI)

    정보보안침해대응전문가

    PEEP류 확장 백도어의 본질은 신규 공격 기법이 아니라 ‘관리자 권한 확보 이후’를 방어하는 통제 공백의 노출이다

    이 공격의 기술적 핵심은 크로미엄 계열 브라우저의 Secure Preferences 무결성 검증이 로컬 관리자 권한 앞에서는 재계산·위조가 가능하다는 신뢰 경계 약점을, 스토어 우회 설치라는 실전 경로로 자동화했다는 점이다. 세션 쿠키 탈취는 다중 인증을 우회하는 가장 실질적인 계정 장악 경로이고, 여기에 임의 명령 실행과 거주 기능이 결합되면 브라우저가 사실상 C2 채널이자 프록시로 전환된다. 다만 관리자 권한 선점이 전제 조건이므로 최소 권한 운영, GPO·ExtensionSettings 기반 비공식 확장 차단, 브라우저 프로세스 자식 실행 모니터링 등 이미 성숙한 통제로 상당 부분 방어 가능한 위협이다. 침해대응 관점의 유효 IOC는 스토어 출처가 아닌 로컬 경로에서 로드된 확장, preferences 파일의 비정상 쓰기, 브라우저 재시작 후 소리 없이 복구되는 확장 항목 등으로 구체화할 수 있다. 아쉬운 점은 이 유형의 무결성 위조가 전례 없는 신기법이 아니며, 상당수 EDR 환경이 브라우저 설정 변조를 기본 탐지 항목으로 삼지 않아 실전 탐지율이 배포 환경에 크게 좌우된다는 사실이다.

    평점: 7/10 – 관리자 권한 선점 환경에서는 구조적으로 막기 어려운 실전적 위협이지만, 새로운 취약점 악용이 아니라 알려진 신뢰 경계 약점의 자동화라는 점에서 기법적 참신성은 제한적

    브라우저플랫폼보안엔지니어

    확장 무결성 검증은 ‘사용자 수준 변조 차단’용 설계로, 관리자 권한 공격자를 상정하는 순간 구조적 한계에 도달한다

    크로미엄의 확장 무결성 체계는 원래 사용자 수준 또는 원격 변조자의 설정 훼손 탐지를 위협 모델로 설계되었고, 검증 시드가 로컬 머신에 존재하는 이상 로컬 관리자를 막는 장치로는 처음부터 기대할 수 없다. 설치 동의 팝업은 OS가 강제하는 경계가 아니라 UI 정책일 뿐이므로, 문제의 본질은 우회 설치 자체보다 ‘스토어 밖 설치의 출처가 서명 기록으로 남지 않는다’는 점이다. 기술적으로는 설치 출처 서명·원격 증명, 비스토어 설치 기본 차단 기본값, 로드 시점 출처 재검증 같은 개선안이 존재하지만 호환성과 프라이버시 트레이드오프 때문에 도입이 더딘 것이 현실이다. 엔터프라이즈용 확장 제어 정책은 이미 강력하므로, 진짜 공백은 기술 부재가 아니라 그것이 기본값이 아니라는 배포 구조의 문제다. 매니페스트 V3 전환과 스토어 심사 강화로 스토어 경유 공격이 줄어드는 만큼 로컬 우회 설치의 상대적 비중은 커질 것이며, 이 사례는 그 방향성을 예고하는 전형으로 본다.

    평점: 6/10 – 메커니즘은 설계된 위협 모델 내에서는 정상 작동하나, 실제 사고가 발생하는 관리자 권한 위협 모델을 커버하지 못하는 설계-현실 간 괴리가 크다

    비판적 분석가

    이 공개는 기술 분석이자 동시에 ‘1차 침투는 몰라도 2차 탐지가 곧 제품 가치’라는 보안 산업의 수요 창출 서사로 읽힌다

    누가 이득을 보는가부터 물어야 한다 — 위협에 기억하기 쉬운 이름을 붙이고 ‘다크웹 거래’라는 프레임을 얹는 일은, 기술적 사실 그 자체보다 기업 보안 예산 심사 자리에서 인용되기 쉬운 서사를 만든다는 점에서 명확한 수혜 구조를 가진다. ‘공식 스토어를 우회한 확장은 다크웹에서만 거래된다’는 주장은 정황상 과장으로 읽힐 여지가 크다 — 이미 관리자 권한을 확보한 공격자에게 익명 시장은 불필요하며 직접 배포가 기본값이기 때문이다. ‘초기 침투 도구가 아니다’라는 분류는 기술적으로는 정확하지만, 동시에 1차 침투는 별개 문제로 치워두고 2차 단계 탐지를 제품 가치로 삼는 EDR 벤더 서사와 지나치게 깔끔하게 맞물린다. 브라우저 벤더는 스토어 밖 설치 통제 강화의 명분을 얻고, 보안 벤더는 브라우저 모니터링 수요를 얻고, 대중은 새로운 경각심 메시지를 얻는다 — 세 주체가 모두 이득을 보는 위협 서사는 결코 흔하지 않다. 우리가 진짜 주목해야 할 점은 피해 규모, 표적, 배포 채널에 관한 검증 가능한 데이터가 얼마나 공개되었는가이며, 그것이 비어 있다면 이 사건은 순수한 기술 분석이라기보다 마케팅에 최적화된 위협 스토리였을 가능성을 배제할 수 없다.

    물밑 시나리오

    • 위협 명명과 보고서 공개 시점이 해당 보안 기업의 위협 동향 발표·제품 홍보 주기와 겹쳤을 가능성이 있다 — 위협에 고유명사를 부여해 검색 가능한 브랜드를 만드는 것은 업계에서 오래 쓰여 온 리드 제너레이션 기법이기 때문이다.
    • ‘다크웹 거래’ 프레임은 실제 배포 경로 증거보다 공포 기반 수요 창출 장치로 기능했을 수 있다 — 관리자 권한 선점이 전제된 공격에서는 익명 유통 시장 자체가 무의미하다는 정황과 충돌하기 때문이다.

    공식 설명 설득력: 5/10 – 무결성 위조라는 기술 동작 묘사는 개연성이 높지만, 배포 채널·피해 규모·표적에 관한 검증 가능 정보가 사실상 비어 있고 근거 제시 없이 다크웹 서사가 공포 프레임을 보강하는 방식으로 배치되어 있다

  • 내비게이트AI 4년 만의 등장 — 에릭 우가 선택한 건설 인력난 정면돌파

    내비게이트AI
    Opendoor 창업자 에릭 우의 신규 회사 NavigateAI, AI 코파일럿으로 미국 건설 현장 인력난에 진출

    핵심 요약

    • 에릭 우는 Opendoor를 8년간 운영한 뒤 2022년 급격한 금리 인상으로 회사를 떠났다.
    • 1년간 휴식한 뒤 AI를 자신의 인생에서 가장 결정적인 기술 플랫폼이라 판단해 다시 창업에 나섰으며, ’10년 뒤에 AI와 관련된 일을 하지 않았다면 후회했을 것’이라고 말했다.
    • 2026년 5월 스텔스 모드를 종료하고 공개한 신규 회사는 NavigateAI로, 건설 노동자와 현장 작업자를 위한 AI 코파일럿을 개발 중이다.

    분석 – 성공한 1세대 PropTech 창업자(Opendoor)가 4년 만의 복귀 무대로 전통 산업(건설)을 선택한 전략적 의미와, AI가 숙련 인력 부족이라는 구조적 문제를 해결할 수 있는지를 펀딩·시장·정책 측면에서 평가

    목차

    “34만 9천 명”이라는 숫자부터 짚어야 한다. 미국 건설업계가 올해 추가로 확보해야 한다고 본 인력 규모다. Associated Builders and Contractors가 추산한 수치다. 내비게이트AI는 이 빈자리를 향해 2026년 5월 모습을 드러낸 회사다.

    내비게이트AI가 노리는 시장 — 34만 9천 명의 빈자리

    8년간 Opendoor를 운영하다 2022년 금리 쇼크와 함께 회사를 떠난 에릭 우가 1년 휴식 끝에 다시 창업판에 섰다. “10년 뒤에 AI와 관련된 일을 하지 않았다면 후회했을 것”이라는 발언이 우를 움직인 동력이다. 그가 만든 내비게이트AI는 스마트폰과 메타 AI 글래스를 통해 건설 현장 작업자에게 단계별 가이드를 실시간·핸즈프리로 제공한다. 우 본인은 이를 “신체로 무언가를 만드는 사람을 위한 핸즈프리 전문가 코치”라 정의했다.

    인력 부족의 원인은 단순하지 않다. 숙련공 고령화와 이민 단속 강화로 외국인 노동자 공급이 줄었다. 여기에 AI 산업 확장으로 데이터센터 신축이 늘면서 단일 프로젝트당 4천~5천 명 단위 인력을 요구하는 현장도 등장했다. AI가 살 공간을 짓는 사람마저 모자라는 아이러니가 매년 깊어지고 있다.

    내비게이트AI의 솔루션 — 핸즈프리 AI 코파일럿 작동 방식

    내비게이트AI의 핵심은 “보면서 즉시 답한다”는 점이다. 작업자가 글래스나 스마트폰 카메라로 현재 작업을 비추면 AI가 다음 단계를 음성·시각으로 안내한다. 일반 AI 어시스턴트와 다른 차이는 노동 현장의 소음·먼지·진동 환경을 전제로 설계됐다는 것이다.

    필자 입장에서는 범용 AI가 놓치는 현장 제약 조건을 어떻게 모델에 넣었는지가 관건이라 본다. 동일 공종이라도 주별 건축 규정, OSHA 안전 표준, 작업자 숙련도가 달라서다. 내비게이트AI 측이 이런 변수를 흡수해 단계별 가이드를 제시하지 못하면 도구는 결국 유튜브 영상과 다를 게 없다.

    내비게이트AI 펀딩 2,500만 달러 — 레나가 베팅한 의미

    1차 펀딩은 2,500만 달러 규모로, 엘라드 길·코슬라 벤처스·레나 등으로부터 조달했다. 미국 대형 주택 건설사 레나의 참여는 내비게이트AI를 단순한 범용 AI 도구가 아니라 주택·부동산·건설 밸류체인의 작업 현장과 직접 연결된 솔루션으로 본다는 신호다.

    필자가 이 지점이 가장 의미 있다고 보는 이유는, 건설사가 자금만 댄 게 아니라 “현장”을 같이 가져오겠다는 의지이기 때문이다. 레나의 신규 단지가 사실상 내비게이트AI의 테스트베드가 될 가능성이 크고, 영업·검증·데이터 라벨링이 한꺼번에 돌아가는 구조를 만든다.

    참여 투자자 유형 시사점
    엘라드 길 개인 VC AI 스타트업 정통 라인업 시그널
    코슬라 벤처스 VC PropTech·건설 테크 포트폴리오 확장
    레나 전략적 투자자(건설사) 현장 검증·밸류체인 직접 통합 가능성

    쟁점 정리

    • 내비게이트AI는 34만 9천 명 부족이라는 명시적 수요 위에서 설계된 B2B 도구다.
    • 데이터센터 붐이 만드는 단일 프로젝트 4천~5천 명 수요가 시장 확대 변수로 작동한다.
    • 주택 건설사 레나의 펀딩 참여는 단순 자금 제공이 아닌 현장 동시 도입 시도를 시사한다.
    • 남은 과제는 AI 가이드의 정확성, 산업재해 책임 소재, 웨어러블 디바이스 현장 도입 장벽이다.

    지금 바로 해볼 것

    • 현장 관리자라면, 스마트폰 기반 AI 가이드를 1개 파일럿 공종(예: 철근 배근)에서 30일간 테스트해 정확성·수용성을 측정하라.
    • 건설사 R&D 담당자라면, 메타 AI 글래스 같은 웨어러블 디바이스의 PPE 호환·안전 인증 이슈를 사전에 점검하라.
    • 투자자라면, 단일 현장 4천~5천 명 수주가 가능한 인력 풀·마켓플레이스 회사와 NavigateAI를 같은 카테고리로 묶어 비교하라.
    • 스타트업 운영자라면, 범용 AI 어시스턴트가 아닌 “신체로 만드는 사람” 타깃 코치를 별도 카테고리로 포지셔닝하라.

    우 본인은 사람을 대체하는 게 아니라 같은 사람이 더 많은 일을 안전하게 끝낼 수 있게 돕는 게 목표라고 말했다. 그 문장이 실제 현장 KPI(산출량, 재작업률, 사고율)로 번역되는 시점이 내비게이트AI의 진짜 검증 지점이 될 것이다.

    자주 묻는 질문

    내비게이트AI는 어떤 회사인가요?

    Opendoor 창업자 에릭 우가 2026년 5월 스텔스를 종료하고 공개한 회사로, 건설 현장 작업자를 위한 AI 코파일럿을 개발합니다. 스마트폰과 메타 AI 글래스를 통해 단계별 안내를 핸즈프리로 제공합니다.

    왜 미국 건설업계가 인력이 부족한가요?

    숙련공 고령화, 이민 단속 강화로 줄어든 외국인 노동자 공급, 데이터센터 등 대형 프로젝트 증가가 맞물려 있습니다. 올해만 약 34만 9천 명의 추가 인력이 필요하다는 추산이 나왔습니다.

    내비게이트AI의 펀딩 규모와 투자자는 어떻게 되나요?

    엘라드 길, 코슬라 벤처스, 레나 등으로부터 2,500만 달러를 유치했습니다. 미국 대형 주택 건설사 레나의 참여는 건설 밸류체인과의 직접 통합을 시사합니다.

    AI 코파일럿이 숙련공 부족 문제를 해결할 수 있나요?

    비숙련 인력이 단계별 가이드를 따라 작업할 수 있게 해 생산성을 끌어올릴 여지가 큽니다. 다만 AI 가이드의 정확성, 산업재해 책임 소재, 웨어러블 디바이스 도입 장벽이라는 과제를 동시에 풀어야 합니다.

    참고: TechCrunch의 에릭 우 인터뷰 원문

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Eric Wu's newest company, out of stealth since May, is going after construction's labor crunch

    전문가 코멘트(AI)

    건설ICT·현장안전 전문가

    명확한 수요 위의 접근이지만, 안전 책임 소재·PPE 제약·현장 문화가 성패를 가를 것

    숙련공 고령화로 현장 경험의 세대 전단이 가속되는 상황에서, 손과 눈이 모두 점령된 작업 환경에 핸즈프리 단계별 가이드를 얹는 접근은 문제 정의와 인터랙션 설계가 모두 타당하다. 레나 같은 대형 주택건설사가 투자와 동시에 현장을 제공한다는 것은 건설테크가 반복적으로 실패하던 ‘현장 검증 부재’ 문제를 우회하는 구조로, 사실상 이 시도의 가장 큰 자산이다. 다만 성패는 기술보다 제도에 달려 있다. AI 안내가 틀려 발생하는 재작업과 재해의 책임이 시공사·솔루션 기업·작업자 중 누구에게 귀속되는지가 불명확하면 보험 인수와 법무 검토에서 막힐 것이고, OSHA는 소프트웨어를 인증하지 않기 때문에 안전 케이스를 기업 스스로 입증해야 한다. 또한 글래스 착용이 보호안경·안면보호구 같은 PPE 요건과 충돌하지 않는지, 콘크리트·철골 구조물 내부에서 연결성과 배터리가 버티는지도 현장 수용의 관문이다. 초기에는 석고보드·조적 같은 저위험·반복 공종부터 안착시키고, 재작업률과 사고율 데이터를 축적한 뒤 고위험 작업으로 확장하는 순서가 현실적이다.

    평점: 7/10 – 수요의 실재성과 전략적 투자자의 테스트베드 구조는 강력한 강점이나, 책임 소재·PPE 호환·노조와 숙련공의 수용성이라는 실행 리스크가 아직 풀리지 않은 단계

    AI·엣지시스템 엔지니어

    현장 제약을 전제로 한 설계 방향은 맞지만, 안전 크리티컬 가이던스의 환각·지연 문제가 기술적 관문

    ‘보이는 대상을 이해하고 다음 단계를 말로 안내한다’는 멀티모달 비전-언어 접근은 과거 AR 작업지시 시도가 좌절했던 하드코딩 문제를 피할 수 있는, 최초로 현실적인 아키텍처다. 그러나 안전 크리티컬 영역에서 생성 모델의 환각은 치명적이므로, 주별 건축 규정·OSHA 기준·제조사 매뉴얼에 대한 검색 근거 기반 생성과 고위험 단계에서의 확인 게이트 없이는 현장 신뢰를 얻기 어렵다. 철골·지하·교외 부지처럼 통신이 불안정한 환경을 고려하면 온디바이스와 클라우드의 하이브리드 추론이 불가피한데, 글래스급 하드웨어에서 저지연·저전력 추론을 구현하는 문제와 영상 스트리밍 비용·작업자 프라이버시 이슈가 동시에 남는다. 진짜 해자는 모델이 아니라 데이터로, 레나 현장에서 공정 영상과 결과(재작업 여부·산출량)가 쌍으로 축적되면 돈으로 살 수 없는 도메인 플라이휠이 만들어진다. 소음·먼지·역광 속 음성 입출력 품질 역시 실험실 데모와 실외 현장 사이에 큰 격차가 있는 영역이다. 요컨대 방향은 맞지만, 범용 어시스턴트와의 차별화는 정확성을 입증하는 측정 체계를 제품과 함께 내놓느냐에 달려 있다.

    평점: 7/10 – 멀티모달 코파일럿 설계와 현장 데이터 플라이휠 구조는 설득력 있으나, 안전 크리티컬 정확성 검증과 엣지 제약 해결이 여전히 미지수

    비판적 분석가

    인력난 해결이라는 명분 뒤에, 건설사의 노동 협상력 회복 전략과 웨어러블 생태계 교두보 확보가 겹쳐 있다

    공식 내러티브는 ‘기술이 일자리 공백을 돕는다’지만, 이면을 들여다보면 가장 먼저 이득을 보는 주체는 작업자가 아니라 노동력에 대한 협상력이 약화되던 대형 건설사와, 현장에 웨어러블 AI를 뿌리내리려는 플랫폼 진영으로 읽힌다. 34만 9천 명이라는 수치는 애초에 업계 단체의 추산이라는 점에서, 인력난 프레임은 이민 정책 압박·임금 상승 억제·기술 대체 투자 유치를 한 번에 정당화하는 만능 서사로 재활용되기 쉽다. 레나가 투자자이면서 동시에 사실상 테스트베드라는 이중 역할은, 이 딜이 단순 자금 조달이 아니라 하도급 현장의 공정 데이터와 작업 방식에 대한 가시성 확보 움직임일 개연성을 높인다. ‘사람을 대체하는 게 아니라 돕는다’는 문구가 반복되는 타이밍이 숙련 노동의 지위와 마찰이 예상되는 시점과 겹친다는 점도 우연으로만 보기 어렵다. 우리가 진짜 주목해야 할 점은, 수천 명 작업자의 시선·동선·실수 기록이 누구의 서버에 쌓이고 그 데이터가 다음 노사·하도급 협상의 카드가 되는가 하는 것이다.

    물밑 시나리오

    • 레나의 전략 투자는 재무 수익보다 자사 신규 단지를 조건부 테스트베드로 제공함으로써 협력업체들의 공정 데이터 통합권을 확보하려는 물밑 구조일 가능성이 있다 – 대형 건설사들이 최근 공급망·공정 데이터 표준화를 계약 조건으로 요구해온 흐름이 그 정황이다.
    • 건설 현장이 웨어러블 AI 글래스의 교두보로 선택된 것은 안전모·보호안경 착용이 일상이라는 환경적 이유만이 아니라, 디바이스 조달 계약이 공개 전에 이미 깔려 있었을 정황으로 읽힌다 – 솔루션 발표마다 특정 글래스가 세트로 언급되는 구조가 그 힌트다.
    • 인력 부족 통계가 매년 강조되는 배경에는, 같은 숫자가 업계의 이민 정책 로비 근거이자 기술 대체 투자의 시장성 근거로 이중 활용되고 있을 개연성이 있다 – 부족하다고 말하는 주체가 곧 그 해법을 파는 쪽과 이해를 같이한다는 점이 교차 검증 포인트다.

    공식 설명 설득력: 4/10 – 수요 통계와 투자 라인업 자체는 사실에 기반해 설득력이 있으나, 투자자의 테스트베드 이중 역할·노동 대체 논쟁·현장 데이터 소유 구조에 대한 설명이 비어 있어 공식 서사의 신뢰도는 제한적

  • 미니CPM5-2B, 2.5B 파라미터로 34개 벤치마크 평균 53.9 — OpenBMB가 다시 정의한 온디바이스 LLM 기준

    미니CPM5
    OpenBMB가 공개한 2.52B 파라미터 소형 언어모델 MiniCPM5-2B의 아키텍처, 34개 벤치마크 평균 53.9점 성과, 그리고 학습·배포 파이프라인 분석

    핵심 요약

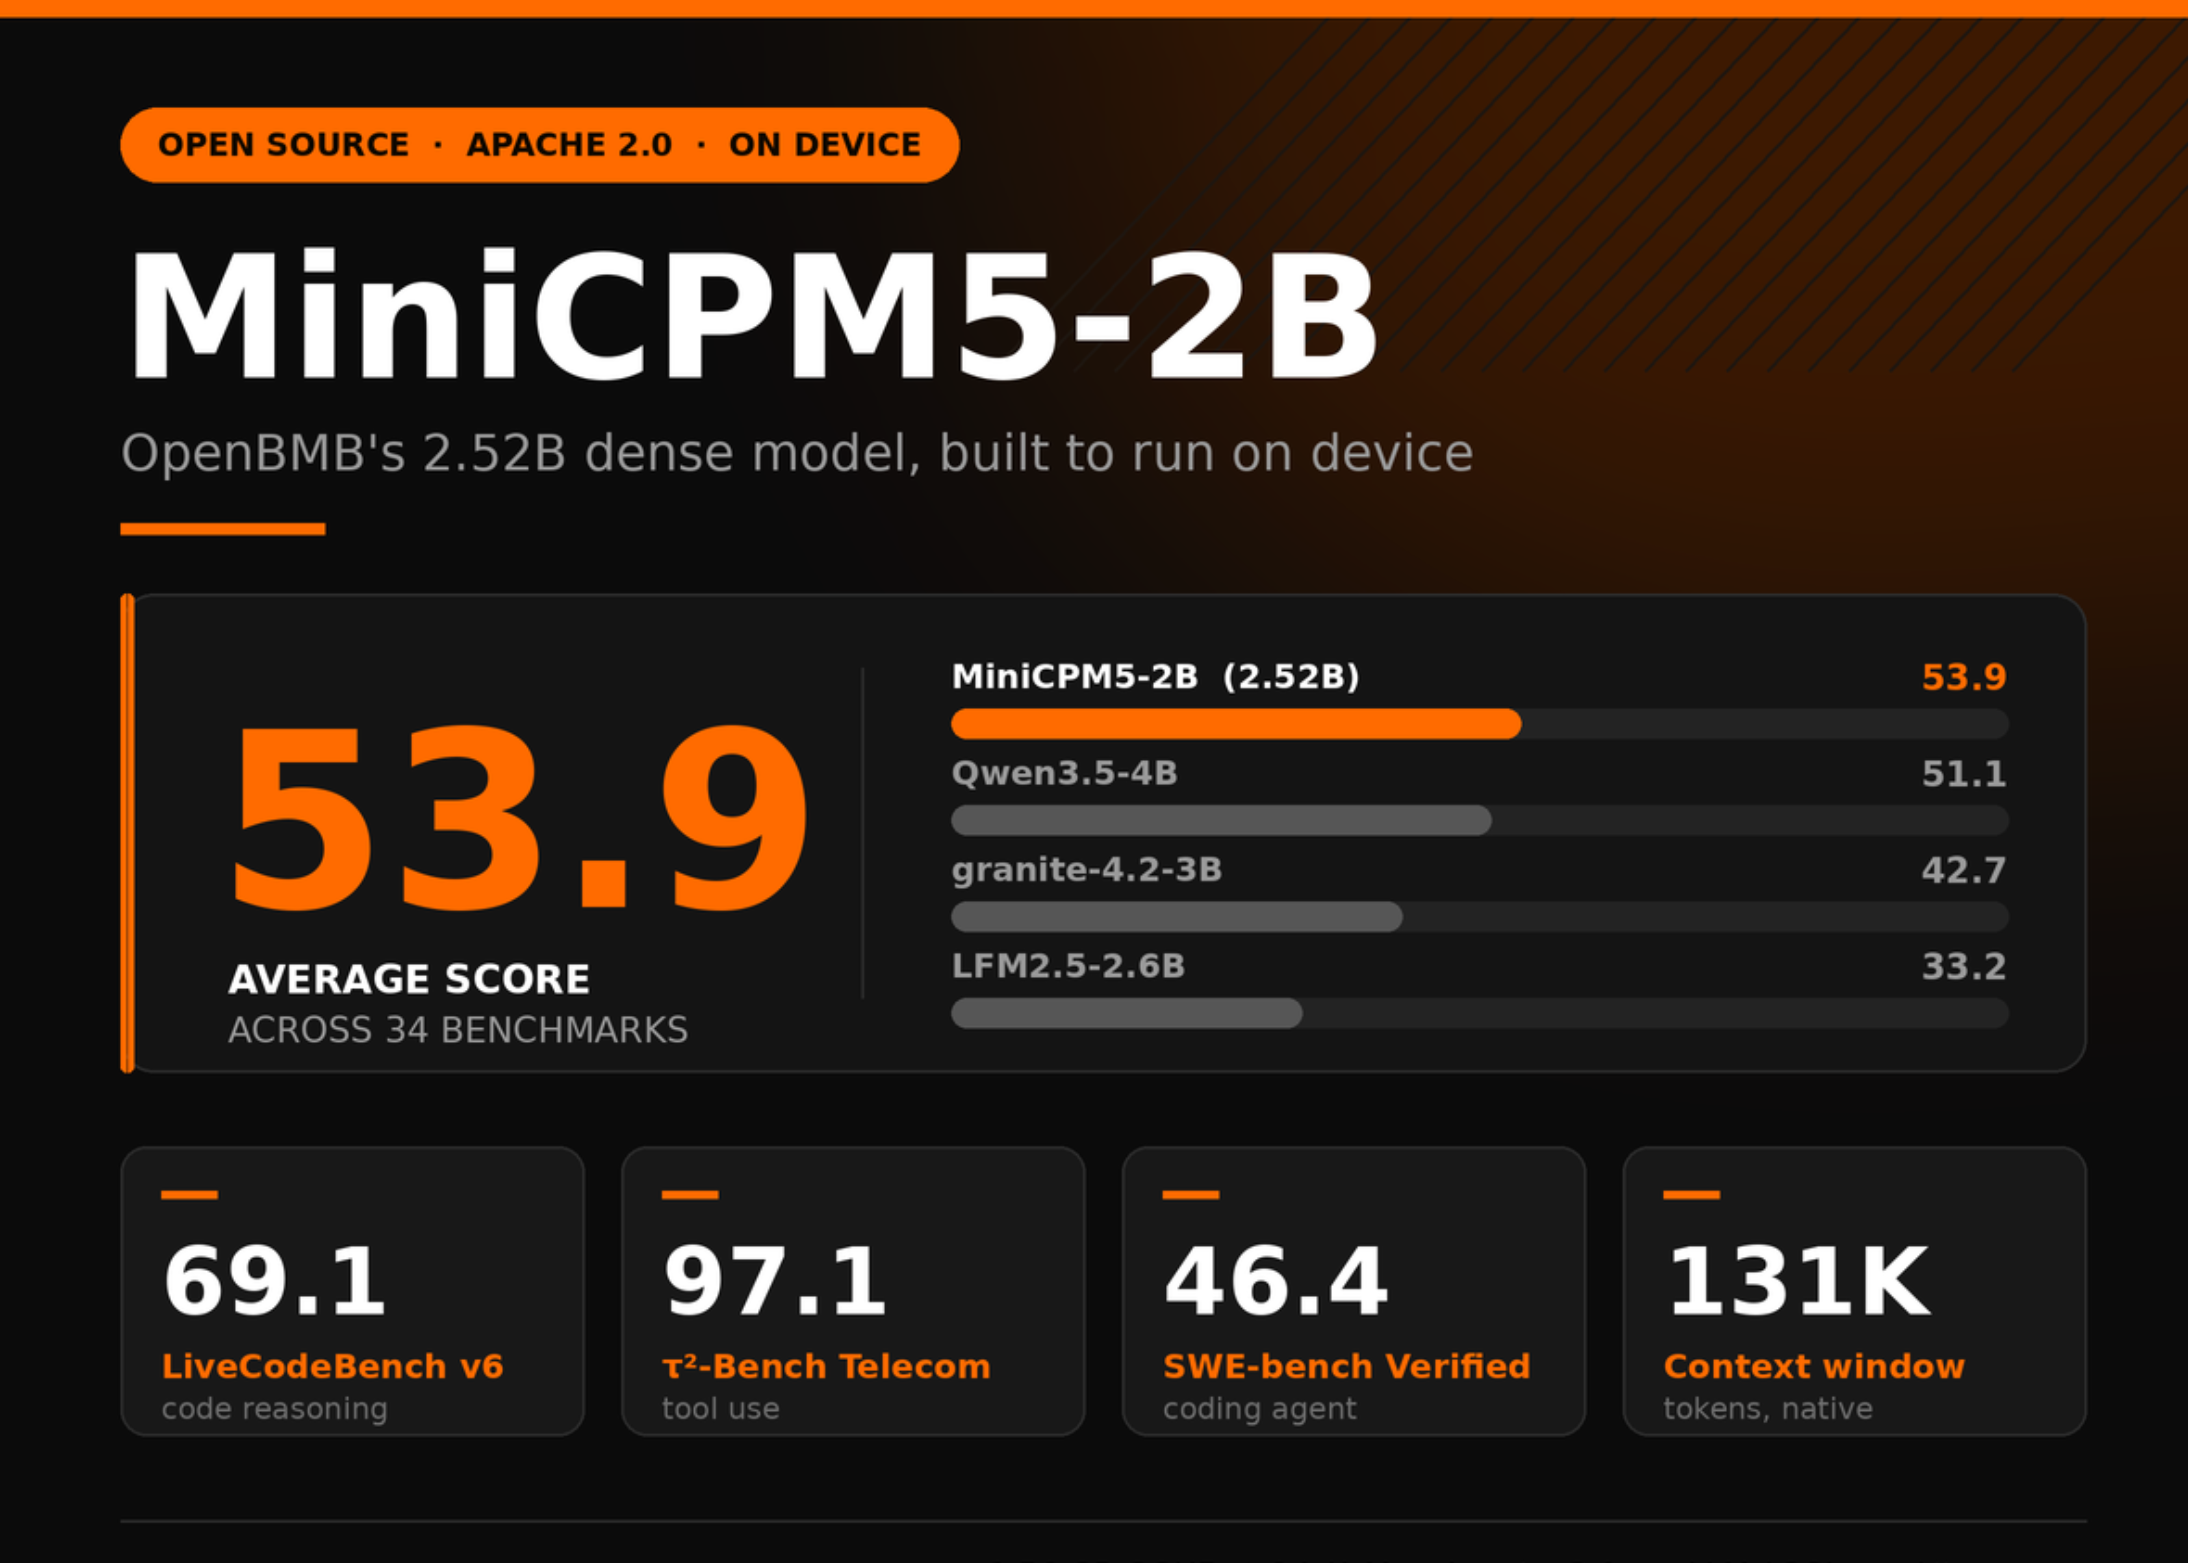
    • MiniCPM5-2B는 2,516,756,480개 파라미터(임베딩 제외 1,981,982,720개)를 가진 dense causal language model로, 42개 레이어와 grouped-query attention(query 16 head, key/value 2 head)을 채택했다.
    • 네이티브 컨텍스트 윈도우는 131,072 토큰이며, 아키텍처가 표준 LlamaForCausalLM이라 vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS에서 커스텀 커널이나 모델 코드 포크 없이 동작한다.
    • 라이선스는 Apache 2.0이고, 같은 크기급 비교 대상으로 LFM2.5-2.6B·Qwen3.5-2B·Gemma-4-E2B-it가, 레퍼런스로 Qwen3.5-4B(51.1)·granite-4.2-3B(42.7)·LFM2.5-2.6B(33.2) 등이 제시된다.

    분석

    목차

    미니CPM5-2B는 2,516,756,480개 파라미터에 네이티브 컨텍스트 윈도우 131,072 토큰이라는 스펙으로 9월 7일 모습을 드러냈다. 34개 벤치마크 평균 53.9점은 같은 라인업 베이스라인 최고 점수인 Qwen3.5-4B의 51.1을 2.8점 앞서는 수치다. 파라미터 수는 절반이 채 안 되는데 종합 점수는 더 높다. 필자 입장에서 이 모델의 진짜 의미는 “작다고 못 함”을 숫자로 입증한 데 있다.

    미니CPM5-2B 아키텍처: 표준 Llama 포크라 8개 추론 엔진 즉시 호환

    미니CPM5-2B는 42개 레이어에 grouped-query attention(query 16 head, key/value 2 head)을 채택한 dense causal language model이다. 임베딩을 제외하면 1,981,982,720개 파라미터다. 핵심은 아키텍처가 표준 LlamaForCausalLM이라는 점이다. vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS까지 8개 추론 엔진이 커스텀 커널이나 모델 코드 포크 없이 그대로 동작한다. Apache 2.0 라이선스까지 얹혔으니, 2~3B급 모델을 실서비스에 올리려던 팀에게는 가장 마찰이 적은 옵션 중 하나가 됐다.

    미니CPM5-2B, 34개 벤치마크 평균 53.9의 의미

    단일 점수 53.9만 봐서는 감이 안 잡힌다. 분야별로 쪼개 보면 미니CPM5-2B의 성격이 또렷해진다. 같은 크기급 비교 대상으로 LFM2.5-2.6B, Qwen3.5-2B, Gemma-4-E2B-it가, 레퍼런스로는 Qwen3.5-4B(51.1), granite-4.2-3B(42.7), LFM2.5-2.6B(33.2) 등이 제시됐다. 종합 53.9는 이 레퍼런스 풀 안에서 가장 높은 수치다.

    벤치마크 미니CPM5-2B 베이스라인 최고 격차
    34개 종합 평균 53.9 Qwen3.5-4B 51.1 +2.8
    LiveCodeBench v6 69.1 56.4 +12.7
    SWE-bench Verified 46.4 33.6 +12.8
    τ²-Bench Telecom 97.1
    BFCL v4 66.6
    τ³-Bench Banking 20.8 6.8 +14.0
    NoLiMa 68.1 43.5 +24.6
    AA-LCR 59.0 61.0 −2.0
    LongBench v2 43.7 47.3 −3.6
    MMLU-Pro 70.8 78.0 −7.2
    Humanity’s Last Exam 8.9 9.9 −1.0

    강점: 코드 추론과 도구 사용에서 베이스라인을 압도

    격차가 가장 큰 영역은 코드다. LiveCodeBench v6에서 69.1을 찍었고, SWE-bench Verified에서는 46.4로 베이스라인 33.6을 12.8점 차로 제쳤다. 2.5B 모델이 SWE-bench에서 46.4라는 건 단순 코드 완성이 아니라 multi-turn 디버깅까지 포함된 작업에서 절반 가까운 정답률을 내놨다는 의미다.

    도구 사용은 더 가파르다. τ²-Bench Telecom 97.1은 사실상 만점에 가깝고, BFCL v4 66.6, τ³-Bench Banking 20.8(베이스라인 6.8)도 함수 호출과 라우팅이 2.5B급에서 기대할 수 있는 수준을 한참 넘었다. 미니CPM5-2B가 에이전트 워크로드에 실제로 쓸 만한 후보라는 건 이 숫자들이 가장 직접적으로 말해준다.

    균형점: 장문 컨텍스트 항목별 편차와 일반 지식 한계

    모든 항목에서 앞서진 않는다. 장문 컨텍스트는 항목별로 결과가 갈린다. NoLiMa 68.1(베이스라인 43.5)에서는 24.6점 차로 우세하지만, AA-LCR 59.0(61.0)과 LongBench v2 43.7(47.3)에서는 오히려 밀린다. 131K 토큰 윈도우를 갖췄어도 실측 정확도에서 베이스라인을 못 따라가는 구간이 있다는 뜻이다.

    일반 지식도 비슷한 양상이다. MMLU-Pro 70.8(78.0), Humanity’s Last Exam 8.9(9.9) 모두 소폭 열세다. 파라미터가 절반에 가까운 모델이 광범위 사실 회상에서 4B급을 이길 수 없는 건 자연스러우니, 미니CPM5-2B를 “올라운더”가 아니라 “코딩·에이전트 특화 경량 모델”로 보는 편이 정확하다.

    학습 파이프라인: UltraData → 400B SFT → JustRL II → 16 expert 증류

    성적의 배경에는 단계별 학습 설계가 깔려 있다. base 학습은 UltraData 계층형 데이터 관리로 stable·decay 두 단계로 돌아갔고, mid-training 이후 400B 토큰 규모의 deep-thinking SFT가 진행됐다. RL 단계는 math·code·agentic·writing 네 영역을 따로 두고 JustRL II라는 critic 기반 teacher가 학습을 이끌었다. 마지막에 16개 전문가 모델을 단일 체크포인트로 합치는 on-policy distillation까지 붙는다.

    모델 카드는 Artificial Analysis 출처 행과 내부 재현 행을 분리 표기해 평가 일관성 이슈를 미리 명시했다. 재현 가능성을 의식한 흔적이다.

    지금 바로 해볼 것

    • Ollama 또는 llama.cpp로 미니CPM5-2B를 내려받아 Mac·RTX 3090 단일 GPU에서 추론 latency를 직접 측정한다.
    • 내 도메인 코딩 문제 30개를 골라 multi-turn 디버깅을 시켜본 뒤 Qwen3.5-2B·Gemma-4-E2B-it와 응답 품질을 비교한다.
    • BFCL 스타일 함수 호출 시나리오 10개를 만들어 tool-use 정확도를 사내 데이터 기준으로 재평가한다.
    • 131K 컨텍스트에 5만 토큰 분량의 사내 문서를 넣고 검색·요약 정확도를 NoLiMa·AA-LCR·LongBench 항목처럼 직접 점검한다.
    • Apache 2.0 적용 범위를 법무팀과 한 번 확인하고, 사내 파인튜닝 데이터에 대한 라이선스 리스크가 없는지 점검한다.

    실무 적용 포인트

    • 2~3B급을 평가할 때 종합 평균 한 점만 보지 말고 LiveCodeBench·SWE-bench·BFCL 같은 도메인 벤치마크를 가중치에 반영한다.
    • 에이전트 워크로드에 미니CPM5-2B를 쓰려면 함수 호출 라우팅을 별도 검증한다. τ²-Bench 97.1이 일반화 가능한 수치라고 단정하면 안 된다.
    • 장문 컨텍스트가 핵심이면 131K 윈도우 자체보다 AA-LCR·LongBench 같은 실측 항목 점수를 기준으로 모델을 가른다.
    • 온디바이스 배포 시 grouped-query attention의 key/value 2 head 구성 때문에 attention cache 메모리는 작지만 batch throughput은 떨어질 수 있으니 시나리오별로 측정한다.
    • 라이선스 검증이 끝났다면 vLLM·SGLang으로 1차 베이스라인을 띄우고, 부족한 영역은 JustRL II 식 RL 파인튜닝으로 보강하는 순서가 현실적이다.

    자주 묻는 질문

    미니CPM5-2B는 상업 프로젝트에 바로 쓸 수 있나요?

    Apache 2.0 라이선스라 상업적 사용과 2차 배포 모두 허용된다. 다만 모델 출력에 대한 책임은 사용자에게 있으니, 도메인 평가 후 도입 여부를 결정하는 편이 안전하다.

    2.5B 모델이 Qwen3.5-4B보다 점수가 높은데 정말 쓸 만한가요?

    34개 평균 53.9는 사실이다. 다만 우위는 코드와 도구 사용에 집중돼 있고 MMLU-Pro 같은 일반 지식에서는 7점 이상 밀린다. 평가 가중치를 도메인에 맞춰 다시 매겨야 한다.

    미니CPM5-2B는 온디바이스에서 실제로 돌아가나요?

    표준 LlamaForCausalLM 아키텍처라 llama.cpp, Ollama, LM Studio, MLX에서 그대로 실행된다. 다만 131K 컨텍스트 전체를 모바일에서 쓰기보다 8K~32K로 잘라 쓰는 게 현실적이다.

    기존 MiniCPM 모델에서 마이그레이션해야 할 이유가 있나요?

    이전 세대 대비 컨텍스트 윈도우와 코드·에이전트 점수가 동시에 끌어올려졌다. 신규 프로젝트라면 미니CPM5-2B로 시작하되, 기존 시스템은 토큰 사용량과 응답 latency를 비교한 뒤 단계적으로 옮기는 편이 낫다.

    원문 자료는 마크테크포스트의 MiniCPM5-2B 보도에서 확인했다. 비교군 정보는 같은 매체의 IFM K2 Horizon 출시 기사를 참고했다.

  • AI 암 치료 5년 안에 현실화 — Arm CEO가 진단한 칩 부족의 벽

    AI 암 치료
    Arm Holdings CEO, AI의 암 치료 기여 가능성과 칩 부족 병목 현상에 대한 입장

    핵심 요약

    • Arm Holdings의 CEO Rene Haas는 BBC 인터뷰에서 AI가 인간이 평생 찾을 수 없는 암 치료법을 찾을 수 있을 것이라고 주장함
    • Haas는 DNA 마커가 암에 미치는 영향을 모델링하는 것이 현재 인간과 AI 컴퓨터 모두에게 ‘너무 복잡한 문제’라고 설명함
    • 현재 AI의 급속한 성장은 데이터센터 구축에 필요한 칩 부족으로 지연되고 있다고 Haas는 진단함

    세계적인 반도체 설계사 Arm의 최고 경영자가 AI의 의료·산업 혁신 잠재력과 이를 가로막는 칩 부족이라는 구조적 병목을 동시에 진단한 사례로, 영국 기술 산업의 현 주소와 정책적 시사점을 짚는 분석

    목차

    AI 암 치료가 인간 연구자 평생이 걸려도 도달하지 못하는 분자를 찾아낼 수 있다. Arm Holdings의 CEO Rene Haas가 BBC 인터뷰에서 꺼낸 이 발언은 낙관도 비관도 아닌, 데이터 부족과 칩 병목이라는 두 현실적 제약 위에 세워진 진단이다.

    올해 여름 AI 붐이 Arm 주가를 최고점으로 끌어올렸을 때, 이 회사는 현금 기준 영국 본사 사상 최고 가치 기업에 등극했다. Arm은 제조를 하지 않는 설계사다. 그 점이 Haas의 발언에 설계자 특유의 냉철함을 부여한다. 전 세계 수천억 개 기기—휴대전화, 자동차, 스마트워치, 가젯—에 들어가는 CPU를 설계하는 회사가 진단하는 AI 인프라의 한계는, 추상적 우려가 아니라 부품 번호 단위의 현실이다.

    Haas가 본 AI 암 치료의 가능성과 한계

    BBC의 ‘Big Boss Interview’ 팟캐스트에서 Haas는 DNA 마커가 암 발현에 미치는 영향을 모델링하는 일이 지금의 인간 연구자뿐 아니라 AI 컴퓨터에게도 ‘너무 복잡한 문제’라고 인정했다. 다만 그 복잡함의 한쪽 끝이 풀리는 순간, 인간이 평생 걸려서도 찾지 못했던 AI 암 치료 후보 물질이 화면 위로 올라올 수 있다는 게 그의 그림이다.

    Institute of Cancer Research 소속 Prof Chris Bakal(Sentinal4D CEO)도 BBC에 같은 답을 했다. 암은 유전체·미세환경·시간 축이 얽힌 시스템이라는 점에서 AI의 패턴 인식이 연구 속도를 끌어올릴 여지가 있다는 입장이다. 필자는 이 지점이 가장 의미 있다고 본다. 신약 파이프라인이 10년 단위로 움직이는 산업에서, 분자 단위 시뮬레이션을 자동화한다는 건 비용 구조 자체를 뒤집는 서사이기 때문이다.

    AI 암 치료의 시간축은 어디까지 줄어드는가

    AI 암 치료가 가져올 시간 축의 압축은 후보 도출 단계에서 두드러진다. 기존 신약 개발은 후보 물질 도출부터 임상 3상 통과까지 평균 10~15년이 걸리는데, AI가 탐색 공간을 좁히면 전임상 단계는 수개월 단위로 단축될 수 있다는 게 보수적 추정이다. 다만 임상 단계의 환자 모집·규제 승인·부작용 검증은 여전히 시간과 비용이 그대로 남는다. 즉 AI가 줄여주는 건 ‘연구’이지 ‘승인’이 아니다.

    칩 부족이 만드는 데이터센터 병목

    Haas는 AI 성장이 데이터센터 증설에 필요한 반도체 부족으로 발목 잡히고 있다고 못 박았다. GPU와 고대역폭 메모리(HBM) 공급망이 수요를 따라가지 못하면서 신규 데이터센터 착공 일정이 밀리고 있다는 설명이다. 실무자 입장에서 눈에 띄는 건, Arm이 이 병목을 직접 풀지 못한다는 점이다. Arm은 CPU 설계사이며, GPU·HBM 시장은 NVIDIA·AMD·SK하이닉스가 장악하고 있다. ‘칩을 만들 줄 아는 곳이 없다’는 사실을 가장 잘 아는 사람이 그 이야기를 했다는 무게가 있다.

    Arm의 시장 위상과 소프트뱅크-OpenAI 구조

    Arm의 모회사인 일본 소프트뱅크는 OpenAI를 포함한 다양한 기술 투자를 묶고 있다. Haas의 시각에는 일본 자본의 글로벌 분산 전략이 반영돼 있다. OpenAI-브레인웨이브-London-Stargate로 이어지는 인프라 투자는 Arm 설계 수요의 직접적인 수혜 경로다. 올해 여름 Arm은 FTSE 100 내 셰일 기업들을 제치고 영국 본사 사상 최고 가치 자리(현금 기준)에 올랐다. 설계 산업이 다시 재평가받는 신호탄이다.

    휴머노이드 로봇 5년 보편화, 영国内 제조는 회의

    Haas는 향후 5년 안에 휴머노이드 로봇이 보편화될 것이라고 예견했다. 모빌리티·물류·가사 영역에서 두 발 보행 플랫폼이 상용화되면, 그 안에 들어가는 저전력 CPU 수요가 Arm의 다음 먹거리라는 계산이다. 반면 영국 내 칩 제조 가능성에 대해서는 회의적이다. TSMC 애리조나, 인텔 오하이오, 삼성 텍사스 신공장만 보더라도 첨단 노드 팹 건설에는 수십억 달러 단위 자본이 필요하다. 영국 정부의 반도체 전략은 R&D 보조금 중심이며, 대규모 제조 거점 확보에는 한계가 분명하다. 올해 4월 Haas는 영국 제약 대기업 AstraZeneca 이사회에서도 사임했다. AI 헬스케어 스타트업과 다른 대형 제약사의 의사결정 속도 차이 때문으로 보인다.

    글로벌 첨단 노드 투자 비교

    지역 주요 프로젝트 투자 단계 비고
    미국 애리조나 TSMC 1~3공장 1공장 가동, 2~3공장 건설 3나노 노드
    미국 오하이오 인텔 신공장 건설 초기 최대 1.4나노
    미국 텍사스 삼성 테일러 부분 가동 4나노 노드
    영국 캠브리지 Arm R&D 본사 설계 거점 제조 없음
    일본 구마모토 TSMC JASM 1공장 가동, 2공장 건설 12~6나노

    표에서 보이듯 영국은 설계 역량만으로는 첨대하나, 제조 인프라 자립까지는 거리가 있다. 이는 Haas의 진단을 수치로 뒷받침한다.

    쟁점 정리

    • AI 암 치료의 본질은 신약 후보 물질의 탐색 속도 향상이지, 진단·치료 시점의 단기 혁신이 아니다
    • 칩 부족은 GPU·HBM 위주의 학습용 인프라 병목이며, Arm은 이를 직접 풀지 못하는 설계사 포지션이다
    • 영국 반도체 자립은 정책 의지보다 팹 건설 자본과 공급망 확보가 더 큰 변수다
    • 휴머노이드 로봇 상용화 시점은 배터리·액추에이터·소프트웨어 세 축이 동시에 성숙해야 한다
    • Arm의 영국 본사 가치는 주식 시장이 설계 산업을 재평가하는 신호로 읽힌다

    지금 바로 해볼 것

    • Arm 분기별 주가를 FTSE 100 대비 상대 수익률로 변환해 6개월 추세를 캡처한다
    • BBC ‘Big Boss Interview’ 원본 팟캐스트를 청취해 Haas의 어조를 직접 확인한다
    • OpenAI·앤트로픽·xAI 등 AI 랩의 데이터센터 캐퍼엑스 발표를 주 단위로 추적한다
    • AI 암 치료 관련 산업 뉴스 알림을 등록해 분기 단위로 모니터링한다
    • TSMC·인텔·삼성의 신규 팹 착공 일정을 한 표로 만들어 영国内 투자와 비교한다

    자주 묻는 질문

    Haas는 언제 이 인터뷰를 했나?

    2025년 가을 BBC ‘Big Boss Interview’ 팟캐스트와 동행 기사에서 공개된 내용이다. Arm의 주가 사상 최고치 이후 시점과 맞물린다.

    Arm은 직접 AI 암 치료 연구를 하나?

    아니다. Arm은 칩 설계사로서 AI 인프라의 CPU를 공급하는 위치이며, 신약 R&D는 별도 영역이다. Haas의 발언은 거시적 진단에 가깝다.

    영국에서 첨단 칩을 만들 수 있나?

    Haas 본인이 회의적이라고 못 박았다. TSMC·인텔·삼성 대비 자본·인력·공급망 모두 부족하다는 게 업계의 중론이다.

    휴머노이드 로봇 5년 보편화는 어떤 의미인가?

    가정·물류·제조 현장에서 두 발 보행 로봇이 제한적 형태로 투입되는 시점을 가리키며, 완전 자율 가정용 로봇과는 거리가 있다.

    출처: BBC News – Arm CEO Rene Haas 인터뷰

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: BBC News — AI cancer cures slowed by chip shortage, says UK's biggest tech boss

  • 금융 내부통제 3대 전환 — 사후감사에서 상시 모니터링으로

    금융 내부통제
    금융권 내부통제 체계의 패러다임 전환: 정기 사후감사에서 접속기록 기반 상시 모니터링으로

    핵심 요약

    • 금융권 내부 직원의 고객 금융거래 정보 무단 조회 및 사적 유용 사례가 잇따라 적발되며 기존 내부통제 체계의 구조적 한계가 드러났다.
    • 외주 개발·운영 인력 관리 소홀로 인한 비인가 데이터 다운로드 사고가 발생하며 협력사·위탁사 통제 공백이 문제로 부상했다.
    • 표본 추출 방식의 정기 사후감사만으로는 지능화된 내부자 위협을 적시에 탐지하기 어렵다는 평가가 확산되고 있다.

    금융 내부통제 패러다임 전환의 배경, 당국의 규제 강화 움직임, 상시 모니터링 체계의 실무적 시사점을 균형 있게 분석하는 해설형 기사

    목차

    금융 내부통제의 사각지대를 드러낸 사건이 2024년 시중은행에서 발생했다. 고객 1만여 명의 금융거래 정보를 담당 직원이 업무 시간 외에 반복 조회한 사실이 내부 점검에서 뒤늦게 드러났다. 이미 조회한 정보는 외부로 유출된 뒤였고, 피해는 더 커지기 전에 우연히 발견됐다. 이 사건은 표본추출 방식의 정기 사후감사만으로는 내부자 위협을 적시에 잡아낼 수 없다는 현실을 적나라하게 보여줬다.

    이후 금융 내부통제는 근본적인 전환점을 맞고 있다. 정기 사후감사에서 접속기록 기반 상시 모니터링 중심으로, 그리고 임원의 모호한 책임에서 책무구조도에 따른 구체적 책임으로 재편되는 흐름이 가속화되고 있다. 보안뉴스 보도에 따르면 최근 적발된 내부 정보 유출 사례 상당수가 시간 외 접근과 외주 인력 경로를 통해 발생했다.

    기존 사후감사의 구조적 한계와 지능화된 내부자 위협

    대부분 금융회사의 내부통제는 월 1~2회 표본감사 형태로 운영돼 왔다. 전체 거래 중 무작위로 0.5~1% 정도를 추출해 사후적으로 확인하는 방식이다. 이 구조적 한계는 금융 내부통제 실무에서 오래 지적돼 온 부분이기도 하다. 비용과 인력 문제로 쉽게 바뀌지 않았다.

    문제는 표본에서 빠진 99%의 영역이다. 내부자가 의도적으로 사각지대를 노리면 표본감사는 무력화된다. 퇴근 시간대, 휴일, 협력사 계정으로 접근하는 경우 대부분 표본에서 누락된다. 필자가 이 지점에서 가장 우려하는 건, 지능화된 내부자일수록 표본감사라는 공통 약점을 정확히 파악하고 있다는 점이다.

    내부자 위협의 형태도 달라졌다. 단순 호기심 조회를 넘어 조직화된 유출, 외주 개발·운영 인력을 통한 우회 접근, 그리고 본인은 깨끗하게 보이게 하면서 시스템을 악용하는 사례까지 등장했다. 2023년 카드사 협력사 직원이 고객 정보를 내려받은 사고가 대표적으로, 권한 관리 부재가 직접적 원인으로 지목됐다.

    당국의 규제 강화: 책무구조도와 양대 법률 개정

    금융당국은 이런 현실에 맞춰 규제 프레임을 바꾸고 있다. 핵심 키워드는 책무구조도다. 2024년 본격 도입된 책무구조도는 임원별로 관리해야 할 구체적 업무와 책임을 문서화하도록 요구한다. “알고 있었다”는 변명이 통하지 않게 만들었다는 점에서 의미가 크다.

    신용정보법과 개인정보보호법도 함께 강화되는 방향이다. 개인정보 유출 시 통지 의무가 명확해졌고, 과징금 상한이 확대됐으며, 대표이사의 직접 책임 조항이 도입됐다. 한 은행 간부 출신은 “이제 잘못된 지시나 방치가 곧 개인 형사책임으로 이어질 수 있어 임원진의 인식 자체가 달라졌다”고 말했다. 실무자 입장에서 눈에 띄는 변화는 컴플라이언스 팀이 형식적 점검에서 실질적 통제 조직으로 무게중심을 옮기기 시작한 점이다.

    상시 모니터링 체계의 4가지 핵심 요소

    그렇다면 실무에서 상시 모니터링은 어떤 모습이어야 할까. 핵심은 접속기록의 전수 수집과 실시간 분석이다.

    첫째, 모든 업무 시스템의 사용자 접속기록을 단일 로그 저장소로 통합해야 한다. 영업점 단말, 콜센터, 외주 협력사 VPN, 관리자 콘솔까지 동일한 기준의 타임스탬프와 사용자 ID로 기록돼야 의미 있는 분석이 가능하다. 둘째, 이상징후 탐지 룰을 정교하게 설계해야 한다. 단순 임계치가 아니라 행위 패턴 분석으로 가는 게 핵심이다.

    셋째, 탐지된 이상징후는 즉시 컴플라이언스 팀과 담당 임원에게 자동 통보되도록 설계해야 한다. 탐지와 조치가 분리되면 효과는 반감된다. 넷째, 협력사·위탁사 관리다. 외주 인력의 접근 권한을 업무 단위로 최소화하고, 작업 종료 시점에 자동으로 권한이 회수되도록 설정해야 한다.

    금융 내부통제, 어디로 가고 있나

    금융 내부통제의 전환은 이제 시스템 도입의 문제가 아니라 조직 문화의 문제에 가깝다. 상시 모니터링은 본질적으로 직원 행위에 대한 지속적 감시라는 저항을 수반한다. 모니터링이 직원 보호와 고객 신뢰를 위한 수단이라는 메시지가 회사 차원에서 분명히 전달돼야 저항을 줄일 수 있다.

    또한 수집만 해놓고 분석하지 못하는 사례가 적지 않다. SIEM 같은 도구 도입과 함께 분석 인력 양성이 병행돼야 실효성이 나온다. 결국 금융 내부통제의 본질은 “사고가 난 뒤에 누가 책임지느냐”가 아니라, “사고가 나기 전에 어떻게 잡아내느냐”로 옮겨가고 있다. 무게중심이 사후에서 상시로, 표본에서 전수로, 형식적 책임에서 실질적 책임으로 이동하는 과정이 지금 진행 중이다.

    쟁점 정리

    • 상시 모니터링은 직원 행위에 대한 지속적 감시라는 저항을 수반하므로, 회사 차원의 명분과 목적 공유가 선행돼야 한다
    • 접속기록 수집량 증가에 따른 분석 역량 병행 확보 없이는 경보 피로와 형식적 운영에 빠질 위험이 있다
    • 협력사·위탁사 접근 권한의 업무 단위 최소화 및 작업 종료 시 자동 회수 정책이 통제 공백을 막는 핵심 수단이다

    지금 바로 해볼 것

    • 현재 내부통제 체계의 표본 추출 비율과 점검 주기를 파악해 상시 모니터링 도입 필요성을 경영진에 보고한다
    • 전사 업무 시스템의 접속기록이 단일 로그 저장소로 통합돼 있는지 확인하고 미비 시 통합 계획을 수립한다
    • 업무 시간 외 대량 조회, 권한 외 접근 등 핵심 이상징후 룰을 도출해 SIEM 등 탐지 시스템에 등록한다
    • 외주 협력사 접근 권한을 업무 단위로 최소화하고 작업 종료 시 자동 회수되도록 권한 정책을 점검한다
    • 탐지된 이상징후가 컴플라이언스 팀과 임원에게 자동 통보되는 에스컬레이션 경로를 설계한다

    기존 사후감사와 상시 모니터링 비교

    구분 기존 사후감사 상시 모니터링
    점검 방식 월 1~2회 표본추출 (전체의 0.5~1%) 접속기록 전수 실시간 분석
    탐지 시점 사고 발생 후 사후 이상징후 발생 즉시
    대상 정규 직원 위주 정규 직원 + 외주 협력사 포함
    책임 소재 팀 단위 모호한 책임 책무구조도 기반 임원별 구체 책임
    이상징후 대응 표본에서 발견 시 수동 조사 자동 알림 및 에스컬레이션

    자주 묻는 질문

    책무구조도 도입이 기존 금융 내부통제와 다른 핵심은 무엇인가

    책무구조도는 임원별로 관리해야 할 구체적 업무와 책임을 문서화하도록 요구한다. 기존에는 책임을 묻기 어려웠던 모호한 영역이 사라지고, 문제 발생 시 누구의 책무인지 즉시 특정할 수 있게 됐다.

    상시 모니터링은 직원 사기 저하를 일으키지 않는가

    이런 우려는 자연스럽지만, 모니터링의 목적을 고객 정보 보호와 직원 보호로 명확히 설명하고 대상을 업무 관련 행위로 한정하면 저항을 상당 부분 줄일 수 있다. 사내 커뮤니케이션 전략이 함께 가야 효과적이다.

    접속기록 기반 상시 모니터링을 도입할 때 가장 큰 기술적 과제는 무엇인가

    로그 통합과 실시간 분석이다. 여러 시스템에 분산된 접속기록을 단일 저장소로 모으고, 이를 SIEM 같은 도구로 실시간 분석하는 인프라 구축이 선행돼야 의미 있는 탐지가 가능하다.

    소규모 금융회사도 상시 모니터링 체계를 도입할 수 있는가

    전체 SIEM을 자체 구축하기 어려우면 클라우드 기반 보안 분석 서비스를 활용하는 방법이 있다. 핵심은 도구의 크기가 아니라 로그 통합과 이상징후 룰의 완성도다.

  • AI데이터센터 화재 1건이 노출한 32억 달러 다중기업 구조의 책임 공백 — Lake Mariner 사건의 교차 검증

    AI데이터센터
    AI 데이터센터 Lake Mariner 화재로 드러난 다중 기업 참여 구조의 책임 소재 문제

    핵심 요약

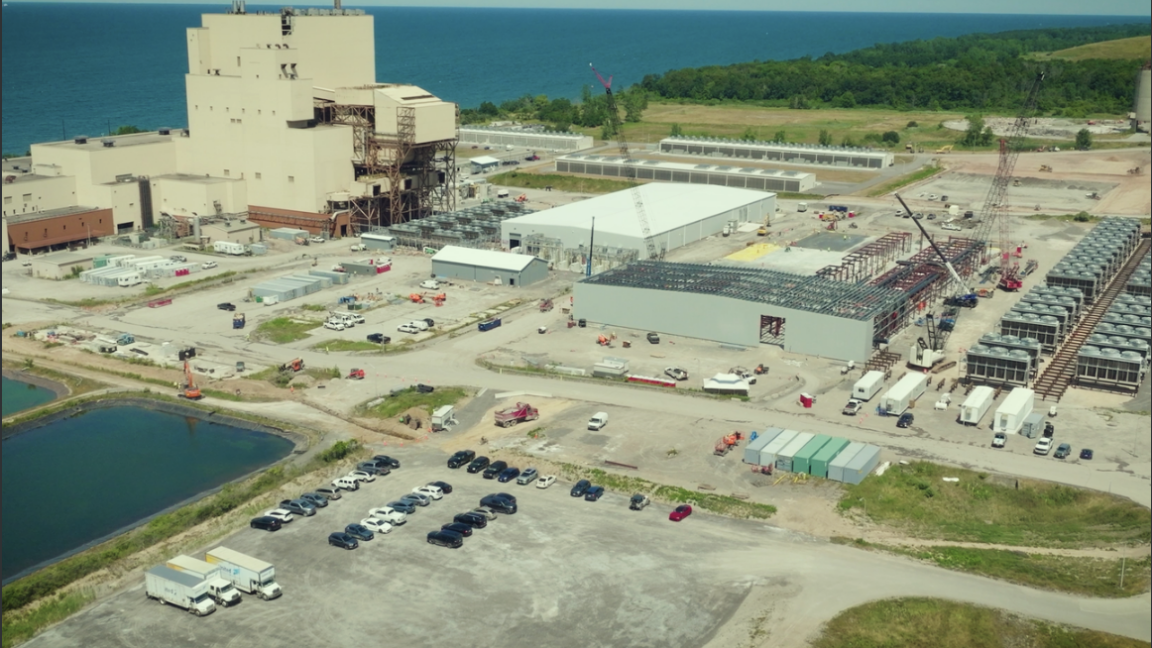
    • 2026년 6월 초, 미국 뉴욕주 서머셋의 Lake Mariner 데이터센터 신축 건물에서 화재가 발생했으며, 이 시설은 총 32억 달러 규모 AI 데이터센터 캠퍼스의 일부임
    • Barker Fire Department 소속 Steve Matisz 소방서장은 진압 당시 작동하는 화재 경보기, 진화 설비, 가동 가능한 소화전이 없었다고 진술했으며, 소방관이 법적으로 열람할 수 있는 안전 문서가 화재로 소실되었다고 보고됨
    • 현장은 온타리오호 연안 폐탄광 부지이며, 뉴욕 주 내 최대 규모 AI 데이터센터 신축 중 하나임

    분석

    목차

    2026년 6월 초, 미국 뉴욕주 서머셋의 Lake Mariner AI데이터센터 신축 건물에서 화재가 발생했다. 진화에 투입된 Barker Fire Department 소속 Steve Matisz 소방서장은 가동 가능한 화재 경보기, 진화 설비, 소화전이 한 곳도 없었다고 진술했다. 32억 달러 규모 캠퍼스에서 시작된 이 사건은 단순한 화재가 아니라, 다중기업 AI데이터센터 구조의 책임 공백을 그대로 드러낸 사례다.

    이 캠퍼스에는 최소 4개 기업이 참여한다. 토지와 건물을 소유·운영하는 TeraWulf, 영국 AI 기업 Fluidstack이 운영을 맡고, Google은 Fluidstack의 임대료를 보증하며 향후 14% 지분 warrant를 보유한다. 컴퓨트 수요처에는 Anthropic이 포함된다. 실무자 입장에서 눈에 띄는 건 토지 임대 구조다. TeraWulf의 자사 CEO가 소유한 회사가 토지를 TeraWulf에 임대한 것으로 알려졌는데, 이건 운영 안전 의무가 누구에게 있는지 흐리게 만드는 장치로 보인다.

    기업 역할 안전 의무 표명
    TeraWulf 소유·운영, 캠퍼스 운영사 공식 회신으로 인정
    Fluidstack 운영 주체 (영국 AI 기업) 별도 표명 없음
    Google 임대료 보증 + 14% warrant 별도 표명 없음
    Anthropic 컴퓨트 수요처 별도 표명 없음

    TeraWulf 최고전략책임자 Kerri Langlais는 운영 안전, 비상 대응, 필수 안전 설비, 지역 소방기관과의 조정에 대한 책임을 TeraWulf가 진다고 공식 회신했다. 화려한 책임 인정이다. 하지만 화재 당시 소방관의 안전 문서 열람이 불가능했고, 그 문서가 화재로 소실되었다는 보고는 “책임이 있다”와 “실제로 그 책임을 수행했다” 사이의 거리를 그대로 보여준다.

    필자는 이 지점이 가장 의미 있다고 본다. 책임 소재는 화재를 막는 장치가 아니라, 화재 이후 소방관과 지역 사회가 정보를 받을 수 있는 채널을 말한다. 그 채널이 다중기업 AI데이터센터 구조 안에서 누가 잠그는지조차 명시되지 않은 상태에서 “TeraWulf가 책임진다”는 진술은 법적 방패에 가깝다.

    원문은 Ars Technica의 분석 기사에서 자세히 다뤄졌고, 같은 시기 RAM 가격 급등이 AI 인프라 확충 비용을 밀어올리고 있다는 보도는 The Verge의 공급망 분석에서 교차 검증된다.

    AI데이터센터 안전 책임의 단일 귀속 문제는 어디서 비롯되는가

    Lake Mariner는 다중기업 AI데이터센터 구조의 모순을 응축한다. TeraWulf는 책임 주체라고 밝히지만, 자금 보증과 지분 warrant를 가진 Google, 운영 권한을 가진 Fluidstack, 수요를 만들어내는 Anthropic은 각각 어떤 의무를 가지는가. 어느 한 회사도 일선 소방관에게 직접 연락할 법적 의무가 명시되어 있지 않다면, 신고가 들어왔을 때 누구에게 전화를 걸어야 하는지조차 불분명해진다. 이건 Lake Mariner만의 문제가 아니다. 미국 전역에서 신축되는 대형 AI데이터센터 캠퍼스가 거의 같은 다중기업 구조를 채택하고 있다.

    쟁점 정리

    • 다중기업 AI데이터센터 구조에서 운영 안전 책임의 단일 귀속 주체를 계약상 명시해야 한다
    • 토지 임대가 자사 CEO 소유 회사와 이뤄지는 경우 이해상충 공시 의무가 따라와야 한다
    • 신축 단계에서 소방서 사전 인지와 안전 문서 원격 열람 체계가 의무화돼야 한다
    • Google, Anthropic 등 자금·수요 측의 비상 대응 기여 범위를 사전에 정의할 필요가 있다

    지금 바로 해볼 것

    • 거주지 인근에 신축 중이거나 가동 예정인 AI데이터센터 캠퍼스의 참여 기업 목록을 확인한다
    • 해당 사업자에게 안전 책임 귀속 주체와 비상 연락망을 서면으로 요청한다
    • 지역 소방서 관할 구역 내 데이터센터 입지를 지도에 표시하고 소방 공지 채널을 구독한다
    • 임대 구조가 자사 임원 소유 회사와 겹치는 경우 주주총회 안건에 공시 여부를 질문한다
    • 기업 ESG 보고서에서 데이터센터 안전 지표가 별도 항목으로 분리돼 있는지 점검한다

    자주 묻는 질문

    Lake Mariner AI데이터센터 화재는 언제, 어디서 발생했나?

    2026년 6월 초 미국 뉴욕주 서머셋의 Lake Mariner 신축 건물에서 화재가 발생했다. 이 시설은 32억 달러 규모 캠퍼스의 일부이며, 온타리오호 연안 폐탄광 부지에 들어서고 있다.

    TeraWulf가 안전 책임을 진다고 밝힌 게 왜 충분하지 않은가?

    화재 당시 소방관이 법적으로 열람해야 할 안전 문서가 소실되었고, 가동 가능한 경보기와 소화전도 없었다는 진술이 나왔다. 책임 주체가 누구인지를 밝히는 것과 실제 그 책임이 수행되는 것은 별개의 문제다.

    Google과 Anthropic은 이 화재와 어떤 관계가 있는가?

    Google은 Fluidstack의 임대료를 보증하고 향후 14% 지분 warrant를 보유한다. Anthropic은 컴퓨트 수요처로 참여한다. 두 회사 모두 안전 의무에 대해 공식 입장을 밝힌 바 없다.

    자사 CEO 소유 회사가 토지를 임대하는 구조는 왜 문제인가?

    임대인이 운영사 CEO와 동일 인물일 경우 임대 조건과 운영 의사결정 사이의 이해상충이 생긴다. 비상 대응 자금을 누가 부담하는지, 시설 투자 우선순위를 누가 정하는지가 외부 감사를 받기 어렵다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Ars Technica — The complex corporate web behind a $3.2 billion AI data center

  • AI 직업 위험 4가지 기준 — 화이트칼라 불안 푸는 체크리스트

    핵심 요약

    • 원글의 상황 조건: AI가 CS 일자리를 줄이고 있다는 뉴스가 반복되면서, 다른 화이트칼라 직종(회계, 일반 엔지니어링, 법률 등)으로의 전환을 권하는 주장이 커뮤니티에서 나오고, 그 주장에 의문을 품은 사용자가 ‘결국 어떤 직업도 안전하지 않다’는 결론에 도달한 상태로 보임.
    • 원글에서 드러난 사고의 함정: ‘A 직종이 위험하다면 B 직종도 위험하다’처럼 직업 단위로 위협을 일반화하는 경향이 있으며, 작성자 스스로 ‘Maybe Im just dumb’라고 적을 정도로 확신이 부족한 채 결론을 내린 것으로 읽힘.
    • 커뮤니티에서 반복되는 해법 후보: ① 직종 전체가 아니라 직무 내 ‘업무 단위’로 AI 노출도를 쪼개 보는 방식, ② 면허·자격·책임이 결합된 영역(공인회계사, 변리사, 의사 등)과 개방형 시장 영역을 구분하는 방식, ③ 고객·현장·물리적 존재가 필요한 단계(감사, 시공, 소송 출정 등)와 문서·코딩 단계가 분리된 업무를 구분하는 방식이 자주 언급되는 흐름으로 보임.

    분석

    목차

    AI 직업 위험이 화이트칼라 사이에서 진지한 대화로 자리 잡은 지는 꽤 됐다. “CS가 줄어든다”는 뉴스를 본 뒤 “그러면 다른 화이트칼라도 결국 같은 거 아닌가”라는 불안이 빠르게 번지는 게 현실이다. 같은 고민이 한 커뮤니티 스레드에서도 반복적으로 등장했다(CS 직군을 떠나도 안전한 자리가 있는지 묻는 글). 필자 역시 이 질문은 가볍게 넘길 수 없다고 본다.

    왜 같은 불안이 계속 반복되는가

    “안전한 직업은 없다”는 결론은 보통 두 단계의 일반화를 거쳐 도출된다. 첫 단계는 “A 직종이 위협받는다”는 뉴스를 받아들이는 것이고, 두 번째는 “B, C, D 직종도 비슷할 것”으로 확장하는 것이다. 문제는 확장이 직업 단위로 일어난다는 점이다.

    직종을 통째로 묶어 판단하면 같은 이름 안에서 자동화가 쉬운 업무와 어려운 업무가 섞인다. 회계라는 이름 아래 반복 입력과 감사·자문이 같이 있고, 엔지니어링 아래 신규 설계와 운영·사고 대응이 같이 있다. 이때 AI 직업 위험은 “직업”이 아니라 “업무 조각”에서 발생한다는 사실이 가려진다.

    필자가 보기에 이 지점이 가장 의미 있다. 같은 직종 안에서도 어느 조각에 앉느냐에 따라 노출도가 완전히 갈린다.

    AI 직업 위험을 가르는 4가지 기준

    커뮤니티에서 반복적으로 등장하는 분석을 종합하면, 노출도는 네 축으로 쪼갤 수 있다. 규칙성·반복성, 결과에 대한 책임 소재, 물리적·관계적 맥락 의존도, 인력 공급 과다 여부다. 이 네 가지에 본인의 업무를 대입하면 답이 직업명이 아닌 업무 구성으로 나온다.

    기준 노출 높음 노출 낮음
    규칙성 정형 입력·반복 문서 예외 처리·신규 설계
    책임 소재 결과만 받아 적는 단계 승인·감사·자문
    물리·관계 화면 안의 코드·문서 현장·고객 면담·출동
    인력 공급 대체 인력 풍부 면허·자격 결합

    표를 채울 때 오른쪽 열에 업무가 많이 걸릴수록 같은 AI 직업 위험의 파도에서도 속도가 느리다. 이 점수표는 AI 직업 위험을 직종명이 아닌 업무 구성으로 환원해 보여주는 도구다.

    자주 등장하는 착각

    “CS가 위험하니 다른 화이트칼라로 가야 한다”는 조언은 한 방향으로는 맞고 한 방향으로는 틀리다. 맞다, 소프트웨어 개발도 코딩 조각에 한해서는 자동화 압력을 받는다. 틀리다, 회계·법률·엔지니어링이 안전한 도피처라고 보는 시각이다. 그 직종에도 “정형 입력” 단계는 있으며, 거기서 사람이 밀려난다.

    또 다른 실수는 헤드라인을 실제 자동화율과 동일시하는 것이다. 현업 체감과 뉴스 헤드라인은 보통 2~3년 정도 차이 난다. 진로 선택을 “어느 분야가 덜 위험한가”로만 좁히면 흥미와 강점을 잃기 쉽다. AI 직업 위험은 분야 사이의 거리가 아니라 같은 분야 안에서의 거리를 좁히는 문제다.

    지금 바로 해볼 것

    • 현재 직무의 업무를 10개로 쪼개 적고, 각각을 4기준(규칙성·책임·맥락·공급)으로 한 줄씩 메모한다.
    • 4기준 중 3개 이상 ‘노출 높음’에 해당하는 업무가 절반을 넘는지 확인한다.
    • 과반이 노출 높음이면 같은 조직 안에서 안전 열 업무로 이동할 수 있는지 상사에게 6개월 안에 제안한다.
    • 안전 열 업무 비중이 늘고 있는지 6개월 단위로 재점검하는 캘린더 알림을 등록한다.
    • 헤드라인 대신 채용 공고 수치와 실제 업무 변화율을 따로 추적한다.

    실무 적용 포인트

    4기준 점수표는 직종이 바뀌어도 그대로 쓸 수 있다. 같은 도표를 회계·법무·운영 직무에 대입해 보면 “안전한 직업”이라는 범주 자체가 모호해진다. 이 지점에서 AI 직업 위험의 답은 직업명이 아니라 업무 구성에서 나온다.

    점수가 좋지 않아도 즉시 이직보다 같은 조직 안에서 업무 비율을 바꾸는 협상을 먼저 시도하는 편이 비용이 낮다.

    자주 묻는 질문

    AI 직업 위험이 가장 낮은 직종은 어디인가요?

    직종 단위보다 4기준에서 노출 낮음 열에 업무가 많이 걸리는 직무가 안전하다. 면허·책임·현장 출동이 결합된 직무가 일반적으로 그 열에 속한다.

    코딩을 줄여도 안전한 다른 직종이 있나요?

    존재하지만 보장되지는 않는다. 어떤 직종이든 정형 입력 단계는 자동화 압력이 들어오며, 본인이 맡을 조각이 어디인지 직접 확인해야 한다.

    헤드라인과 실제 자동화 속도는 얼마나 차이나나요?

    현업 체감상 2~3년 차이 난다. AI 직업 위험을 진지하게 다룬다면 채용 공고 수치와 실제 업무 변화를 따로 추적하는 습관이 필요하다.

    6개월 단위 재점검은 어떻게 하나요?

    캘린더 알림을 걸고 같은 4기준 점수표로 업무 10개 항목을 다시 채점한다. 점수가 오른 항목이 있으면 그 업무에 시간을 더 쓰도록 협상한다.

    6개월 뒤 같은 점수표를 다시 채워 보라. 그때 본인이 앉은 자리가 표의 어느 열에 놓여 있는지, 그리고 그 열이 6개월 전과 같은지 다른지가 AI 직업 위험에 대한 본인만의 답이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/cscareerquestions — If CS is cooked because of AI, why wouldnt every other white collar job be either?

    전문가 코멘트(AI)

    노동경제학전문가

    직무 단위 분해는 노동경제학의 정설과 일치하는 올바른 방향이지만, 4기준은 자동화 위험과 노동시장 경쟁을 한 축에 섞은 미완성 모형이다

    자동화 노출도를 직종이 아니라 업무 조각 단위로 쪼개는 접근은 Autor의 반복 과업 집중도(routine task intensity)와 Acemoglu-Restrepo의 task 기반 모형이 20년 가까이 축적해 온 표준 분석 단위와 정확히 일치하므로, ‘안전한 직업은 없다’는 불안을 ‘안전한 업무 구성은 있다’는 명제로 전환한 것 자체는 학문적으로 건설적이다. 다면 ‘인력 공급 과다’는 기술적 자동화 가능성이 아니라 노동공급 경쟁에 따른 임금 압박 요인으로, 두 성격이 다른 리스크를 한 점수에 합치면 ‘느리게 쇠퇴하는 직무’와 ‘자동화 대상 직무’가 구분되지 않는다. 또한 누락된 변수가 뚜렷하다. AI를 대체재가 아니라 보완재로 쓸 수 있는 생산성 증폭 가능성, 자동화 도입 비용 대비 해당 업무 노동비용의 상대 크기, 도메인 데이터 확보 용이성이 모두 빠져 있다. 물리·관계 맥락 축은 현재 기술 수준에서는 유효한 방어선이지만, 구현 로봇과 멀티모달 에이전트의 개선 속도를 감안하면 이 기준은 3~5년 주기로 반드시 재검증해야 하는 동적 조건이지 고정값이 아니다. 결론적으로 골격은 유효하나, 기준별 가중치와 AI 보완 전략 축을 추가해야 실전 도구로 완성된다.

    평점: 7/10 – task 기반 분해는 검증된 학문적 접근과 부합하나, 공급 과잉 축의 성격 혼합과 보완재 전략·가중치 부재가 아쉬운 단계

    인사·조직전략전문가

    직종 선택에서 업무 재구성으로 관리점을 옮긴 실용적 전환 — 단, 개인의 조직 내 협상력을 과대평가하는 설계가 함정

    이직이라는 고비용 대안 대신 같은 조직 안에서 업무 비율을 바꾸는 협상을 먼저 시도하라는 방향은 전환비용 관점에서 타당하며, 내부 노동시장이 외부보다 정보 비대칭이 적다는 점에서 조직전략적으로도 합리적이다. 6개월 단위 재점검 캘린더는 추상적 불안을 반복 가능한 루틴으로 바꾸는 장치로서 실행력 확보에 실제로 효과적이다. 그러나 업무 재배치 협상의 성패는 관리자의 인수인계 비용, 조직의 평가·보상 제도, 개인이 실제로 보유한 교섭력에 좌우되므로, 체크리스트가 암시하는 ‘개인이 업무 구성을 통제할 수 있다’는 통제력은 현장에서 상당히 과대평가되기 쉽다. 자기 업무의 노출도 자기평가는 자신의 업무를 실제보다 더 창의적·비정형으로 평가하는 인지 편향에 취약해, 직무기술서 대조나 제3자 피드백 없이는 점수표의 신뢰도가 떨어진다. 가장 큰 설계상 아쉬움은 고노출 업무를 ‘피하는’ 방향으로만 답을 제시했다는 점으로, 현실에서 더 강한 생존 전략은 고노출 업무를 AI와 함께 수행하며 검수·예외관리·도구 운영 역량을 쌓는 보완재 전환이다.

    평점: 6.5/10 – 실행 비용 대비 효율과 루틴 설계는 우수하나, 조직 정치와 협상력의 현실을 반영하지 못한 개인 중심 모형

    비판적 분석가

    ‘어떤 직업도 안전하지 않다’는 공포 자체가 누군가의 제품과 강의를 파는 점포가 되는 구조

    공식 내러티브는 대중의 공포를 체크리스트로 합리화해 위안을 준다는 명분이 깔끔하지만, 이면을 들여다보면 ‘모든 화이트칼라가 위험하다’는 메시지의 최대 수혜자는 AI 도구를 파는 기업과 그 불안을 수익화하는 재교육·에듀테크·커리어 코칭 산업이다. ‘CS가 끝났다’는 발을 가장 크게 내딛는 주체들 상당수가 코딩 에이전트를 판매하거나 인건비 절감을 원하는 경영진 쪽이라는 점에서, 이 발의 방향과 이익의 방향이 놀라울 정도로 일치한다. 실제로 2023년 이후 CS 채용 위축은 금리 인상기 테크 구조조정과 팬데믹 과잉채용 청산이 겹친 시기와 정확히 포개져 있는데, 이를 ‘AI 때문’이라는 단일 프레임으로 읽으면 그 이면의 전통적 구조조정이 완벽하게 가려진다. 그리고 ‘노출 높은 업무에서 안전한 업무로 6개월 내 이동하라’는 처방은 개인의 생존 전략처럼 포장되지만, 조직의 관점에서 보면 임금을 올리지 않고 인력 스스로 재구성하게 만드는 무상 인력재편 절차로 그대로 전용될 수 있는 형태다. 우리가 진짜 주목해야 할 점은 체크리스트의 항목이 아니라, 이 불안이 어디에서 생성되고 누구의 매출로 흐르는지이며, 다음에 ‘당신의 직업도 위험하다’는 메시지를 볼 때 그 메시지를 전송하는 주체의 재무제표를 먼저 의심해보라.

    물밑 시나리오

    • 업무 비율 재조정 협상 권고가 조직 입장에서 ‘동일 임금의 직무 확대·저가치화’ 협상 도구로 전용될 가능성이 있다 — 개인이 스스로 저노출·저가치 업무로 이동을 제안하면 조직은 인센티브 없이 인력재편을 완료할 수 있기 때문이다.
    • ‘모든 직종이 위험하다’는 헤드라인의 유통 시점이 AI 제품 출시 캠페인과 구독형 교육 상품 판매 성수기와 반복적으로 겹치는 것은 우연 이상으로 읽힌다 — 실제 노동수요 감소의 상당 부분이 금리 인상기 테크 구조조정에서 비롯됐다는 정황 증거가 이 지연·왜곡을 뒷받침한다.
    • 레딧류 커뮤니티에서 불안 스레드가 반복 상위 노출되는 것은 공포 반응을 증폭하는 추천 알고리즘 구조와 맞물린 결과로, 실제 노동시장 데이터보다 커뮤니티 체감이 먼저 확산되는 역전 현상이 생겼을 가능성이 있다.

    공식 설명 설득력: 5/10 – 업무 단위 분해라는 골격의 설득력은 있으나, 불안 내러티브의 생성·유통 구조와 그 상업적 이해관계에 대한 검증은 사실상 전무한 단계