[작성자:] l0cknsec

  • Benchmark의 벤처 투자 전략: 속도보다 신뢰와 장기 파트너십을 선택하다

    Benchmark의 벤처 투자 전략: 속도보다 신뢰와 장기 파트너십을 선택하다

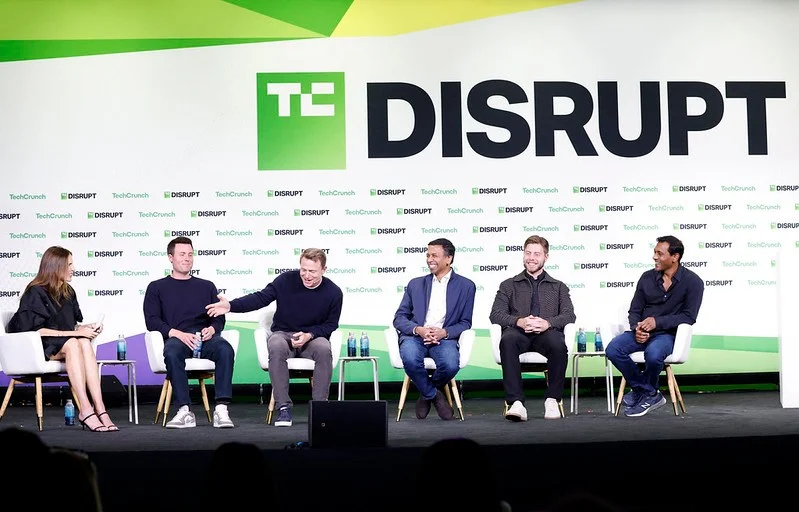
    벤처 투자 전략의 경쟁축이 넓어지는 가운데, Benchmark는 빠른 투자 속도 대신 소수 투자와 장기 파트너십을 중시한다. TechCrunch Disrupt 무대에 모인 다섯 명의 일반 파트너는 이 조직의 변화와 지속되는 원칙을 선명하게 보여 준다.

    31년 역사의 변화와 성장 펀드

    Benchmark는 여름에 두 펀드를 통해 총 $2 billion 규모를 확정하며 31년 역사상 두 번째로 평소보다 큰 차량을 primaire raise했다. 핵심 펀드는 20년간 $500 million 규모를 유지했지만 최근 인플레이션에 맞춰 조정됐고, Peter Fenton은 이것이 전략적 오류였을 수 있다고 인정했다.

    새 성장 펀드는 초기 단계에 집중하던 기존 투자 범위를 넓히는 확장으로 규정됐다. Benchmark에 들어온 기회 중 일부는 10배에서 1,000배의 수익을 낼 수 있었지만 초기 투자 중심 전략이 이를 제한했기 때문에, 벤처 투자 전략의 범위를 넓힌 선택이었다.

    소수 투자가 추구하는 집중 효과

    성장 펀드에서는 선별적으로 4건에서 6건, 많아야 7건에서 8건의 투자를 이루는 구상이 제시됐다. 펀이 성공할 경우 한두 건의 투자에서 수익의 90%가 발생할 수 있다는 점에 전략의 집중성이 드러난다.

    이 구조는 투자 건수를 늘리는 전략과 다르다. Benchmark는 초기 창업자와 함께 10년에서 15년 동안 회사를 지원하는 관계를 유지하며, 이는 인력과 시간만으로 쉽게 복제하기 어렵다.

    다섯 명이 만드는 의사결정 방식

    Benchmark는 현재 다섯 명의 일반 파트너로 구성된 소수 조직이며, 이들은 계층적인 투자팀보다 높은 대화 밀도와 의사결정의 일관성을 지향한다. Ev Randall은 소수 파트너십이 복잡한 조직 구조를 거치지 않고 함께 판단하게 하고, 서로 존중하며 배우는 관계가 조직의 질을 좌우한다고 설명했다.

    Jack Altman은 Benchmark가 돈이나 지위보다 창업자와 회사를 돕는 일을 더 중요하게 여긴다고 말했다. 소수 파트너십은 단순한 인원 제한이 아니라 높은 대화 밀도와 함께 배우는 문화를 가능하게 하는 구조였다.

    정해진 안건 없는 월요일 회의

    파트너들은 매주 월요일에 만나지만 기본 안건은 정하지 않는다. Eric Vishria는 빠르게 변하는 시장에서 반년 전에는 가능하지 않았던 방향을 찾으며, 만나는 회사, 관심을 끈 이유, 이사회에서 관찰한 내용 등을 자유롭게 공유한다고 설명했다.

    안건이 없다는 방식은 체계화를 피하게 하는 동시에 반응 공간을 만든다. Chethan Puttagunta는 창업자가 임원 채용이나 전략적 파트너십을 지원할 때 다섯 파트너가 즉각 투입될 수 있다고 설명했다.

    급변 속에서도 유지하는 속도

    경제 지표가 앞선 위험을 가리키지만 Benchmark는 크게 움직이지 않는다. Eric Vishria는 일부 경고 신호가 X-fueled hysteria의 결과일 수 있다고 봤으며, 시장이 빨라져도 파트너 한 명당 연간 2건에서 3건의 새 투자를 기존 속도로 이어 간다.

    이 전략의 경쟁력은 거래 속도나 펀드 규모보다 다섯 파트너 사이의 신뢰, 창업자와 오래 함께하는 관계, 즉각 대응할 수 있는 유연한 의사결정에 있다. Benchmark는 더 많은 투자를 좇기보다 회사가 다음 단계를 설계하도록 곁에 머무르려 한다. 이 내용은 TechCrunch의 Benchmark 파트너 인터뷰를 바탕으로 한다.

  • 클라우드 EOL 관리, 알림 박스에서 끝나지 않게 만들기

    클라우드 EOL 관리, 알림 박스에서 끝나지 않게 만들기

    클라우드 운영에서 가장 답답한 순간은 지원 종료 공지가 메일함에 들어왔는데, 아무도 자기 팀의 워크로드와 연결하지 못하는 경우다. AI 모델 버전, Kubernetes 버전, 서버리스 런타임, 데이터베이스 엔진처럼 수명주기가 다른 자산이 동시에 따라오므로, “무엇이 곧 종료되는가”를 알아도 “누가 무엇을 언제까지 바꿔야 하는가”가 비어 있다. 바로 이 공백을 메우는 것이 클라우드 EOL 관리의 핵심이다.

    공지를 찾는 방식은 여러 갈래가 된다. Service Health, AWS Health, Advisor, 공급업체 이메일, 자체 스크립트가 각각 다른 신호를 제공하므로, 하나의 소스만 믿으면 공백이 생긴다. 원문에서도 이러한 경로를 조합해 사용하는지 묻고 있다. 문제는 수집 단계보다 그다음이다. 공지는 대개 계정이나 구독 소유자에게 도착하지만 실제 변경 영향은 특정 워크로드 팀이 감당한다.

    공지 수신은 시작일 뿐, 실행 준비도 아니다

    패치 관리 도구만으로는 해결되지 않는다. Renovate와 Dependabot 같은 소프트웨어 의존성 관리 도구는 라이브러리 버전 관리에는 유용하지만, 관리형 AI 모델이나 Kubernetes 버전, 서버리스 런타임 같은 서비스 지원 종료까지 자동으로 추적하지 않는다. IaC에 버전을 고정해 두었다는 사실만으로 배포 안전이 보장되는 것은 아니다. 고정된 버전이 언제 지원 종료되는지는 별도로 확인해야 한다.

    따라서 운영 기준은 “공지 수신 여부”만으로 충분하지 않다. 각 항목에 종료 일정, 영향을 받는 계정·구독·리전, 실제 워크로드, 소유 팀, 대체 경로, 대응 기한을 연결하고, 검증까지 끝난 항목만 종결로 취급하는 방식이 필요하다. 이 기준이 없으면 알림은 많아질수록 담당자는 무엇을 먼저 해야 하는지 판단하기 어렵다.

    공지와 워크로드 소유자를 연결하는 방법

    먼저 공지를 공통 항목으로 정규화한다. 서비스 종류, 대상 버전, 지원 종료일, 원문 링크, 수집 경로를 하나의 레코드로 모으는 작업이다. 이후 계정·구독·리전·서비스·리소스 식별자로 실제 배포 대상과 연결한다. 이때 필요한 것은 소유자 목록 한 장이 아니라, 소유 정보가 갱신되는 규칙과 연결이 끊겼을 때의 처리 절차다.

    실무에서는 조직 자산 조회 체계와 CMDB 또는 소유권 메타데이터를 조합하는 방식이 적합하다. 조직 구조와 배포 메타데이터가 서로 다른 시스템에 남아 있으면 어느 한쪽을 원천으로 정하지 말고 정기적으로 대조한다. 연결되지 않은 공지는 소유자를 추측하지 말고 미배정 항목으로 분리해 담당 조직과 함께 정리한다.

    Terraform와 CI는 마지막 안전장치로 쓰라

    IaC와 CI 검사는 효과적인 보조 가드레일이 된다. Terraform의 고정 버전과 배포 파이프라인에서 지원 종료 대상 여부를 확인하면, 운영 착수 전에 문제를 발견할 수 있다. 다만 이 검사는 실제 배포 구성을 보는 안전장치일 뿐, 모든 계정과 구독의 공지 수집과 소유자 매핑을 대신하지 못한다.

    다음 구성은 개념적 흐름을 보여주는 예시이며 공식 규격이 아니다. 실제 정책은 각 조직의 버전 출처와 승인 절차를 반영해 작성해야 한다.

    eol_policy:
     reject_unmapped_notice: true
     require_owner: true
     require_replacement_plan: true
     block_deployment_after_end_of_support: true

    검사 결과에는 단순한 실패 목록만 남기지 않는다. 해당 버전을 사용하는 배포 대상, 소유 팀, 대체 버전 후보, CI 실행 링크를 함께 저장해야 한다. 그래야 정책 위반이 실행 가능한 작업으로 이어진다.

    수신부터 회귀 검증까지 상태를 관리하라

    운영 흐름은 다음 상태로 구성하면 해석하기 쉽다. 먼저 수신으로 공지를 기록하고, 영향 분석에서 실제 사용 여부와 범위를 확인한다. 계획 단계에서는 소유 팀과 대응 기한을 확정하며, 교체 단계에서는 새 버전 또는 대체 아키텍처를 적용한다. 마지막 검증에서 트래픽 전환과 회귀 테스트까지 확인한 뒤에야 종결로 이동한다.

    이 상태 모델은 업무 시스템으로 구현할 수 있다. 처음부터 복잡한 전용 플랫폼을 만들기보다, 공지·자산·소유자·작업 레코드를 연결할 수 있는 시스템에서 시작하는 편이 현실적이다. 자동화는 수집, 중복 제거, 소유자 후보 제시, 기한 경고에 먼저 집중하고, 교체 의사결정은 담당 팀이 수행하도록 남겨야 한다.

    실무의 한계도 분명하다. 소유 정보가 방치되면 자동화는 정확한 담당자에게 갈 수 없다. 여러 계정과 구독을 조회하면 접근 권한과 비용이 늘어나고, 공급업체마다 공지 형식이 달라 수집 규칙도 계속 유지보수해야 한다. 가장 위험한 운영 방식은 구독 소유자 메일만 감시하거나 모든 공지를 같은 우선순위로 전달하는 것이다. 버전만 적은 스프레드시트 역시 소유자, 대응 상태, 검증 결과가 연결되지 않으면 실행 관리표가 되지 못한다.

    클라우드 EOL 관리를 성숙시키려면 공지 목록을 목표로 삼지 않아야 한다.

    같은 문제를 다룬 원문 게시물도 공지를 찾는 경로, 담당 팀 전달 방식, IaC와 CI 검사 여부를 함께 물었다.

    실무에서는 먼저 Service Health, AWS Health, Advisor와 공급업체 메일의 최근 지원 종료 공지를 수집해 공통 목록으로 정리할 수 있다. 각 공지에는 계정·구독·리전·대상 버전·종료일·원문 링크를 붙인다. 이후 조직의 자산 조회 체계와 CMDB, 배포 메타데이터를 대조해 실제 워크로드 사용 여부와 소유 팀을 확인한다. 미배정 공지는 담당 조직과 함께 정리하고, Terraform 고정 버전과 CI 파이프라인에 지원 종료 검사를 추가해 배포 직전 차단과 대체 버전 검증을 시험할 수 있다.

    실무 적용 포인트

    • 관련 팀과의 조율 및 승인 경로 확인
    • 격리된 환경에서 사전 영향도 테스트
    • 단계적 롤아웃과 비상 롤백 계획 수립

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/devops — How does your team track everything that’s about to be retired in your cloud?

  • DeepSeek 모델 DeepSeek-V4.1-Flash-1017 공개, 에이전트용 Search·Fetch API까지 제공

    DeepSeek 모델 DeepSeek-V4.1-Flash-1017 공개, 에이전트용 Search·Fetch API까지 제공

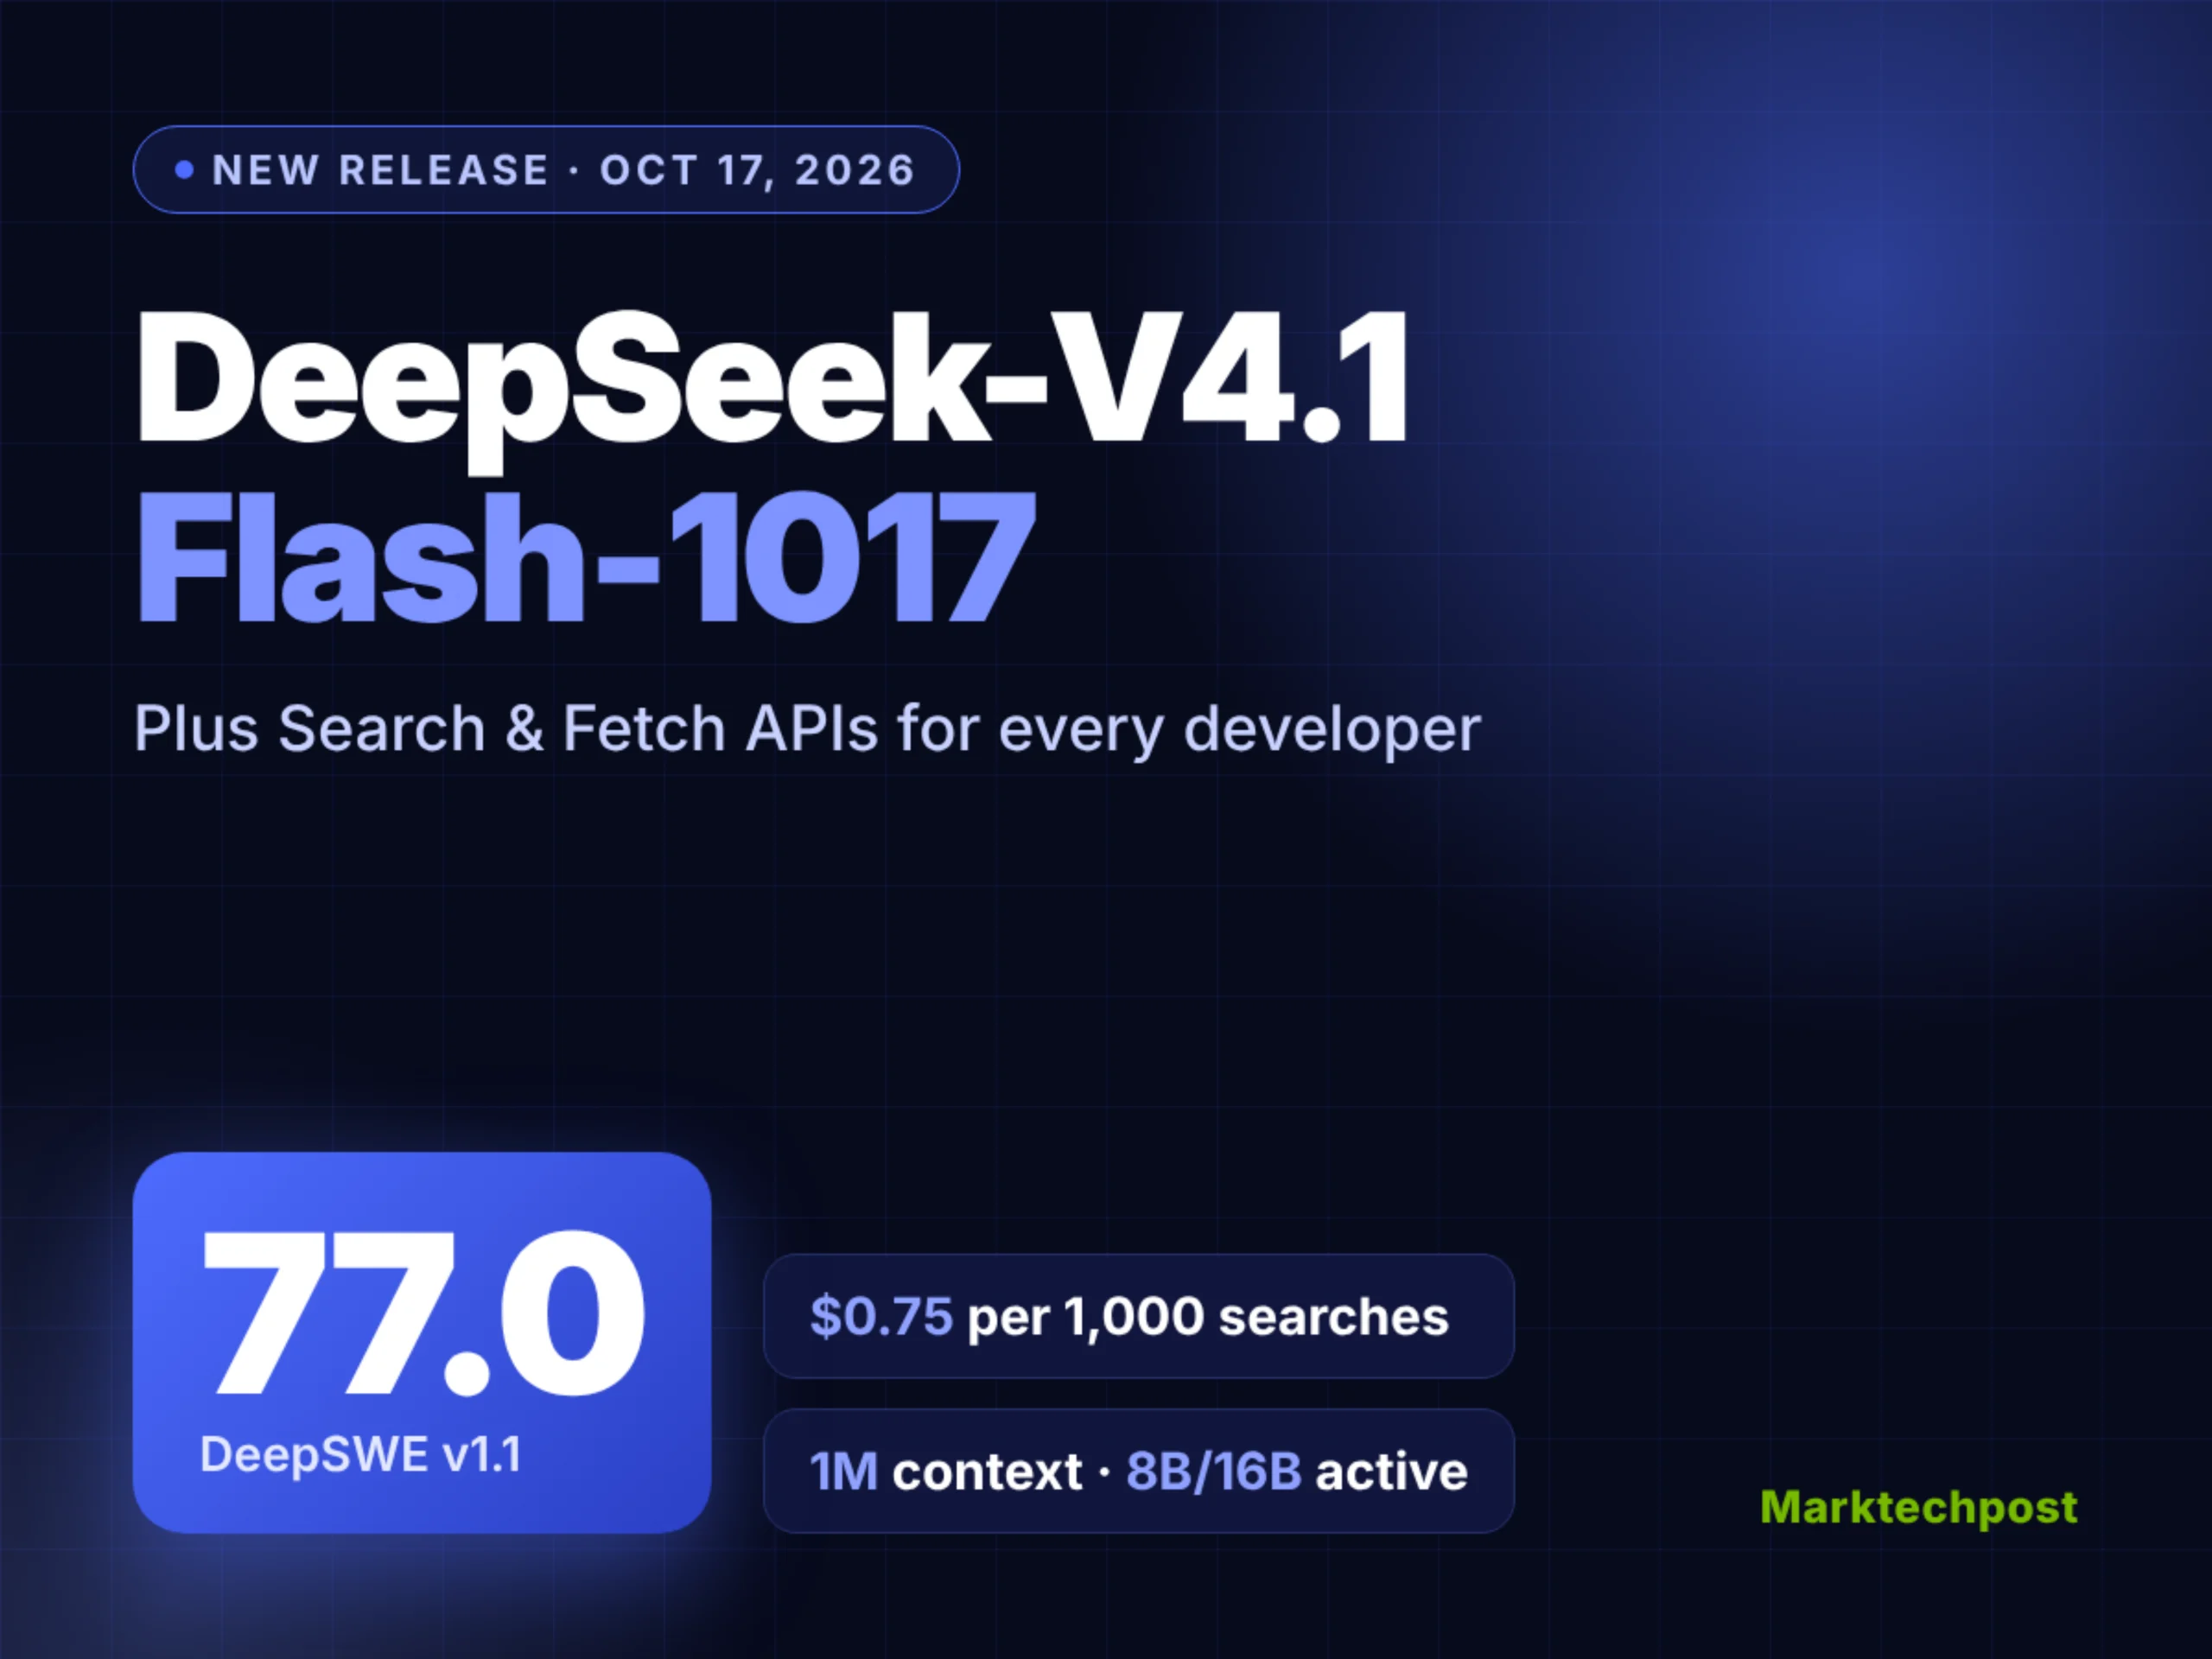
    DeepSeek는 DeepSeek 모델 DeepSeek-V4.1-Flash-1017을 공개해 웹사이트와 앱, API의 deepseek-flash 모델로 제공했다. 기존 9월 V4.1-Flash의 후속 체크포인트인 새 모델은 DeepSeek의 자체 측정치에 따르면 11개 벤치마크에서 앞선 성능을 기록했다. 동시에 모든 개발자에게 Search API와 Fetch API를 열어, 모델과 웹 정보 접근 계층을 하나의 API 키로 구성할 수 있게 했다.

    77점 DeepSWE, 코딩 성능 개선의 의미

    DeepSeek는 1017 체크포인트가 기존 V4.1-Flash보다 11개 벤치마크에서 2.0점부터 11.1점까지 높은 점수를 냈다고 밝혔다. DeepSWE v1.1에서는 77.0점을 기록해 이전 V4.1-Flash의 74.2점과 Claude Opus 5의 74.0점을 웃돌았다. Automation-Bench에서는 60.5점, Agents’ Last Exam에서는 35.4점을 기록하며 이들 항목에서도 앞선 것으로 나타났다.

    다만 성능의 우열이 모든 작업 영역으로 확장되지는 않는다. HLE without tools에서 1017 체크포인트는 42.6점으로 Claude Opus 5의 56.3점보다 낮았고, Terminal-Bench 4.0과 ProgramBench, NL2Repo에서도 Claude Opus 5가 앞서 것으로 나타났다. 위 수치는 DeepSeek가 자체적으로 측정한 결과이며, 독립적인 재검증이 필요한 성능 주장으로 읽어야 한다.

    모델 DeepSWE v1.1 HLE without tools
    DeepSeek-V4.1-Flash-1017 77.0 42.6
    DeepSeek-V4.1-Flash 74.2 해당 수치 미제시
    Claude Opus 5 74.0 56.3

    MoE 구조와 장문 컨텍스트 효율화

    DeepSeek-V4.1-Flash-1017은 40개 Transformer 계층을 20개 causal encoder와 20개 decoder로 나눈 multimodal Mixture-of-Experts 모델을 기반으로 한다. 전체 규모는 552B backbone parameters와 196B Engram parameters이며, 토큰별 활성 파라미터는 prefill 8B, decode 16B다. 컨텍스트는 최대 1M 토큰이고 출력은 최대 384K 토큰까지 지원한다.

    효율화 요소에는 Causal Encoder-Decoder와 Compressed Sparse Attention 2, FP4 main KV cache, SWA Bounded Replay가 포함된다. CED는 최종 encoder hidden state에서 decoder global KV를 투영해 prefill 연산량을 거의 절반으로 줄인다. CSA2는 계층을 Full, Reindex, Reuse 모드로 운용하며 main KV와 indexer keys를 계층 간 공유한다. FP4 main KV cache는 global KV를 토큰당 890바이트로 줄여 V4-Flash의 약 1/4 수준으로 관리하고, SWA Bounded Replay는 persistent KV cache를 약 1/8 수준으로 축소한다.

    후훈련에는 self-feedback를 이용한 reinforcement learning이 적용됐으며, 게임 제작과 3D 모델링을 포함한 종단 프로젝트 작업 사례가 제시됐다. API의 reasoning effort는 1부터 100까지의 scalar이며 low, high, max는 각각 50, 75, 100에 대응한다.

    Search·Fetch API로 웹 접근 계층 단순화

    Search API는 질의에 따른 순위형 웹 검색 결과를 반환하고, Fetch API는 단일 페이지를 Markdown으로 변환한다. 두 기능의 엔드포인트는 각각 POST /v1/tools/search와 POST /v1/tools/fetch이며, api.deepseek.com에서 제공된다. Search API는 1개부터 50개까지의 결과와 선택적 페이지 콘텐츠를 지원하고 site:, lang:, after:, before: 연산자를 사용할 수 있다. 각 결과에는 0부터 3까지의 rerank score와 0부터 4까지의 authority tier가 포함된다.

    요금과 제한은 API별로 동일하다. Search API와 Fetch API는 각각 성공 요청 1,000건당 0.75달러이며, 빈 결과와 실패 요청에는 비용이 부과되지 않는다. 계정별 엔드포인트 요청 제한은 초당 5건이다.

    비용과 오픈 웨이트의 남은 제약

    deepseek-flash의 peak 가격은 캐시 미적중 입력 토큰 100만 개당 0.30달러, 출력 토큰 100만 개당 1.20달러이며 off-peak 요금은 절반이다. DeepSeek Harness, Claude Code, Codex를 통한 서버 측 호출은 2026년 11월 1일까지 무료로 제공된다. 모델은 OpenAI 형식과 Anthropic 형식 엔드포인트로 호출할 수 있다.

    9월 V4.1-Flash의 763B 파라미터 FP8 가중치는 MIT 라이선스로 Hugging Face에 공개됐다. 반면 1017 체크포인트의 가중치와 하드웨어 요구사항은 공개되지 않았다. API 서비스와 웹 도구를 함께 제공한 만큼 실무 선택은 코딩 품질, 장문 처리량, 호출 비용, 자체 배포 가능성을 함께 비교하는 데 달려 있다. 상세 내용은 MarkTechPost의 공개 보도를 통해 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — DeepSeek Just Released V4.1-Flash-1017, Scores 77.0 on DeepSWE, Opens Search API

  • 에버노스 나스닥 상장 뒤 XRP 기관 운용 모델의 구조와 쟁점

    에버노스 나스닥 상장 뒤 XRP 기관 운용 모델의 구조와 쟁점

    디지털 자산 재무 전문 기업 에버노스(Evernorth)가 티커 심볼 ‘XRPN’으로 나스닥 폐장 벨을 울리며 제도권 시장에 진입했다. 리플의 브래드 갈링하우스 최고경영자(CEO)는 XRP의 핵심 활용 방향이 단순 장기 보유(HODL)를 넘어 실질적인 수익을 창출하는 기관 상품 개발이라고폈다. 에버노스가 구축한 XRP 기관 운용 모델은 나스닥 주식으로 디지털 자산에 접근하는 방식과 운용 수익의 재투자 구조를 결합한다.

    나스닥 주식이 XRP 투자 접근성을 바꾸는 방식

    에버노스는 약 4억 7,300만 개의 XRP를 보유하고 있으며 리플, 크라켄, 코인베이스, 비트고를 첫 기관 거래 파트너로 선정했다. 자산운용사, 헤지펀드, 패밀리 오피스 등은 직접 지갑을 관리하거나 XRP 보관 위험을 감수하지 않고 나스닥 주식을 통해 투자할 수 있게 됐다. 유입된 자본으로 발생한 수익은 다시 XRP에 재투자되는 순환 모델이 작동한다. 이 구조에서 XRP 기관 운용의 핵심은 주식 발행으로 모은 자금이 디지털 자산 수요와 생산적 수익 활동으로 연결되는지 여부다.

    브래드 갈링하우스 리플 최고경영자(CEO)는 에버노스가 온체인·오프체인 전반에서 차별화 전략과 레버리지·수익 기회를 구축해 XRP의 성과를 견인할 수 있다고 밝혔다. 갈링하우스 리플 최고경영자(CEO)는 XRP 기관 운용이 단순 보유보다 실질적인 수익 창출을 지향할 방향이라고 밝혔다.

    제도권 자본의 참여도 이 구조를 뒷받침한다. 씨티그룹 글로벌 마켓츠는 단독 사모 주관사를 맡았고 SBI 홀딩스, 판테라 캐피털, 애링턴 캐피털, GSR 등이 투자 그룹을 구성했다. NH투자증권은 XRP 인수와 생태계 확장을 지원하는 3,000만 달러 규모의 전환사채(CB) 발행에 참여했다. 전통 금융기관의 조직적 개입은 XRP 기관 운용이 기관 투자 수요를 흡수하는 별도 자본시장으로 확장될 수 있다는 점에 의미가 있다.

    주당 XRP 내재 가치와 XRPL 인프라

    시장 전문가들은 에버노스의 ‘주당 XRP 가치’ 지표에 주목하고 있다. 현재 보유량을 기준으로 연간 보유량이 1% 증가하면 473만 개, 3% 증가하면 1,419만 개, 5% 증가하면 2,365만 개의 XRP가 축적된다.

    연간 보유량 증가율 연간 추가 축적 XRP
    1% 473만 개
    3% 1,419만 개
    5% 2,365만 개

    에버노스가 주식 발행 속도보다 빠르게 XRP 보유량을 확대한다면 주당 내재 가치는 지속적으로 상승할 수 있다. 이 논리는 신규 주식 발행으로 희석되는 지분 가치와 XRP 보유량 확대가 함께 반영될 때 성립한다. 실제 상승 폭은 발행 규모, XRP 가격, 운용 비용과 수익 실현 여부에 좌우되며, 현재 보유량만으로 결과가 확정되지는 않는다.

    기관의 실제 운영을 뒷받침할 XRPL 인프라도 개발 중이다. XRP레저(XRPL)의 XLS-65 단일 자산 보관소(Single Asset Vault)와 XLS-66 대출 프로토콜(Lending Protocol)은 XRP 보관과 대출 기능을 담당하는 핵심 요소로 제시됐다. 두 안건은 모두 검증자들의 과반 지지를 확보하며 도입에 속도를 내고 있다. 이 기반이 활성화되면 기관은 대출, 유동성 공급, 신용시장에서 XRP를 운용할 수 있게 되며, 월스트리트의 XRP 평가도 단순한 시세 변동성 추종에서 생산적 금융 자산으로 바뀌는 방향으로 전개될 가능성이 제시됐다.

    수익 실현과 도입 속도가 남긴 검증 과제

    에버노스의 모델이 성립하려면 주식 발행 속도를 넘어서는 XRP 보유량 확대와 운용 수익의 실질적인 재투자가 확인돼야 한다. 거래·보관 체계와 기관 자본의 참여는 구성됐지만, 운용 수익이 얼마나 발생하는지, XLS-65와 XLS-66이 실제 거래 환경에서 어느 정도 활용되는지는 별도의 관찰 대상이다.

    이 구조는 XRP 기관 운용의 접근성을 넓혔지만, ‘보유 자산’과 ‘운용 자산’의 전환을 가늠하는 기준은 상장 자체가 아니라 반복 가능한 수익성과 주당 XRP 내재 가치의 검증에 있다. 관련 배경은 글로벌이코노믹의 원문 보도에서 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 글로벌이코노믹 — “XRP 팔 생각이라면”…리플 CEO가 던진 새 비전부터 보라

  • 해킹 사고 대응 점검에 5대 은행장 국감 출석…개인정보 유출 경위 논의

    해킹 사고 대응 점검에 5대 은행장 국감 출석…개인정보 유출 경위 논의

    금융권 연쇄 해킹 사고와 관련해 5대 시중은행장이 19일 국회 정무위원회 금융감독원 국감에 일반 증인으로 출석해 해킹 사고 대응과 재발 방지 대책을 설명한다. 이환주 KB국민, 정상혁 신한, 이호성 하나, 정진완 우리, 강태영 NH농협은행장은 주말에도 비상 모드로 사고 경위와 재발 방지 대책을 점검하며 국감 답변을 준비하는 것으로 알려졌다.

    개인정보 유출 경위와 관리 책임이 핵심 쟁점

    5대 은행장이 함께 국감 증인으로 출석한 것은 2022년 10월 11일 이후 4년 만이다. 당시 국감은 횡령 등 금융사고와 내부통제를 다뤘으며, 이번에는 AI가 활용된 해킹으로 발생한 고객 개인정보 유출 경위와 관련 부서의 사고 대응, 보안 투자, 경영진의 관리 책임에 질의가 집중될 것으로 예상된다.

    은행들은 대형 로펌의 법률 자문을 받으면서 시스템 전수 점검과 보안 상황을 확인하고 있다. 2차 피해가 발생할 경우 고객에게 신속하게 보상할 수 있는 절차도 검토 중이다. 다만 개인정보 유출 범위와 구체적인 공격 방식은 공개되지 않았다.

    점검을 넘어 예산과 보안 체계 강화로

    은행들은 후속 조치와 보안 강화 계획을 다듬고 있으며, 국감 답변에서는 정보 유출 원인을 규명하는 과정과 현장의 재발 방지 조치를 상세히 설명할 계획이다. 보안 대응이 계속 이뤄지는 만큼 공개되지 않은 추가 해킹 위험이 언급될 가능성도 제기된다. 금융권에서는 이번 감사가 정보보호 수준을 높이는 계기가 되기를 기대하고 있다.

    국회가 보안 예산 확대와 관련 사업 추진을 논의해 보안 강화에 힘이 실릴 것이라는 기대도 나온다. 반면 일부에서는 과도한 비난이나 필요 이상의 공포감을 조성할 수 있다는 우려를 제기했다. 출석한 5대 은행장은 모두 올해 연말 임기가 만료돼 연임 등 지배구조 문제도 거론될 가능성이 있다.

    금융권 관계자는 이번단이 과도한 비난이나 필요 이상의 고객 불안을 증폭시키는 자리가 아니라 AI 기반 해킹 위협에 대응하기 위한 금융권의 보안 체계를 고도화하는 실질적인 논의의 장이 되기를 기대한다고 말했다. 해킹 사고 대응의 완성도를 판단할 근거는 국감 이후 공개되는 유출 경위, 사고 과정의 책임 소재, 보안 강화 계획과 예산 확보 여부다. 구체적인 조치 계획이 제시될 때 해킹 사고 대응이 기관별 임시 조치가 아닌 지속 가능한 보안 체계로 이어지는지 살펴볼 필요가 있다.

    자세한 보도 내용은 보안뉴스의 5대 은행장 국감 출석 관련 기사에서 확인할 수 있다.

  • Meta 약관 문구 삭제로 드러난 AI 학습 데이터 수집 쟁점

    Meta 약관 문구 삭제로 드러난 AI 학습 데이터 수집 쟁점

    Meta는 최근 상업 이용약관을 수정하면서 업무용 계정의 도메인, 웹 페이지 또는 URL에 담긴 콘텐츠를 제품 제공·개발·개선·연구 및 AI 모델 학습 등에 사용할 수 있다고 명시했다. Nieman Lab가 인터뷰한 법률 전문가들은 이 조항이 Meta 업무 계정을 보유한 출판사 웹사이트를 스크래핑하고 콘텐츠를 AI 모델 학습에 활용할 권한을 부여하는 것으로 보인다고 평가했다.

    Meta 약관과 실제 수집 방식은 별개

    Meta spokesperson는 수정된 약관이 웹 크롤링 방식의 변화를 반영하지 않았다며, 통합해 제시한 크롤링 관련 조건은 광고 및 비즈니스 제품에 관한 것이었다고 밝혔다. The Verge 보도에 따르면 우려를 야기한 조항은 이후 삭제됐다. 이어 Meta 약관에서 문구가 삭제됐다는 보도가 나왔고, 회사는 “It does not change how Meta uses web crawlers.”라고Clarified했다. TechCrunch의 원문 보도에 따르면 이 조항은 Meta의 AI 학습 데이터 수집 권한을 광범위하게 부여할 수 있다는 논쟁을 불러일으켰다.

    출판사에 남는 저작권 쟁점

    Meta는 지난해 저작권 침해와 관련해 고위 소송에서 승소했지만, Meta를 포함한 AI 기업을 상대로 한 소송은 계속되고 있다. 서버 측 수집 행위와 약관상 허용 범위는 서로 다를 수 있어, 출판사와 AI 기업 모두 데이터 수집의 근거와 적용 범위를 명확히 해야 할 쟁점이 남아 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Meta removes language that raised scraping and AI training concerns

  • JavaScript CVE가 너무 많아요? 배포물 취약점 검증으로 실제 위험부터 좁히기

    JavaScript CVE가 너무 많아요? 배포물 취약점 검증으로 실제 위험부터 좁히기

    JavaScript 취약점 관리는 의존성 목록을 만든 다음 끝나는 일이 아니다. CI에서 Syft로 SBOM을 생성해 Dependency Track에 올리는 방식은 재현 가능한 의존성 목록을 확보하는 데 유용하지만, 그 목록이 실제 서비스에 포함된 코드와 같은지는 별도 문제로 남는다. lockfile에는 많은 패키지가 들어 있는데, 최종 번들에는 일부만 포함되고, 그마저 취약한 코드 경로가 실행 가능할지까지는 별도로 판단해야 한다.

    따라서 배포물 취약점 검증은 SBOM을 생성하는 작업의 다음 단계여야 한다. 잠재적 취약점 목록, 빌드 단계 취약점, 최종 배포물의 직접 위험을 같은 판정값으로 섞으면 개발용 패키지 때문에 CVE 숫자만 오르고 실제 대응 순서는 오히려 흐려진다. 해결책은 lockfile 검사를 폐기하는 것이 아니라, lockfile과 배포 산출물의 차이를 명시적으로 관리하는 것이다.

    왜 lockfile 전체가 과도한 후보가 되는가

    lockfile에는 개발 서버, 번들러, 테스트 도구 등 최종 브라우저 코드에 들어가지 않는 패키지도 기록된다. SPA라면 devDependency을 제외하는 방식으로 일부 완화할 수 있지만, Laravel 구조에서는 NPM 패키지가 devDependency에 놓이므로 그 분류만으로 서버 측 빌드 구성을 설명하기 어렵다. 따라서 분류 이름보다 배포 산출물에 남았는지를 먼저 확인해야 한다.

    이 문제에 대한 논의는 JavaScript CVE 스캔을 다룬 원문 스레드에서도 그대로 나타난다. lockfile에 있는 패키지와 번들러에 들어간 패키지를 구분할 방법이 없다는 질문이 핵심이며, sourcemap을 생성하면 결과가 상당히 줄어든 것처럼 보인다는 경험도 함께 제시된다. 소스맵은 유용한 단서지만 공개 자산에 포함할 수 있는 검증 결과는 아니다.

    두 개의 SBOM을 하나의 결과물로 섞지 마라

    권장 파이프라인은 소스 의존성과 배포 산출물을 각각 스캔하는 것이다. 소스 단계에서는 lockfile 기반 SBOM을 만들어 누락된 의존성과 업데이트 후보를 관리한다. 배포 단계에서는 빌드된 공개 자산이나 최종 컨테이너 이미지를 다시 스캔한다. Dependency-Track에서 두 결과를 같은 자산의 동일 증거처럼 취급하지 말고, 소스 잠재 목록과 배포 포함 목록 사이의 차이를 별도 단계로 남긴다.

    소스 디렉터리와 빌드 산출물은 서로 다른 산출물로 관리할 수 있다.

    ※ 개념적 가상 예시 (Illustrative Example, not official spec)

    아래 명령은 작업 디렉터리와 빌드 산출물의 패키지 목록을 생성하는 기본 형태다.

    npm ci
    npm run build
    syft dir:. -o cyclonedx-json > sbom-source.json
    syft dir:public/build -o cyclonedx-json > sbom-build.json
    

    실제 경로와 빌드 스크립트는 프로젝트 구조에 맞춰야 한다. Laravel 애플리케이션이라면 NPM 의존성이 최종 빌드 구성에 포함되는지 별도로 확인한다. package.json의 분류보다 빌드 결과와 배포 이미지에 포함된 파일을 근거로 삼아야 한다.

    번들과 배포 이미지에서 포함 여부를 대조하라

    일반적인 프런트엔드 자산에서는 최종 app.js를 조사하고, 필요하면 빌드 중 생성한 sourcemap을 함께 분석해 번들 포함 여부를 대조한다. sourcemap은 분석용 아티팩트로 보관하고 배포 이미지에서 제외한다. 확인 기준은 lockfile 엔트리 수가 아니라 최종 번들에 남은 코드 경로다.

    배포 검증은 한 단계 더 나아가야 한다. CI에서 만든 컨테이너 이미지를 그대로 스캔하면 빌드 도구와 런타임 파일이 분리된 상태를 확인할 수 있다. 배포물 취약점 검증 결과에서 실제 운영 자산에 포함된 항목은 높은 대응 우선순위로 두고, 개발·빌드 단계 항목과 재현성 확인용 항목은 별도 정책으로 관리한다.

    소스맵만 믿어도 되는가

    sourcemap은 lockfile과 번들 사이를 대조할 때 중요한 단서가 되지만, 그 자체가 배포 포함 여부를 증명하는 것은 아니다. 따라서 sourcemap은 근거 자료로 활용하고, 배포 이미지 안의 파일과 실행 가능한 코드 경로를 함께 확인한다.

    CVE 수가 적다는 이유로 모든 패키지를 무조건 업그레이드하는 방식도 위험하다. 업데이트는 취약 패키지의 배포 포함 여부, 실행 경로, 코드 사용 여부를 함께 확인한 뒤 결정한다. 이렇게 하면 lockfile 검사는 유지하면서도 CVE 숫자를 낮추기 위한 무차별 변경을 피할 수 있다.

    실무에서는 lockfile SBOM을 소스 잠재 의존성으로 보관하고, 빌드 후 공개 자산의 위치를 확인한다. Syft로 소스와 빌드 산출물의 SBOM을 각각 생성해 차이를 비교하고, 최종 컨테이너 이미지에서 런타임 패키지를 별도로 식별한다. 업그레이드 알림마다 배포 포함 여부와 실행 경로를 확인하는 규칙을 CI에 추가한다.

    실무 적용 포인트

    • 관련 팀과의 조율 및 승인 경로 확인
    • 격리된 환경에서 사전 영향도 테스트
    • 단계적 롤아웃과 비상 롤백 계획 수립

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/devops — How do I actually scan for CVEs for Javascript?

  • AI 에이전트 격리와 스냅샷으로 줄이는 Kubernetes 대기 자원

    AI 에이전트 격리와 스냅샷으로 줄이는 Kubernetes 대기 자원

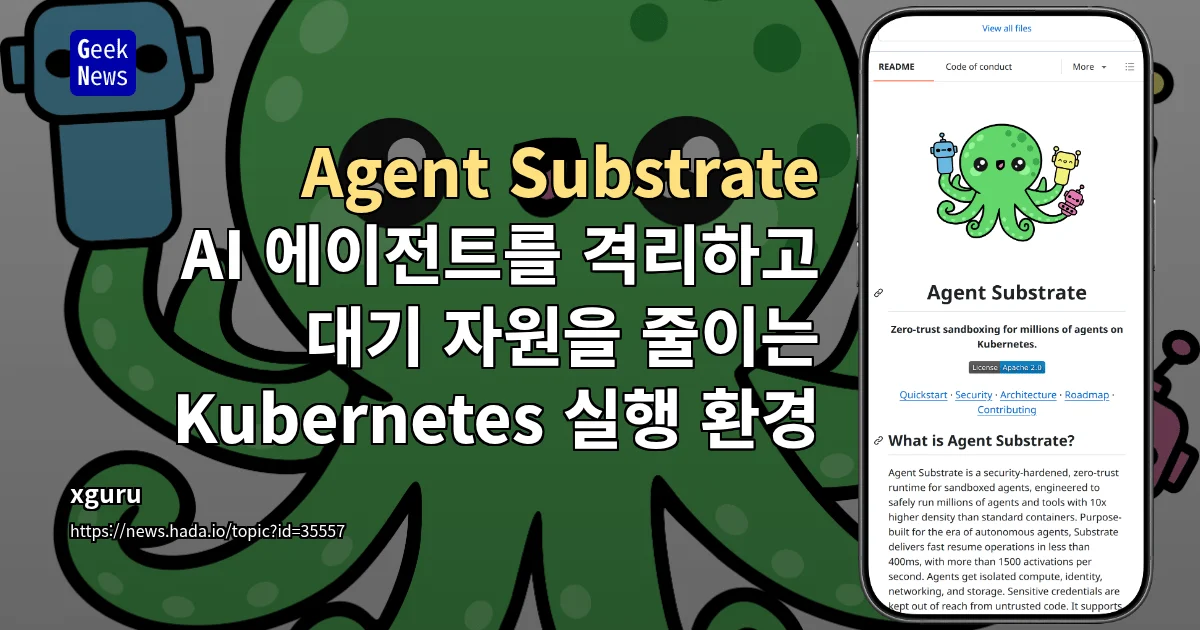
    이 도구는 여러 AI 에이전트를 독립 샌드박스에서 실행하면서 대기 중인 자원을 회수하는 인프라 도구다. 모델 응답이나 도구 실행을 기다리는 동안 메모리와 파일 상태를 저장해 요청이 들어오면 복원하고 작업을 재개한다. 이를 통해 AI 에이전트 격리를 유지하면서 Kubernetes의 상시 실행 비용을 낮이는 것이 목표다.

    Pod 재사용을 지탱하는 마이크로VM 구조

    Agent Substrate는 미리 준비한 소수의 Kubernetes Pod를 여러 에이전트가 번갈아 사용한다. gVisor 또는 Cloud Hypervisor 기반 마이크로VM으로 실행 환경을 격리하지만, 일반 Linux 컨테이너만으로 실행하는 방식은 지원하지 않는다. 표준 OCI 컨테이너 이미지를 활용할 수 있어 특정 모델이나 에이전트 SDK에 종속되지 않는다.

    저장된 상태는 다른 워커에서도 복원할 수 있어 실행 위치가 바뀌어도 세션과 작업 환경을 유지한다. 이 구조는 에이전트별 Pod 유지와 장기 대기라는 Kubernetes 자원 관리 과제를 상태 저장·복원 방식으로 풀었다.

    게이트웨이와 정책으로 보호되는 외부 요청

    API 키와 인증정보는 샌드박스 밖에서 관리하며, 게이트웨이가 허용된 외부 요청에만 인증정보를 주입한다. 에이전트별 신원 구분과 네트워크 분리, 외부 인증 및 데이터 유출 방지 정책 연동도 가능하다. 따라서 AI 에이전트 격리는 실행 환경뿐 아니라 인증 경계와 데이터 이동 정책을 함께 다루는 문제로 구현된다.

    Kubernetes 배포와 남은 운영 조건

    Agent Substrate는 Kubernetes에 직접 배포되며 PostgreSQL과 스냅샷 저장소가 필요하다. 로컬 kind와 GKE 개발 환경도 제공된다. 실제 도입에서는 마이크로VM 격리, 스냅샷 복원, 워커 간 이동, 인증정보 주입 범위를 함께 검증해야 한다. Agent Substrate의 원문 정보를 기준으로 확인할 수 있다.

  • 호주, 소셜 미디어 ‘알고리즘 스위치’ 법안 제안…추천 알고리즘 선택권 확대

    호주, 소셜 미디어 ‘알고리즘 스위치’ 법안 제안…추천 알고리즘 선택권 확대

    호주 정부가 소셜 미디어 플랫폼에 이용자가 추천 알고리즘을 끌 수 있는 ‘알고리즘 스위치’를 제공하도록 하는 법안을 의회에 제안했다. 이 스위치를 켜면 추천 게시물 대신 자신이 팔로우한 계정의 글만 볼 수 있게 하는 것이 핵심이다. 법안에는 온라인 서비스에 이용자의 안전을 위해 합리적으로 행동할 법적 의무인 duty of care도 포함돼 있다.

    원하지 않는 콘텐츠에서 벗어나지 못한 두 사람

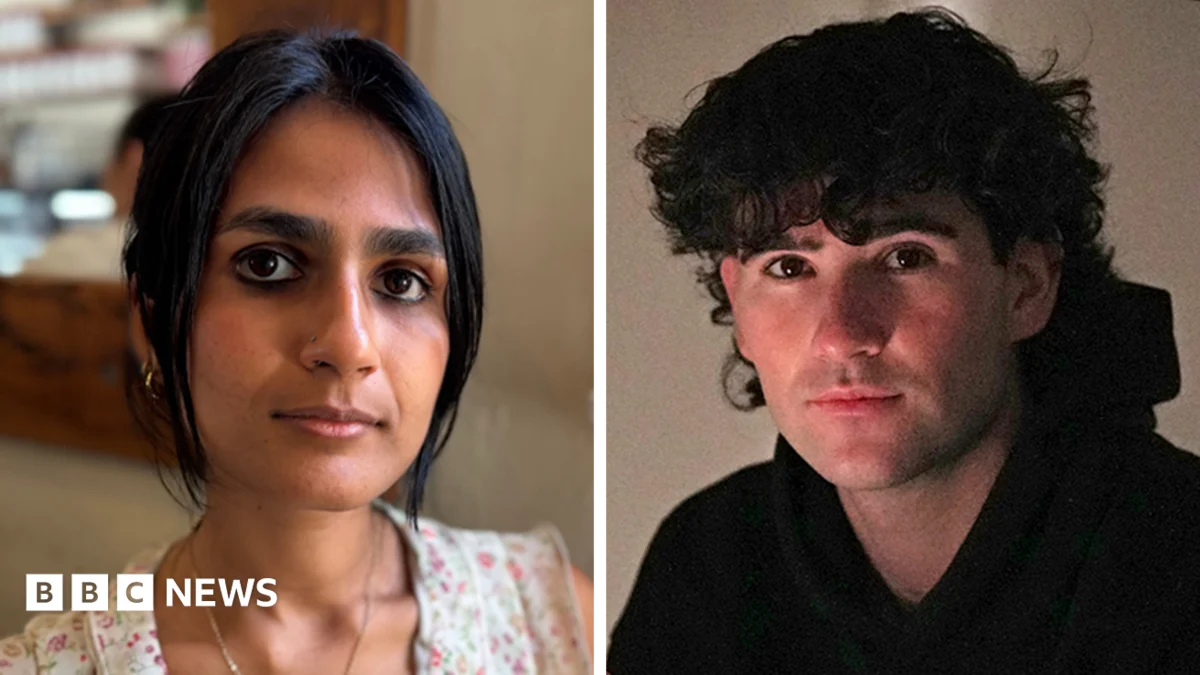
    제안의 배경에는 추천 알고리즘이 이용자의 취약한 시기에 상태를 악화시킬 수 있다는 경험이 자리한다. 식이장애에서 회복 중인 Varsha Yajman은 모든 안전 설정과 금지 단어를 사용해도 체중 감량 콘텐츠가 계속 노출됐다고 밝혔다. 그녀는 13세에 소셜 미디어를 시작했고, 운동 영상과 위험한 칼로리 챌린지로 가득한 피드를 접하면서 외모와 음식에 집착하는 환경에 노출됐다고 설명했다. 과거에는 하루 동안 자신이 먹은 음식을 기록하는 사람들의 글을 지켜보며 “먹을 필요 없다. 다른 사람들이 먹는 것만 보면 된다”고 말했다.

    Flynn Martin의 경험에서는 악성 남성주의 콘텐츠가 증상을 악화시키는 배경으로 나타났다. 당시 20대였던 그는 Andrew Tate를 비롯한 인플루언서들의 게시물이 피드를 장악했고, 불안하고 좌절하던 시기에 그 rhetoric을 믿었다고 말했다. 이후 조증과 입원 치료를 거쳐 해당 콘텐츠 환경에서 벗어났지만, 과거의 자신을 돌아보며 그때의 감정과 취향에 대한 연민을 느낀다고 말했다. 두 사람 모두 소셜 미디어만을 최악의 시기로 몰아놓지는 않았지만, 원하지 않는 콘텐츠가 문제를 키웠다는 점에서 핵심 요인으로 언급했다.

    기본값은 유지, 선택은 강제…캠페인은 더 강한 규제를 요구

    Consent education 캠페인 운영자 Chanel Contos가 이끈 Fix Our Feeds는 추천 알고리즘을 기본적으로 끄고 이용자가 원할 때만 켜도록 요구했다. 캠페인은 1만 5천 명 이상이 참여했으며 전임 총리 두 명, 의원, 정신 건강 전문가와 온라인 안전 전문가의 지지를 받았다. 호주 정부는 9월 캠페인 요구를 받아들였다고 밝혔다. 그러나 정부 발표안은 추천 기능을 자동으로 끄도록 요구하지 않고 플랫폼에 선택 기능만 마련하도록 하는 수준에 머문다.

    Anthony Albanese 총리는 이 조치가 정부가 알고리즘을 통제하는 것이 아니라 사람들에게 선택권을 주는 조치라고 설명했다. 그의 표현처럼 이용자가 위험한 콘텐츠를 끝까지 탐색할 자유를 보장하는 것과 추천 알고리즘의 노출을 줄이도록 기본값을 설계하는 것 사이에는 차이가 남아 있다. ‘끄기’가 가능한 선택지만으로는 피로, 낮은 기술 접근성, 무엇보다 반복 노출에 따른 심리적 부담이 해결되지 않을 수 있기 때문이다. 알고리즘 스위치의 효과는 기능의 존재뿐 아니라 얼마나 쉽게 발견하고 전환할 수 있는지에 달려 있다.

    플랫폼의 반박과 ‘안전관리 책임’ 논쟁

    소셜 미디어 기업은 추천 알고리즘의 위험이 과장됐다고 주장하며 이미 효과적인 안전 도구를 제공한다고 반박한다. 그러나 세계 여러 지역에서 진행된 사법 사건과 내부 정보 공개를 통해 기업들이 위험을 알면서도 참여도와 수익을 위해 관리를 미루었다는 주장이 제기돼 왔다. Chanel Contos는 분노나 두려움, 욕망과 불안 같은 강한 감정을 자극하는 콘텐츠가 스크롤을 계속 이어지게 한다고 말했다. 추천 알고리즘의 참여도 유인을 문제 삼으려면, 이용자에게 기능을 끄게 하는 것뿐 아니라 플랫폼의 설계와 추천 순위 결정 책임도 함께 검증해야 한다.

    온라인 서비스에 부과되는 주의 의무는 이러한 논쟁에서 핵심 축이다. 추천 노출을 단순히 이용자의 선택에 맡긴다면 알고리즘 구조가 이용자를 반복적인 소비 환경으로 만드는 책임은 상대적으로 희석될 수 있다. 반대로 플랫폼이 결정하는 추천을 과도하게 규제하면 표현의 자유와 서비스의 다양한 이용 방식이 훼손될 수 있다는 반론도 제기된다. 입법의 실효성은 추천 스위치가 실제로 선택되는지, 플랫폼이 위험을 인지한 이후 안전한 기본값을 적용하는지, 위반 시 어떤 책임이 발생하는지를 함께 확인할 필요가 있다.

    영국 AI 안전 논쟁이 제시한 더 넓은 규제 방향

    호주의 소셜 미디어 법안과 직접 같은 사안은 아니지만, 영국 Labour 정권 내부에서도 AI 확산과 기술 안전에 대한 우려가 커지고 있다. 한 장관은 초지능 기술의 집중적인 힘이 위험한 행위자의 손에 들어갈 가능성을 가장 두려운 문제로 지적했다. Ed Miliband은 콘퍼런스 연설에서 기술 기업의 이익이 자녀와 인간 전체의 안전을 희생하게 해서는 안 된다고 강조했다.

    이러한 논쟁은 추천 알고리즘에만 한정되지 않는 방향을 보여준다. 플랫폼이 제공하는 기능이 이용자의 선택을 넓히는 도구인지, 반복 가능한 노출을 통해 행동과 소비를 설계하는 수단인지를 판단해야 한다. 호주의 알고리즘 스위치는 선택권을 명시적으로 보장하는 정책이지만, 그 실질적인 효과는 기본값과 접근성, duty of care의 집행 수준에 달려 있다. BBC의 알고리즘 스위치 보도와 The Guardian의 AI 안전 분석은 기술 규제의 초점을 이용자 선택에서 시작해 시스템이 만드는 위험까지 확장해야 한다는 공통점을 보여준다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: BBC Tech — Toxic algorithms wouldn’t let them go – now Australia wants an off switch

  • DB저축은행 개인정보 유출… 대출 가한도 조회 시도까지, 외주 접근 관리 보안 점검 필요성

    DB저축은행 개인정보 유출… 대출 가한도 조회 시도까지, 외주 접근 관리 보안 점검 필요성

    DB저축은행에서 임직원과 프로젝트 외주인력 등 142명의 개인정보가 유출된 것으로 추정되는 사고가 발생했다. 유출된 정보를 이용한 대출 가한도 조회까지 시도됐지만 실제 금융거래는 이뤄지지 않았다. 개인정보 유출이 금융거래 관련 공격으로 이어졌다는 점에서 외주 프로젝트의 접근 권한과 사후 거래 통제가 보안 관리의 핵심 쟁점으로 떠올랐다.

    사고의 전말과 비정상 접근

    DB저축은행이 국회 정무위원회 소속 신동욱 국민의힘 의원실에 제출받은 금감원 사고·장애 전산시스템 보고 내역에 따르면, 사고는 인터넷뱅킹 및 모바일웹 업무 시스템에서 발생했다. 사고 발생 일시는 10일 오후 12시 28분이며, 같은 날 오후 6시에 인지한 뒤 다음 날 오후 3시 5분에 금감원에 보고했다.

    유출 대상은 퇴직자를 포함한 임직원 122명과 프로젝트 외주인원 20명 등이다. 인터넷뱅킹 사용자 ID, 성명, 주민등록번호, 휴대전화번호 등 4개 항목의 정보가 노출됐다. 유출 경로로는 2024년 11월 이후 진행된 디지털채널 고도화 프로젝트에 참여한 외주인력이 지목됐지만, 정보 유출에 관여한 경위와 고의성 여부는 아직 확인되지 않았다.

    유출된 정보에는 비정상적인 대출 가한도 조회가 이어졌다. DB저축은행은 회사 정책에 따라 모든 거래를 차단했으며 현재까지 2차 피해가 발생하지 않았다고 설명했다. 사고 이후 방화벽에 공격 IP를 블랙리스트로 등록하고, 유사한 패턴에 대한 지속적인 모니터링을 수행하고 있다.

    외주 접근 관리와 공급망 보안

    이번 사례에서 드러난 핵심은 개인정보 유출의 영향이 초기 유출 시점에 끝나지 않았다는 점이다. 외주인력이 접근한 개인정보가 대출 가한도 조회와 같은 비정상적인 접근으로 이어졌기 때문이다. 실무 환경에서는 프로젝트 참여자의 데이터 접근 범위와 권한 승인·회수 절차, 공급망에 속한 인력의 활동 기록을 함께 관리하는 것이 중요하다.

    방화벽 차단과 거래 차단은 실제 금융거래로 이어지는 것을 막은 방어 기록에 해당한다. 다만 공격 IP 차단만으로 모든 악성 접근을 제거할 수는 없으므로, 정상 거래와 비정상 패턴을 구분하는 지속적인 탐지 체계가 함께 필요하다. 공급망 관리 역시 단순한 접근 허용이 아니라 개인정보가 어디에 사용되는지 확인하는 과정까지 포함해야 한다.

    DB저축은행은 유출 대상자에게 스팸·사칭 메일 등 불필요한 방법을 통한 2차 피해에 주의하도록 안내했다. 실제 피해가 발생할 경우에는 고객센터와 개인정보보호위원회, 금감원 등을 통한 피해보상체계를 구축하겠다고 밝혔다. 개인정보 유출 사고의 대응 범위는 서버와 방화벽 안에서 끝나지 않으며, 대상자 안내와 피해 구제 절차까지 연결되는 사후 보안이 요구된다.

    보안뉴스의 DB저축은행 개인정보 유출 추정 보도를 보면, 이번 사고는 외주인력에 대한 접근 통제와 이상 거래 탐지가 결합될 필요가 있음을 보여준다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 보안뉴스 — 탈취한 개인정보로 대출한도 조회… DB저축은행, 142명 개인정보 유출 추정