[작성자:] l0cknsec

  • Binance 해킹, 추가 침투 지점 확인…63억 달러 사고의 보안 쟁점

    Binance 해킹, 추가 침투 지점 확인…63억 달러 사고의 보안 쟁점

    Binance 해킹으로 63억 달러 규모의 디지털 자산이 영향을 받아 역대 최대급 암호화폐 거래소 보안 사건으로 주목받고 있다. 거래사는 당초 엔지니어 노트북 침해가 출발점이라는 입장을 밝히지 않았지만, 추가 침투 지점이 확인됐다는 공개로 초기 설명만으로는 사고 경위를 설명하기 어려워졌다.

    63억 달러 피해, 동결 이후에도 추적은 계속돼야

    Binance은 영향받은 자산의 약 절반을 동결했다고 밝혔다. 그럼에도 공격자가 상당량의 도난 자산을 계속 보유하고 있으며, 회사는 모든 손실을 보상하겠다고 밝혔다. 이는 동결이 공격 확산을 막았는지, 출금 가능한 기반까지 차단됐는지를 의미하지 않으며, 자금이 어디로 이동했는지 추적하는 과정이 남아 있음을 보여준다.

    Tether와 Circle은 이번 사고에 대응해 합계 약 24억 달러 상당의 자산을 동결했다고 밝혔다. World Liberty Financial은 파트너들과 함께 도난 자산을 동결하는 데 협력했다고 밝혔다. Coinbase는 사고의 영향을 받지 않았으며 상황을 모니터링하고 있다고 밝혔다.

    노트북에서 출금 환경까지 이어진 복합 공격

    Binance 공동최고경영자 Richard Teng는 초기 조사가 침해된 엔지니어 노트북에서 공격이 시작됐다고 밝혔다. 해당 노트북을 통해 공격자는 서비스 컨테이너에 접근해 무단 출금 거래를 제출했다고 설명했다.

    그 공격은 한 엔지니어의 권한만 이용한 단순한 일회성 클릭이 아니었다. Teng는 여러 단계를 거친 복잡한 공격 과정이었다고 강조했으며, 현재까지 지갑 개인키 유출 증거는 발견되지 않았다고 밝혔다. Check Point의 Jayant Dave는 최근 Bitget 해킹과 유사한 점에 주목하며, 공격자가 볼트 키 자체가 아니라 이를 사용할 권한을 가진 시스템과 사람을 노릴 수 있다고 분석했다.

    이 구조는 개인키가 안전하다는 사실만으로 운영 환경이 안전하다고 볼 수 없다는 점을 드러낸다. 출금 요청을 생성하고 승인하며 실행하는 경로가 하나의 계정이나 비밀정보에 집중되어 있다면, 해당 권한을 장악한 공격자는 광범위한 손실을 일으킬 수 있다. 기업 내부의 침투 범위를 제한하려면 노트북 단말, 관리자 권한, 서비스 컨테이너와 출금 승인 체계가 하나의 공격 경로로 연결되지 않도록 검증해야 한다.

    TraderTraitor 연관성은 분석과 공식 입장이 갈린다

    Check Point와 TRM Labs는 이번 공격이 북한 연결 해킹 조직인 TraderTraitor의 활동과 연결된다고 분석했다. 보안 업체 Check Point는 이 조직이 업계에서 Lazarus Group으로도 알려져 있으며, 2025년 Bybit 해킹의 책임이 지목돼 온 조직이라고 설명했다. TRM Labs 역시 Bybit 해킹을 포함한 기존의 북한 연결 사건과 여러 요소가 닮았다고 보고했다.

    Chainalysis도 북한과 연계된 조직이 이번 해킹에 연루됐다고 높은 확신을 가지고 평가했다. 해당 업체의 글로벌 정책 책임자인 Ari Redbord는 Binance 해킹을 업계가 이전에 보지 못한 전환점으로 규정했다. 반면 Binance는 가해자가 누구인지 공식적으로 확정하지 않았으며, 법 집행기관과 협력해 범인을 확인하고 법의 심판을 받게 하겠다고 밝혔다.

    출금 중지와 사후 조사가 남긴 과제

    Binance는 보안 환경이 확인될 때까지 출금을 중지했다. 공동최고경영자 Yi He는 안전을 우선한다는 이유로 출금 중지를 결정했다고 설명했다. 출금 정지는 추가 피해를 막는 현재 가능한 방어선이지만, 침투 지점의 진정성 검증과 재발 방지 여부를 증명하는 과정으로 이어져야 한다.

    Binance는 조사가 끝나면 상세한 사후 조사를 공개할 계획을 밝혔다. 그사이에도 새로운 침투 지점이 발견됐다는 점을 밝힌 회사는 사실을 계속 수집하고 있으며, 발견되는 즉시 더 구체적인 내용을 공유하겠다고 설명했다. 거래소 보안 강화의 핵심은 출금 권한의 분산, 운영 환경의 연속적인 이상 징후 감지, 공격 이후 침투 경로의 재확인이다. 63억 달러 해킹은 개인키 노출보다 운영 권한과 실행 환경을 잇는 복합 경로가 얼마나 넓은 피해를 만들 수 있는지 보여주는 사건으로 남는다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: BBC Tech — Crypto giant Binance hit by $6.3bn hack suspected to be largest in history
  • Waymo Toyota 협력, bZ4X 기반 일본·영국 로봇택시 확대

    Waymo Toyota 협력, bZ4X 기반 일본·영국 로봇택시 확대

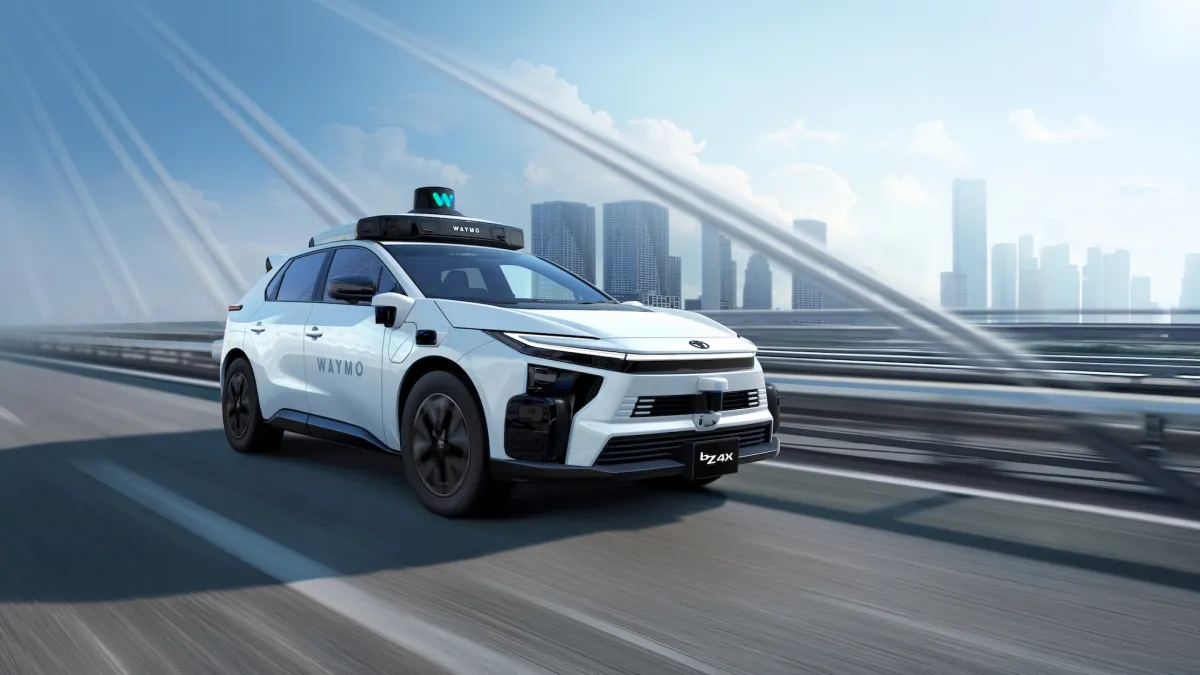
    Waymo가 Toyota와 자율주행차 공급 및 시스템 통합 협력을 구체화했다. Waymo Toyota 협력에 따라 2027년형 Toyota bZ4X에 Waymo의 자율주행 시스템을 설치한 차량을 일본에서 시험할 계획이며, 향후에는 일본에서 로봇택시 서비스를 운영할 계획이다.

    제조와 자율주행 시스템 통합 구조

    Toyota는 일본 Takaoka 공장에서 2027년 bZ4X를 제조하고 Waymo의 자율주행 시스템을 통합한다. 북미 시장에서 해당 전기차는 BZ라는 이름으로 알려져 있으며, Waymo는 이 차량을 일본에서 우선 시험한 뒤 일본과 영국에 배치할 계획이다.

    이번 발표는 두 기업이 약 18개월 전에 자율주행 차량 플랫폼의 개발과 배포를 탐색하는 예비 합의를 체결한 뒤 이루어졌다. 당시 합의는 구체적인 범위가 넓게 남아 있었지만, 현재의 Waymo Toyota 협력은 특정 지역의 차량 공급을 위한 역할 분담과 제조·시스템 통합에 집중한 차량 공급 계약에 가깝다.

    영국 등 오른쪽 통행 국가로의 확장

    Waymo와 Toyota는 일본에서 초기 시험을 진행한 뒤 영국을 비롯한 다른 오른쪽 통행 국가에도 bZ4X를 배치할 계획을 검토하고 있다. 영국에서는 이미 Waymo가 자율주행 Jaguar I-Pace 차량을 런던에서 시험하고 있으며, 필요한 허가를 받는다면 로봇택시 서비스를 출시할 계획이다.

    상세 내용은 원문 보도에서 확인할 수 있다.

    개인차량과 교통 인프라까지 넓어지는 협력 범위

    두 기업은 Waymo의 자율주행 기술을 개인 소유 Toyota 차량에 적용하는 방안도 계속 검토한다. 별도로 Waymo의 실제 운영에서 얻은 인사이트를 활용해 다른 도로 이용자의 안전을 높이기 위한 활동도 논의하며, Toyota는 차량과 교통 인프라를 연동해 도로 안전을 개선하는 방향을 제시했다.

    Waymo와 Toyota의 협력이 로봇택시용 차량 공급에 머물지 않고 개인용 Toyota 차량과 도로 인프라의 안전 개선까지 확장될 수 있다는 점이 핵심이다. 일본 시험과 영국 서비스 출시가 실제 사업으로 이어지는 과정에서 기술 통합이 어느 수준까지 검증될지는 향후 주목할 점이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Waymo taps Toyota to supply robotaxis for Japan and the U.K.

  • EC2·RDS 야간 비용이 줄지 않을 때: 자동 중지와 즉시 복구를 함께 설계하기

    EC2·RDS 야간 비용이 줄지 않을 때: 자동 중지와 즉시 복구를 함께 설계하기

    야간에 돌아가지만 아무도 쓰지 않는 인스턴스와 RDS를 콘솔에서 하나씩 직접 끄는 방식은 언젠가 반드시 공백을 만든다. 담당자가 휴가를 떠나거나 장애를 처리하는 날이면 중지 작업이 빠지고, 다음 날에는 정상 상태라는 가정만 남는다. AWS 비용 절감은 비용을 아끼는 일을 넘어, 필요한 순간에는 자원이 곧바로 돌아오도록 운영 규칙을 설계하는 작업이다.

    문제는 자동화가 세대에게 달려 있다는 오해다. 태그를 읽어 자원을 찾는 스크립트는 태그 이름이 바뀌면 오류를 내거나 대상을 놓칠 수 있고, 예약으로 중지한 RDS는 7일이 지나 다시 시작될 수 있다. 개발자가 저녁에 중지된 인스턴스를 당장 필요로 한다면, 절약한 비용보다 복구 지연이 더 큰 생산성 손실이 된다. 그래서 설계의 출발점은 ‘어떤 자원을 끌 것인가’보다 ‘무엇을 언제 끌고, 누가 즉시 깨울 수 있으며, 상태가 어긋나면 어떻게 발견하는가’여야 한다.

    자동 중지와 예약 재시작을 분리해 생각하기

    원문에서는 AWS Instance Scheduler가 소규모 팀의 자동 중지 대안으로 언급됐다. 다만 구체적인 구성 방법과 운영 효과는 공개되지 않았다. 예약이 존재한다는 사실만으로 운영이 완성되지는 않는다. 예약 시간, 개발 환경의 사용 시간, 긴급 복구 경로, 예약 상태 검증이 서로 다른 문제이기 때문이다. 소규모 팀은 먼저 중지해도 업무에 지장이 없는 자원을 선별하고, 나머지는 자동 중지 대상에서 제외하는 편이 안전하다.

    원문에서는 Cron과 Lambda 스크립트도 소규모 팀의 자동화 대안으로 언급했다. 구체적인 구현 방법은 공개되지 않았지만, 태그 조건으로 자원을 조회하는 방식은 태그가 정책의 유일한 식별자라면 사소한 변경에도 취약하다. 태그를 수정하는 사람의 실수를 발견하는 절차가 없다면 Lambda가 아무것도 하지 않은 성공 상태가 장기간 이어질 수 있다.

    따라서 태그는 검색의 출발점으로만 사용하고, 실제 실행 여부는 환경 목록과 사전에 정의한 허용 범위에서 다시 확인한다. 자동 중지와 수동 유지 여부를 혼합해 관리할 때는 AWS CLI의 리소스 조회 명령으로 대상 목록을 확인한 뒤, 중지 명령을 별도 단계로 실행하는 편이 안전하다. 아래 예시처럼 조회와 실행을 분리하면 검토 없이 많은 자원에 명령이 전파되는 일을 막을 수 있다.

    # ※ 아래 설정 및 코드는 이해를 돕기 위한 개념적 가상 예시 (Illustrative Example, not official spec)입니다.
    aws ec2 describe-instances \
     --filters "Name=tag:AutoStop,Values=true" \
     --query "Reservations[].Instances[].InstanceId" \
     --output text
    
    aws rds describe-db-instances \
     --query "DBInstances[].[DBInstanceIdentifier,DBInstanceStatus]" \
     --output table

    조회 결과가 예상한 대상과 다른지 확인한 뒤 EC2는 인스턴스 중지 명령, RDS는 예약 중지 명령을 적용한다. 명령을 실행한 직후에는 실제 상태를 다시 조회해 중지되었는지 확인해야 한다. 실행 성공 메시지만 믿으면 예약 권한이나 대상 선정 오류를 뒤늦게 발견하게 된다. 복구 경로도 같은 방식으로 별도로 검증한다.

    태그 변경과 RDS 예약 재시작을 견디는 운영 체계

    태그 기반 관리는 자원 그룹을 만들 때 유용하지만, 이름 변경에 취약하다는 문제가 원문에서도 지적된다. 표준 명명 규칙을 정하는 데서 끝내지 말고, 태그 변경을 감시하는 알림과 주기적인 대상 목록 점검을 연결해야 한다. 자동화가 찾는 자원이 비어 있는지뿐 아니라, 수동으로 유지해야 하는 자원이 태그 때문에 자동 중지 목록에 섞이지 않았는지도 확인한다.

    RDS는 중지 상태가 유지되는지 주기적으로 확인하고, 7일 후 자동으로 시작되는 예약을 다시 설정할 시점과 실행 권한을 함께 관리한다. 재설정 작업은 사람이 기억하는 절차보다 예약된 자동 점검에 맡기는 편이 낫다. 점검에서는 중지 상태뿐 아니라 재시작 여부와 실패한 예약을 함께 확인해 알림을 보내야 한다.

    개발자가 당장 필요할 때의 복구 경로

    야간에 중지된 개발 환경이 필요한 경우에는 예약 시작만 기다리지 말고, 즉시 시작 절차를 운영 문서와 팀의 접근 가능한 채널에 명확히 둔다. 복구 대상과 권한을 미리 정해 두면 자동 절감이 개발 속도를 해치는 일이 줄어든다. 반대로 복구가 필요한 자원을 자동 중지 목록에서 제외하는 편이 좋다면, 그 예외도 태그와 실행 목록 양쪽에서 검증한다.

    검증은 한 번의 성공으로 끝내지 않는다. 예약 직후의 시작, 예약이 지난 뒤의 유지, 태그가 바뀐 경우의 대상 누락, 복구 명령 실패를 각각 확인해야 한다. 이 과정은 AWS 비용 절감 자동화를 실제 운영 체계로 바꾸는 핵심이다. 비용 절감 효과보다 먼저 복구 시간과 안정성을 확인하고, 그 결과를 바탕으로 예약 범위를 넓힌다.

    작은 팀이 처음부터 모든 자원을 자동화하려 하면 유지보수 부담이 커진다. 공유 개발 환경, 재현성 테스트 환경, 단발성 검증 환경처럼 사용 패턴이 다른 자원을 나누고, 영향이 작은 대상부터 시작하는 편이 낫다. 자동 중지 뒤 실제 상태를 확인하는 절차를 정착시키면 비용 절감과 복구 안정성을 같은 운영 루틴 안에서 관리할 수 있다.

    이 문제는 소규모 팀의 개발·테스트 EC2와 RDS 유휴 운영을 묻는 원문 논의에서 출발했다. 핵심은 AWS Instance Scheduler, Cron과 Lambda, 태그 기반 관리 중 어느 도구 하나를 고르는 일이 아니라, 예약, 실행, 검증, 예외 처리를 하나의 흐름으로 묶는 것이다. 자동 중지는 그 흐름의 한 단계일 뿐이며, 필요할 때 확실히 복구될 수 있어야 완전한 비용 절감 자동화가 된다.

    지금 바로 해볼 것

    • 현재 실행 중인 개발·테스트 EC2와 RDS 목록을 조회해 자동 중지 후보와 수동 유지 대상을 구분한다.
    • 태그 이름과 중지 정책을 표준화하고, 태그 변경 시 대상 목록을 재검증하는 알림을 연결한다.
    • 인스턴스 스케줄러의 중지와 시작 예약을 만든 뒤 예약 직후 실제 상태를 확인한다.
    • RDS 예약 중지가 유지되는지 점검하고, 예약이 풀리면 다시 설정하는 자동 점검 절차를 등록한다.
    • 개발자가 즉시 시작할 수 있는 복구 명령과 권한을 문서화하고, 실제 복구를 시험한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/aws — How do small teams handle dev/test EC2 and RDS sitting idle overnight?

  • 컨텍스트 엔지니어링의 현주소: 긴 컨텍스트 넘어 전략적 망각으로 설계하는 에이전트

    컨텍스트 엔지니어링의 현주소: 긴 컨텍스트 넘어 전략적 망각으로 설계하는 에이전트

    인공지능 에이전트의 성능을 좌우하는 요소를 한 문장으로 줄이면, 모델보다 현재 목표에 필요한 정보를 골라 전달하는 컨텍스트 엔지니어링에 가깝습니다. 결정론적 코드와 확률적 모델의 역할을 나누고, 오래된 상태를 주기적으로 버리는 방식이 긴 컨텍스트의 한계를 보완하는 대안으로 부상하고 있습니다.

    긴 컨텍스트가 만드는 네 가지 실패

    긴 컨텍스트 창은 정보량뿐 아니라 환각, 잘못된 사실과 상충하는 사례까지 함께 수용합니다. 잘못된 정보에 고착되는 컨텍스트 오염, 컨텍스트에 지나치게 집중하는 주의 분산, 현재 문제와 무관한 사실이 답에 영향을 주는 혼동, 도구와 스킬이 예기치 않게 충돌하는 컨텍스트 충돌이 그 결과로 나타납니다.

    Gemini 2.5의 Pokémon 플레이 실험에서는 구버전의 게임 규칙과 새버전의 과제가 함께 주어지자 모델이 오래된 목표를 여러 시간 추구했습니다. 기술 보고서의 부록에 따르면 컨텍스트가 10만 토큰을 상당히 넘은 구간에서는 새 계획을 세우기보다 과거 행동을 반복하기 시작했습니다.

    Carolina Camassa와 Derek Shiller의 ‘Do as I Say, Not as I Do’ 실험에서도 새 지시와 상충하는 대화 사례가 늘어날수록 모든 시험 모델의 원래 지시 준수율이 낮아졌습니다. Gemma 3 12B는 소수의 상충 사례만으로 준수율이 절반 아래로 내려갔고, Opus 4.6도 사례가 누적될수록 같은 문제가 나타났습니다.

    정보 보강부터 요약까지 여섯 가지 관리 기법

    컨텍스트 관리에는 RAG와 스킬로 필요한 정보를 보강하고, 요청에 적합한 도구만 노출해 과부하를 막는 도구 구성 선별이 포함됩니다. 한 기업에서는 소프트웨어 시작마다 엔지니어별로 600개 스킬을 로드해 성능 저하가 갑자기 발생했고, 도구 필터링이 필요했습니다. 하위 에이전트와 동료 에이전트를 빈 대화 이력으로 시작시키는 컨텍스트 격리는 다른 작업의 정보와 목표를 분리합니다.

    오래된 이력을 제거하는 가지치기, Markdown 파일이나 데이터베이스에 정보를 보관하는 외부 저장, 오래된 대화를 요약해 새 컨텍스트를 시작하는 요약까지 이어집니다. Claude Code와 Codex는 컨텍스트 압축의 초기 단계에서 불필요해진 도구 결과도 제거했습니다. 실무에서는 관련성을 먼저 평가해 이력을 줄인 뒤 요약하면 더 유용한 압축 결과를 얻을 수 있습니다.

    하네스로 옮겨 가는 컨텍스트 구성

    컨텍스트 엔지니어링은 프롬프트에서 시스템이 동적으로 컨텍스트를 조립하는 방식으로 발전했고, 처리를 컨텍스트 밖의 코드로 옮기는 하네스 엔지니어링으로 확산됐습니다. DSPy 시연은 ReAct 모듈과 Python 함수 도구를 while 루프에 결합해 대화 이력을 누적하는 방식으로 구성됐습니다.

    도구 선별에는 큰 모델 Claude Sonnet 4.5와 작은 판단 모델 Jev를 함께 사용했습니다. Jev는 요청과 도구를 평가해 필요한 도구 집합을 고르고, 하위 에이전트를 격리하며, 각 대화 차례를 검토해 불필요한 이력을 삭제합니다. 네 가지 개선을 하나의 루프에 넣는 변경은 약 16줄로 소개됐습니다.

    장기 실행의 실패와 전략적 망각

    장기 작업 모델에는 학습된 행동과 현재 지시가 충돌하는 ‘가중치와의 싸움’, 중단할 가설과 하위 작업을 계속 추구하는 ‘컨텍스트 관성’이 새로 나타났다. Claude Code의 시스템 프롬프트와 도구 지시에는 독립적인 도구 호출을 병렬 실행하라는 요청이 여러 차례 반복돼 Learning 환경의 행동 편향이 드러났다.

    Anthropic의 자기 복제 연구에 사용된 Memento 하네스는 90분마다 짧은 메모를 작성하고 컨텍스트를 비우는 방식으로 고착 문제를 완화했다. 환경과 작업 결과는 유지하면서 진행 중인 대화를 없애 새 관점에서 다시 시작하는 방식이다. Microsoft Research의 Fork-and-Flush는 큰 개선 이후 탐색이 정체되는 문제를 다뤘고, UC Berkeley의 Shangyin Tan이 주도한 Scaling Discovery Requires Forgetting는 산출물을 유지한 채 주기적으로 컨텍스트를 지워 성능이 다시 상승하는 양상을 보고했다.

    개인 에이전트에서는 기억과 스킬이 누적되며 지시 충돌이 새로운 운영 과제가 될 것으로 보인다. Hermes를 6개월 운용한 경험에서는 스킬에 특이한 수정이 쌓이면서 문제 해결 방식이 나빠질 수 있었고, 범용 에이전트가 같은 문제를 서로 다른 방식으로 해결하면서 기억과 지시가 충돌했다. 이에 대응하는 수단은 격리, 외부 저장, 누적 이력 삭제 같은 기존 기법으로 남아 있다. 에이전트 하네스의 품질은 컨텍스트 창의 크기보다 목표 중심의 정보 선별과 전략적 망각을 얼마나 정교하게 자동화하는가에 달렸다.

    이 변화는 컨텍스트 엔지니어링의 현주소를 다룬 자료에서 확인할 수 있다. 장기 에이전트를 설계하는 팀은 프롬프트 길이보다 무엇을 컨텍스트에 남기고 언제 비울지를 함께 다뤄야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — 컨텍스트 엔지니어링의 현주소

  • GPU당 2,000달러 구상, 엔비디아 구독과 AI 에이전트 시장

    GPU당 2,000달러 구상, 엔비디아 구독과 AI 에이전트 시장

    엔비디아가 AI 에이전트를 구동하는 소프트웨어를 GPU당 연간 약 2,000달러에 제공하는 구상을 공개하면서, 엔비디아 구독의 새로운 방향성이 제시됐다. 젠슨 황 엔비디아 CEO는 2026년 10월 22일 독일 베를린에서 열린 GTC 행회에서 하드웨어 판매를 넘어 반복 매출을 확보하는 소프트웨어 라이선스 사업의 가능성을 언급했다.

    이 구상의 핵심은 AI 팩토리에서 에이전트를 실행하는 데 필요한 엔비디아 소프트웨어 전체의 운영 비용을 제시한 데 있다. 보안, 접근 권한 관리와 인프라 운영을 하나의 플랫폼에 묶는 전략으로, GPU 판매에 집중해 온 매출 구조를 구독형으로 확장하려는 시도다.

    2,000달러는 확정된 제품 가격이 아니다

    발표된 2,000달러는 확정된 판매 가격이라기보다 라이선스 모델을 설명하기 위해 제시된 예로 보인다. 엔비디아는 적용 시점과 구체적인 소프트웨어 구성, 라이선스 조건을 공개하지 않았다. 기존 제품과 어떻게 구분되는지도 아직 명확하지 않다.

    엔비디아의 기업용 AI 소프트웨어 플랫폼인 AI 엔터프라이즈는 GPU당 연간 4,500달러에 판매되고 있다. 새로 언급된 금액이 범위가 더 좁은 에이전트 전용 패키지인지, 별도의 라이선스 체계인지 확인되지 않아 기존 요금 인하로 해석하기 어렵다.

    반복 매출의 규모와 미확정된 전제

    구독이 본격적으로 도입될 경우 GPU 판매 주기와 무관한 반복 매출을 확보할 수 있다는 점은 엔비디아 구독의 주요 상업적 가치다. 유료 라이선스 대상 GPU가 500만대라면 연간 100억달러, 5년간 유지될 경우 누적 500억달러의 매출로 계산된다.

    다만 이 수치는 실제 매출 전망이 아니다. 엔비디아는 유료 라이선스 대상 GPU 수나 매출 전망을 공개하지 않았으며, 500만대와 5년이라는 조건을 가정한 가상의 시나리오로 이해해야 한다. 따라서 2,000달러라는 발표만으로 시장 규모를 확정하기는 어렵다.

    오픈셸과 센트리가 관리하는 에이전트 보안

    AI 에이전트는 외부 도구와 데이터에 접근하고 여러 작업을 자율적으로 수행할 수 있어, 기업 환경에서 대규모로 운영하려면 실행 범위와 권한을 통제할 수 있는 관리 체계가 필요하다. 엔비디아는 2026년 10월 21일 AI 에이전트의 실행 환경 격리와 접근 범위 제한을 지원하는 오픈셸 레퍼런스 아키텍처를 공개했다.

    오픈셸은 베라 루빈 컴퓨팅 인프라, 베라 CPU와 블루필드-4 데이터처리장치(DPU)를 기반으로 하며, 엔비디아 센트리(Sentry)를 통해 에이전트 활동을 감시한다. 센트리는 설정된 보안 경계를 넘으려는 에이전트를 격리할 수 있다. 모델 자체의 안전장치에 의존하지 않고 인프라 단계에서 통제 기능을 구현한다는 점이 핵심이다.

    외부 기업과의 연동도 시작됐다. 앤트로픽은 클로드 매니지드 에이전트에 오픈셸과 블루필드 하드웨어를 통합해 기업 에이전트의 접근 권한을 관리하는 사업을 추진하고 있으며, 세일즈포스는 슬랙에서 에이전트의 접근 요청을 검토하고 승인 또는 거부하는 관리 기능을 개발했다. 이러한 사례는 보안 관리 계층이 단순한 참조 구조를 넘어 실제 서비스에 적용될 수 있음을 보여준다. AI타임스의 관련 보도에서도 엔비디아의 구독 확장과 생태계 영향이 함께 주목됐다.

    하드웨어에서 풀스택으로, 락인 가능성은 남는다

    젠슨 황 엔비디아 CEO는 언젠가는 사람들이 엔비디아를 더 이상 칩 회사로 분류하지 않을 수도 있다고 말했다. 의료, 자동차, 통신과 생명과학 등 다양한 산업에 반도체뿐 아니라 소프트웨어와 시스템을 포함한 기술 스택을 제공하는 방향을 강조한 발언이다.

    기업이 보안과 관리 체계를 엔비디아 인프라에 구축할수록 다른 플랫폼으로 이전하는 데 필요한 비용과 부담이 커질 수 있다. 반복 매출과 높은 전환 비용은 엔비디아 구독의 장점이면서 동시에 생태계 락인을 가속할 위험으로 남는다. AI 에이전트 시장이 확대될수록 보안 계층의 가치도 커지지만, 도입 시점과 대상 GPU, 포함 소프트웨어, 라이선스 단위 및 조건, AI 엔터프라이즈와의 중복 여부가 명확해져야 실제 사업 계획을 평가할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: AI타임스 — 엔비디아, GPU당 연간 2000달러 SW 구독제 구상…생태계 ‘락인’ 가속

  • AI 학습 데이터, ‘저장’과 ‘학습’ 구분해 통제하라

    AI 학습 데이터, ‘저장’과 ‘학습’ 구분해 통제하라

    기업의 외부 생성형 AI 도입 과정에서 가장 큰 오해는 입력 데이터가 ‘저장되는가’와 ‘학습되는가’를 같은 문제로 취급하는 데 있다. 두 방식은 보안 위험과 통제 수단이 다르며, AI 학습 데이터가 모델에 반영되면 원본을 삭제한 뒤에도 의도치 않은 노출 가능성을 완전히 배제하기 어렵다.

    이를 대응하려면 서비스의 약관만 읽는 데서 멈추지 않고, 계약과 기술적·정책적 설정을 통해 학습 활용 여부와 데이터의 저장·로그·삭제 범위를 함께 검증해야 한다.

    저장과 학습, 동일한 위험으로 볼 수 없다

    저장된 데이터는 침해나 권한이 없는 제3자 노출에 노출될 수 있지만, 기업용 AI 서비스에서는 계약과 관리 설정으로 접근 범위, 보존 기간, 삭제 정책을 일정 부분 통제할 수 있다. 학습은 다른 차원의 위험을 만든다. 데이터가 학습 과정에 반영된 뒤에는 원본 삭제만으로 영향이 완전히 되돌려지지 않을 수 있으며, 향후 출력이나 내부 표현을 통해 민감정보와 기밀정보가 드러날 가능성도 남아 있다.

    따라서 핵심 질문은 ‘데이터가 저장되는가’뿐 아니라 ‘저장된 데이터를 모델 학습에 쓰지 않는다는 것을 계약과 설정으로 확인할 수 있는가’까지 확장된다.

    주요 서비스의 데이터 처리 정책은 제각각

    개인용 서비스는 기능 이름만으로도 데이터 활용 범위를 오해하기 쉽다. ChatGPT의 ‘모두를 위한 모델 개선’ 기능이 활성화된 상태에서는 연구·업무·개인 데이터의 대화가 모델 개선과 학습에 활용될 수 있다. Claude Free·Pro·Max는 가입·이용 과정에서 데이터 활용 여부를 선택할 수 있지만, 기본적으로 체크된 Opt-Out 방식이므로 별도로 변경하지 않으면 대화와 코딩 세션이 모델 개선에 활용될 수 있다. Gemini는 ‘활동 기록 보관’ 설정으로 관련 활용 여부를 관리한다.

    서비스 관련 설정 또는 방식 확인할 데이터 활용 위험
    ChatGPT ‘모두를 위한 모델 개선’ 비활성화하지 않으면 대화가 모델 개선과 학습에 활용될 수 있음
    Claude 기본 체크된 Opt-Out 방식 별도로 변경하지 않으면 대화와 코딩 세션이 모델 개선에 활용될 수 있음
    Gemini ‘활동 기록 보관’ 기록 보관 설정을 통해 데이터 활용 여부를 관리함

    회사가 직원 개인 계정의 구독료를 지원하는 경우에도 통제권이 자동으로 확보되지는 않는다. 별도 보안 통제 없이 업무 정보를 입력하면 회사의 내부 정보가 제공업체로 전송·저장되고, 서비스 정책에 따라 학습에 활용될 수 있다.

    도입 전 계약과 설정을 함께 검증한다

    기업은 내부 데이터가 외부 서비스의 학습이나 모델 개선에 사용되지 않도록 해야 하며, 단순히 학습 금지가 확인됐다는 이유로 저장 위험을 놓쳐서는 안 된다. 가장 선호하는 저장 방식은 ZDR(Zero Data Retention)이다. ZDR은 요청 처리에 필요한 범위를 넘어 프롬프트와 이미지 등을 보관하거나 별도로 로깅하지 않고 모델 학습에도 활용하지 않도록 제한하는 정책 또는 계약 조건으로 설명된다.

    다만 ZDR은 모든 서비스와 요금제에서 기본 제공되지 않으며, 최상위 Plan인 Enterprise 계약에서도 한정적으로 제공되는 경우가 많다. 실무 점검에서는 학습 금지 여부뿐 아니라 실제 저장 여부, 보존 기간, 로그 관리 범위, 삭제 정책을 함께 확인해야 한다.

    RAG 보안은 전체 데이터 흐름을 따라간다

    검색증강생성(RAG) 환경에서도 내부 테넌트나 전용 계정만으로 모든 위험이 해소되지는 않는다. 암호화 여부, 저장 리전(Region), 개인정보·민감정보 필터링, 보존·삭제 정책, SLA, 접근권한, 개인정보 국외이동 여부를 함께 검토해야 한다.

    내부 문서가 벡터 데이터베이스나 외부 AI 서비스로 전달되는 구조라면 저장 위치, 접근 주체, 삭제 시점을 전체 흐름에서 관리해야 한다. 기업 AI 보안의 출발점은 입력 데이터의 저장 여부를 넘어, AI 학습 데이터가 남는 범위와 목적을 계약과 설정으로 검증하는 데 있다. 보안뉴스의 원문 분석도 이 통제 기준을 조명한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 보안뉴스 — [한국정보공학기술사 보안을 論하다–50] AI 학습에 대한 오해와 진실

  • AI 재무 성과, 비기술 대기업에서 아직 확인되지 않다

    AI 재무 성과, 비기술 대기업에서 아직 확인되지 않다

    TechCrunch는 Apollo Global Management 최고 경제학자 Torsten Slok의 분석을 바탕으로 비기술 대기업의 AI 재무 성과가 아직 드러나지 않았다고 보도했다. Slok은 Alphabet, Amazon, Apple, Meta, Microsoft, Nvidia, Tesla을 제외한 S&P 500 기업 493곳, 즉 S&P 493을 분석 대상으로 삼았다. 이 분석은 대규모 AI 투자와 hype가 실제 생산성 개선으로 이어졌는지에 핵심을 두었다.

    이익률과 직원당 매출은 정체

    분석 대상 기업의 이익률과 직원당 매출은 대체로 평평하게 나타났으며, AI가 생산성을 높였다는 근거는 확인되지 않았다. Slok은 점점 저렴해지는 지능을 높은 매출 성장과 이익률로 연결하기는 어렵다는 지적에 회의론을 표했다. 이는 비기술 기업이 AI를 도입했다는 사실만으로 AI 재무 성과가 성사됐다고 볼 수 없다는 의미로 읽힌다.

    계산보다 중요한 Slok의 판단

    Slok은 AI가 뛰어난 계산 도구가 될 수 있지만, 비즈니스에서 지능은 대부분 판단이라고 썼다. AI는 책임, 신뢰, 문화, 암묵적 규칙, 윤리적 절충, 공정성에 대한 이해가 부족하며, 이런 요소는 평판 위험과 매출 성장 및 이익률에 영향을 준다고 lingered했다.

    기업이 AI 투자 효과를 판단할 때는 도구 도입 범위보다 업무별 생산성 변화, 직원당 매출, 매출 성장률, 이익률의 개선 여부를 함께 살펴야 한다. AI 재무 성과는 투자 규모나 사용 사례 수보다 실제 손익과 운영 효율에 반영됐는지를 기준으로 검증하는 편이 적절하다.

    다만 현재 확인된 정보는 Slok의 해석에 기반한 한 편의 분석이며, 제시된 지표를 직무별 운영 데이터와 비교한 결과까지 포함하지 않는다. 따라서 이 분석을 모든 산업에 대한 일반적 결론으로 확대하기보다, 비기술 기업의 AI 투자 수익성을 점검하는 출발점으로 활용할 필요가 있다.

    자세한 분석은 TechCrunch의 Apollo economist 관련 보도에서 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — AI delivers ‘zero financial payoff’ to most companies, Apollo economist says

  • 팀마다 다른 파이프라인에도 SAST·DAST 적용: 보안검사 강제 실무 설계

    팀마다 다른 파이프라인에도 SAST·DAST 적용: 보안검사 강제 실무 설계

    원문에서는 엔지니어링 팀마다 자체 CI/CD 파이프라인을 두고 있어 SAST나 DAST 검사를 어떻게 강제할지 질문했다. 자체 파이프라인 환경에서는 도구 버전과 검사 대상, 실패 기준, 예외 조건이 달라질 수 있다. 이처럼 공통 실행 기준이 없으면 보안검사 강제가 도구별 실행률이나 개별 팀의 협조에 의존할 위험이 있다.

    원문은 Snyk, Trivy, IaC 등의 검사를 팀 파이프라인에서 어떻게 보장할지 묻는 질문으로 게시됐다. 게시자는 GitHub의 enforcement 기능만으로는 충분하지 않다고 소프트웨어 섹션에 적었다. 저장소 설정만으로 통제하려 하면 직접 수정된 파이프라인, 우회된 배포, 검증되지 않은 예외를 막기 어렵다. 한 가지 방법은 조직 정책을 공통 실행 경로와 배포 승인 구조에 연결하는 것이다.

    먼저 보안검사 강제 기준을 정책으로 정한다

    가장 먼저 정할 것은 모든 취약점을 곧바로 차단할지 여부가 아니라, 어떤 변경에 어떤 검사를 적용하고 어떤 결과가 배포를 막아야 하는지다. 검사 대상 저장소, 배포 산출물, IaC와 의존성 검사 범위, DAST를 적용할 환경, 승인 권한, 예외 만료 조건을 버전 관리되는 정책 파일로 정의한다. 이 파일은 애플리케이션 코드와 함께 코드 리뷰를 거치고 변경 이력을 남긴다.

    판정에는 심각도만 사용하지 않는다. 자산 중요도, 인터넷 노출 가능성, 수정 난이도와 활성 예외를 함께 반영해야 한다. 고위험 취약점은 차단하고 중간 위험은 경고하는 방식으로 출발하되, 팀이 검사를 끄거나 예외를 남발하지 않도록 기준을 문서보다 실행 가능한 정책으로 관리한다. 모든 취약점에 대해 즉시 파이프라인을 실패시키면 운영 부담이 커져 결국 우회가 생긴다.

    공통 파이프라인은 호출만 맡기지 않는다

    공통 파이프라인 모듈은 도구 버전, 검사 설정, 결과 업로드, 정책 평가와 실패 판정을 중앙 관리한다. 팀 파이프라인은 저장소별 최소 설정만 전달하고 공통 단계를 호출하게 한다. Trivy를 사용하는 환경이라면 다음과 같은 결과를 정책 평가에 전달하는 방식이 가능하다.

    trivy image --format sarif --output trivy-results.sarif IMAGE_NAME
    

    ※ 개념적 가상 예시 (Illustrative Example, not official spec)
    실제 이미지 참조와 실행 환경에 맞게 조정해야 합니다.

    공통 모듈은 검사 실행 로그뿐 아니라 대상 커밋, 도구 버전, 정책 버전, 결과, 판정과 예외 식별자를 메타데이터로 남긴다. 이 정보가 있어야 사후에 특정 배포가 어떤 검사를 통과했는지 추적할 수 있다. 결과 수집 대시보드가 있는지만 확인해서는 강제 여부를 알 수 없다.

    배포 게이트를 파이프라인과 분리한다

    팀이 소유한 파이프라인 안에서 검사만 수행하면 파이프라인 변경과 함께 보안 단계가 제거될 수 있다. 더 안전한 구조는 독립적인 배포 게이트다. 배포 요청과 산출물에 검사 상태, 정책 버전, 예외 만료 여부를 연결하고, 필요한 상태가 없거나 정책 위반이 있으면 승인이나 승격을 진행하지 않는다.

    이 구조에서 보안검사 강제는 파이프라인 실행 성공 여부가 아니라 배포 승격 가능 여부로 판정된다. 중앙 서비스는 파이프라인이 실행한 검사인지, 대상 커밋과 산출물이 일치하는지, 판정에 사용한 정책이 현재 유효한지 확인한다. 파이프라인이 바뀌어도 테스트를 생략한 산출물이 자동 배포 영역으로 이동할 수 없다.

    SAST와 DAST는 같은 게이트 안에서 다르게 실행한다

    SAST, 의존성 검사와 IaC 검사는 코드와 구성을 대상으로 수행할 수 있지만, DAST는 실행 중인 애플리케이션이 필요하다. DAST에는 격리된 테스트 환경, 인증 정보, 테스트 데이터와 실행 시간 관리가 필요하다. 운영 환경으로 임의의 요청을 보내지 않도록 대상과 네트워크 범위를 정하고, 검사 결과를 공통 결과 모델로 정규화한다.

    공통 정책과 승인 체계는 공유하되 실행 계층은 분리한다. 정적 검사는 커밋마다 빠르게 실행하고, 동적 검사는 배포 가능한 테스트 환경에서 애플리케이션이 준비된 뒤 수행한다. 두 검사 유형의 특성상 하나가 끝나기 전 다른 하나가 막힐 수 있으므로, 어떤 단계가 선행 조건인지도 정책에 명시해야 한다.

    예외는 영구 우회가 아니라 관리 객체다

    보안 예외는 두려워할 기능이 아니라 통제 가능한 임시 완화다. 예외마다 근거, 책임자, 보정 기한, 적용 도구와 범위, 예외 식별자를 기록한다. 만료된 예외는 자동으로 차단 상태로 전환하고, 만료 전 재검토를 요구한다. 같은 예외가 반복되면 도구 설정이나 공통 파이프라인을 개선할 대상으로 분류한다.

    주기적으로는 검사 없이 배포된 산출물, 실패한 파이프라인의 우회, 만료된 예외, 반복 예외를 함께 점검한다. 이 지표는 도구별 실행률보다 보안검사 강제의 실효성을 더 잘 보여준다. 정책과 파이프라인, 배포 게이트, 예외 수명주기를 하나의 운영 체계로 묶어야 비협조적 팀과 변경 가능한 파이프라인에서도 기준이 유지된다.

    이 문제의 출발점은 원문의 CI/CD 보안 강제 논의이며, 핵심 쟁점은 도구 자체보다 분산된 개발 조직에서 실행을 보장하는 설계에 있다.

    지금 바로 해볼 것

    • 현재 사용 중인 모든 저장소와 배포 파이프라인을 목록화하고 SAST, DAST, IaC 검사 누락 지점을 표시한다.
    • 검사 대상, 차단 기준, 승인 권한, 예외 만료일을 담은 정책 파일을 저장소에서 관리한다.
    • 도구 버전과 결과 수집, 정책 판정을 수행하는 공통 파이프라인 모듈을 만들고 한 팀부터 연결한다.
    • 배포 승격 단계에서 검사 상태와 정책 버전이 없는 산출물이 차단되는지 검증한다.
    • 기존 보안 예외에 근거, 소유자, 만료일, 적용 범위를 기록하고 반복 예외를 개선 후보로 분류한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/devops — Enforcing SAST and DAST Tools at Enterprise Level

  • LLM 정형 검증의 가능성과 한계: Claude가 검증한 123개 라이브러리

    LLM 정형 검증의 가능성과 한계: Claude가 검증한 123개 라이브러리

    Anthropic과 Theorem은 Claude를 이용해 Google OSS-Fuzz 대상 오픈소스 라이브러리 123개, 퍼징 진입점 239개를 정형 검증했다. 버그를 수정한 뒤에는 특정 실행 환경과 입력 크기 조건에서 컴파일된 코드가 충돌하지 않음을 증명하는 수준까지 확장했다. 이 실험은 LLM 정형 검증의 규모와 재사용 가능성을 보여주는 동시에, 보장 범위를 어디까지 설정하느냐가 핵심 쟁점임을 드러낸다.

    퍼즈 테스트를 ‘항상 충돌하지 않는 코드’로 바꾸다

    정형 검증은 코드를 수학적 모델로 옮겨 정의된 규칙을 위반하지 않는다는 것을 보이는 방식이다. 기존 테스트는 특정 입력이 통과하거나 실패하는지 확인하지만, 실행 시간을 늘려도 모든 코드 경로를 탐색한다는 보장은 없다. 이번 실험은 개발자가 입력 진입점을 만들고 문제가 생기면 충돌하도록 만든 퍼즈 테스트를 ‘64MB 미만의 어떤 입력에서도 충돌하지 않는다’는 명세로 변환했다.

    라이브러리와 퍼즈 테스트를 RISC-V 실행 파일로 컴파일한 뒤 Theorem의 RISC-V 명령어 및 Linux 프로세스 의미론으로 실제 바이너리의 동작을 모델링했다. 수만 개 명령어의 가능한 동작과 상호작용을 다루는 대규모 증명에 Claude가 활용됐고, Claude가 작성한 Rocq 코드는 커널이 명세 충족 여부를 검사한다. AddressSanitizer를 이용해 잘못된 메모리 접근을 충돌로 드러내는 방식은 메모리 안전성 명세를 만들기 위한 기반이 됐다.

    퍼징이 놓친 경계에서 드러난 버그들

    증명 과정에서는 Claude가 발견한 버그를 바로 패치하고 명세를 다시 생성하며 작업을 이어갔고, 수백 개의 버그가 확인됐다. 압축 해제 코드의 카운터 언더플로는 약 20MB 입력의 드문 특정 배치에서 경계 밖 쓰기를 일으켰으며, 이미지 디코더의 경계 밖 읽기는 64MB 입력과 2GB가 넘는 메모리가 필요했다. 다른 라이브러리에서는 동일 파일의 핸들 두 개에 대해 특정 호출 순서가 실행돼야 경계 밖 읽기가 발생했다.

    Claude는 깊게 중첩된 입력이 필요한 libexpat의 CVE-2026-56132도 재발견했다. 최종 증명에 성공하지 못한 과제에서도 증명 시도가 실제로 수정해야 할 버그를 찾는 데 기여했다. 이는 정형 검증의 실패가 곧 결론을 폐기할|Division 아니라, 추가 조사와 패치가 필요한 지점을 알려주는 결과일 수 있음을 보여준다.

    기계 검사의 신뢰 경계와 증명 재사용

    전체 증명은 약 1억 8,000만 줄의 Rocq 코드로 구성됐고, 일반적인 증명의 약 60만 줄보다 훨씬 크다. 사람이 거대한 증명 코드를 모두 검토할 필요는 없지만, 보장은 단일 스레드 정적 바이너리와 Linux의 RISC-V CPU 실행이라는 가정에 의존한다. RISC-V와 Linux 프로세스의 형식 모델이 현실과 일치하고, 실제 증명된 정리의 서술이 정확한지 확인하는 과정은 여전히 남아 있다.

    증명 생성에는 막대한 토큰이 들기 때문에 비용 절감도 핵심 과제로 떠올랐다. OSS-Fuzz 코드에서 만든 소규모 검증 과제 36개에서 Opus 5.5는 Opus 5보다 약 40% 적은 토큰으로 과제의 절반을 증명했다. 에이전트가 서로의 증명을 복사할 수 있는 공유 작업 공간은 토큰 사용량을 17% 줄였고, 단독에서는 실패했던 일부 과제도 성공했다. 공통 코드와 작은 증명을 재귀적으로 조합하는 방식은 LLM 정형 검증의 확장성을 높이는 핵심 전략으로 제시된다.

    ‘버그 없음’이 아닌 조건부 증명

    검증 대상은 musl libc와 연결된 단일 스레드 정적 RISC-V 바이너리였다. 실제 사용 환경은 대체로 x86 또는 ARM에서 glibc에 동적으로 연결되는 형태이므로 배포 환경에 더 가까운 시스템 모델과 정확한 x86 의미론이 추가로 필요하다. ASan도 모든 메모리 안전성 버그를 탐지하지 못하며, 모든 진입점을 검증했다고 해서 도달 불가능한 코드까지 라이브러리 전체가 보장되는 것은 아니다.

    정형 검증됨은 버그 없음과 같지 않다. 검사기는 형식 명세의 충족 여부만 확인하고, 명세가 현실과 일치하는지는 판단하지 못한다. 호출자가 공개 함수를 잘못 사용하거나 명세에 없는 실행 조건이 존재하면 보장 밖의 문제가 남는다. 이번 실험의 의미는 AI가 모든 소프트웨어의 완전한 정답을 제시한다는 데 있지 않다. 테스트 가능한 보장을 기계가 확인 가능한 형태로 확장하고, 그 범위와 신뢰 경계를 함께 드러내는 데 있다.

    원문의 실험 집계와 세부 배경은 LLM 정형 검증 관련 보도에서 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — LLM이 훨씬 더 큰 규모의 소프트웨어 정형 검증을 가능하게 하고 있음

  • 체리자동차, 가정용 휴머노이드 로봇 ‘모보’ 공개…자동차 기술의 일상화

    체리자동차, 가정용 휴머노이드 로봇 ‘모보’ 공개…자동차 기술의 일상화

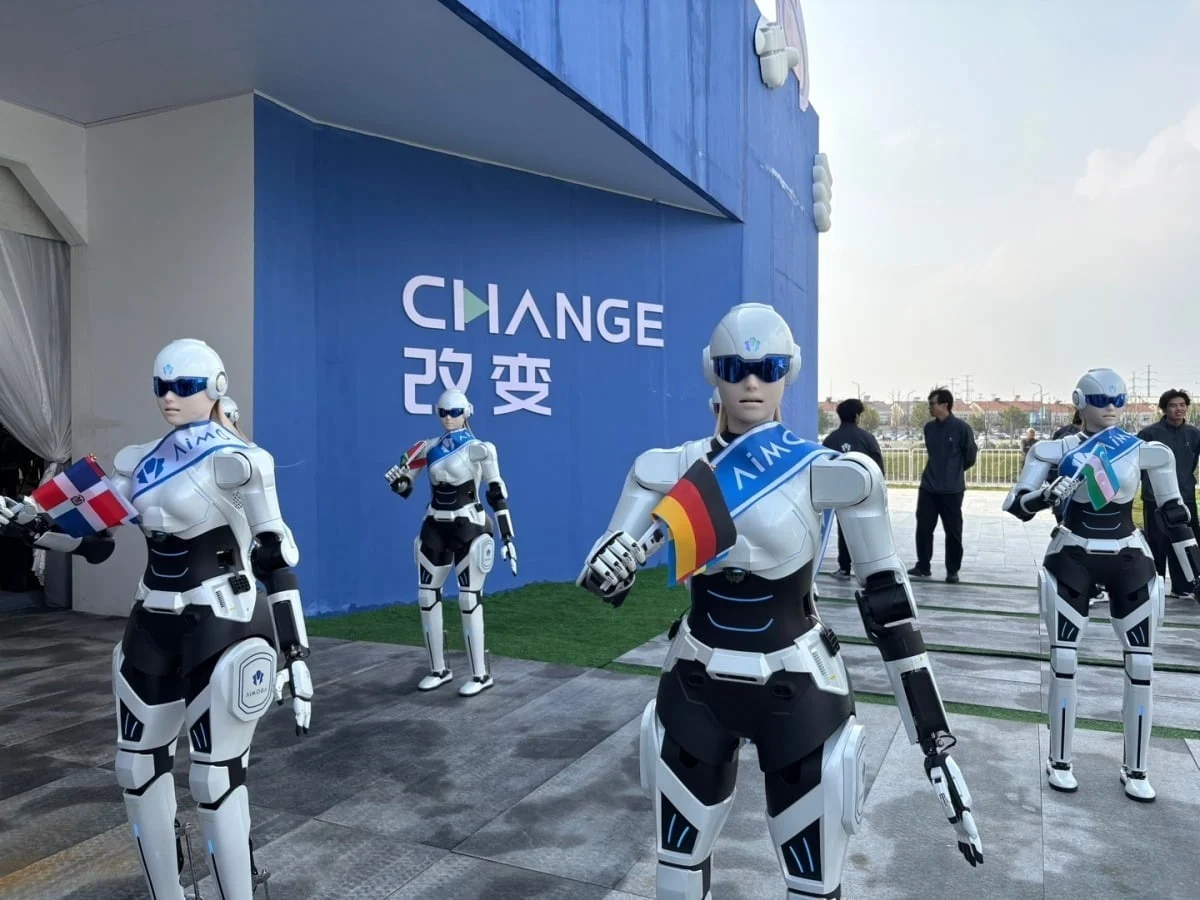
    중국 최대 자동차 수출업체 체리자동차가 가정용 휴머노이드 로봇 ‘모보’를 처음 공개했다. 키 90센티미터의 모보는 복약 알림, 영어 교육, 가족 구성원 기억과 돌봄 업무를 수행하며, 자동차 제조 과정에서 축적한 인공지능과 대량생산 역량을 가정용 로봇에 적용하는 시험에 나섰다.

    복약 알림에서 장기 기억까지, 가정용 기능 공개

    아이모가는 모보가 할머니와 대화하며 복약 시간을 알려주고, 아이와 숨바꼭질을 하고 영어와 춤을 보여주는 등 돌봄과 육아 기능을 무대에서 표현했다. 3대가 함께 사는 가정에 로봇이 들어온 상황을 상황극으로 연출해 제품의 활용성을 구체화했다.

    모보는 사람의 얼굴을 구분하고 가족 구성원과 나눈 대화와 생활 정보를 기억해 다음 대화에 활용한다. 음성 명령에 작동하며 20개 이상의 언어를 지원하고, 어린이에게 영어를 가르치거나 동화를 읽어주며 노인에게 복약과 일정을 알린다. 외부로 전송되는 데이터는 기기 내부에서 비식별화와 보안 검사를 거치도록 설계됐다.

    복수 작업과 돌발 상황 대응을 겨냥한 ‘이중 두뇌’

    아이모가 수석부사장 샤펑은 모보가 최대 16개 작업을 병렬 처리하고 작업 중단 상황에 0.2초 이내로 대응할 수 있다고 밝혔다. 시연에서는 회의 알림과 순찰 업무를 수행하던 모보가 예상하지 못한 질문에 답한 뒤 기존 작업을 재개했다.

    아이모가 직원은 모보가 사람의 명령에 단순히 반응하는 데 그치지 않고 주변 환경을 인식해 여러 단계의 작업을 스스로 계획하도록 설계됐다고 설명했다. 장기 작업 계획과 돌발 상황에 대한 즉각적인 대응을 결합한 이중 두뇌 구조가 특징으로 제시됐다.

    자동차 공급망을 로봇 제조에 재활용

    체리차는 자동차와 로봇이 카메라·센서 기반 환경 인식, 인공지능 경로 판단, 음성인식 기술을 공유할 수 있다는 점에 주목했다. 자동차 부품의 공동 구매와 생산 표준화로 제조원가를 낮추고 대량생산 체계를 갖추는 전략을 추진한다.

    로봇 설계 단계부터 자동차 부품과의 공용화를 검토하고, 제품군 사이에서도 부품 규격을 표준화해 공동 구매 규모를 키운다. 장귀이빙 체리차 부사장 겸 아이모가 사장은 대량생산과 수익성 있는 운영을 위해 자동차 제조업의 원가 관리 원칙을 적용해야 한다고 말했다. 기술 조직도 플랫폼 연구와 실제 사용 환경 검증을 나눠 산업화 체계로 개편하고 있다.

    글로벌 사업화 앞에는 가격과 인도 일정 남아

    아이모가의 글로벌 누적 로봇 판매량은 3천대를 넘어섰고, 제품과 서비스는 세계 60개 이상의 국가와 지역에 진출해 100개 이상 분야에 활용되고 있다. 우후시에서 글로벌 로봇 임대 브랜드 시범사업에 들어간 뒤 해외으로 확대할 계획이다.

    모보는 사람과 장애물을 인식해 경로를 조정하고, 사람이 다가오면 속도를 줄이거나 길을 양보한다. 다만 정식 판매가격과 구체적인 인도 일정은 아직 공개되지 않았다. 가정에서 기억과 감정적인 교류를 요구하는 서비스가 실제 삶에 정착할지는 가격, 안전성, 데이터 관리와 함께 검증될 과제로 남았다.

    한국경제의 현장 보도를 통해 체리자동차의 로봇사업 전환과 모보의 초기 기능을 확인할 수 있다.