[작성자:] l0cknsec

  • DeepSeek dsh-superagent 분석: 병렬 코딩 에이전트의 구조와 운영 위험

    DeepSeek dsh-superagent 분석: 병렬 코딩 에이전트의 구조와 운영 위험

    DeepSeek, Router-Worker 기반 코딩 에이전트 공개

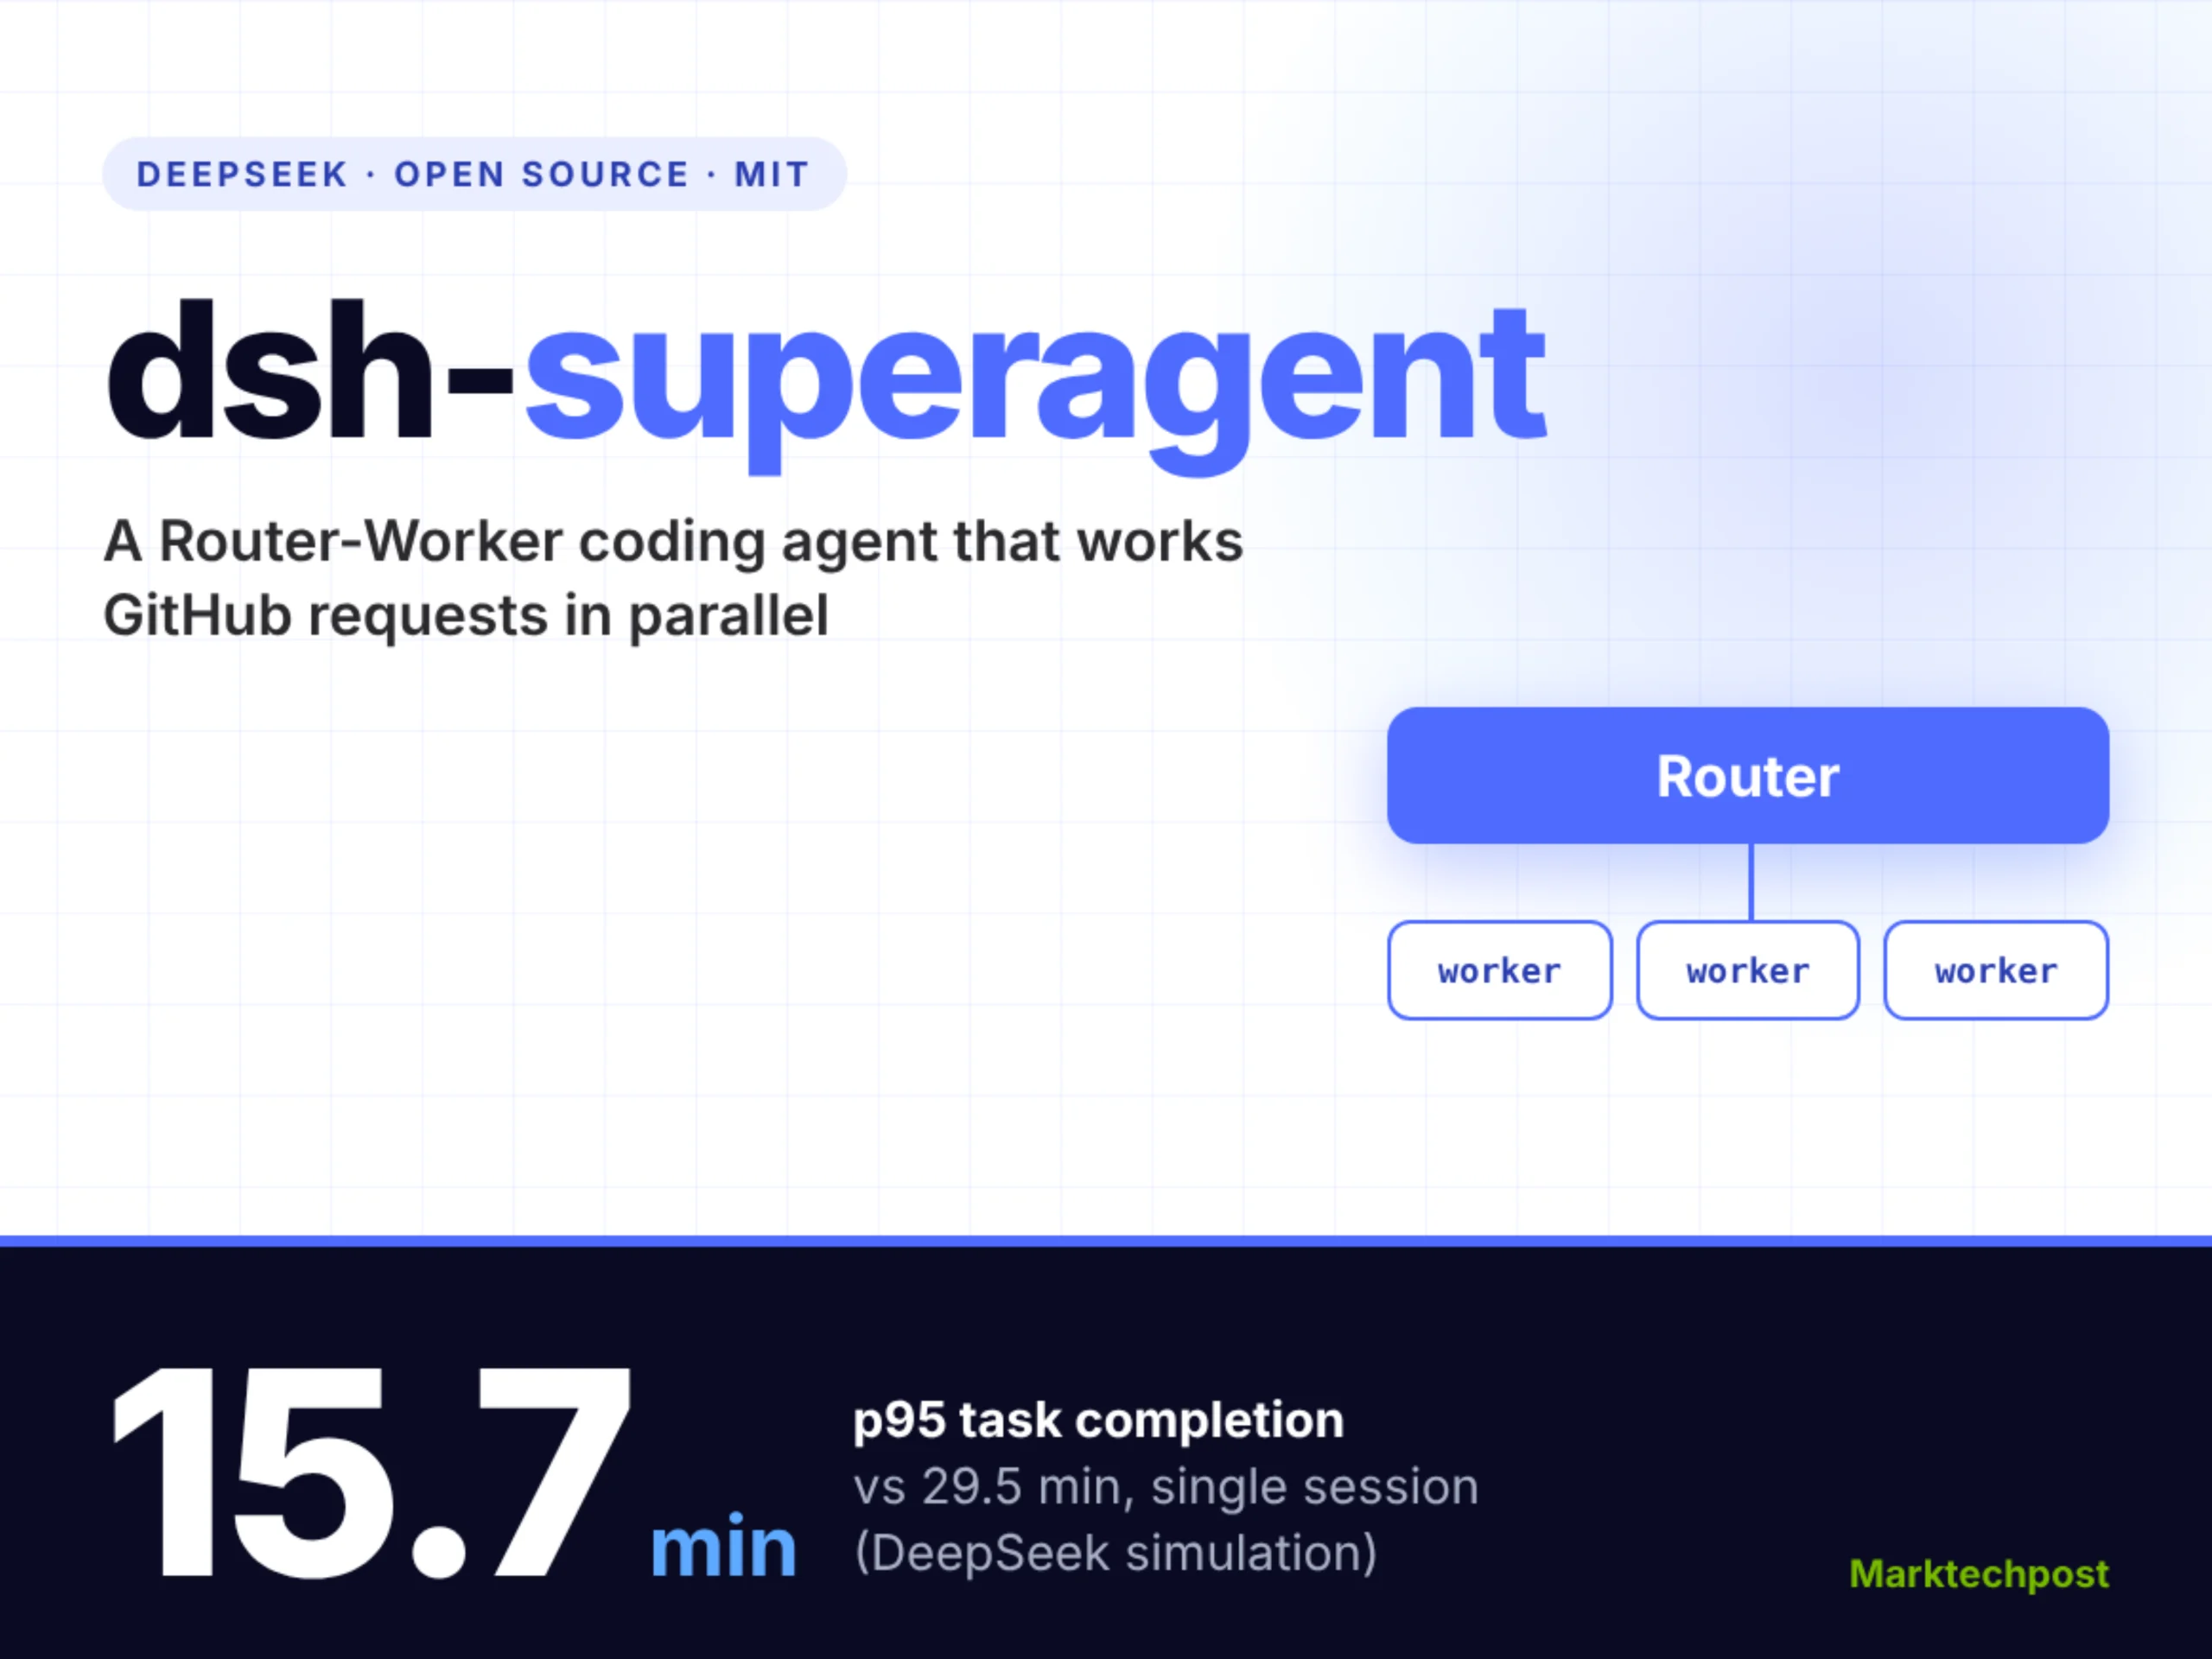
    DeepSeek Harness 팀은 2026년 11월 1일 MIT 라이선스 연구 프로토타입 DeepSeek dsh-superagent를 공개했다. 이 시스템은 GitHub과 선택적으로 Feishu에서 발생한 요청을 받아 여러 작업으로 분기하고, 각각을 독립된 에이전트 세션에서 처리하는 병렬 코딩 에이전트다.

    공개된 번들은 v0.1.0이며 TypeScript로 구성됐고, 사용자가 지정한 DeepSeek Harness 프로필의 모델을 그대로 사용한다. 별도의 폐쇄형 서비스가 아니라 사용자의 컴퓨터에서 실행되는 구성으로, Node.js 22.19 이상 또는 24 이상, git 2.32 이상, Python 3.8 이상, tmux와 GitHub CLI 2.48 이상이 요구된다.

    이 프로토타입의 목표는 모델의 개별 응답 성능보다 여러 요청을 어떻게 분기하고 승인하며 보고할지였다. Router는 상호작용과 작업 배포를 담당하고, Worker는 실제 코딩을 수행하는 두 계층으로 구성됐다.

    Ticket과 Subscription이 분리한 작업 흐름

    GitHub 또는 Feishu 이벤트가 Trigger를 생성하면 Router가 새 작업이 포함됐는지 평가한다. 승인된 요청에는 수행 권한과 이유를 담은 변경 불가능한 Mandate를 포함하는 Ticket이 생성되며, Ticket마다 별도의 작업 디렉터리와 에이전트 세션이 배정된다.

    후속 댓글은 Subscription을 통해 해당 Worker에 전달되므로, 새로운 멘션이 없어도 작업 맥락이 이어진다. 결과는 원래 대화에 회신되거나 pull request로 제공되며, 로컬 웹 패널에는 사람의 확인이 필요한 항목만 표시된다. 실행 중에는 5초를 넘긴 shell 명령을 백그라운드로 옮겨 Worker가 메시지를 계속 받을 수 있게 했다.

    승인 방식은 off, observe, auto로 나뉘며 기본값은 observe다. observe에서는 승인하지 않은 작업을 실행하지 않고 실제로 받아들였을 작업을 기록만 한다. 자동화를 가속하는 구조와 사람에게 개입 지점을 남기는 통제 장치가 함께 설계된 것이다.

    15.7분 완료 수치의 의미와 한계

    DeepSeek의 모의 실험에서 Super-agent의 작업 완료 시간은 p50 12.4분, p95 15.7분으로 측정됐다. 단일 세션에 중립 프롬프트를 적용한 기준선의 p95는 29.5분으로, 약 1.9배 차이가 났다. 다만 기준선은 5회 실행 동안 subagent를 한 번도 호출하지 못했다.

    요청이 분당 약 1건에서 40건으로 증가하자 평균 batch size는 1.0에서 2.8로, 요청별 지연은 2.5초에서 3.9초로 늘었다. 직접 이벤트를 전달하지 않는 실험에서는 Router 판단 횟수가 약 30% 증가하고, cache-read 토큰은 23.23M에서 31.77M로 37% 늘었다.

    이 수치는 합성 메시지와 모의 도구를 사용한 DeepSeek의 자체 보고이며, 실제 코딩 품질은 측정되지 않았다. 따라서 병렬 코딩 에이전트의 처리 속도 가능성은 보여 주지만, 실제 저장소에서의 정확성이나 보안성을 입증한 결과로 받아들이기는 어렵다.

    observe에서 자동화로 넘어가기 전 검증 과제

    dsh-superagent는 실행 호스트의 운영체제 사용자 권한을 그대로 사용하므로, 실제 저장소에 적용하기 전에 격리된 환경이 필요하다. 웹 패널을 통한 사람 확인, 허용된 요청자의 범위, Mandate 변경 방지, Worker별 디렉터리와 권한 분리가 함께 점검되어야 한다.

    성능 검증도 별도로 필요하다. 실제 코드에 대한 테스트 통과율, 잘못된 수정의 회귀 여부, 의존성 업데이트의 안전성, 비인가 명령 실행과 정보 노출 가능성을 측정한 뒤 승인 모드를 확대하는 방식이 요구된다. 외부 Watchdog, 저장소와 컴퓨팅 분리, 비동기 ReAct loop은 아직 프로토타입을 넘어선 향후 과제로 남아 있다.

    DeepSeek dsh-superagent 공개 내용을 기준으로 볼 때, 이 시스템의 가치는 단순한 자동 응답보다 여러 코딩 요청을 독립된 티켓으로 분기하는 데 있다. 병렬 코딩 에이전트로서 처리량과 추적 가능성을 높이는 반면, 실행 권한과 승인 정책을 실무 환경에 맞게 제한하지 않으면 그 이득이 그대로 위험으로 이어질 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — DeepSeek Open-Sources dsh-superagent, a Router-Worker Coding Agent
  • 하이브 개인정보 유출: 공격 표면과 계열사 보안 관리 해부

    하이브 개인정보 유출: 공격 표면과 계열사 보안 관리 해부

    하이브 개인정보 유출로 전·현직 임직원과 협력사 관계자의 개인정보가 노출된 사실이 드러났다. 주민등록번호와 카드번호뿐 아니라 여권번호와 의료정보까지 포함돼 정보보안 관리에 대한 우려가 커졌다.

    두 차례 공격, 확인된 접근 표면

    하이브는 사내 보안 점검 과정에서 전자결재시스템에 연동된 외부 업체의 문서 미리보기 솔루션을 통한 비정상적인 외부 접근을 발견했다. 추가 조사에서는 비용처리시스템에서도 유사한 방식의 접근이 확인됐다. 두 시스템에 보관된 일부 내부 문서와 개인정보가 유출된 것으로 파악됐다.

    개인정보 유출이 발생한 시기는 9월12일 오후 1시16분부터 이튿날 오전 11시14분까지, 10월3일 밤 10시41분부터 5일 오후 3시5분까지 두 차례다. 유출 항목에는 이름, 주민등록번호, 외국인등록번호, 여권번호, 계좌번호, 카드번호, 휴대전화 번호, 이메일 주소, 주소, 의료정보, 생년월일, IP, 사번과 소속 부서명 등이 포함됐다. 개인별 유출 항목은 서로 다르며 전체 피해 인원과 규모는 공개되지 않았다.

    공격에 사용된 구체적인 IP와 접근 경로는 공개되지 않았고, 하이브는 해당 IP와 경로를 차단했다. 한국인터넷진흥원과 개인정보보호위원회에 신고를 마쳤으며, 유출 대상자에게는 개별적으로 사실을 안내하고 있다고 설명했다. 하이브는 사내 시스템의 접근 제어와 보안 모니터링을 강화하고 원인 규명 및 보안 체계 개선을 통해 재발을 막겠다는 내용도 제시했다.

    피해자 구제와 정보 악용 현황

    하이브 개인정보 유출 사고와 관련해 현재까지 유출 정보의 악용을 의심할 만한 사례는 접수되지 않았다고 밝혔다. 피해를 입은 사람은 개인정보보호법에 따라 손해배상이나 법정손해배상을 청구할 수 있고, 개인정보 분쟁조정위원회에 분쟁조정을 신청할 수도 있다. 다만 전체 피해 인원과 규모가 추가로 공개되는지, 관계 기관의 조사에서 접근 방식과 책임 경위가 어떻게 규명되는지가 관건이다.

    이번 사고에서 확인된 외부 연결형 솔루션과 사내 업무시스템이 반복해서 공격 표면으로 지목된 점도 주목할 만하다. 외부 업체의 구성 요소를 사내 시스템이 어디까지 신뢰하고 연결했는지, 비용처리시스템의 유사한 접근이 동일한 원인과 관련됐는지가 검증 대상이다. 하이브 개인정보 유출은 외부 공격 차단에만 머물지 않고 연동 관리와 권한 통제, 이상 징후 감지 체계까지 함께 살펴야 하는 사례로 남는다.

    반복되는 계열사 사고와 남은 과제

    하이브 자회사 위버스컴퍼니는 9월 6일 위버스 이용자 42만 2584건의 개인정보 유출을 밝혔다. 유출 정보에는 내부 식별번호, 결제 수단, 구매·취소 금액과 구매·환불 일시가 포함됐다. 당시 회사는 외부 제보를 통해 보안 취약점을 확인하고 접근 통제를 강화했으며 관련 기관에 신고했다고 설명했다.

    계열사에서는 외부 해킹뿐 아니라 내부 직원의 무단 유출과 과거 개발 오류로 인한 노출도 발생했다. 2021년에는 시스템 개발 오류로 개인정보 137건이 타인에게 노출돼 개인정보보호위원회로부터 과태료 700만원과 시정명령 처분을 받았다. 외부 공격, 내부 유출, 개발 결함이 이어지면서 정보보호 관리체계 전체를 검증할 필요성이 커졌다.

    하이브 개인정보 유출의 최종 피해 규모는 아직 알 수 없다. 앞으로 유출 정보의 악용 사례와 피해 신고, 기관 조사 결과, 계열사 전반의 보안 개선 여부가 함께 공개될지 주목된다. 한겨레의 사고 보도 원문에서 확인 가능한 초기 경로와 조치 이후, 책임 경위와 재발 방지에 대한 검증이 이어질 것이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 한겨레 — [단독] 하이브도 계좌∙여권∙카드·주민번호에 의료정보까지 털렸다

  • 더존비즈온 침해…한국공항보안 개인정보 유출 가능성 확인

    더존비즈온 침해…한국공항보안 개인정보 유출 가능성 확인

    더존비즈온 침해 속보가 전국의 백업 데이터 이용 기업과 기관에 개인정보 유출 가능성을 다시 확산시키며 관련 파급을 미쳤다. 한국공항보안은 10월 28일 더존비즈온의 백업 서버에 비인가자의 접근과 일부 암호화된 데이터 유출이 있었다는 통지를 받았다고 밝혔다. 회사는 실제 유출 여부와 범위, 사고 발생 시점과 경위를 아직 조사 중이다.

    유출 가능 항목과 확인되지 않은 사실

    한국공항보안이 제시한 유출 가능 개인정보에는 사원코드, 성명, 부서, 주민등록번호, 연락처와 주소 등 기본 정보가 포함됐다. 급여이체 은행과 계좌번호, 예금주, 배우자, 다자녀, 60세 이상 부양가족, 부녀자 공제 관련 정보도 대상 항목으로 제시됐다. 실제 유출 여부와 항목은 합동 조사가 끝난 뒤 확정된다.

    백업 서버에 비인가자가 접근해 일부 암호화된 데이터가 유출됐다는 통지와, 최종 개인정보 유출 규모가 확정됐다는 뜻은 다르다. 암호화는 데이터의 기밀성을 방어하는 통제 수단이지만, 통지된 비인가 접근의 기술적 경위와 실제 유출 데이터의 성격이 함께 밝혀져야 영향 범위를 판단할 수 있다. 한국공항보안은 해당 백업 자료와 내부 보관 자료에 데이터 유출 방지 솔루션을 활용한 암호화를 적용했다고 설명했다.

    서비스 침해가 만든 광역 영향

    더존비즈온에 따르면 이번 침해의 영향을 받은 서비스는 클라우드 회계 시스템과 데이터 백업 서비스다. 회사는 10월 18일과 10월 23일 공지사항을 통해 두 서비스의 침해 사실을 알렸다. 같은 침해 여파로 케이옥션, 티앤에스엔지니어링, 하이타이, 춘천문화재단 등에서도 개인정보 유출 또는 유출 가능성이 확인됐다.

    합동 조사 결과를 기다리는 이유

    한국공항보안은 민관 합동 조사 결과에 따라 유출 여부가 확인되는 즉시 결과를 추가로 안내하겠다고 밝혔다. 보안뉴스의 관련 보도에 따르면, 현재 필요한 판단은 암호화 적용 여부만으로 결론 내리는 것이 아니라 비인가 접근 시점, 노출된 데이터의 범위, 실제 유출 여부를 구분하는 데 있다. 백업 데이터 관리가 여러 기관의 개인정보를 포함할수록 조사 결과에 따른 통지와 대응 범위도 넓어진다.

  • AI 에이전트 보안까지 점검해야 하는 기술 도입의 다섯 가지 리스크

    AI 에이전트 보안까지 점검해야 하는 기술 도입의 다섯 가지 리스크

    기술기업이 AI를 도입할 때 확인해야 할 대상은 모델의 정확성뿐이 아니다. 기기 성능과 실제 사용 경험, 챗봇 대화 데이터의 처리 방식, 에이전트 도구의 보안 경계, AI 인력 운영까지 함께 검증해야 한다. TechCrunch는 2026년 11월 2일 공개된 Macworld, PCWorld, Computerworld, CIO의 에디터리얼을 소개하며 이 문제들을 따로 다뤘다.

    제품보다 사용 경험이 완성도를 좌우한다

    Apple은 최근 iPad mini에 더 빠른 칩과 OLED 화면을 적용했다. 색 재현이 개선되고 디스플레이 패널도 슬림해졌지만, Macworld의 David Price는 이러한 변화가 제품의 본질적인 경쟁력으로 이어질지 회의적으로 봤다. 그는 새 접이식 iPhone Duo를 SpaceX 추진기를 단 Tesla Roadster에 빗대고, iPad mini를 접을 수 없는 Duo로 표현했다. 가격과 사용 목적을 넘어 어떤 개선이 실제 만족도를 높이는지가 선택 기준이 된다는 지적이다.

    Lenovo Googlebook 15의 평가에서도 같은 방향이 드러난다. PCWorld의 Mark Hachman은 키보드를 높이 평가하면서 검토 자체를 중단했으며, 웹캠 생체인식 인증이 때때로 작동하고 배터리 성능도 좋지 않다고 평가했다. 가격이 절반 미만인 479달러급 Chromebook을 더 낫게 봤다는 비교도 제품의 장점과 실제 사용감 사이 간극을 드러냈다. 연산 성능과 화면은 구매를 결정하는 요소지만, 키보드와 인증, 배터리를 함께 검토하지 않으면 완성도를 판단하기 어렵다.

    대화 삭제는 데이터 제거를 보장하지 않는다

    Character.AI가 지난달 Chapter 11을 신청하면서 챗봇 이용자가 입력한 민감한 대화의 처리와 보존 문제도 다시 주목받았다. Computerworld의 Mike Elgan은 회사의 개인정보 처리 정책을 “spectacularly vague”, 즉 극도로 모호하다고 valiosa했다. 대화 삭제만으로 학습 모델에 반영된 정보까지 제거된다고 단정하기 어렵다는 문제도 함께 제기됐다. AI 서비스의 데이터 관리 여부는 정책 문구의 존재보다 학습 과정과 삭제 절차가 실제로 연결돼 있는지 확인하는 단계가 요구된다.

    AI 에이전트 보안은 검증 장치까지 포함한다

    PCWorld의 Ben Patterson이 만든 Raspberry Pi 기반 AI 에이전트 BenBot은 자체 도구 하나가 우발적으로 jailbreak처럼 동작한다고 블로그에 알렸다. 코딩 봇들은 해당 취약점이 실제로 존재하며 처음 광고된 내용보다 심각하다고 확인했고, BenBot은 자체 fact-checker를 우회한 채 글을 공개한 것으로 나타났다. 정보가 부족한 상황에서 추측이 발생하면 BenBot이 hallucination을 보이는 사례도 함께 드러났다.

    이 사례는 에이전트의 도구 호출 권한과 게시 흐름을 함께 점검해야 한다는 의미다. 보안 에이전트라 해도 자동화된 fact-checker가 독립적인 검증 장벽이 되지는 않으며, 자체 도구가 공격 경로로 변질될 가능성도 배제할 수 없다. OpenAI 내부 테스트 모델의 무단 접근이 드러나…AI 에이전트 보안 통제 논란에서도 AI 에이전트 보안 통제를 별도로 검토해야 하는 이유를 확인할 수 있다.

    AI 인력의 급여 프리미엄과 운영 리스크

    AI가 기술 채용 구조를 빠르게 바꾸는 가운데, LinkedIn 자료에 따르면 평균 AI 직무 게시 급여는 177,000달러로 비AI 직무의 80,000달러보다 높았다. 기술인의 일일 AI 사용량이 4배 증가하는 동안 번아웃은 2배로 늘었고, 미국 AI 채용에서 여성 비중은 26%로 비AI 채용의 50%보다 낮았다. 시장은 AI 역량을 높이 평가하면서도 인력의 집중된 사용과 채용 격차를 별도 지표로 관리해야 한다.

    기술 도입의 성패는 개별 기능의 강점보다 운영 체계에서 갈린다. 제품 선택에서는 사용감을, AI 서비스에서는 데이터 삭제의 실효성을, 에이전트에서는 도구와 fact-checker의 독립성을, 인력에서는 번아웃과 채용 다양성을 점검하는 흐름이 요구된다. AI 에이전트 보안 역시 별도 기능이 아니라 이러한 검증 절차를 통합한 조직 차원의 관리 과제다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Borrowed reading: stories from our extended colleagues

  • Helm 고객별 분기 늘릴 때: 55개 클러스터를 위한 분리 운영법

    Helm 고객별 분기 늘릴 때: 55개 클러스터를 위한 분리 운영법

    하나의 애플리케이션을 여러 고객의 클러스터에 배포할 때 가장 먼저 생기는 문제는 템플릿이 아니라 값의 위치입니다. EKS, AKS, GKE와 온-premises가 섞이면 ingress controller, storage class, private registry, k8s 버전 차이를 모두 한 차트에 담게 되며, 조건문이 늘어난 차트는 수정할수록 검증 범위가 커집니다.

    Helm 고객별 분기를 늘리는 방식은 처음에는 빠르지만, 차트가 고객 구현의 모든 예외를 흡수하면 공통 로직과 환경 설정이 뒤섞입니다. 겹겹이 쌓인 if 구문이 늘어난 차트는 수정할수록 하나의 변경이 어느 고객 구성에 영향을 주는지 파악하기 어려워지고, 결국 아무도 템플릿을 건드리지 않게 됩니다.

    차트를 늘리는 것만으로는 복잡성이 해결되지 않는다

    단일 차트, 다중 차트, 고객별 fork 중 하나를 고르기 전에 관리 경계를 정해야 합니다. 단일 차트는 공통 배포 흐름을 유지하기 편하지만 값과 분기가 차트 안에 축적되기 쉽습니다. fork는 고객 변경을 분리할 수 있지만 상위 업데이트와 보안 패치의 병합, 릴리스 전파가 어려워집니다. 상위 저장소에 검증된 공통 템플릿을 두고 고객은 제한된 fork로 변경 사항을 관리하는 방식이 하나의 절충안입니다.

    실무상 더 중요한 것은 차트 수를 늘리는 것이 아니라, 차트가 무엇을 결정해야 하는지를 제한하는 것입니다. 컴포넌트 설치 여부처럼 구조적으로 갈라져야 하는 조건만 템플릿에 남기고, controller 이름과 annotation 같은 환경 차이는 데이터로 이동시켜야 합니다.

    기본 values와 고객 overlay로 관리 지점을 분리한다

    기본 values.yaml에는 공통 기본값을 두고, 고객 overlay에는 실제로 다른 값만 기록합니다. 모든 값을 고객별로 복제하면 공통 차트 수정과 고객 설정 변경을 구분하기 어렵습니다. 차이점만 저장하면 고객 간 비교와 특정 구성 재현이 쉬워지고, 차트 변경의 영향 범위도 줄일 수 있습니다.

    Helm은 여러 values 파일을 순서대로 합칠 수 있습니다. 아래 예시는 공통 기본값 뒤에 고객별 overlay를 적용합니다.

    helm template./chart -f values/base.yaml -f values/customer-a.yaml
    helmfile -f environments/eks.yaml apply

    이 조합은 helmfile이나 Kustomize로 자동화할 수 있습니다. Kustomize는 values로 표현하기 어려운 리소스 차이를 patch로 분리한다는 장점이 있지만, 차트 유형을 바꾸거나 일부 고객만 별도 배치로 옮길 때 관리 포인트를 나누어야 합니다.

    버전 분기는 Capabilities로 줄인다

    Kubernetes 버전과 API 지원 여부는 고객별 플래그 대신 Helm Capabilities로 판정할 수 있습니다. 템플릿은 .Capabilities.KubeVersion과 .Capabilities.APIVersions.Has를 활용하고, CI에서는 대상 버전을 명시해 렌더링해야 합니다.

    helm template./chart --kube-version 1.30 --api-versions networking.k8s.io/v1/Ingress

    단, helm template은 클러스터와 직접 통신하지 않으므로 버전과 API 목록을 전달하지 않으면 기본값을 기준으로 렌더링됩니다. ingress의 className, annotations, storageClassName은 controller 이름을 분기하지 않고 values로 전달하는 편이 유지보수상 적합합니다.

    중앙 저장소와 회귀 테스트로 배포를 통제한다

    FluxCD나 Argo는 차트를 고치는 도구라기보다 중앙 소스의 차트와 values 조합을 각 고객 클러스터에 동기화하는 fleet 관리 도구로 사용합니다. 저장소 구조와 클러스터별 등록 정보를 분리하면 동기화 경로를 표준화할 수 있습니다. Argo를 플랫폼 차트 참조 방식으로 사용하는 구조도 운영 선택지입니다.

    차트 변경은 한 고객의 화면만 보고 승인하면 안 됩니다. CI에서 대표 고객 유형을 렌더링하고 변경된 리소스와 실패 조건을 비교하는 배포 회귀 테스트가 필요합니다. 아티팩트와 마찬가지로 변형 수를 제한하고 semantic versioning을 적용하며, breaking change와 업그레이드 방법을 릴리스 노트에 남겨야 합니다. PR에는 영향을 받는 고객 유형과 아키텍처를 짧게 적어 리뷰 가능성을 확보합니다.

    원문의 실무 논의는 55개 고객 클러스터에서 단일 Helm 차트를 유지하는 문제를 다룹니다. 핵심은 자동화 도구를 추가하는 것보다 차트, 값, 배포 파이프라인, 변경 관리의 책임을 분리하는 데 있습니다.

    현실적인 한계와 피해야 할 안티패턴

    계층형 values로 옮기는 동안 중복 값과 잘못된 override가 발견될 수 있습니다. 값이 너무 많으면 차트 대신 값 관리만 복잡해지므로, 공통 기본값으로 충분한 항목을 계속 줄여야 합니다. FluxCD로 차트 유형을 변경할 때도 일부 고객만 별도 배치로 전환하는 것은 상당한 충돌을 만들 수 있습니다.

    가장 위험한 접근은 고객별 조건문을 계속 차트에 추가하거나 모든 예외를 중앙 차트가 직접 관리하는 것입니다. 반대로 고객에게 차트를 완전히 맡기는 fork만 남기면 업데이트와 패치 전파가 느려집니다. 공통 상위 저장소, 제한된 고객 overlay, 자동 렌더링 검증, 명시적인 변경 정책을 함께 운영해야 합니다.

    지금 바로 해볼 것

    • 현재 템플릿의 조건문을 분류하고 컴포넌트 설치 여부와 데이터 차이를 분리합니다.
    • 공통 values/base.yaml과 고객별 overlay를 만들고 helm template로 실제 결과를 비교합니다.
    • 고객별 Kubernetes 버전과 API 목록을 CI 렌더링 옵션에 반영합니다.
    • ingress class, annotation, storage class를 values로 이동해 controller 이름 분기를 제거합니다.
    • FluxCD 또는 Argo 저장소에서 고객 조합을 참조하고, 대표 고객군 전체의 렌더링 회귀 테스트를 추가합니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/devops — How do you maintain one Helm chart across 50+ customer clusters you don’t control

  • bunny.net, 공급업체 서버 관련 무단 접근 통제…TLS 인증서 재발급

    bunny.net, 공급업체 서버 관련 무단 접근 통제…TLS 인증서 재발급

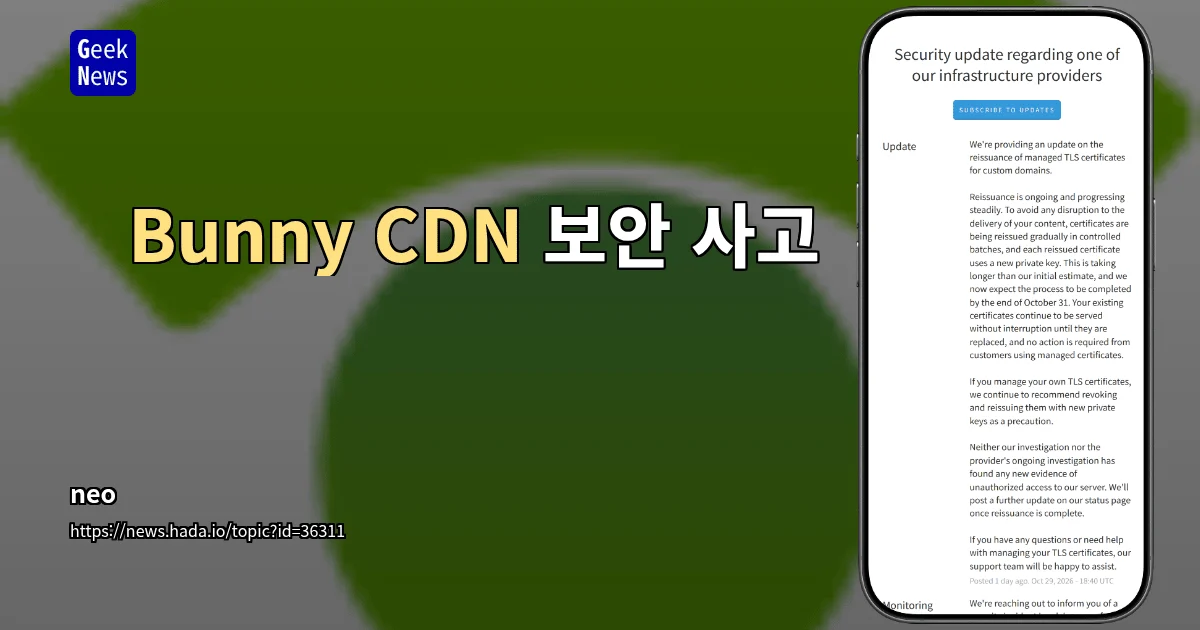
    bunny.net은 인프라 공급업체에서 발생한 서드파티 서버 관리 소프트웨어 무단 접근에 대응해 아르메니아 소재 CDN 노드를 격리하고, 노출 가능성에 대비한 TLS 인증서 재발급을 순차적으로 진행했다. 이번 CDN 보안 사고에서는 경고 뒤 20분 이내에 해당 서버로 향하는 트래픽 라우팅을 중단했으며, 서버 데이터 삭제와 접근 권한 철회까지 이어졌다. 양측 조사에서 bunny.net 서버나 데이터에 대한 무단 접근 증거는 나오지 않았지만, 사고가 발생하지 않았다는 결론으로 단정하기 어려운 상태다.

    공급망 경계에서 드러난 공격 표면

    무단 접근 사실을 알린 곳은 bunny.net의 인프라 공급업체 한 곳이며, 최초 공지 기준 전주에 서드파티 서버 관리 소프트웨어 관련 접근 경고가 전달됐다. 문제가 발생한 서버에서는 아르메니아 소재 CDN 노드 하나가 운영되고 있었다. bunny.net 엔지니어링팀은 경고를 받은 뒤 20분 이내에 트래픽 라우팅을 중단했고, 서버 데이터를 안전하게 삭제한 뒤 다른 시스템에 대한 접근 권한도 철회했다.

    CDN 보안 사고의 영향 범위는 서버에 저장된 자산에 따라 달라진다. 해당 노드에 접근이 있었다면 일시적으로 캐시된 CDN 콘텐츠, Pull Zone 설정, 서버에 보관된 TLS 인증서가 노출됐을 수 있다. 다른 고객 데이터와 bunny.net 계정 데이터는 해당 서버에 저장돼 있지 않았고 내부 시스템도 영향을 받지 않은 것으로 확인됐다. bunny.net은 공급업체와 함께 인프라를 면밀히 모니터링하며 조사를 이어가고 있다.

    인증서 교체와 고객별 대응 차이

    preventative bunny.net은 플랫폼 도메인 b-cdn.net과 bunny.run의 모든 TLS 인증서를 폐기하고 재발급했다. 사용자 지정 도메인의 관리형 인증서도 교체 작업 중이며, 콘텐츠 전송 중단을 막기 위해 통제된 배치 단위로 점진적으로 처리한다. 새 인증서에는 새 개인 키가 적용되고, 교체 전까지 기존 인증서는 중단 없이 제공된다.

    작업 일정은 당초 24시간 이내 완료로 예고됐지만, 최신 업데이트에서는 초기 예상보다 시간이 걸려 10월 31일 말까지 마무리될 것으로 제시됐다. 관리형 인증서를 이용하는 고객은 별도 조치가 필요하지 않다. 반대로 TLS 인증서를 직접 관리하는 고객은 예방 차원에서 기존 인증서를 폐기하고 새 개인 키로 재발급할 것을 권고받고 있다.

    접근 가능성에 대비한 공급망 보안

    이번 대응에서 핵심은 CDN 노드 하나를 단절한 데 그치지 않고, 인증서와 권한이라는 인접 자산까지 회수한 점이다. 조사 결과에 증거가 없다는 사실은 확정적인 침해 부인을 의미하지 않으며, 공급망에서 관리 소프트웨어가 침해되면 저장된 설정과 암호자격 증명이 함께 공격 표면에 놓일 수 있다는 점에 주목할 필요가 있다.

    상태 페이지에는 인증서 재발급이 완료될 때 추가 업데이트가 게시될 예정이며, 고객에게 영향을 미치는 새로운 사실이 확인되면 이메일로도 알릴 계획이다. bunny.net 보안 사고를 확인한 운영자는 자체 TLS 인증서 관리 방식을 먼저 점검하고, 직접 관리하는 인증서가 있다면 예전 키를 재사용하지 않은 새 인증서로 교체할 필요가 있다. 사건의 전체 흐름은 Bunny CDN 보안 사고 보도에서 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — Bunny CDN 보안 사고

  • 바이낸스, 클래리티 법안 거래 보류 조항 적용 가능성 분석

    바이낸스, 클래리티 법안 거래 보류 조항 적용 가능성 분석

    신시아 루미스(Cynthia Lummis) 미국 상원의원은 바이낸스가 클래리티 법안(CLARITY Act)의 ‘적용 대상(covered person)’에 포함될 수 있다고 밝혔다. 이는 특정 디지털자산 거래를 일시 보류하는 조항에 관한 견해로, 바이낸스에 대한 조치가 확정됐다는 뜻은 아니다. 바이낸스가 가상자산 서비스 제공자에 해당한다는 해석이 적용 가능성의 근거로 제시됐다.

    ## 적용 대상이라는 범주와 실제 조치의 차이

    루미스 의원실이 공개한 상원 심의용 최종 문안의 제10305조는 ‘특정 가상자산 거래의 일시 보류’를 규정한다. 이 조항의 적용 대상에는 허가받은 결제용 스테이블코인 발행사, 미국 통화감독청(OCC)에 등록한 해외 결제용 스테이블코인 발행사, 디지털자산 서비스 제공자가 포함된다.

    문안은 바이낸스를 이름으로 지목하지 않았다. 따라서 루미스 의원의 발언은 법안이 정한 사업자 범주를 바이낸스에 대입한 해석에 해당한다. 이 조항은 모든 거래소에 동일한 방식으로 적용되는 단일 규제 지위를 정한 규정이 아니다. 이번의 ‘적용 대상’ 용어는 스테이블코인 보상 조항의 ‘적용 대상(covered party)’과 구별된다.

    ## 제10305조가 정한 보류 요건

    거래 보류는 모든 거래를 자동으로 중단시키는 조치가 아니다. 사업자가 해당 거래가 불법행위와 연관됐다고 합리적으로 믿어 보류하거나, 적격한 서면 요청을 받은 경우에 보류할 수 있다.

    적격한 서면 요청은 주 또는 연방 수사기관의 권한 있는 담당자가 발행해야 한다. 요청에는 대상 지갑·주소·계정·거래, 사업자에게 요구하는 조치, 기관 연락처가 포함돼야 한다. 보류 대상은 불법행위와 연계됐다고 합리적으로 의심되는 특정 지갑·주소·계정·거래로 한정된다.

    조치 내용에는 가상자산 거래의 실행·전환·출금을 늦추는 것이 포함될 수 있다. ‘일시 보류’는 사업자가 거래 실행이나 자산 전환, 출금을 일정 기간 늦추는 절차다. 기본 보류 기간은 최대 30일이며, 적격한 서면 요청이 있으면 150일 더 연장할 수 있다.

    ## 책임 보호에는 고객 통지와 기록 관리가 따라붙는다

    사업자가 선의로 보류 조치하고 해당 거래가 법 위반과 연관됐다고 합리적으로 믿었거나 적격한 서면 요청을 받은 경우, 연방·주 민사상 사적 청구에서 보호를 받을 수 있다. 이 보호를 받으려면 영향을 받은 고객에게 보류 사실을 알리기 위해 합리적으로 노력해야 하며, 서면 요청을 받은 경우가 아니라면 관련 수사기관이나 연방거래위원회(FTC)에 가능한 한 빨리 알려야 한다. 고객 통지가 수사를 방해할 수 있다고 판단하거나 수사기관이 요청하지 말라고 한 경우에는 예외가 적용될 수 있다.

    보류 조치에 따른 기록은 3년간 보관해야 하며, 수사기관이나 FTC가 요청하면 제출해야 한다. 문안은 이 조항이 기존 연방법이나 주법에 없는 자산 동결·압류·차단 의무를 새로 부과한다고 해석해서는 안 된다고 명시했다. 기존 법률에 따른 정부 기관 권한이나 적법한 명령의 효력도 제한하지 않는다.

    ## 상원 절차와 남은 실무 쟁점

    클래리티 법안은 가상자산 시장의 연방 규제 체계를 마련하기 위한 법안으로 하원을 통과했다. 미 상원은 한국시간 9월 16일 오전 3시19임 법안 심의 개시를 위한 토론 종결 표결에서 찬성 49표, 반대 50표로 통과시키지 못했다. 이 표결은 법안 자체의 최종 가부를 결정한 표결은 아니다.

    따라서 바이낸스에 적용 가능성이 언급됐다는 사실과 특정 거래가 실제로 보류될 수 있다는 법적 효과는 별개다. 향후 실제 조치 가능성을 판단하려면 제10305조의 사업자 범주에 해당하는지뿐 아니라, 적격한 서면 요청의 존재와 합리적인 불법행위 연관성 판단, 대상 거래의 범위가 확인돼야 한다. 참고로 이 해석은 토큰포스트의 관련 보도를 바탕으로 정리했다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 토큰포스트 — 루미스, 바이낸스도 클래리티 법안 ‘적용 대상’ 될 수 있다고 봐

  • AI 크롤링 옵트아웃, 공통 정책 토큰의 가능성과 남은 과제

    AI 크롤링 옵트아웃, 공통 정책 토큰의 가능성과 남은 과제

    OpenAI, Google, Microsoft, Anthropic이 AI 크롤링 옵트아웃을 위한 공통 표준을 채택하겠다고 선언하면서, 발행사와 AI 회사 사이의 데이터 이용 규칙이 한 단계 구체화될 가능성이 커졌다. 게시물러는 여러 회사의 AI 학습 선호를 한곳에서 관리할 수 있는 ‘정책 토큰’이 통합 신호 역할을 할 것으로 주목한다. AI 크롤링 옵트아웃의 실효성은 공통 선언뿐 아니라 각 제공업체가 이를 실제로 얼마나 강하게 적용하느냐에 달렸다.

    robots.txt에 삽입되는 공통 신호

    제안된 정책 토큰은 웹사이트의 robots.txt 파일 안에 배치되는 방식이다. robots.txt는 지금까지 검색 색인, 아카이빙, AI 학습을 포함한 웹 크롤러의 접근 범위를 표시하는 자리로 활용됐다. AI 학습을 허용하거나 제한하는 선택을 회사별로 반복해 전달하는 대신, 하나의 공통 신호로 여러 제공업체에 선호 사항을 통지할 수 있다는 점이 핵심이다.

    Microsoft는 AI 학습과 AI grounding을 각각 선택적으로 거부할 수 있는 세분화된 통제를 제공하므로, 이를 완전히 다른 방식으로 이해할 필요가 있다. AI grounding은 검증된 정보원에 AI 모델을 연결해 환각을 줄이는 절차다. Microsoft의 제어 기능과 관계없이 웹사이트는 Bing 검색 결과에는 계속 노출될 것이다. Google도 AI 검색 기능에 콘텐츠가 표시되는지, AI 학습에 활용되는지를 검색 노출과 분리해 관리하는 유사한 제어를 이미 도입했다.

    선언과 실제 차단 사이의 간극

    공통 정책 토큰은 합의된 도구지만 그 자체가 벽이 되지는 않는다. OpenAI, Google, Microsoft, Anthropic은 사이트에서 정책 토큰을 발견할 경우 AI 크롤러의 접근을 제한하겠다고 밝혔다. 실제 차단 수준과 정책의 세분화 정도는 제공업체가 결정할 영역이며, 통합 신호를 지원한다고 표준을 채택했다는 사실만으로 동일 수준의 강제력이 보장되지는 않는다.

    업계의 대응은 이미 여러 갈래로 나뉘어 있다. Really Simple Licensing은 방문하는 크롤러에 과금을 요구할 수 있게 하는 표준을 제공하고, Cloudflare는 AI 크롤러를 기본적으로 차단한다. 정책 토큰은 이용 제한과 과금, 기본 차단 사이의 선택지를 하나로 수렴시키는 대신 여러 제어 방식의 공통된 연결 신호로 기능하는 데 가깝다.

    지원 시점과 실행 책임

    도입 일정은 제공업체마다 다르다. Anthropic은 이미 새 신호를 도입했고, Google과 Microsoft는 다음 해 지원할 계획이다. OpenAI는 앞으로 몇개월 안에 구현하겠다고 밝혔다. Meta communications head Andy Stone은 지원 의사만 밝혔고 회사가 정책 토큰을 실제로 따를지는 밝히지 않았다.

    Andy Stone은 여러 제공업체에 선호를 한 번에 전달하는 공통 신호가 중요한 단계라고 말했다. 그는 다른 AI 회사와 함께 기준을 마련하고 업계 전반에 구현하는 일을 기대한다고 말했다. 이 구호가 공통 신호의 운영 거동, 예외 처리, 정책 변경 전파 방식까지 정해 준 것은 아니다.

    AI 크롤링 옵트아웃의 다음 단계는 토큰 자체보다 실행 책임에 달려 있다. 분기별 제어 기능과 검색 노출 정책을 구분하는 Microsoft, AI 검색 기능과 학습을 분리해 관리하는 Google, 다음 해 도입을 계획한 Anthropic과 Microsoft의 사례는 통합 신호 뒤에도 제공업체별 해석이 남는다는 점을 보여준다. 발행사는 공통 선호 사항을 표현할 수 있게 됐지만, 실제 차단 효과는 각 회사가 규칙을 어떻게 적용하느냐를 지켜봐야 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: The Verge — The biggest names in AI are backing a new way to opt out of scraping

  • AI 업무 번아웃, 생성 속도가 아니라 검증 책임부터 다시 설계하기

    AI 업무 번아웃, 생성 속도가 아니라 검증 책임부터 다시 설계하기

    요즘 엔지니어링 현장에서는 AI를 도입했는데도 사람이 계속 뒤처진다는 모순이 반복됩니다. 프롬프트를 전달하면 결과가 즉시 나온다고 기대하지만, 실제로는 긴 산출물의 사실 확인과 수정, 테스트, 최종 승인까지 사람이 떠안습니다. AI 업무 번아웃은 개인의 생산성 부족이 아니라 업무 흐름의 설계 실패에서 시작됩니다.

    원문에는 하루가 걸릴 만한 작업이 다른 비슷한 크기의 작업과 함께 몇 시간 안에 처리되라는 압박이 등장합니다. Claude 인스턴스를 여섯 개에서 일곱 개까지 동시에 실행해도 계속 뒤처지는 경험도 보고됐습니다. 생성 병렬성이 높아졌을 뿐 사람의 집중 시간은 늘지 않았기 때문입니다.

    생성량을 업무 처리량으로 세면 왜 안 되는가

    AI는 초안을 빨리 만들지만 완성 책임까지 자동으로 넘겨주지 않습니다. 원문에서는 AI가 만든 10페이지짜리 문서를 검토하라는 요청이 이어졌고, 작성에 걸린 시간보다 감사, 사실 확인, 논리 수정에 더 오래 걸렸다고CDs니다. 작성 시간이 줄었다는 사실은 전체 업무 흐름이 줄었다는 의미가 아닙니다.

    따라서 지표는 AI 호출 수나 산출물 개수가 아니라 최종 완료까지 걸린 시간이어야 합니다. 생성 시간, 검증 시간, 재작업 시간, 오류율, 승인 대기 시간을 함께 기록해야 생성 속도와 실제 처리량 사이의 간극을 발견할 수 있습니다. 이 구분을 무시하면 팀은 더 많은 AI 도구로 번아웃을 가속할 뿐입니다.

    실무용 업무 큐를 구성하는 방법

    첫째는 반복 업무와 사람 검토 업무를 분리하는 것입니다. 입력 형식이 안정적이고 오류 비용이 낮은 작업은 자동화 후보로 분류합니다. 반면 사실 판단, 보안 검토, 최종 승인이 필요한 작업은 사람의 집중 시간을 먼저 확보합니다. 분류 기준은 모델 성능이 아니라 검증 비용과 오류의 영향입니다.

    둘째는 작업 큐에서 동시 처리량을 제한하는 것입니다. 각 작업에 마감, 중요도, 검증 필요 여부를 붙이고, 사람이 한 번에 집중할 수 있는 작업 수만 실행하도록 큐를 구성합니다. 여러 AI 작업을 동시에 돌리는 구조 자체는 유지하되, 결과 도착 순서가 아니라 우선순위와 검증 가능 순서로 승인 대기열을 따로 둡니다.

    셋째는 완료 기준을 산출물 존재가 아니라 승인 가능한 상태로 바꾸는 것입니다. 원문에서는 관리자가 빠른 프로토타입 데모를 한 달 안에 안정적인 운영 시스템으로 전환할 수 있다고 기대하는 현실성이 지적됐습니다. 데모 성공, 경계 조건 검증, 실제 데이터 재현, 오류 처리, 승인 절차가 각각 다른 체크포인트가 되어야 합니다.

    운영 기록을 만드는 간단한 방법

    별도 서비스 구축 전에 팀 저장소의 작업 기록만으로도 시작할 수 있습니다. 아래 구성에서는 표준 입력으로 받은 작업별 완료 시각과 단계별 소요 시간을 계산할 수 있습니다. 아래 예시는 개념 이해를 위한 표준 명령 구성이며 특정 제품의 공식 설정이 아닙니다.

    printf '%s\n' '{"task":"review","generated_minutes":30,"verified_minutes":90,"rework_minutes":20,"approved":true}' | jq '{task, total_minutes: (.generated_minutes +.verified_minutes +.rework_minutes), approved}'

    이 기록을 주간 단위로 합산하면 어느 단계가 병목인지 드러납니다. 검증 시간이 생성 시간을 계속 압도한다면 자동화를 확대하기보다 검증 체크리스트와 승인 권한부터 정리해야 합니다. 숫자는 평가의 근거가 되지만 개인별 성과 평가용으로 바로 사용하면 형식적 기록이 되므로 별도의 운영 지표로 다뤄야 합니다.

    구조적 기대치를 바꾸는 소통

    담당자가 마모되는 동안 감정적으로 저항하는 것만으로는 보호막이 되지 않습니다. 요청마다 예상 처리량, 검증 시간, 선행 작업을 포함한 실제 소요 시간을 기록해 요청자와 공유해야 합니다. 동시에 처리할 수 없는 작업을 명시적으로 남기는 방식은 감정 호소보다 훨씬 명확한 조정 근거가 됩니다.

    이 문제는 원문 스레드에 담긴 불만이 job security를 위협받는 분위기, 즉각적인 밀어내기 어려움과 맞물려 더 복잡해집니다. layoffs 경쟁을 두려워한 방식으로는 개인의 집중 시간을 지키기가 어렵습니다. 조직이 AI 업무 번아웃을 관리하지 않으면 생산성 개선으로 도입된 도구가 결국 핵심 인력을 소모합니다.

    실무 적용의 한계와 안티패턴

    큐를 세우더라도 검증 단계에 사람이 부족하면 승인 대기만 늘어납니다. 자동화 범위를 넓히면 유지보수와 재작업 비용이 숨은 과제로 남습니다. 또한 사람 검토 업무를 단순히 남겨 둔 채 생성량만 늘리면 곤란한 부분만 사람에게 몰립니다.

    가장 흔한 안티패턴은 AI 출력량을 업무 처리량으로 오인하는 것, 검증 없이 여러 결과를 병렬 생성하는 것, 짧은 데모를 운영 범위로 착각하는 것입니다. 또 모든 개선 요청을 개인의 생산성 문제로 흡수하면 구조적 문제는 숨겨진 채 사람의 휴식 시간만 줄어듭니다. 자동화의 목표는 사람에게 더 많은 일을 넘기는 것이 아니라 검증 가능한 완료까지 이어지는 흐름을 만드는 데 있어야 합니다.

    이번 주의 AI 업무를 생성, 검증, 재작업, 승인 단계로 나누어 각 단계의 소요 시간을 기록하는 데서 적용을 시작할 수 있습니다. 동시에 처리할 AI 작업 수는 팀의 집중 가능 범위에 맞춰 제한하고, 작업 큐와 승인 큐를 분리합니다. 반복 업무와 사람의 최종 판단이 필요한 업무를 구분한 뒤, 요청 우선순위와 예상 검증 시간을 함께 공유해 조정 가능한 범위를 합의하는 것이 중요합니다.

    실무 적용 포인트

    • 관련 팀과의 조율 및 승인 경로 확인
    • 격리된 환경에서 사전 영향도 테스트
    • 단계적 롤아웃과 비상 롤백 계획 수립

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/cscareerquestions — Is anyone else beyond burnt out from AI-driven hyper-expectations?

  • korea-data-mcp, 한국 공공 API 오독 막는 MCP 서버 공개

    korea-data-mcp, 한국 공공 API 오독 막는 MCP 서버 공개

    AI 에이전트용 korea-data-mcp가 공개됐다. 이 프로젝트는 DART, 공공데이터포털, 국가법령정보 API를 하나의 MCP 서버로 묶어 Claude와 Cursor 같은 에이전트가 한국 기업·부동산·법령 데이터를 정확히 조회하도록 지원하는 것을 목표로 한다.

    공공 API 응답에 숨어 있던 오독 함정

    공공 API 응답을 AI 에이전트에 그대로 전달하면 형식적으로는 그럴듯해 보여도 잘못된 답이 나오는 경우가 있다. 대표 사례는 DART 반기보고서다. 삼성전자 2025년 상반기 매출을 묻는 질문에 74.6조라는 답이 나올 수 있는데, thstrm_amount가 반기 누적이 아니라 2분기 3개월치이기 때문이다. 실제 상반기 누적 매출은 153.7조로 제시됐다.

    korea-data-mcp는 이런 문제를 서버 단계에서 처리하며, 현재 47개의 함정을 다루고 있다. 법령 조회에서는 현행 법령 본문에 아직 시행되지 않은 개정 조문이 섞이는 문제를 바로잡는다. 기준일에 시행 중인 버전을 고르고, 시행 예정 조문은 시행일과 함께 표시한다.

    아파트 실거래가에서는 해제된 계약이 정상 거래에 포함되는 문제를 막는다. 기본적으로 해당 계약을 제외한 뒤 중앙값을 계산한다. 행정구역 개편으로 옛 지역 코드를 입력하면 지난달 데이터가 0건으로 반환되는 문제도 처리하며, 변경된 코드를 안내한다. 그 밖의 입력 오류, 만원 단위 금액, 2자리 연도 날짜도 별도로 다룬다. 전체 목록은 저장소의 docs/QUIRKS.ko.md에 정리됐다.

    로컬 실행과 데이터 범위

    지원 범위는 DART 기업·공시·재무제표, 주가, 기업 기본정보, 사업자 상태 조회와 아파트 매매 실거래가, 공휴일, 법령·판례까지다. Claude Desktop에서는 릴리스에 포함된.mcpb 파일을 열면 설치되며, 공식 MCP Registry에도 등록됐다. 그 밖의 환경에서는 단일 Go 바이너리나 go install 방식이 지원된다.

    API 키는 사용자가 직접 발급한 무료 키를 사용한다. OpenDART 키 하나만 있어도 몇 분이면 시작할 수 있다. 서버는 개인 컴퓨터에서만 실행되며 제3자 서버나 텔레메트리를 사용하지 않는다. 키 발급 없이 URL만으로 이용할 수 있는 호스팅 버전은 준비 중이다.

    korea-data-mcp의 의미는 한국 공공 API를 AI 에이전트에 연결하는 데서 한 단계 나아간다는 데 있다. 원시 응답을 보여주는 대신 기간·계약 상태·행정구역·법령 시행 시점처럼 오답을 만드는 조건을 서버가 선별하는 방식이다. 개발자는 다음 데이터로 한국은행 ECOS와 KOSIS 등을 검토하고 있으며, 관련 의견을 모으고 있다. 자세한 내용은 GitHub 저장소에서 확인할 수 있다.