
핵심 요약
- 공개 규모: 375B-A23B, 36B-A4B, 32B, 7B, 3.7B, 0.9B 등 6개 모델을 모두 Apache 2.0으로 허깅페이스에 동시 배포 (0.9B는 더 작은 어휘 사용)
- 오픈스택 동봉: 모델 가중치 외에 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 공개 — IFM은 이를 ‘AI 역사상 가장 큰 완전 오픈소스 출시’로 표현
- 학습 데이터: 6개 모델 모두 약 20조 토큰으로 사전학습, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰이 합성 데이터
오픈소스 거대언어모델의 풀스택 공개가 기술·라이선싱·상용화 측면에서 갖는 의미를 분석하고, 동일 아키텍처를 0.9B에서 375B까지 일관되게 운용할 수 있다는 점이 실무에 주는 함의를 짚는 분석형 기사
목차
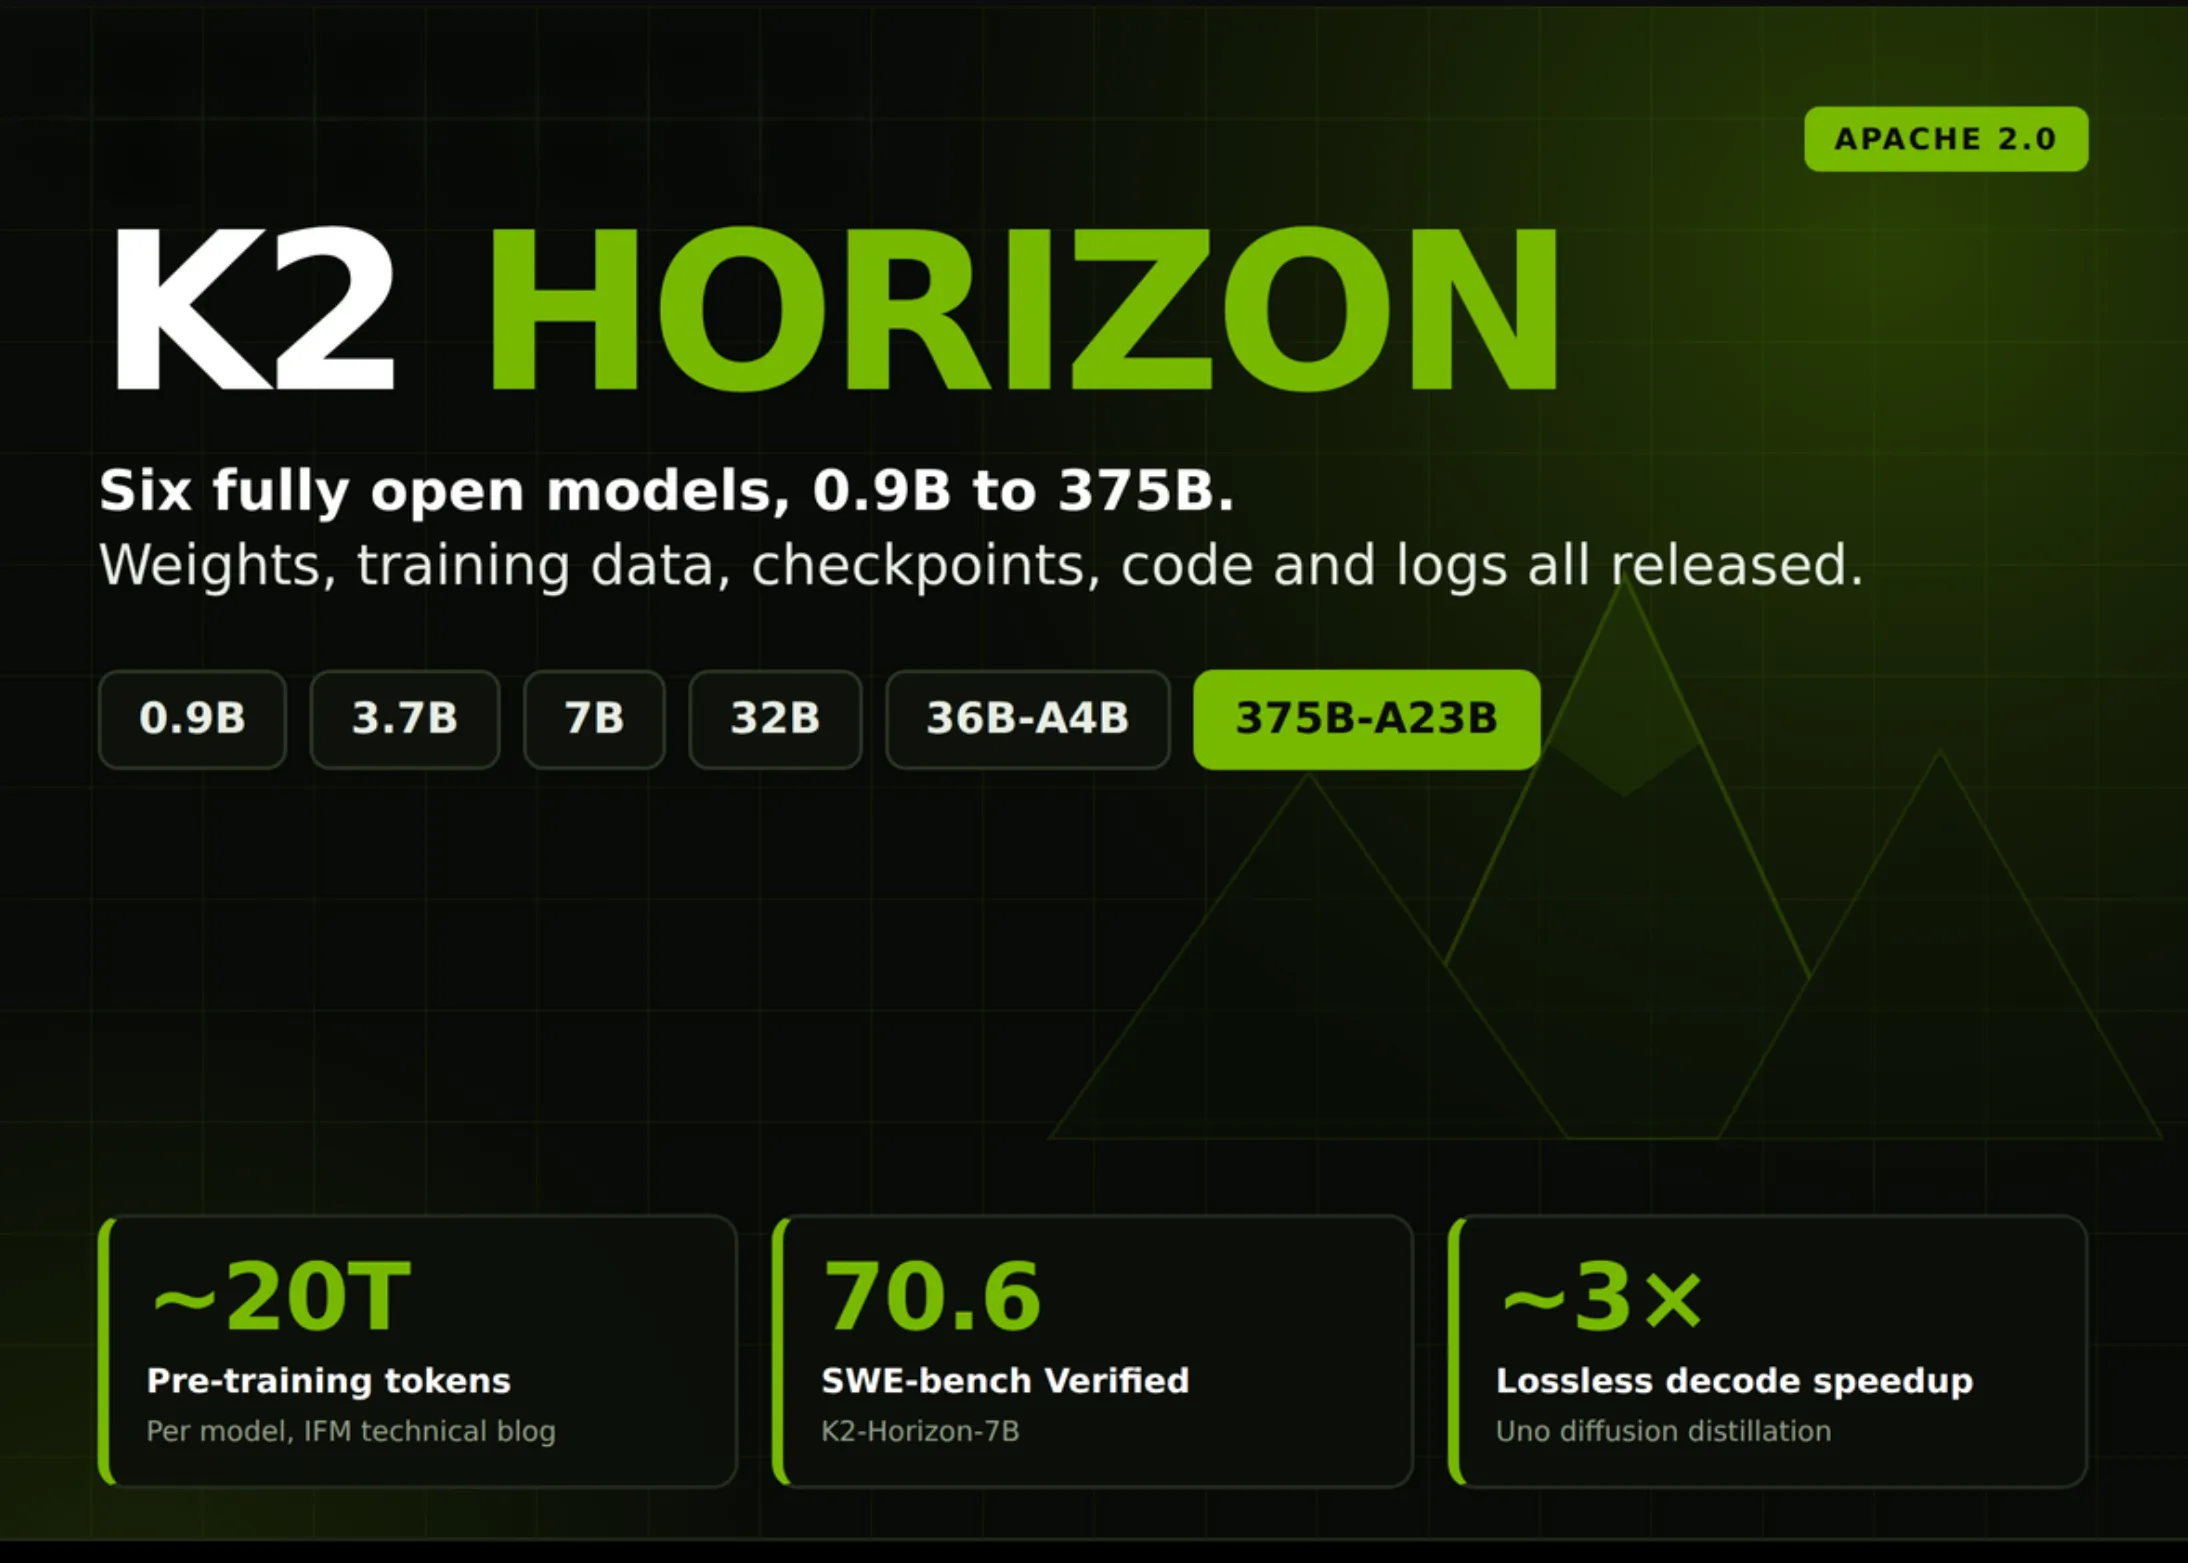
K2 호라이즌이 0.9B에서 375B까지 여섯 개 모델을 같은 날 Apache 2.0으로 풀어낸 사건은, 오픈소스 거대언어모델의 풀스택 공개가 어떤 의미를 갖는지를 다시 묻게 만든다. MBZUAI 산하 재단모델 연구소(IFM)가 2026년 9월 공개한 묶음은 가중치뿐 아니라 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 출하되는 ‘플릿(fleet)’ 형식이다.
필자가 보기에 이 발표의 핵심은 모델 크기나 벤치마크가 아니라 공개 범위다. 0.9B 모델이 더 작은 어휘를 쓴다는 점까지 명시된 것은, 같은 학습 파이프라인을 스케일만 바꿔 반복할 수 있다는 뜻이다. 실무에서 사이즈별로 동일한 인터페이스를 그대로 쓸 수 있다는 점은 통합 운영의 전제가 된다.
K2 호라이즌 라인업: 0.9B부터 375B-A23B까지
라인업은 여섯 개 모델로 나뉜다. 0.9B는 축소 어휘, 3.7B·7B·32B는 dense, 36B-A4B와 375B-A23B는 MoE 구성이다. 모든 모델이 동일 토크나이저와 도구 호출 인터페이스를 공유하기 때문에, 같은 코드를 모델 식별자만 바꿔 운용할 수 있다.
| 모델 | 총 파라미터 | 활성 | 유형 |
|---|---|---|---|
| 0.9B | 0.9B | 0.9B | 축소 어휘 dense |
| 3.7B | 3.7B | 3.7B | 로컬 추론용 dense |
| 7B | 7B | 7B | 범용 dense |
| 32B | 32B | 32B | 고품질 생성 dense |
| 36B-A4B | 36B | 4B | MoVA MoE |
| 375B-A23B | 375B | 23B | 플래그십 MoE |
K2 호라이즌 여섯 모델이 같은 합성 태스크 생성기를 거치고, 같은 추론 트레이스 비율(약 17%)로 학습됐다는 점에서 데이터 정렬이 라인업 전체에 일관되게 적용된다. 0.9B에서 검증한 프롬프트 포맷을 375B-A23B로 이식해도 동작이 크게 깨지지 않을 가능성이 높다.
K2 호라이즌이 가져온 오픈스택의 범위
IFM은 “AI 역사상 가장 큰 완전 오픈소스 출시”라는 표현을 썼다. K2 호라이즌 배포 묶음에는 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그가 모두 포함된다. 다른 오픈소스 프로젝트가 가중치와 추론 코드 정도만 내놓는 것과 비교하면 범위가 한 단계 다르다.
중간 체크포인트 공개는 재현성과 직접 연결된다. 375B-A23B를 처음부터 재학습하기는 어렵지만, 중간 단계에서 fine-tuning을 이어 붙이거나 ablation을 시도할 수 있다. 합성 데이터 비율이나 추론 트레이스 비율을 바꿔가며 실험할 표면이 확보된 셈이다.
학습 데이터 설계: 20조 토큰, 1억+ 태스크
여섯 모델 모두 약 20조 토큰으로 사전학습됐고, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰은 합성 데이터다. 연구팀은 1억 개 이상의 고유 합성 태스크를 생성했고, 미들 트레이닝 단계에서 포스트 트레이닝 데이터를 점진 반영했다.
실무자가 주목할 지점은 합성 태스크의 규모다. 필자가 본 가장 흥미로운 수치이기도 하다. 1억 개는 사람이 손으로 설계할 수 있는 범위를 한참 넘는다. 도메인 태스크를 정의해 모델에 주입하는 게 아니라, 태스크 생성 자체를 모델이 맡고 인간이 큐레이션하는 구조로 이동한 것이다. 36B-A4B와 7B 사이의 성능 격차를 따질 때 이 1억 태스크의 분포가 결정 변수가 된다.
MoVA: 어텐션으로 확장한 MoE의 두 번째 축
K2 호라이즌 라인업 중 36B-A4B는 MoVA(Mixture-of-Value Attention)를 적용했다. MoE가 피드포워드에서 전문가 라우팅으로 확장 축을 만들었다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합해 어텐션 차원의 두 번째 확장 축을 추가한 것이다. FlashAttention·GQA·sparse attention과 호환되어 기존 서빙 스택을 크게 뜯지 않고 쓸 수 있다.
MoVA가 흥미로운 이유는 MoE의 파라미터 효율을 한 단계 더 밀어붙일 수 있기 때문이다. K2 호라이즌 상위 라인업이 모두 MoVA로 수렴할지, dense와 MoVA가 공존할지는 지켜볼 지점이다.
도구 호출 포맷: Markdown의 18.5% 토큰 효율 우위
IFM은 JSON·XML·Markdown 세 포맷으로 도구 정의를 학습시키고, 추론 기본값을 Markdown으로 설정했다. 측정 결과 Markdown은 JSON 대비 약 18.5% 더 적은 토큰을 사용한다. 같은 결과를 더 적은 토큰으로 만든다는 것은 곧 latency와 비용의 직접적 감소다.
도구 정의가 길어질수록 Markdown 우위는 커진다. 30~50개 도구를 동시에 노출하는 에이전트는 흔하고, 이 경우 18.5%는 단순한 최적화가 아니라 아키텍처 선택에 가깝다. K2 호라이즌으로 도구 호출 시스템을 설계할 때는 별도 라우터보다 모델이 직접 Markdown 도구 정의를 읽고 호출하게 두는 편이 단순하다.
서빙 생태계: vLLM·SGLang·Ollama 데이-0 지원
공개 당일 vLLM·SGLang·Ollama가 데이-0 지원을 받았고, FP8과 GGUF 빌드도 함께 제공된다. NVIDIA뿐 아니라 AMD와 Cerebras까지 대응 범위에 포함된다. IFM 공식 발표에 따르면 호스팅은 Compass, Cerebras, Nebius API와 platform.ifm.ai 게이트웨이로 나뉘며, 같은 가중치를 다양한 스택에서 즉시 시험할 수 있다. 배포 인프라 선택은 AI 칩 아키텍처별 데이터 이동 비용 관점에서 따져볼 만하다.
데이-0 서빙 지원은 발표의 ‘신호’다. 새 모델은 보통 커뮤니티 패치 후 안정화되는데, K2 호라이즌은 출하 시점에 이미 세 추론 엔진에서 동작한다. 이는 IFM이 오픈소스 모델을 ‘스택’으로 출시한다는 전략적 선택을 보여준다.
실무 적용 포인트
사이즈 선택은 호출 빈도와 응답 지연 허용치에 따라 갈린다. 0.9B·3.7B는 분류·라우팅·간단 변환에, 7B는 범용 추론, 32B는 고품질 생성·요약에 배치하는 편이 자원 대비 효율이 좋다. 36B-A4B는 토큰당 4B 활성이라는 점을 활용해 에이전트 라우터나 다중 도구 호출 워크로드에 적합하다. 375B-A23B는 운영비 부담이 크므로 0.9B에서 프롬프트와 도구 정형을 먼저 검증한 뒤 점진적으로 끌어올리는 방식이 안전하다.
지금 바로 해볼 것
- Hugging Face에서 K2 호라이즌 0.9B 또는 3.7B 가중치를 받아 vLLM으로 로컬 서빙을 띄워보세요.
- 동일한 도구 정의를 JSON과 Markdown 포맷으로 각각 작성해 토큰 수와 응답 시간을 비교 측정하세요.
- 36B-A4B를 받아 MoVA 라우팅이 활성화된 상태에서 다중 도구 호출 시나리오 5개 이상을 실행해보세요.
- 사전학습 코퍼스 메타데이터에서 합성 태스크 분포를 확인해 사내 도메인 태스크와 가장 가까운 클러스터를 골라 fine-tuning을 시작하세요.
자주 묻는 질문
K2 호라이즌 0.9B 모델은 왜 어휘 사전이 다른가?
엣지 디바이스 타깃 모델이기 때문에 어휘 사전을 줄여 메모리 사용량을 낮췄다. 동일한 학습 파이프라인을 거치지만 추론 환경에 맞춘 축소 어휘를 채택했다.
Apache 2.0 라이선스로 상용화 가능한가?
가중치·코드·데이터 모두 Apache 2.0으로 공개됐기 때문에 상용 서비스에 그대로 사용할 수 있다. 단, 재배포 시 동일 라이선스 표기 조건은 지켜야 한다.
MoVA는 기존 MoE와 어떻게 다른가?
MoE가 피드포워드에서 전문가를 라우팅한다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합한다. FlashAttention·GQA·sparse attention과 호환되는 것이 특징이다.
Markdown 도구 호출이 JSON보다 18.5% 효율인 이유는?
Markdown이 중괄호·따옴표·태그 같은 메타문자가 적기 때문에 동일 의미에 더 적은 토큰이 쓰인다. 도구 정의가 길어질수록 우위는 커진다.
K2 호라이즌의 공개가 던지는 질문은 단순히 ‘또 다른 오픈소스 모델 출시인가’가 아니다. 같은 파이프라인으로 0.9B부터 375B까지 일관 운용되는 플릿이 Apache 2.0으로 풀려나갔다는 사실은, 오픈소스 LLM 경쟁의 축이 가중치에서 데이터·코드·중간 상태를 포함한 ‘스택’으로 이동했음을 보여준다. 이 변화가 어떤 라이선싱 표준을 만들고, 상용 벤더들이 어떻게 대응할지는 앞으로 몇 분기 동안 판가름될 지점이다.
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — IFM Releases K2 Horizon: Six Apache 2.0 Models From 0.9B to 375B
답글 남기기