
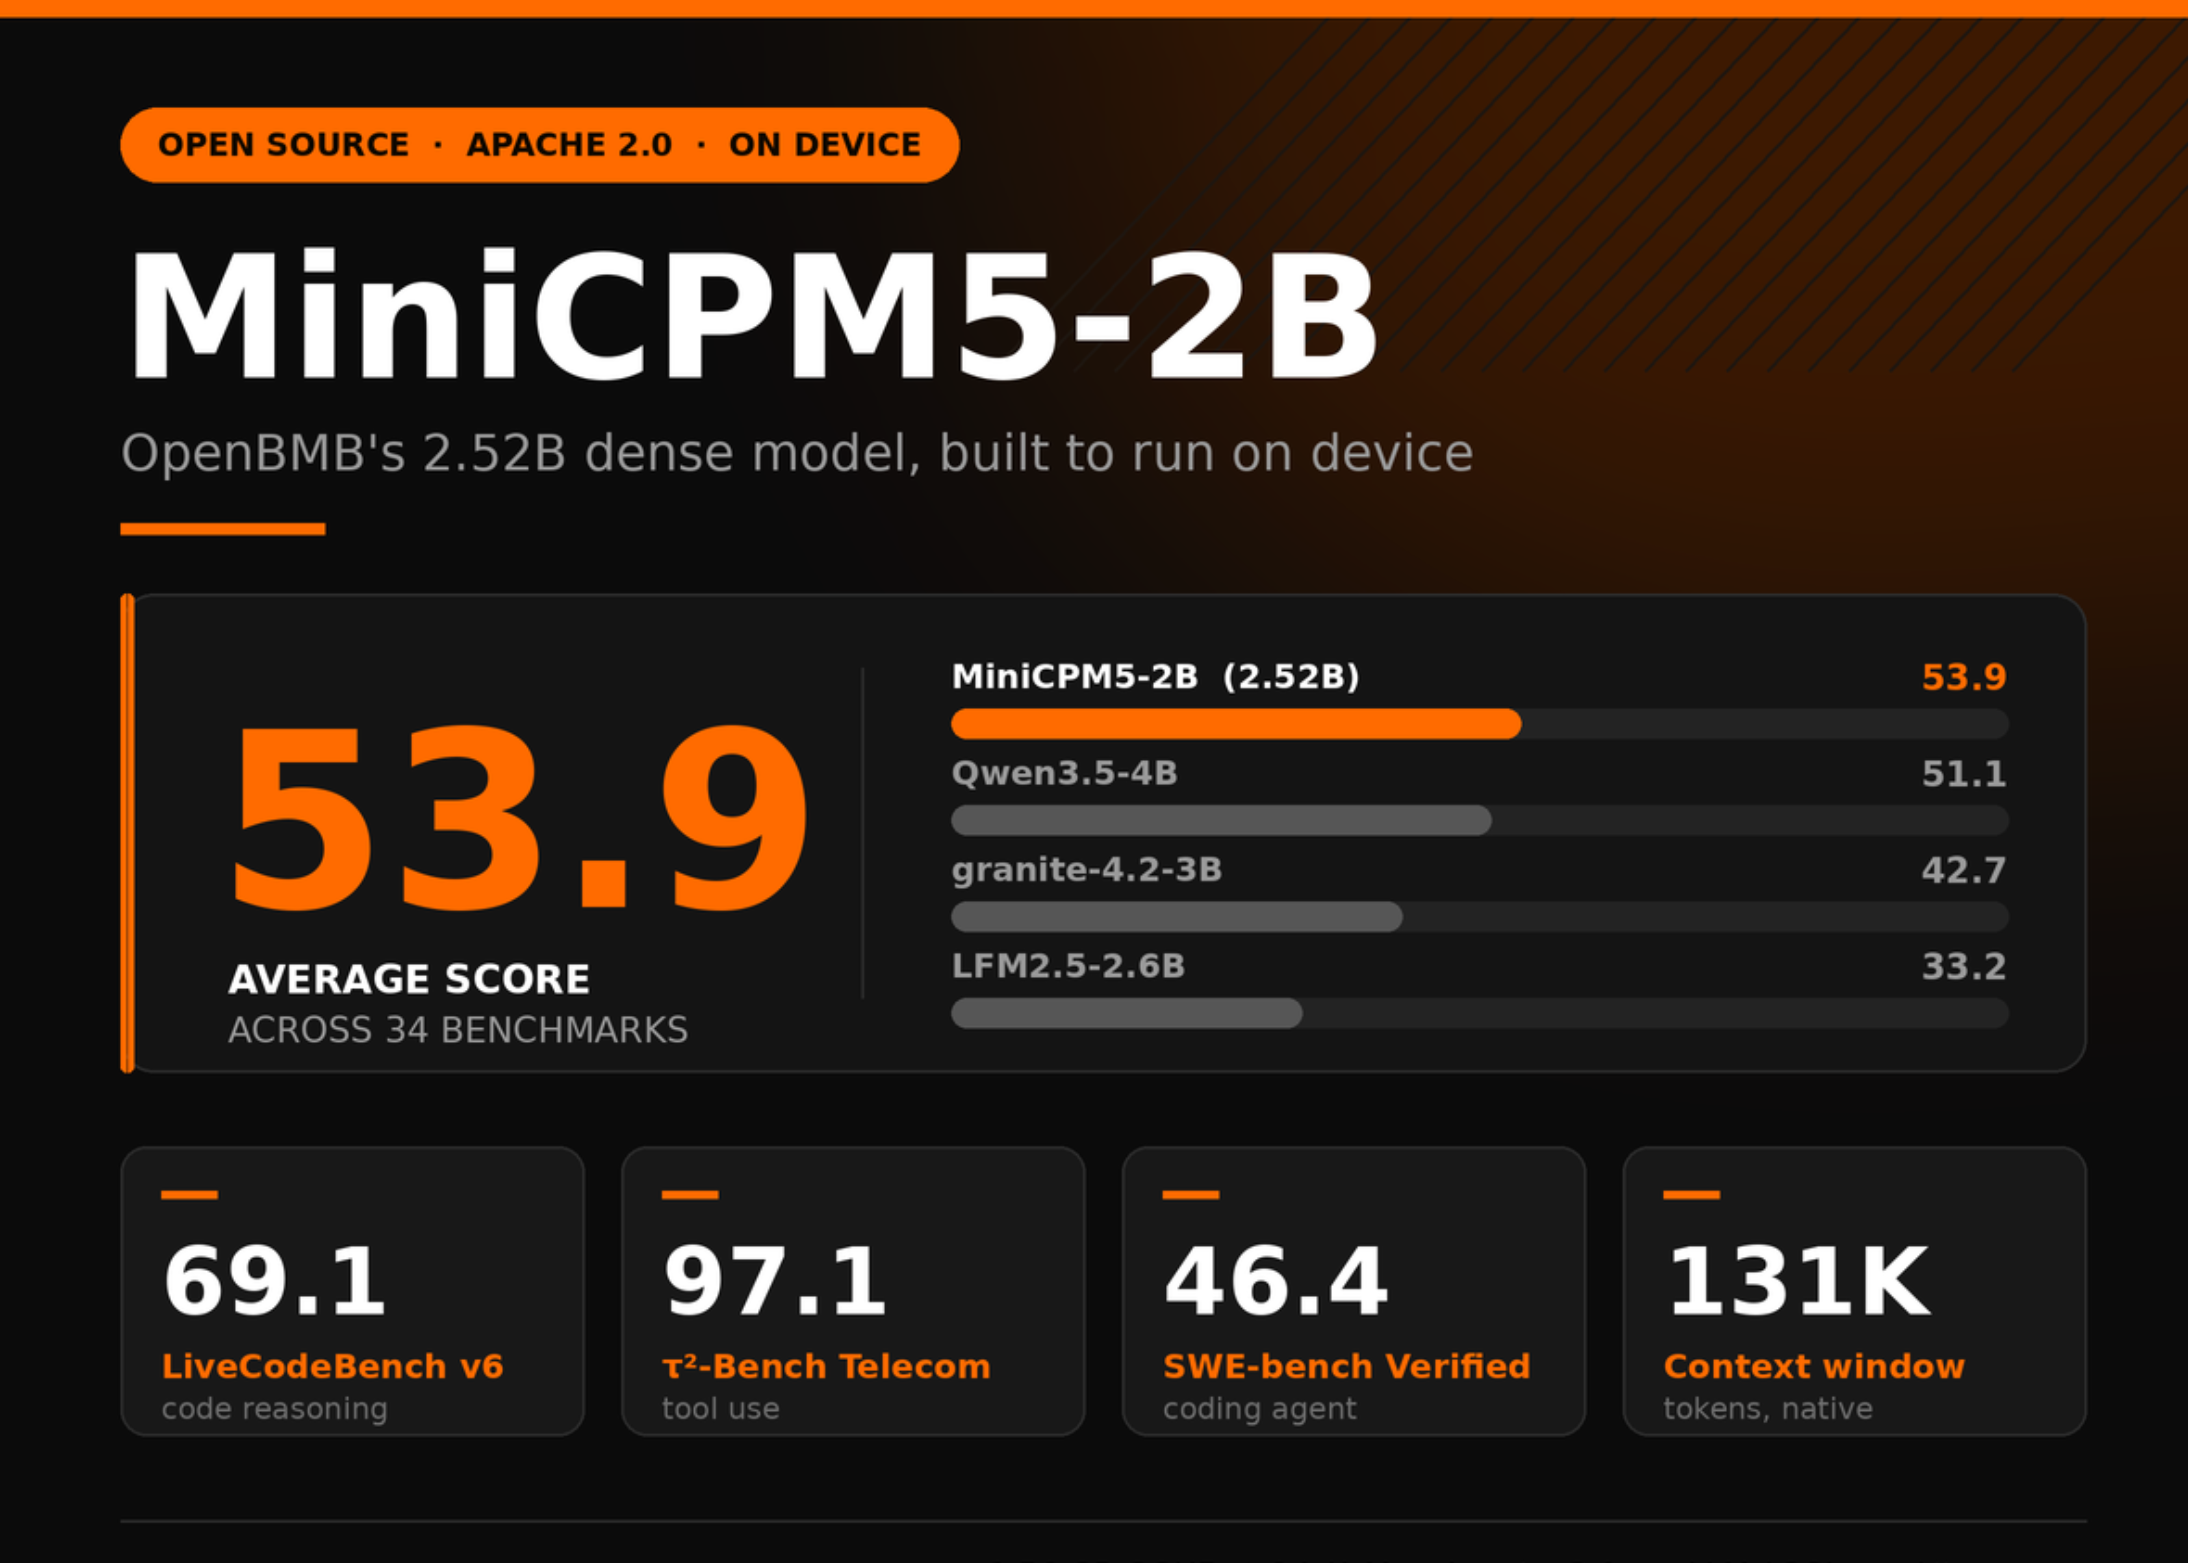
핵심 요약
- MiniCPM5-2B는 2,516,756,480개 파라미터(임베딩 제외 1,981,982,720개)를 가진 dense causal language model로, 42개 레이어와 grouped-query attention(query 16 head, key/value 2 head)을 채택했다.
- 네이티브 컨텍스트 윈도우는 131,072 토큰이며, 아키텍처가 표준 LlamaForCausalLM이라 vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS에서 커스텀 커널이나 모델 코드 포크 없이 동작한다.
- 라이선스는 Apache 2.0이고, 같은 크기급 비교 대상으로 LFM2.5-2.6B·Qwen3.5-2B·Gemma-4-E2B-it가, 레퍼런스로 Qwen3.5-4B(51.1)·granite-4.2-3B(42.7)·LFM2.5-2.6B(33.2) 등이 제시된다.
분석
목차
미니CPM5-2B는 2,516,756,480개 파라미터에 네이티브 컨텍스트 윈도우 131,072 토큰이라는 스펙으로 9월 7일 모습을 드러냈다. 34개 벤치마크 평균 53.9점은 같은 라인업 베이스라인 최고 점수인 Qwen3.5-4B의 51.1을 2.8점 앞서는 수치다. 파라미터 수는 절반이 채 안 되는데 종합 점수는 더 높다. 필자 입장에서 이 모델의 진짜 의미는 “작다고 못 함”을 숫자로 입증한 데 있다.
미니CPM5-2B 아키텍처: 표준 Llama 포크라 8개 추론 엔진 즉시 호환
미니CPM5-2B는 42개 레이어에 grouped-query attention(query 16 head, key/value 2 head)을 채택한 dense causal language model이다. 임베딩을 제외하면 1,981,982,720개 파라미터다. 핵심은 아키텍처가 표준 LlamaForCausalLM이라는 점이다. vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS까지 8개 추론 엔진이 커스텀 커널이나 모델 코드 포크 없이 그대로 동작한다. Apache 2.0 라이선스까지 얹혔으니, 2~3B급 모델을 실서비스에 올리려던 팀에게는 가장 마찰이 적은 옵션 중 하나가 됐다.
미니CPM5-2B, 34개 벤치마크 평균 53.9의 의미
단일 점수 53.9만 봐서는 감이 안 잡힌다. 분야별로 쪼개 보면 미니CPM5-2B의 성격이 또렷해진다. 같은 크기급 비교 대상으로 LFM2.5-2.6B, Qwen3.5-2B, Gemma-4-E2B-it가, 레퍼런스로는 Qwen3.5-4B(51.1), granite-4.2-3B(42.7), LFM2.5-2.6B(33.2) 등이 제시됐다. 종합 53.9는 이 레퍼런스 풀 안에서 가장 높은 수치다.
| 벤치마크 | 미니CPM5-2B | 베이스라인 최고 | 격차 |
|---|---|---|---|
| 34개 종합 평균 | 53.9 | Qwen3.5-4B 51.1 | +2.8 |
| LiveCodeBench v6 | 69.1 | 56.4 | +12.7 |
| SWE-bench Verified | 46.4 | 33.6 | +12.8 |
| τ²-Bench Telecom | 97.1 | — | — |
| BFCL v4 | 66.6 | — | — |
| τ³-Bench Banking | 20.8 | 6.8 | +14.0 |
| NoLiMa | 68.1 | 43.5 | +24.6 |
| AA-LCR | 59.0 | 61.0 | −2.0 |
| LongBench v2 | 43.7 | 47.3 | −3.6 |
| MMLU-Pro | 70.8 | 78.0 | −7.2 |
| Humanity’s Last Exam | 8.9 | 9.9 | −1.0 |
강점: 코드 추론과 도구 사용에서 베이스라인을 압도
격차가 가장 큰 영역은 코드다. LiveCodeBench v6에서 69.1을 찍었고, SWE-bench Verified에서는 46.4로 베이스라인 33.6을 12.8점 차로 제쳤다. 2.5B 모델이 SWE-bench에서 46.4라는 건 단순 코드 완성이 아니라 multi-turn 디버깅까지 포함된 작업에서 절반 가까운 정답률을 내놨다는 의미다.
도구 사용은 더 가파르다. τ²-Bench Telecom 97.1은 사실상 만점에 가깝고, BFCL v4 66.6, τ³-Bench Banking 20.8(베이스라인 6.8)도 함수 호출과 라우팅이 2.5B급에서 기대할 수 있는 수준을 한참 넘었다. 미니CPM5-2B가 에이전트 워크로드에 실제로 쓸 만한 후보라는 건 이 숫자들이 가장 직접적으로 말해준다.
균형점: 장문 컨텍스트 항목별 편차와 일반 지식 한계
모든 항목에서 앞서진 않는다. 장문 컨텍스트는 항목별로 결과가 갈린다. NoLiMa 68.1(베이스라인 43.5)에서는 24.6점 차로 우세하지만, AA-LCR 59.0(61.0)과 LongBench v2 43.7(47.3)에서는 오히려 밀린다. 131K 토큰 윈도우를 갖췄어도 실측 정확도에서 베이스라인을 못 따라가는 구간이 있다는 뜻이다.
일반 지식도 비슷한 양상이다. MMLU-Pro 70.8(78.0), Humanity’s Last Exam 8.9(9.9) 모두 소폭 열세다. 파라미터가 절반에 가까운 모델이 광범위 사실 회상에서 4B급을 이길 수 없는 건 자연스러우니, 미니CPM5-2B를 “올라운더”가 아니라 “코딩·에이전트 특화 경량 모델”로 보는 편이 정확하다.
학습 파이프라인: UltraData → 400B SFT → JustRL II → 16 expert 증류
성적의 배경에는 단계별 학습 설계가 깔려 있다. base 학습은 UltraData 계층형 데이터 관리로 stable·decay 두 단계로 돌아갔고, mid-training 이후 400B 토큰 규모의 deep-thinking SFT가 진행됐다. RL 단계는 math·code·agentic·writing 네 영역을 따로 두고 JustRL II라는 critic 기반 teacher가 학습을 이끌었다. 마지막에 16개 전문가 모델을 단일 체크포인트로 합치는 on-policy distillation까지 붙는다.
모델 카드는 Artificial Analysis 출처 행과 내부 재현 행을 분리 표기해 평가 일관성 이슈를 미리 명시했다. 재현 가능성을 의식한 흔적이다.
지금 바로 해볼 것
- Ollama 또는 llama.cpp로 미니CPM5-2B를 내려받아 Mac·RTX 3090 단일 GPU에서 추론 latency를 직접 측정한다.
- 내 도메인 코딩 문제 30개를 골라 multi-turn 디버깅을 시켜본 뒤 Qwen3.5-2B·Gemma-4-E2B-it와 응답 품질을 비교한다.
- BFCL 스타일 함수 호출 시나리오 10개를 만들어 tool-use 정확도를 사내 데이터 기준으로 재평가한다.
- 131K 컨텍스트에 5만 토큰 분량의 사내 문서를 넣고 검색·요약 정확도를 NoLiMa·AA-LCR·LongBench 항목처럼 직접 점검한다.
- Apache 2.0 적용 범위를 법무팀과 한 번 확인하고, 사내 파인튜닝 데이터에 대한 라이선스 리스크가 없는지 점검한다.
실무 적용 포인트
- 2~3B급을 평가할 때 종합 평균 한 점만 보지 말고 LiveCodeBench·SWE-bench·BFCL 같은 도메인 벤치마크를 가중치에 반영한다.
- 에이전트 워크로드에 미니CPM5-2B를 쓰려면 함수 호출 라우팅을 별도 검증한다. τ²-Bench 97.1이 일반화 가능한 수치라고 단정하면 안 된다.
- 장문 컨텍스트가 핵심이면 131K 윈도우 자체보다 AA-LCR·LongBench 같은 실측 항목 점수를 기준으로 모델을 가른다.
- 온디바이스 배포 시 grouped-query attention의 key/value 2 head 구성 때문에 attention cache 메모리는 작지만 batch throughput은 떨어질 수 있으니 시나리오별로 측정한다.
- 라이선스 검증이 끝났다면 vLLM·SGLang으로 1차 베이스라인을 띄우고, 부족한 영역은 JustRL II 식 RL 파인튜닝으로 보강하는 순서가 현실적이다.
자주 묻는 질문
미니CPM5-2B는 상업 프로젝트에 바로 쓸 수 있나요?
Apache 2.0 라이선스라 상업적 사용과 2차 배포 모두 허용된다. 다만 모델 출력에 대한 책임은 사용자에게 있으니, 도메인 평가 후 도입 여부를 결정하는 편이 안전하다.
2.5B 모델이 Qwen3.5-4B보다 점수가 높은데 정말 쓸 만한가요?
34개 평균 53.9는 사실이다. 다만 우위는 코드와 도구 사용에 집중돼 있고 MMLU-Pro 같은 일반 지식에서는 7점 이상 밀린다. 평가 가중치를 도메인에 맞춰 다시 매겨야 한다.
미니CPM5-2B는 온디바이스에서 실제로 돌아가나요?
표준 LlamaForCausalLM 아키텍처라 llama.cpp, Ollama, LM Studio, MLX에서 그대로 실행된다. 다만 131K 컨텍스트 전체를 모바일에서 쓰기보다 8K~32K로 잘라 쓰는 게 현실적이다.
기존 MiniCPM 모델에서 마이그레이션해야 할 이유가 있나요?
이전 세대 대비 컨텍스트 윈도우와 코드·에이전트 점수가 동시에 끌어올려졌다. 신규 프로젝트라면 미니CPM5-2B로 시작하되, 기존 시스템은 토큰 사용량과 응답 latency를 비교한 뒤 단계적으로 옮기는 편이 낫다.
원문 자료는 마크테크포스트의 MiniCPM5-2B 보도에서 확인했다. 비교군 정보는 같은 매체의 IFM K2 Horizon 출시 기사를 참고했다.
답글 남기기