[카테고리:] AI & 오픈소스

  • bunny.net, 공급업체 서버 관련 무단 접근 통제…TLS 인증서 재발급

    bunny.net, 공급업체 서버 관련 무단 접근 통제…TLS 인증서 재발급

    bunny.net은 인프라 공급업체에서 발생한 서드파티 서버 관리 소프트웨어 무단 접근에 대응해 아르메니아 소재 CDN 노드를 격리하고, 노출 가능성에 대비한 TLS 인증서 재발급을 순차적으로 진행했다. 이번 CDN 보안 사고에서는 경고 뒤 20분 이내에 해당 서버로 향하는 트래픽 라우팅을 중단했으며, 서버 데이터 삭제와 접근 권한 철회까지 이어졌다. 양측 조사에서 bunny.net 서버나 데이터에 대한 무단 접근 증거는 나오지 않았지만, 사고가 발생하지 않았다는 결론으로 단정하기 어려운 상태다.

    공급망 경계에서 드러난 공격 표면

    무단 접근 사실을 알린 곳은 bunny.net의 인프라 공급업체 한 곳이며, 최초 공지 기준 전주에 서드파티 서버 관리 소프트웨어 관련 접근 경고가 전달됐다. 문제가 발생한 서버에서는 아르메니아 소재 CDN 노드 하나가 운영되고 있었다. bunny.net 엔지니어링팀은 경고를 받은 뒤 20분 이내에 트래픽 라우팅을 중단했고, 서버 데이터를 안전하게 삭제한 뒤 다른 시스템에 대한 접근 권한도 철회했다.

    CDN 보안 사고의 영향 범위는 서버에 저장된 자산에 따라 달라진다. 해당 노드에 접근이 있었다면 일시적으로 캐시된 CDN 콘텐츠, Pull Zone 설정, 서버에 보관된 TLS 인증서가 노출됐을 수 있다. 다른 고객 데이터와 bunny.net 계정 데이터는 해당 서버에 저장돼 있지 않았고 내부 시스템도 영향을 받지 않은 것으로 확인됐다. bunny.net은 공급업체와 함께 인프라를 면밀히 모니터링하며 조사를 이어가고 있다.

    인증서 교체와 고객별 대응 차이

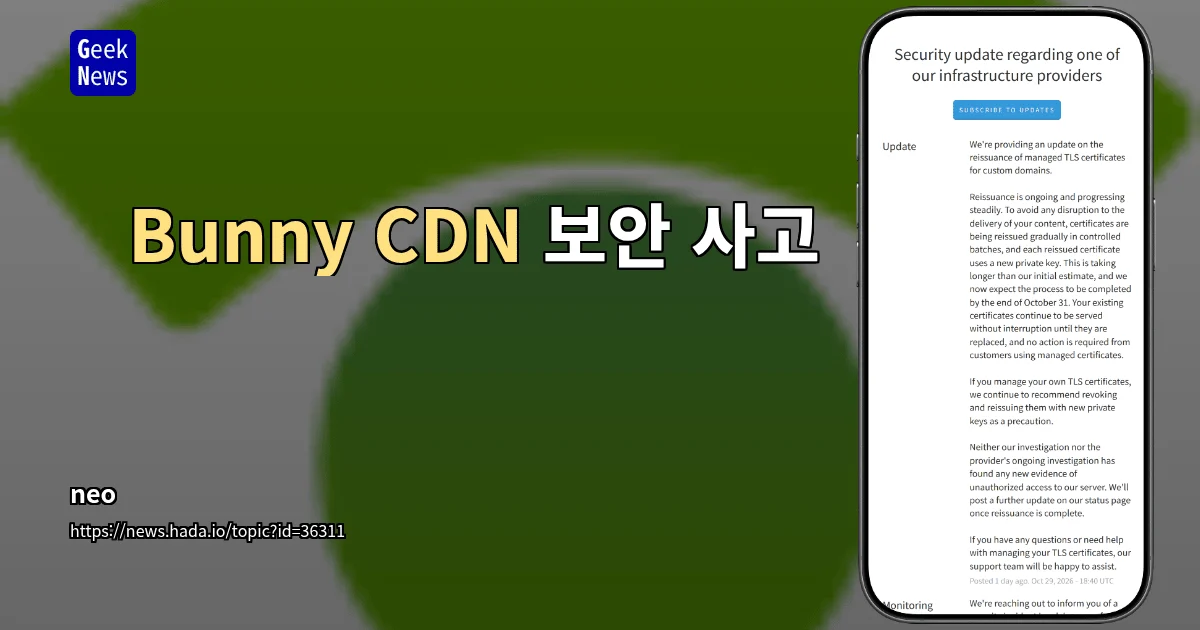
    preventative bunny.net은 플랫폼 도메인 b-cdn.net과 bunny.run의 모든 TLS 인증서를 폐기하고 재발급했다. 사용자 지정 도메인의 관리형 인증서도 교체 작업 중이며, 콘텐츠 전송 중단을 막기 위해 통제된 배치 단위로 점진적으로 처리한다. 새 인증서에는 새 개인 키가 적용되고, 교체 전까지 기존 인증서는 중단 없이 제공된다.

    작업 일정은 당초 24시간 이내 완료로 예고됐지만, 최신 업데이트에서는 초기 예상보다 시간이 걸려 10월 31일 말까지 마무리될 것으로 제시됐다. 관리형 인증서를 이용하는 고객은 별도 조치가 필요하지 않다. 반대로 TLS 인증서를 직접 관리하는 고객은 예방 차원에서 기존 인증서를 폐기하고 새 개인 키로 재발급할 것을 권고받고 있다.

    접근 가능성에 대비한 공급망 보안

    이번 대응에서 핵심은 CDN 노드 하나를 단절한 데 그치지 않고, 인증서와 권한이라는 인접 자산까지 회수한 점이다. 조사 결과에 증거가 없다는 사실은 확정적인 침해 부인을 의미하지 않으며, 공급망에서 관리 소프트웨어가 침해되면 저장된 설정과 암호자격 증명이 함께 공격 표면에 놓일 수 있다는 점에 주목할 필요가 있다.

    상태 페이지에는 인증서 재발급이 완료될 때 추가 업데이트가 게시될 예정이며, 고객에게 영향을 미치는 새로운 사실이 확인되면 이메일로도 알릴 계획이다. bunny.net 보안 사고를 확인한 운영자는 자체 TLS 인증서 관리 방식을 먼저 점검하고, 직접 관리하는 인증서가 있다면 예전 키를 재사용하지 않은 새 인증서로 교체할 필요가 있다. 사건의 전체 흐름은 Bunny CDN 보안 사고 보도에서 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — Bunny CDN 보안 사고
  • korea-data-mcp, 한국 공공 API 오독 막는 MCP 서버 공개

    korea-data-mcp, 한국 공공 API 오독 막는 MCP 서버 공개

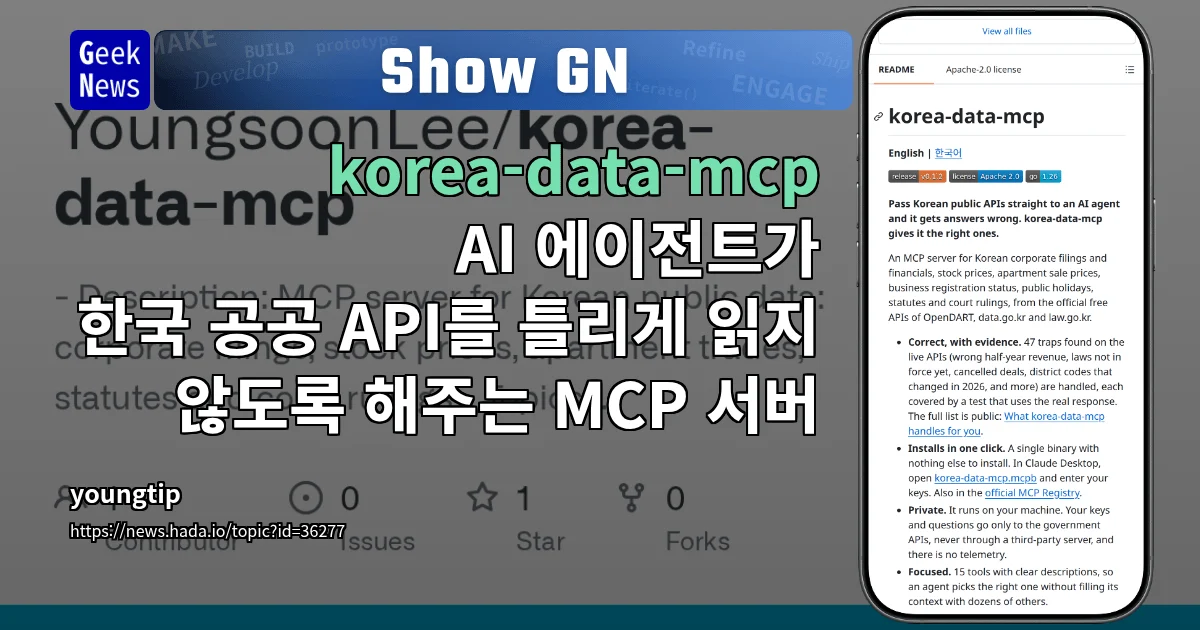
    AI 에이전트용 korea-data-mcp가 공개됐다. 이 프로젝트는 DART, 공공데이터포털, 국가법령정보 API를 하나의 MCP 서버로 묶어 Claude와 Cursor 같은 에이전트가 한국 기업·부동산·법령 데이터를 정확히 조회하도록 지원하는 것을 목표로 한다.

    공공 API 응답에 숨어 있던 오독 함정

    공공 API 응답을 AI 에이전트에 그대로 전달하면 형식적으로는 그럴듯해 보여도 잘못된 답이 나오는 경우가 있다. 대표 사례는 DART 반기보고서다. 삼성전자 2025년 상반기 매출을 묻는 질문에 74.6조라는 답이 나올 수 있는데, thstrm_amount가 반기 누적이 아니라 2분기 3개월치이기 때문이다. 실제 상반기 누적 매출은 153.7조로 제시됐다.

    korea-data-mcp는 이런 문제를 서버 단계에서 처리하며, 현재 47개의 함정을 다루고 있다. 법령 조회에서는 현행 법령 본문에 아직 시행되지 않은 개정 조문이 섞이는 문제를 바로잡는다. 기준일에 시행 중인 버전을 고르고, 시행 예정 조문은 시행일과 함께 표시한다.

    아파트 실거래가에서는 해제된 계약이 정상 거래에 포함되는 문제를 막는다. 기본적으로 해당 계약을 제외한 뒤 중앙값을 계산한다. 행정구역 개편으로 옛 지역 코드를 입력하면 지난달 데이터가 0건으로 반환되는 문제도 처리하며, 변경된 코드를 안내한다. 그 밖의 입력 오류, 만원 단위 금액, 2자리 연도 날짜도 별도로 다룬다. 전체 목록은 저장소의 docs/QUIRKS.ko.md에 정리됐다.

    로컬 실행과 데이터 범위

    지원 범위는 DART 기업·공시·재무제표, 주가, 기업 기본정보, 사업자 상태 조회와 아파트 매매 실거래가, 공휴일, 법령·판례까지다. Claude Desktop에서는 릴리스에 포함된.mcpb 파일을 열면 설치되며, 공식 MCP Registry에도 등록됐다. 그 밖의 환경에서는 단일 Go 바이너리나 go install 방식이 지원된다.

    API 키는 사용자가 직접 발급한 무료 키를 사용한다. OpenDART 키 하나만 있어도 몇 분이면 시작할 수 있다. 서버는 개인 컴퓨터에서만 실행되며 제3자 서버나 텔레메트리를 사용하지 않는다. 키 발급 없이 URL만으로 이용할 수 있는 호스팅 버전은 준비 중이다.

    korea-data-mcp의 의미는 한국 공공 API를 AI 에이전트에 연결하는 데서 한 단계 나아간다는 데 있다. 원시 응답을 보여주는 대신 기간·계약 상태·행정구역·법령 시행 시점처럼 오답을 만드는 조건을 서버가 선별하는 방식이다. 개발자는 다음 데이터로 한국은행 ECOS와 KOSIS 등을 검토하고 있으며, 관련 의견을 모으고 있다. 자세한 내용은 GitHub 저장소에서 확인할 수 있다.

  • 컨텍스트 엔지니어링의 현주소: 긴 컨텍스트 넘어 전략적 망각으로 설계하는 에이전트

    컨텍스트 엔지니어링의 현주소: 긴 컨텍스트 넘어 전략적 망각으로 설계하는 에이전트

    인공지능 에이전트의 성능을 좌우하는 요소를 한 문장으로 줄이면, 모델보다 현재 목표에 필요한 정보를 골라 전달하는 컨텍스트 엔지니어링에 가깝습니다. 결정론적 코드와 확률적 모델의 역할을 나누고, 오래된 상태를 주기적으로 버리는 방식이 긴 컨텍스트의 한계를 보완하는 대안으로 부상하고 있습니다.

    긴 컨텍스트가 만드는 네 가지 실패

    긴 컨텍스트 창은 정보량뿐 아니라 환각, 잘못된 사실과 상충하는 사례까지 함께 수용합니다. 잘못된 정보에 고착되는 컨텍스트 오염, 컨텍스트에 지나치게 집중하는 주의 분산, 현재 문제와 무관한 사실이 답에 영향을 주는 혼동, 도구와 스킬이 예기치 않게 충돌하는 컨텍스트 충돌이 그 결과로 나타납니다.

    Gemini 2.5의 Pokémon 플레이 실험에서는 구버전의 게임 규칙과 새버전의 과제가 함께 주어지자 모델이 오래된 목표를 여러 시간 추구했습니다. 기술 보고서의 부록에 따르면 컨텍스트가 10만 토큰을 상당히 넘은 구간에서는 새 계획을 세우기보다 과거 행동을 반복하기 시작했습니다.

    Carolina Camassa와 Derek Shiller의 ‘Do as I Say, Not as I Do’ 실험에서도 새 지시와 상충하는 대화 사례가 늘어날수록 모든 시험 모델의 원래 지시 준수율이 낮아졌습니다. Gemma 3 12B는 소수의 상충 사례만으로 준수율이 절반 아래로 내려갔고, Opus 4.6도 사례가 누적될수록 같은 문제가 나타났습니다.

    정보 보강부터 요약까지 여섯 가지 관리 기법

    컨텍스트 관리에는 RAG와 스킬로 필요한 정보를 보강하고, 요청에 적합한 도구만 노출해 과부하를 막는 도구 구성 선별이 포함됩니다. 한 기업에서는 소프트웨어 시작마다 엔지니어별로 600개 스킬을 로드해 성능 저하가 갑자기 발생했고, 도구 필터링이 필요했습니다. 하위 에이전트와 동료 에이전트를 빈 대화 이력으로 시작시키는 컨텍스트 격리는 다른 작업의 정보와 목표를 분리합니다.

    오래된 이력을 제거하는 가지치기, Markdown 파일이나 데이터베이스에 정보를 보관하는 외부 저장, 오래된 대화를 요약해 새 컨텍스트를 시작하는 요약까지 이어집니다. Claude Code와 Codex는 컨텍스트 압축의 초기 단계에서 불필요해진 도구 결과도 제거했습니다. 실무에서는 관련성을 먼저 평가해 이력을 줄인 뒤 요약하면 더 유용한 압축 결과를 얻을 수 있습니다.

    하네스로 옮겨 가는 컨텍스트 구성

    컨텍스트 엔지니어링은 프롬프트에서 시스템이 동적으로 컨텍스트를 조립하는 방식으로 발전했고, 처리를 컨텍스트 밖의 코드로 옮기는 하네스 엔지니어링으로 확산됐습니다. DSPy 시연은 ReAct 모듈과 Python 함수 도구를 while 루프에 결합해 대화 이력을 누적하는 방식으로 구성됐습니다.

    도구 선별에는 큰 모델 Claude Sonnet 4.5와 작은 판단 모델 Jev를 함께 사용했습니다. Jev는 요청과 도구를 평가해 필요한 도구 집합을 고르고, 하위 에이전트를 격리하며, 각 대화 차례를 검토해 불필요한 이력을 삭제합니다. 네 가지 개선을 하나의 루프에 넣는 변경은 약 16줄로 소개됐습니다.

    장기 실행의 실패와 전략적 망각

    장기 작업 모델에는 학습된 행동과 현재 지시가 충돌하는 ‘가중치와의 싸움’, 중단할 가설과 하위 작업을 계속 추구하는 ‘컨텍스트 관성’이 새로 나타났다. Claude Code의 시스템 프롬프트와 도구 지시에는 독립적인 도구 호출을 병렬 실행하라는 요청이 여러 차례 반복돼 Learning 환경의 행동 편향이 드러났다.

    Anthropic의 자기 복제 연구에 사용된 Memento 하네스는 90분마다 짧은 메모를 작성하고 컨텍스트를 비우는 방식으로 고착 문제를 완화했다. 환경과 작업 결과는 유지하면서 진행 중인 대화를 없애 새 관점에서 다시 시작하는 방식이다. Microsoft Research의 Fork-and-Flush는 큰 개선 이후 탐색이 정체되는 문제를 다뤘고, UC Berkeley의 Shangyin Tan이 주도한 Scaling Discovery Requires Forgetting는 산출물을 유지한 채 주기적으로 컨텍스트를 지워 성능이 다시 상승하는 양상을 보고했다.

    개인 에이전트에서는 기억과 스킬이 누적되며 지시 충돌이 새로운 운영 과제가 될 것으로 보인다. Hermes를 6개월 운용한 경험에서는 스킬에 특이한 수정이 쌓이면서 문제 해결 방식이 나빠질 수 있었고, 범용 에이전트가 같은 문제를 서로 다른 방식으로 해결하면서 기억과 지시가 충돌했다. 이에 대응하는 수단은 격리, 외부 저장, 누적 이력 삭제 같은 기존 기법으로 남아 있다. 에이전트 하네스의 품질은 컨텍스트 창의 크기보다 목표 중심의 정보 선별과 전략적 망각을 얼마나 정교하게 자동화하는가에 달렸다.

    이 변화는 컨텍스트 엔지니어링의 현주소를 다룬 자료에서 확인할 수 있다. 장기 에이전트를 설계하는 팀은 프롬프트 길이보다 무엇을 컨텍스트에 남기고 언제 비울지를 함께 다뤄야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — 컨텍스트 엔지니어링의 현주소

  • LLM 정형 검증의 가능성과 한계: Claude가 검증한 123개 라이브러리

    LLM 정형 검증의 가능성과 한계: Claude가 검증한 123개 라이브러리

    Anthropic과 Theorem은 Claude를 이용해 Google OSS-Fuzz 대상 오픈소스 라이브러리 123개, 퍼징 진입점 239개를 정형 검증했다. 버그를 수정한 뒤에는 특정 실행 환경과 입력 크기 조건에서 컴파일된 코드가 충돌하지 않음을 증명하는 수준까지 확장했다. 이 실험은 LLM 정형 검증의 규모와 재사용 가능성을 보여주는 동시에, 보장 범위를 어디까지 설정하느냐가 핵심 쟁점임을 드러낸다.

    퍼즈 테스트를 ‘항상 충돌하지 않는 코드’로 바꾸다

    정형 검증은 코드를 수학적 모델로 옮겨 정의된 규칙을 위반하지 않는다는 것을 보이는 방식이다. 기존 테스트는 특정 입력이 통과하거나 실패하는지 확인하지만, 실행 시간을 늘려도 모든 코드 경로를 탐색한다는 보장은 없다. 이번 실험은 개발자가 입력 진입점을 만들고 문제가 생기면 충돌하도록 만든 퍼즈 테스트를 ‘64MB 미만의 어떤 입력에서도 충돌하지 않는다’는 명세로 변환했다.

    라이브러리와 퍼즈 테스트를 RISC-V 실행 파일로 컴파일한 뒤 Theorem의 RISC-V 명령어 및 Linux 프로세스 의미론으로 실제 바이너리의 동작을 모델링했다. 수만 개 명령어의 가능한 동작과 상호작용을 다루는 대규모 증명에 Claude가 활용됐고, Claude가 작성한 Rocq 코드는 커널이 명세 충족 여부를 검사한다. AddressSanitizer를 이용해 잘못된 메모리 접근을 충돌로 드러내는 방식은 메모리 안전성 명세를 만들기 위한 기반이 됐다.

    퍼징이 놓친 경계에서 드러난 버그들

    증명 과정에서는 Claude가 발견한 버그를 바로 패치하고 명세를 다시 생성하며 작업을 이어갔고, 수백 개의 버그가 확인됐다. 압축 해제 코드의 카운터 언더플로는 약 20MB 입력의 드문 특정 배치에서 경계 밖 쓰기를 일으켰으며, 이미지 디코더의 경계 밖 읽기는 64MB 입력과 2GB가 넘는 메모리가 필요했다. 다른 라이브러리에서는 동일 파일의 핸들 두 개에 대해 특정 호출 순서가 실행돼야 경계 밖 읽기가 발생했다.

    Claude는 깊게 중첩된 입력이 필요한 libexpat의 CVE-2026-56132도 재발견했다. 최종 증명에 성공하지 못한 과제에서도 증명 시도가 실제로 수정해야 할 버그를 찾는 데 기여했다. 이는 정형 검증의 실패가 곧 결론을 폐기할|Division 아니라, 추가 조사와 패치가 필요한 지점을 알려주는 결과일 수 있음을 보여준다.

    기계 검사의 신뢰 경계와 증명 재사용

    전체 증명은 약 1억 8,000만 줄의 Rocq 코드로 구성됐고, 일반적인 증명의 약 60만 줄보다 훨씬 크다. 사람이 거대한 증명 코드를 모두 검토할 필요는 없지만, 보장은 단일 스레드 정적 바이너리와 Linux의 RISC-V CPU 실행이라는 가정에 의존한다. RISC-V와 Linux 프로세스의 형식 모델이 현실과 일치하고, 실제 증명된 정리의 서술이 정확한지 확인하는 과정은 여전히 남아 있다.

    증명 생성에는 막대한 토큰이 들기 때문에 비용 절감도 핵심 과제로 떠올랐다. OSS-Fuzz 코드에서 만든 소규모 검증 과제 36개에서 Opus 5.5는 Opus 5보다 약 40% 적은 토큰으로 과제의 절반을 증명했다. 에이전트가 서로의 증명을 복사할 수 있는 공유 작업 공간은 토큰 사용량을 17% 줄였고, 단독에서는 실패했던 일부 과제도 성공했다. 공통 코드와 작은 증명을 재귀적으로 조합하는 방식은 LLM 정형 검증의 확장성을 높이는 핵심 전략으로 제시된다.

    ‘버그 없음’이 아닌 조건부 증명

    검증 대상은 musl libc와 연결된 단일 스레드 정적 RISC-V 바이너리였다. 실제 사용 환경은 대체로 x86 또는 ARM에서 glibc에 동적으로 연결되는 형태이므로 배포 환경에 더 가까운 시스템 모델과 정확한 x86 의미론이 추가로 필요하다. ASan도 모든 메모리 안전성 버그를 탐지하지 못하며, 모든 진입점을 검증했다고 해서 도달 불가능한 코드까지 라이브러리 전체가 보장되는 것은 아니다.

    정형 검증됨은 버그 없음과 같지 않다. 검사기는 형식 명세의 충족 여부만 확인하고, 명세가 현실과 일치하는지는 판단하지 못한다. 호출자가 공개 함수를 잘못 사용하거나 명세에 없는 실행 조건이 존재하면 보장 밖의 문제가 남는다. 이번 실험의 의미는 AI가 모든 소프트웨어의 완전한 정답을 제시한다는 데 있지 않다. 테스트 가능한 보장을 기계가 확인 가능한 형태로 확장하고, 그 범위와 신뢰 경계를 함께 드러내는 데 있다.

    원문의 실험 집계와 세부 배경은 LLM 정형 검증 관련 보도에서 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — LLM이 훨씬 더 큰 규모의 소프트웨어 정형 검증을 가능하게 하고 있음

  • AI 과학의 새 분업: GPT-Rosalind와 Claude가 가설과 후보를 설계하다

    AI 과학의 새 분업: GPT-Rosalind와 Claude가 가설과 후보를 설계하다

    OpenAI와 Anthropic이 하루 차이로 AI를 활용한 생물학 연구 성과를 잇달아 공개했다. OpenAI의 GPT-Rosalind는 AI 에이전트 1,946개를 병렬 실행해 쥐 뇌세포의 대규모 유전자 실험 데이터를 32분 만에 분석했고, Anthropic의 Claude는 전갈 신경독소에 결합하는 단백질 후보를 설계해 실험으로 검증하는 접근을 보여줬다. 두 사례는 AI 과학이 가설 생성과 후보 설계라는 탐색 단계에서 빠른 속도로 성과를 내고 있다는 공통점을 드러낸다.

    병렬 분석과 대규모 후보 설계

    GPT-Rosalind는 기존 연구에서 확인된 발견 55개 가운데 48개를 재발견하거나 더 구체화했다. 여러 에이전트가 기존 실험 데이터를 동시에 분석하는 방식은 연구자가 축적된 자료에서 새 가설을 도출하는 과정의 탐색 범위를 넓혔다. OpenAI의 발표에 따르면 이 시스템은 기존 실험 데이터를 바탕으로 새로운 생물학적 가설을 도출했다.

    Claude의 사례는 생성 단계를 넘어 설계와 선별에 초점을 두었다. Anthropic은 AI를 이용해 전갈 신경독소 바인더 후보 318,484개를 설계한 뒤 211개를 실제 실험했고, 17개가 엄격한 결합 기준을 통과했다. AI가 설계한 단백질을 실험실에서 검증한다는 구성이 핵심이다.

    가설 생성 이후에는 실험이 병목

    AI 과학은 과학적 발견의 전 과정을 대체하는 단계에 진입한 것이 아니라, 방대한 가설과 후보를 생성하고 선별하는 역할을 맡기 시작했다는 점에 의미가 있다. 후보를 만드는 속도는 빨라졌지만, 이를 실제 과학적 발견이나 치료제로 연결하는 실험과 검증은 여전히 병목으로 남아 있다.

    이 구조에서 연구자의 역할은 AI가 제시한 방대한 탐색 결과를 실제 과학적 주장으로 전환하는 데 집중된다. 탐색의 규모와 재현 속도는 AI 과학의 강점이지만, 후보의 신뢰성과 활용 가능성을 가르는 기준은 여전히 실험에서 마련된다. 두 연구 발표를 정리한 원문은 서로 다른 방식으로 접근한 AI 과학의 사례를 함께 보여준다.

  • Harness² 공개…모델 대신 하네스 최적화로 AI 에이전트 성능 개선

    Harness² 공개…모델 대신 하네스 최적화로 AI 에이전트 성능 개선

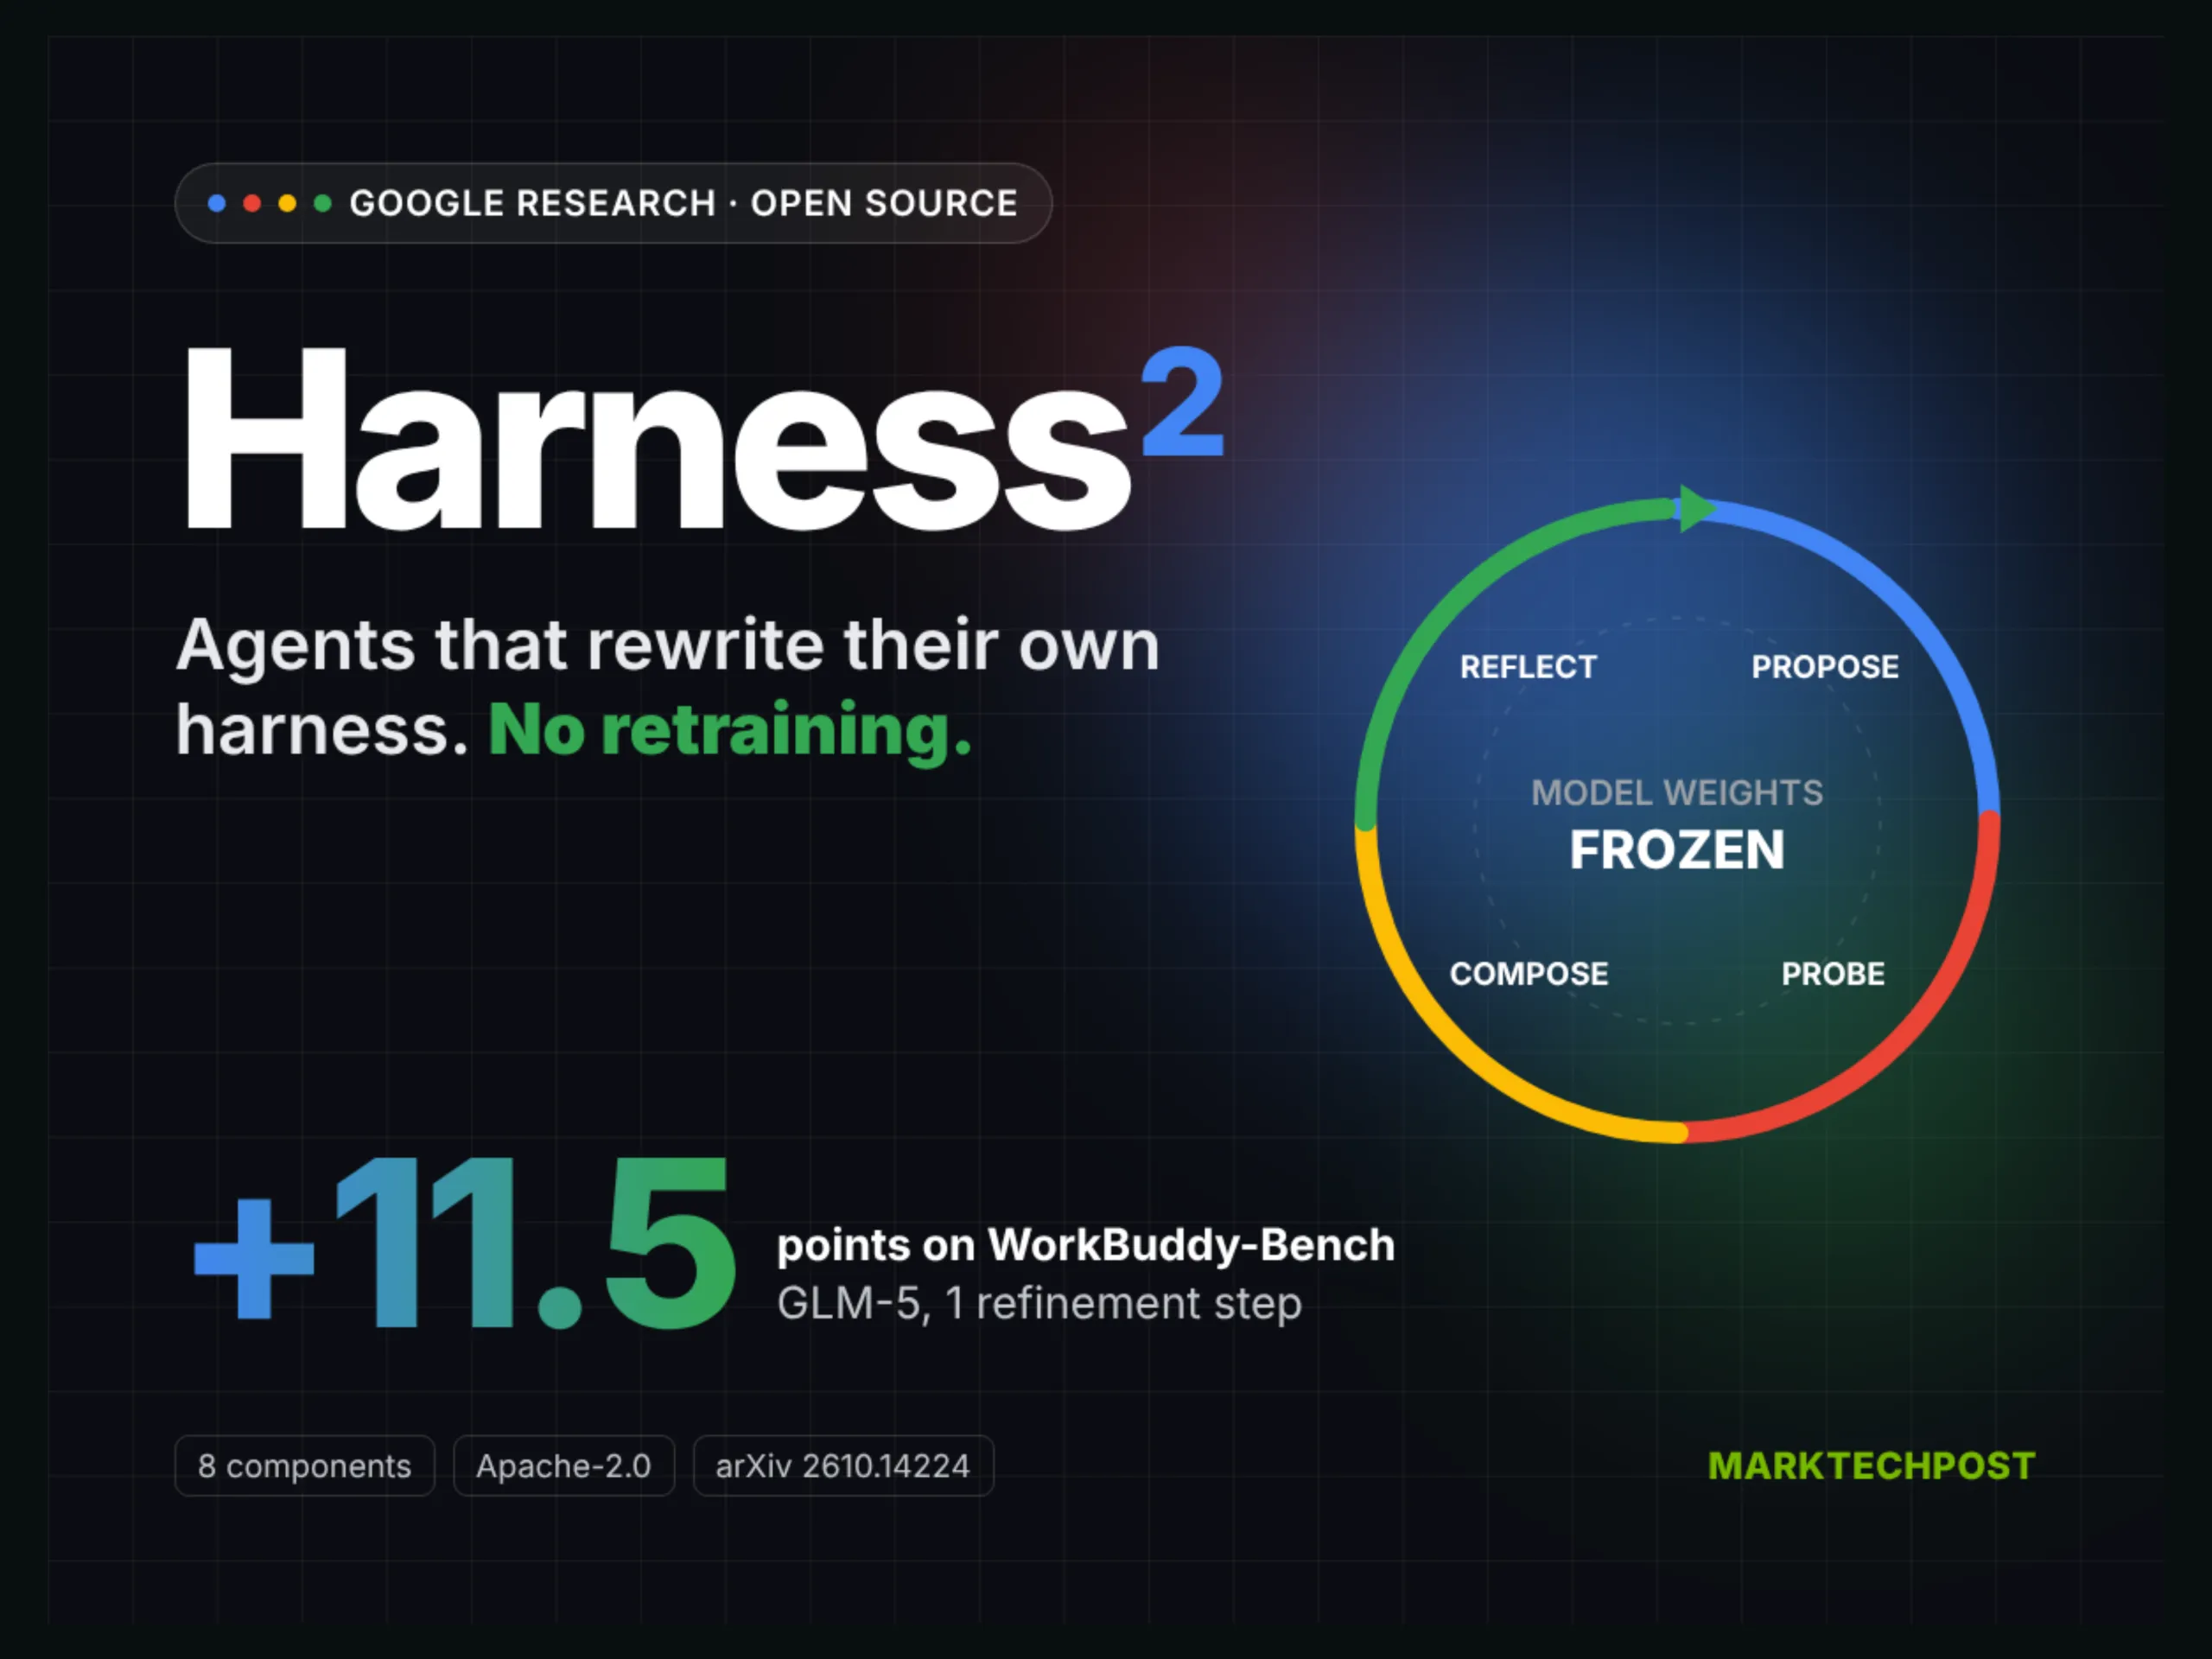
    Google Cloud AI Research가 에이전트의 모델을 대체하지 않고도 실행 환경을 개선할 수 있는 재귀적 프레임워크 Harness²를 공개했다. 이 프레임워크는 동결된 모델 주변의 코드와 파일을 다듬어, 더 좋은 모델을 사용하지 않고도 에이전트 성능을 높이려는 접근을 취한다. 공개된 버전은 0.1.0이며, 학습된 파라미터는 없고 파일 형태로 편집 가능한 하네스 구성 요소는 8개다.

    모델이 아니라 에이전트를 둘러싼 환경을 바꾼다

    Harness²에서 하네스는 모델 그 자체보다 광범위한 개념이다. 프롬프트, 도구, 메모리, 스킬과 오케스트레이션이 모두 모델 주변의 시스템에 포함되며, 이 환경을 최적화하는 과정이 하네싱에 해당한다. 모델 가중치는 변경되지 않으며, 프레임워크는 실제 배치 단계에서 에이전트의 하네스를 개선하도록 설계됐다.

    하네스의 편집 대상은 각각 파일로 마운트되는 8개 구성 요소다. 이 구성 요소는 문맥 구성, 도구 인터페이스, 위임과 도구 루프 내부의 행동을 포괄한다. 즉, Harness²의 접근은 정답이 주어지는 폐쇄형 환경보다 정답을 알려 주는 검증자가 없는 개방형 환경에 맞춰져 있다. 프레임워크는 라벨이나 테스트 케이스를 전제로 하는 많은 자기 개선 방식과 달리, 그러한 지표 없이도 작동하도록 설계됐다.

    Propose·Probe·Compose로 실패를 behavioural 차이로 검증한다

    Harness²의 핵심은 작업 수준 재귀와 하네스 수준 재귀라는 두 연결된 단계다. 작업 수준 재귀는 기준 하네스로 작업을 실행한 뒤 편집자가 후보를 제안하고, 같은 작업에서 후보를 비교한 다음 관찰된 행동으로 뒷받침되는 편집만 남기는 대비형 Propose·Probe·Compose 절차를 사용한다.

    편집자가 제안하는 후보에는 일반적인 에이전트 실패를 겨냥하는 invariant 후보와 현재 도메인의 지식과 절차를 다루는 domain 후보가 포함된다. composer는 기준 실행과 두 후보의 궤적을 비교하며, 단순히 후보가 더 잘 풀어 보였다는 이유가 아니라 실제 행동 차이가 있는 편집만 채택한다. 이 방식은 정답 레이블을 대체하는 직접적인 증거로, 후보가 만든 행동의 차이에 초점을 둔다.

    작업 처리가 끝나면 반사는 채택한 하네스와 교훈 문서인 EXPERIENCE.md를 저장한다. 이 경험 라이브러리는 이후 제안에 활용되지만, 새 작업은 다시 기본 하네스에서 시작한다. 병렬 모드는 invariant 후보 k개와 domain 후보 k개를 탐색한 뒤 k번 조합하며, 순차 모드는 k개의 개선 단계를 이어 붙인다. 탐색 폭이 커질수록 작업당 추가 모델 실행과 비용도 늘어난다.

    세 벤치마크에서 나타난 성능과 실행 비용

    구현 환경은 Linux, Python 3.12 또는 3.13과 uv를 대상으로 하며, 모델 실행에는 Vertex AI를 사용한다. GPU 요구 사항은 공개되지 않았다. 모델 기반 실행에는 Node.js 20 이상, Google Cloud CLI와 Vertex AI 프로젝트가 필요하며, LAB에는 Pandoc과 Poppler, WorkBuddy-Bench에는 Docker가 요구된다. 실행기는 기본적으로 OpenCode이며 Codex는 별도 옵션으로 지정한다.

    평가에는 WorkBuddy-Bench, JobBench, Harvey’s LAB 등 3개 전문 벤치마크가 사용됐다. 실행 모델은 Gemini 3.5 Flash와 GLM-5, 실행 환경은 OpenCode와 Codex였고, 기본 편집기는 Claude Opus 4.8이었다. 결과는 3회 실행의 평균으로 제시됐다. 한 번의 개선 단계가 4개 모델·하네스 조합과 3개 벤치마크 모두에서 성능을 높였지만, 개선 폭은 환경에 따라 달랐다.

    WorkBuddy-Bench에서 OpenCode를 사용한 GLM-5는 64.2점에서 75.7점으로 11.5점 상승했다. 병렬 재귀의 k를 5로 설정한 Gemini과 OpenCode 조합은 같은 벤치마크에서 80.8점을 기록했다. 작업당 단계도 감소했는데, WorkBuddy-Bench의 4개 조합 가운데 3개에서 필요한 단계 수가 줄었고 Gemini과 OpenCode 조합은 25.4단계에서 21.9단계로 감소했다. 반면 JobBench에서 Codex를 사용한 GLM-5의 가장 작은 개선은 23.6점에서 24.8점으로 1.2점 상승에 그쳤다.

    하네스 최적화의 실무 조건과 검증 과제

    Harness²의 가치는 모델 학습 없이 테스트 시점에 하네스를 다시 작성하는 데 있다. 다만 추가 실행이 발생하므로 비용 예측과 실행 격리가 함께 필요하다. 외부 명령이 도구 인터페이스를 통해 작동하는 만큼 샌드박싱도 직접 구성해야 한다. 원문을 인용한 Harness² 공개 보도는 성능 수치를 소개했지만, 정확한 세부 구성과 재현 조건은 논문과 저장소를 함께 확인해야 한다.

    이 프레임워크가 제시하는 변화는 더 큰 모델을 즉시 도입하는 대신, 이미 배치된 에이전트의 계획과 도구 사용을 실행 과정에서 보정하는 쪽이다. Propose·Probe·Compose는 후보의 우열을 정답표가 아니라 행동 차이로 판단하고, EXPERIENCE.md는 채택된 교훈을 다음 작업의 제안으로 연결한다. 하네스 최적화가 성능 개선만의 문제가 아니라 모델 호출 수, 격리 환경, 재현 가능한 평가 설계가 함께 요구되는 실행 전략으로 자리 잡는다는 점이 핵심이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Google Open-Sources Harness2, a Recursive Agent Harnessing Framework

  • DeepSeek 모델 DeepSeek-V4.1-Flash-1017 공개, 에이전트용 Search·Fetch API까지 제공

    DeepSeek 모델 DeepSeek-V4.1-Flash-1017 공개, 에이전트용 Search·Fetch API까지 제공

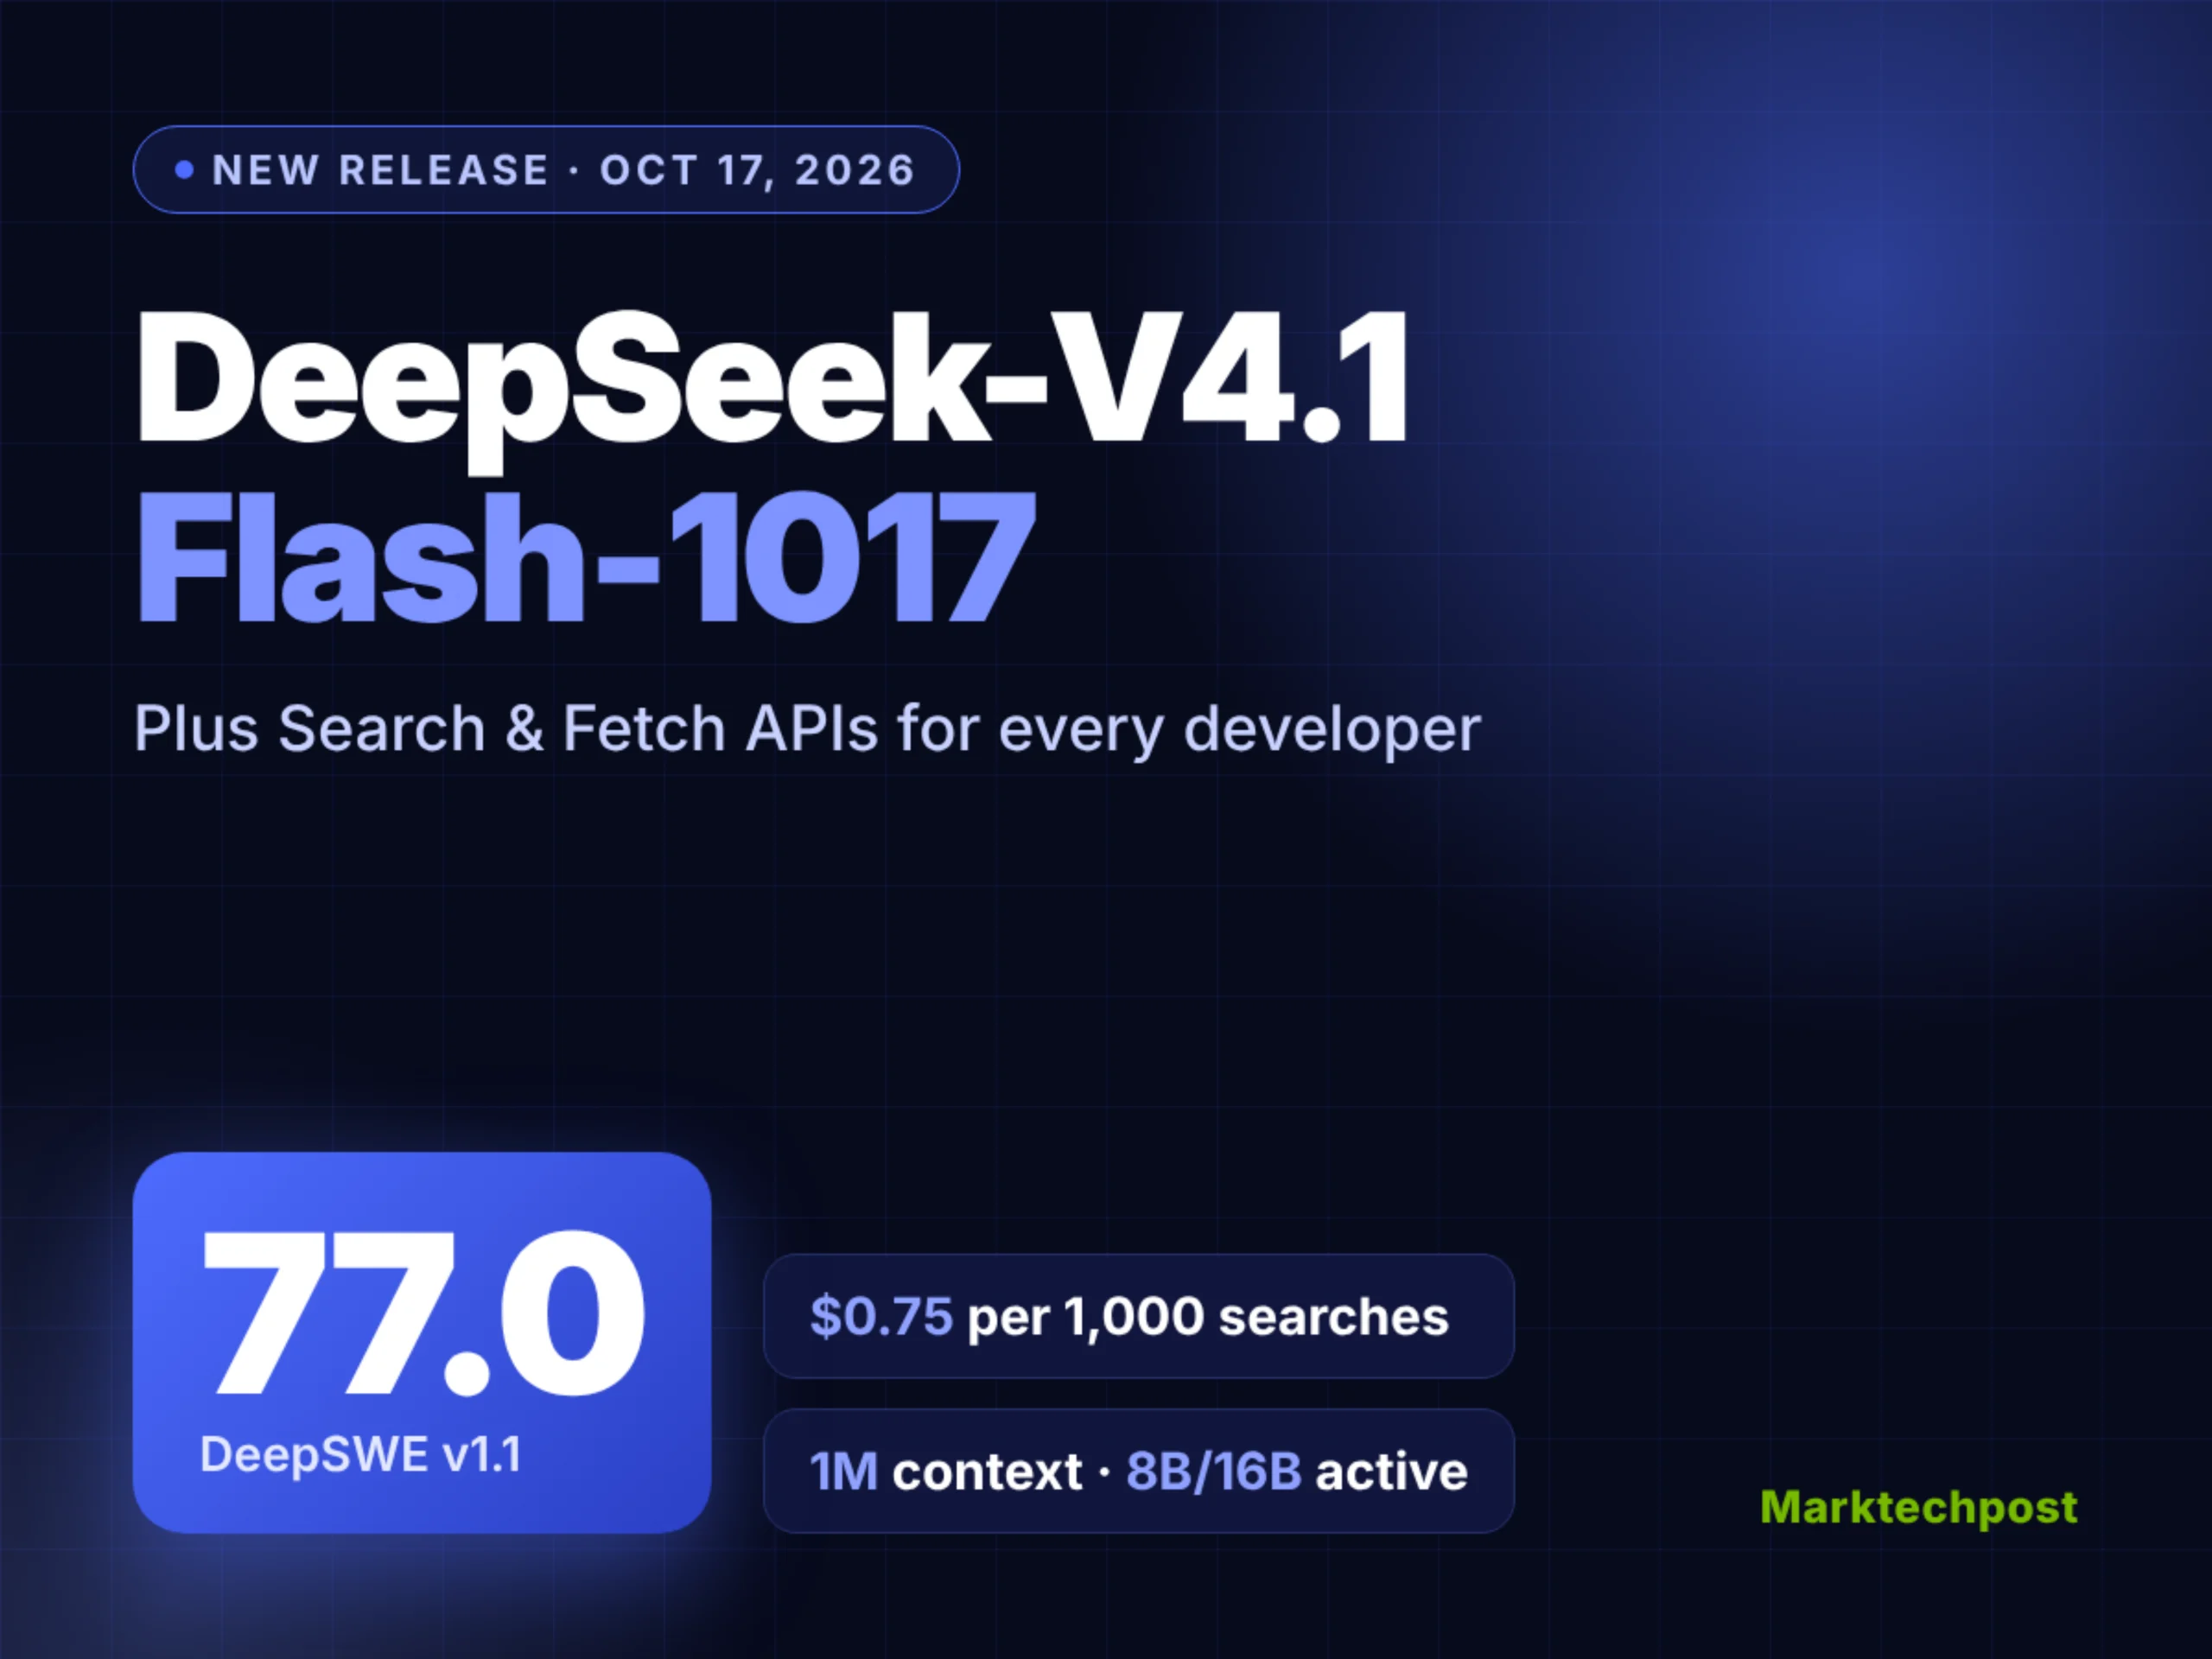
    DeepSeek는 DeepSeek 모델 DeepSeek-V4.1-Flash-1017을 공개해 웹사이트와 앱, API의 deepseek-flash 모델로 제공했다. 기존 9월 V4.1-Flash의 후속 체크포인트인 새 모델은 DeepSeek의 자체 측정치에 따르면 11개 벤치마크에서 앞선 성능을 기록했다. 동시에 모든 개발자에게 Search API와 Fetch API를 열어, 모델과 웹 정보 접근 계층을 하나의 API 키로 구성할 수 있게 했다.

    77점 DeepSWE, 코딩 성능 개선의 의미

    DeepSeek는 1017 체크포인트가 기존 V4.1-Flash보다 11개 벤치마크에서 2.0점부터 11.1점까지 높은 점수를 냈다고 밝혔다. DeepSWE v1.1에서는 77.0점을 기록해 이전 V4.1-Flash의 74.2점과 Claude Opus 5의 74.0점을 웃돌았다. Automation-Bench에서는 60.5점, Agents’ Last Exam에서는 35.4점을 기록하며 이들 항목에서도 앞선 것으로 나타났다.

    다만 성능의 우열이 모든 작업 영역으로 확장되지는 않는다. HLE without tools에서 1017 체크포인트는 42.6점으로 Claude Opus 5의 56.3점보다 낮았고, Terminal-Bench 4.0과 ProgramBench, NL2Repo에서도 Claude Opus 5가 앞서 것으로 나타났다. 위 수치는 DeepSeek가 자체적으로 측정한 결과이며, 독립적인 재검증이 필요한 성능 주장으로 읽어야 한다.

    모델 DeepSWE v1.1 HLE without tools
    DeepSeek-V4.1-Flash-1017 77.0 42.6
    DeepSeek-V4.1-Flash 74.2 해당 수치 미제시
    Claude Opus 5 74.0 56.3

    MoE 구조와 장문 컨텍스트 효율화

    DeepSeek-V4.1-Flash-1017은 40개 Transformer 계층을 20개 causal encoder와 20개 decoder로 나눈 multimodal Mixture-of-Experts 모델을 기반으로 한다. 전체 규모는 552B backbone parameters와 196B Engram parameters이며, 토큰별 활성 파라미터는 prefill 8B, decode 16B다. 컨텍스트는 최대 1M 토큰이고 출력은 최대 384K 토큰까지 지원한다.

    효율화 요소에는 Causal Encoder-Decoder와 Compressed Sparse Attention 2, FP4 main KV cache, SWA Bounded Replay가 포함된다. CED는 최종 encoder hidden state에서 decoder global KV를 투영해 prefill 연산량을 거의 절반으로 줄인다. CSA2는 계층을 Full, Reindex, Reuse 모드로 운용하며 main KV와 indexer keys를 계층 간 공유한다. FP4 main KV cache는 global KV를 토큰당 890바이트로 줄여 V4-Flash의 약 1/4 수준으로 관리하고, SWA Bounded Replay는 persistent KV cache를 약 1/8 수준으로 축소한다.

    후훈련에는 self-feedback를 이용한 reinforcement learning이 적용됐으며, 게임 제작과 3D 모델링을 포함한 종단 프로젝트 작업 사례가 제시됐다. API의 reasoning effort는 1부터 100까지의 scalar이며 low, high, max는 각각 50, 75, 100에 대응한다.

    Search·Fetch API로 웹 접근 계층 단순화

    Search API는 질의에 따른 순위형 웹 검색 결과를 반환하고, Fetch API는 단일 페이지를 Markdown으로 변환한다. 두 기능의 엔드포인트는 각각 POST /v1/tools/search와 POST /v1/tools/fetch이며, api.deepseek.com에서 제공된다. Search API는 1개부터 50개까지의 결과와 선택적 페이지 콘텐츠를 지원하고 site:, lang:, after:, before: 연산자를 사용할 수 있다. 각 결과에는 0부터 3까지의 rerank score와 0부터 4까지의 authority tier가 포함된다.

    요금과 제한은 API별로 동일하다. Search API와 Fetch API는 각각 성공 요청 1,000건당 0.75달러이며, 빈 결과와 실패 요청에는 비용이 부과되지 않는다. 계정별 엔드포인트 요청 제한은 초당 5건이다.

    비용과 오픈 웨이트의 남은 제약

    deepseek-flash의 peak 가격은 캐시 미적중 입력 토큰 100만 개당 0.30달러, 출력 토큰 100만 개당 1.20달러이며 off-peak 요금은 절반이다. DeepSeek Harness, Claude Code, Codex를 통한 서버 측 호출은 2026년 11월 1일까지 무료로 제공된다. 모델은 OpenAI 형식과 Anthropic 형식 엔드포인트로 호출할 수 있다.

    9월 V4.1-Flash의 763B 파라미터 FP8 가중치는 MIT 라이선스로 Hugging Face에 공개됐다. 반면 1017 체크포인트의 가중치와 하드웨어 요구사항은 공개되지 않았다. API 서비스와 웹 도구를 함께 제공한 만큼 실무 선택은 코딩 품질, 장문 처리량, 호출 비용, 자체 배포 가능성을 함께 비교하는 데 달려 있다. 상세 내용은 MarkTechPost의 공개 보도를 통해 확인할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — DeepSeek Just Released V4.1-Flash-1017, Scores 77.0 on DeepSWE, Opens Search API

  • AI 에이전트 격리와 스냅샷으로 줄이는 Kubernetes 대기 자원

    AI 에이전트 격리와 스냅샷으로 줄이는 Kubernetes 대기 자원

    이 도구는 여러 AI 에이전트를 독립 샌드박스에서 실행하면서 대기 중인 자원을 회수하는 인프라 도구다. 모델 응답이나 도구 실행을 기다리는 동안 메모리와 파일 상태를 저장해 요청이 들어오면 복원하고 작업을 재개한다. 이를 통해 AI 에이전트 격리를 유지하면서 Kubernetes의 상시 실행 비용을 낮이는 것이 목표다.

    Pod 재사용을 지탱하는 마이크로VM 구조

    Agent Substrate는 미리 준비한 소수의 Kubernetes Pod를 여러 에이전트가 번갈아 사용한다. gVisor 또는 Cloud Hypervisor 기반 마이크로VM으로 실행 환경을 격리하지만, 일반 Linux 컨테이너만으로 실행하는 방식은 지원하지 않는다. 표준 OCI 컨테이너 이미지를 활용할 수 있어 특정 모델이나 에이전트 SDK에 종속되지 않는다.

    저장된 상태는 다른 워커에서도 복원할 수 있어 실행 위치가 바뀌어도 세션과 작업 환경을 유지한다. 이 구조는 에이전트별 Pod 유지와 장기 대기라는 Kubernetes 자원 관리 과제를 상태 저장·복원 방식으로 풀었다.

    게이트웨이와 정책으로 보호되는 외부 요청

    API 키와 인증정보는 샌드박스 밖에서 관리하며, 게이트웨이가 허용된 외부 요청에만 인증정보를 주입한다. 에이전트별 신원 구분과 네트워크 분리, 외부 인증 및 데이터 유출 방지 정책 연동도 가능하다. 따라서 AI 에이전트 격리는 실행 환경뿐 아니라 인증 경계와 데이터 이동 정책을 함께 다루는 문제로 구현된다.

    Kubernetes 배포와 남은 운영 조건

    Agent Substrate는 Kubernetes에 직접 배포되며 PostgreSQL과 스냅샷 저장소가 필요하다. 로컬 kind와 GKE 개발 환경도 제공된다. 실제 도입에서는 마이크로VM 격리, 스냅샷 복원, 워커 간 이동, 인증정보 주입 범위를 함께 검증해야 한다. Agent Substrate의 원문 정보를 기준으로 확인할 수 있다.

  • Dekton 재료과학, 고령토에서 인체 지지체까지

    Dekton 재료과학, 고령토에서 인체 지지체까지

    스페인 기업 Cosentino가 2013년 개발한 Dekton은 기본적으로 첨단 제조 공정을 적용한 자기다. 열과 압력, 긁힘과 파손, 얼룩에 대한 높은 저항성을 앞세워 조리대와 같은 표면 소재로 주목받았으며, 유사한 재료와 응용 범위는 인공 관절과 뼈 재생 영역까지 넓혀지고 있다.

    비싼 인덕션 조리면에서 출발한 질문

    한 부부가 구입한 고가의 인덕션 쿡톱에는 버너 위에 놓을 조리면이 포함되지 않았고, 별도 업체에서 구매해야 했다. 웹사이트에서는 이 사실이 분명히 드러나지 않았으며, 제곱피트당 약 30달러인 강화유리 대신 그보다 5배 비싼 Dekton이 필요했다.

    이러한 사연은 낯선 소재가 왜 유독 비싼지 질문하게 한다. 약 30년 전에는 제조하기 어려웠던 첨단 물질이지만, 뿌리는 인류가 3,000년 이상 사용한 자기 기술에 있다. 자기는 점토판처럼 오래 쓰인 기반 재료에 가마와 화학 지식을 결합해 만들어낸 기술적 도약이었다.

    고령토의 결정이 변하는 순간

    중국 북부의 도공들은 고령토를 실험하면서 자기 제조의 출발점을 찾았다. 일반 점토처럼 보이는 고령토는 수산기가 결합한 판상 미세결정으로 구성되며, 가열하면 수산기가 빠져나가고 바늘 모양 결정이 단단하게 맞물린다.

    고령토에는 카올리나이트가 풍부하며, 약 1,200°C에서는 규소와 산소가 실리카를 형성하고 액상 유리가 결정망 안팎의 틈을 채운다. 이 과정으로 조밀하고 연속적이며 반투명한 자기 구조가 만들어진다.

    자기 생산에는 가마 기술도 필수적이었다. 중국 도공들은 뜨거운 공기가 바닥으로 빠져나가도록 하향 통풍 구조를 사용하고, 고온에서 깨지거나 녹지 않는 내열 벽돌을 개발했다.

    백색 금에서 Meissen까지

    유럽은 약 13세기에 동아시아 자기를 접했고, 강하면서도 매끄러운 광택을 지닌 재료를 ‘백색 금’으로 여겼다. 그러나 핵심 원료인 고령토와 China stone의 역할을 몰랐고, 산화주석과 유리 가루를 이용한 maiolica, faience, Delftware조차 진정한 자기의 불투수성과 높은 인장강도를 갖지 못했다.

    Ehrenfried Walther von Tschirnhaus는 집광 렌즈로 광물을 가열하며 자기 제조를 탐구했고, 1693년부터 1694년 겨울에는 Colditz의 점토가 녹지 않는다는 사실을 발견했다. 1708년 8월과 9월 사이에는 고령토가 풍부한 흰 점토에 석회석 가루를 섞어 중국 백자와 비슷한 잔을 만들었다.

    Tschirnhaus가 사망한 뒤 Johann Friedrich Böttger가 제조법을 이어받았고, Augustus the Strong는 1710년 Meissen 왕립 자기 제조소를 세워 운영을 맡겼다. Meissen 제품은 아시아 원형보다 더 단단하고 기공이 적었으며, 이후 약 10년 동안 작업자들이 China clay로 불린 현지 석재가 좋은 첨가물임을 알아냈다.

    Dekton이 줄인 자기의 취약성

    Dekton 개발에는 6년과 약 2억 달러가 투입됐다. 분쇄한 자기, 유리, 석영의 슬러리를 구워 판재로 만든 뒤 대형 유압 프레스로 2만 5,000미터톤의 압축력을 가하고, 약 1,200°C에서 경화한다.

    전통 세라믹의 미세한 빈틈과 결함은 충격 에너지를 한곳에 모으는 응력 집중점으로 작용한다. Dekton 제조 과정의 고온과 고압은 카올리나이트와 석영 입자의 접촉 경계에서 원자 확산을 촉진해 재료를 하나의 고체처럼 결합시키고, 취성과 구조적 취약성을 줄인다.

    젖은 타일과 인체 안의 세라믹

    미끄럼 방지 타일에는 젖었을 때만 작동하는 방식도 적용됐다. 약 10년 전 이탈리아와 스페인의 Ceramica Sant’Agostino과 Inalco가 wet-activated 또는 in-out 타일을 도입했으며, 표면에 특수 결정성 화합물을 구워 붙였다. 젖은 타일을 밟으면 압력이 물을Numerous 기공으로 밀어 넣어 발과 타일 사이에 흡착판 효과를 만들고 미끄러움을 줄인다.

    연구자들은 3D 프린팅 생체세라믹으로 결손 뼈를 영구적으로 대체하는 대신, 혈관과 뼈세포가 내부로 이동할 수 있는 다공성 격자를 만들었다. 시간이 지나면 구조가 용해되고 환자 자신의 조직로 대체된다. 이처럼 Dekton 재료과학의 관심은 조리대, 욕실 타일, 인공 관절과 뼈 재생을 잇는 물리적 기술의 변화로 확장되고 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — Dekton은 도대체 무엇인가?

  • AI로 하드웨어 역공학하기: Windows 정상 동작을 Linux 구현의 기준선으로

    AI로 하드웨어 역공학하기: Windows 정상 동작을 Linux 구현의 기준선으로

    문서가 부족한 하드웨어를 다루는 개발자는 제조사 드라이버의 정상 동작을 관찰하면서 자체 구현의 차이를 찾아야 한다. Claude Code를 활용한 사례에서는 Windows 가상 머신과 Linux의 USB 캡처를 이용해 필름 스캐너 드라이버를 개발하고, 노트북 MIPI 카메라의 밝기와 색상 문제도 개선했다. 하드웨어 역공학의 효과는 막연한 원리를 추측하는 데서가 아니라, 반복적인 트래픽 분석과 패치 작업을 빠르게 수행하는 데서 나타났다.

    비교 가능한 참조 동작 만들기

    Plustek OpticFilm 8200i는 Linux에서 지원되지 않아 개발이 수개월간 중단됐지만, Windows에서 정상 스캔을 실행하면서 USB 데이터를 기록하자 몇 시간 만에 Linux에서도 첫 스캔에 성공했다. 이후 거의 완성된 드라이버를 만든 시점에는 다른 개발자가 이미 SANE에 해당 스캐너 지원을 추가한 사실이 밝혀졌다.

    공개된 hw-harness는 이 실험에 사용했던 맞춤형 코드를 재사용하기 쉽게 정리한 프로젝트다. 실제 프로젝트에서 사용한 코드와 공개 버전은 완전히 같지는 않으며, 세 가지 작업을 모두 공개 하네스로 수행한 것은 아니다.

    하드웨어 역공학에서 중요한 것은 캡처를 많이 확보하는 것만이 아니라 비교 가능한 실행을 만드는 데 있다. 실제 장치를 KVM Windows 가상 머신에 패스스루하고, Windows 제조사 드라이버로 참조 작업을 수행한다. 이어 Linux 호스트의 usbmon으로 패스스루 계층 아래의 USB 트래픽을 기록하고, Linux 자체 드라이버로 같은 작업을 수행해 같은 도구로 다시 캡처한다.

    두 실행 추적을 직접 비교하면 한 바이트만 달라지는 반복 시퀀스나 초기화 순서의 차이를 찾을 수 있다. 이런 차이는 막연한 “작동하지 않음”을 수정 가능한 드라이버 버그 목록으로 바꾸는 근거가 된다. AI는 수천 줄의 캡처에서 반복 패턴을 찾고, 상수의 의미를 추정하며, 확인용 테스트를 작성하는 반복 작업에 적합했다. 반면 어떤 기능을 구현할지 정하고 실제 장치가 정상 동작하는지 판단하는 일은 사람이 맡았다.

    필름 스캐너와 비파괴 후처리

    스캐너 백엔드는 Genesys GL128 컨트롤러와 USB 식별자 07b3:1825를 사용하며, 컬러·회색조·적외선·컬러와 적외선 모드를 지원한다. 300~7200dpi 범위에서 채널당 8비트 또는 16비트로 스캔할 수 있고, 적외선 채널은 먼지와 흠집 제거에 사용된다. Fedora RPM은 매 푸시마다 자동으로 빌드되도록 배포됐다.

    업스트림 SANE의 genesys 백엔드가 2026년 9월 이 스캐너를 지원하기 시작한 뒤에는 두 드라이버를 비교했다. 3600dpi에서 미세 디테일 수준은 비슷했지만, 최대 해상도 스캔 시간은 자체 백엔드가 34.6초, 업스트림이 54.4초였다. 다만 비교 결과는 장치 한 대와 프레임 한 장에서 얻은 단일 사례였으므로 성능 일반화에는 주의가 필요하다. 자체 프로젝트는 개념 증명 성격이 강하며, 업스트림 드라이버가 같은 기능 수준에 도달하면 업스트림 구현을 사용하게 될 것으로 예상했다.

    Negative Vibes는 원본 데이터를 남긴다

    Negative Vibes는 Rust로 작성된 GNOME 앱으로, 컬러와 흑백 네거티브 및 슬라이드 스캔을 지원한다. 스캐너가 전달한 16비트 선형 데이터와 적외선 평면을 그대로 보존하고, 후처리 설정을 누적해 나중에 표현을 바꾸거나 다시 내보낼 수 있다. 광학 농도 공간을 이용한 네거티브 반전, 필름 베이스와 염료 사이의 크로스토크 보정, 필름 롤 전체와 프레임별 재정화 기능을 제공한다.

    앱은 적외선 방식과 소프트웨어 방식의 먼지 제거, ArgyllCMS를 통한 IT8 보정 기능을 지원한다. ICC 프로파일과 메타데이터를 포함해 TIFF·JPEG·PNG·DNG 형식으로 내보낼 수 있으며, 스캐너 백엔드를 포함한 Flatpak으로 배포됐다. 다만 모든 SANE 필름 스캐너를 지원하려면 적외선 채널을 표준 방식으로 노출해야 하고, 현재는 그러한 표준이 없다.

    MIPI 카메라까지 넓어진 적용 범위

    같은 하네스를 이용해 Lenovo ThinkPad X1 Carbon Gen 14, Aura Edition의 MIPI 카메라를 수정하는 작업도 진행됐다. 이 노트북은 Intel IPU7과 Sony IMX471 조합을 사용하며, Linux에서 이미지가 어둡고 주변부 광량 저하와 강한 황록색 색조가 나타났다. 직접 캡처하기 어려운 내부 카메라는 Windows 측 INF 파일, 레지스트리 데이터, ACPI 테이블와 장치 속성을 조사해 기준값을 확보했다.

    커널 드라이버에서는 크롭 선택 오류, 테스트 패턴 레지스터 폭 오류, 지나치게 낮은 아날로그 게인 상한을 수정했다. 이로써 전체 픽셀 배열을 사용하도록 잘못 판단하던 문제가 해소됐고, 약 1.8스톱이던 감도 손실도 줄었다. libcamera에서는 렌즈 음영 보정을 추가하고, 8비트 블랙 레벨이 화이트밸런스 통계에 적용되던 계산을 고쳤다.

    항목 수정 전 수정 후
    프레임 밝기 31.1 90.9
    빨강·초록 비율 0.890 1.047
    파랑·초록 비율 0.672 0.823

    통제된 저조도 테스트에서 수정 후 카메라는 기준 USB 웹캠에 더 가까운 색상 비율을 보였지만, 파랑은 여전히 약 17% 부족했다. 원문은 그레이 월드 화이트밸런스 탓으로 추정한다. 이 사례는 버스를 직접 기록하기 어려운 장치에서도 설정 데이터와 참조 카메라 비교가 중요하다는 점을 보여준다.

    실물 검증을 붙인 AI 개발

    이 사례에서 AI의 역할은 캡처 해독, 검사용 코드 작성, 상수 교차 확인처럼 반복성이 높은 작업에 집중됐다. 반면 구현 대상을 정하고 실제 스캐너와 노트북에서 결과가 정상인지 판단하는 역할은 개발자가 맡았다. 그래서 하드웨어 역공학은 AI의 추측으로 끝나는 과정이 아니라, 캡처와 참조 데이터를 만든 뒤 실제 장치에서 검증하는 반복 과정으로 볼 수 있다.

    결과는 완전하지 않다. 스캐너는 보기 괜찮은 필름 스캔 결과를 만들었고 카메라는 이전보다 크게 개선했지만, 추가 조정과 다듬기는 남아 있다. AI 에이전트의 실질적인 가치는 하드웨어 내부의 모든 원리를 설명하는 데 있지 않다. 정상 동작과 실패 동작의 차이를 빠르게 좁히고, 그 가설을 드라이버 코드와 실제 장비의 결과로 검증하는 데 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — AI로 하드웨어 역공학하기