[카테고리:] AI & 오픈소스

  • Liquid AI, 토큰당 2B만 활성화하는 24B MoE 온디바이스AI 추론 모델 공개

    Liquid AI, 토큰당 2B만 활성화하는 24B MoE 온디바이스AI 추론 모델 공개

    Liquid AI가 24B 파라미터 중 토큰당 2B만 활성화하는 Mixture-of-Experts(MoE) 추론 모델 LFM2.5-24B-A2B를 공개했다. 2026년 10월 13일자로 Hugging Face 블로그에 게시된 발표에 따르면, 모델은 답변 전에 명시적인 사고 과정을 거치며, 도구를 호출하고 OpenClaw·Hermes Agent·Pi·OpenCode 같은 에이전트 하네스 안에서 다단계 작업을 수행하도록 설계됐다. 활성 파라미터가 토큰당 2B에 그치기 때문에 추론 토큰 한 개당 비용이 낮아, 자체 하드웨어에서 에이전트를 지속적으로 운영할 수 있는 온디바이스AI 옵션으로 포지셔닝된다.

    아키텍처: 40 레이어·64 expert·하이브리드 어텐션

    LFM2.5-24B-A2B는 LFM2-24B-A2B의 설계를 계승해 40개 레이어, MoE 블록당 64 expert, top-4 라우팅을 유지하며 게이티드 단기 컨볼루션과 GQA(Grouped Query Attention)의 하이브리드 어텐션을 그대로 사용한다. 컨텍스트 윈도우는 32K에서 131K 토큰으로 확장됐고, 토크나이저는 65K에서 128K로 어휘를 늘려 비라틴어 토큰화가 개선됐다. LFM2-24B-A2B와 달리 추론 전용 모델로 동작하며, 최종 답변 전에 명시적인 연쇄적 사고(Chain of Thought)를 생성한다.

    학습 파이프라인: 33T 프리트레이닝과 5단계 포스트트레이닝

    프리트레이닝 토큰 수는 약 17T에서 약 33T로 확대됐다. 미드트레이닝은 32K 컨텍스트에서 추론·수학·코드·지시 따름·다국어 텍스트에 가중을 둔 2T 토큰, 131K 컨텍스트에서 장문맥 데이터에 가중을 둔 300B 토큰으로 구성되며 도구 호출과 다회화 궤적이 양 단계 전반에 등장한다. 포스트트레이닝은 ① 지도 미세조정(SFT), ② 다중 도메인 온폴리시 증류(MOPD) 비에이전트 단계에서 전문가 모델을 비에이전트 과제에 증류, ③ MOPD 에이전트 단계에서 에이전틱 과제 증류, ④ 에이전틱 강화학습(에이전트 하네스 내부 학습), ⑤ 후속 미세조정의 다섯 단계로 진행된다.

    에이전트 성능: 도구 사용 5종·지시 따름 3종 1위

    평가는 vLLM으로 진행됐으며, 비교 대상은 Qwen3.6-35B-A3B·Gemma-4-26B-A4B-it·Nemotron-3.5-Lightning이고 도구 사용·에이전틱 워크플로·지식·지시 따름·수학·코딩을 아우르는 16개 벤치마크가 사용됐다. LFM2.5-24B-A2B는 그룹에서 가장 작은 모델임에도, 총·활성 파라미터가 약 50% 더 많은 MoE들과 경쟁 가능한 성능을 보였다. 도구 사용·에이전틱 8개 벤치마크 중 AutomationBench·BFCLv4·ToolSandbox·LiveClaw·τ³-Bench Banking 5개에서 1위 또는 동률을 기록했고, AutomationBench는 차순위 모델 대비 3배 이상의 점수를 냈다. LiveClaw에서는 48.09로 Qwen3.6-35B-A3B의 38.19을 앞섰으며, 지시 따름 벤치마크 3종에서도 모두 1위였다. 반면 GPQA Diamond·HLE·AA-Omniscience 등 지식 중심 벤치마크와 SWE-Bench Verified(OpenCode)·SciCode 등 코딩 벤치마크에서는 더 큰 모델이 우위를 유지했다.

    추론 속도: M5 Max 184 tok/s, B300 단일 GPU 21K tok/s

    모델은 llama.cpp·MLX·vLLM·SGLang·ONNX에서 출시 즉시 지원된다. 엣지 추론에서 Apple M5 Max로 184 tokens/s, Ryzen AI Max+ 395로 114 tokens/s의 디코딩 속도를 기록했으며, 차순위 모델 대비 최대 1.7배 빠르면서 메모리 사용량은 가장 적었다. GPU 추론에서는 단일 NVIDIA B300에서 고동시성 시 21K 출력 토큰/s를 돌파해 동일 크기급에서 가장 빠른 속도를 보였다.

    벤치마크 / 환경 LFM2.5-24B-A2B 비교 대상
    LiveClaw(에이전틱 종합) 48.09 Qwen3.6-35B-A3B 38.19
    엣지 디코딩(Apple M5 Max) 184 tokens/s 차순위 대비 최대 1.7배
    엣지 디코딩(Ryzen AI Max+ 395) 114 tokens/s 차순위 대비 최대 1.7배
    데이터센터 GPU(단일 B300) 21K tokens/s(고동시성) 동급 최고 수준

    실무 적용 절차와 에이전트 하네스 연동

    모델은 OpenAI 호환 백엔드로 로컬 서빙한 뒤 에이전트 하네스에서 가리키는 방식으로 연결된다. transformers 5.0.0 이상에서 AutoModelForCausalLM으로 로딩하며, device_map=auto, dtype=bfloat16, 호환 GPU에서는 flash_attention_2 옵션을 함께 사용한다. Hermes Agent에는 model.provider를 custom으로, model.base_url을 로컬 OpenAI 호환 엔드포인트로 지정하고 model.context_length를 131072로 설정해 도구 사용을 강제한다. 서빙 백엔드별 기본 포트는 llama.cpp·MLX 8080, vLLM 8000, SGLang 30000, LM Studio 1234다. 같은 OpenAI 호환 인터페이스로 동작하기 때문에 M5 Max 같은 노트북 클래스 엣지 디바이스에서도 동일한 절차로 에이전트를 띄울 수 있어, 온디바이스AI 적용 범위가 데이터센터에서 개인 디바이스까지 확장된다.

    한계와 시사점

    지식·코딩 워크플로에서는 여전히 더 큰 모델이 우위를 점해, RAG나 웹 검색 결합이 권장된다. 131K 컨텍스트와 토큰당 2B 활성 구조의 조합은 외부 API 의존 없이 도구 호출과 다단계 추론을 로컬에서 처리하는 온디바이스AI 시나리오에 초점을 맞추고 있으며, LFM2.5-24B-A2B와 LFM2.5-24B-A2B-Base 모두 오픈웨이트로 Hugging Face에 공개된 만큼 자체 하드웨어에서 사적 에이전트를 운영하려는 팀이 즉시 검토해볼 만한 모델로 평가된다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Hugging Face Blog — Run fast, private agents on-device with LFM2.5-24B-A2B

  • ChatGPT·Claude 없이 일하기: 오픈웨이트 LLM과 보안 인클레이브로 추론 스택을 다시 짜는 법

    ChatGPT·Claude 없이 일하기: 오픈웨이트 LLM과 보안 인클레이브로 추론 스택을 다시 짜는 법

    오픈AI와 앤스로픽이 제공하는 폐쇄형 프런티어 모델이 LLM 시장의 표준으로 군림해 왔지만, 두 회사가 학습 사용 거부 설정만으로는 대화 데이터에 대한 접근을 사실상 포기하지 않는다는 점, 그리고 일부 미국 사이버보안 기업과 군수 계약업체에 가드레일이 느슨한 모델 접근 권한이 부여됐을 가능성이 있다는 점 때문에, 실무 환경에서 의존을 끊는 대안을 검토하는 움직임이 커지고 있다. 그 대안의 핵심축은 오픈웨이트 모델과 보안 인클레이브 기반 비공개 추론 서비스다.

    학습 거부 설정은 프라이버시 보장이 아니다

    오픈AI와 앤스로픽은 강력한 모델을 폐쇄형 서비스로만 제공하며, 사용자는 채팅이나 API 접근 비용을 지불한다. 학습 사용 거부 토글을 켜더라도 두 회사는 대화 전체에 접근할 수 있고, 이를 열람하거나 정부 및 기업과 공유할 수 있다는 점에서 학습 거부와 비공개 대화는 본질적으로 다르다. 현재 시점에서는 학습 거부를 존중할 가능성이 높더라도, 그것만으로 장기적인 데이터 처리 신뢰를 확보할 수는 없다는 평가다.

    특히 사이버보안 영역에서는 엄격한 가드레일이 적용되며, 대화를 감시하는 에이전트가 해킹 가능성을 판단하면 세션 진행을 차단하는 식으로 운영되지만 오탐도 빈번하다는 비판을 받는다. 반면 일부 사용자에게는 제한이 느슨하거나 없는 모델 접근이 허용되며, 다수의 미국 사이버보안 기업, 거의 확실한 미국 군수 계약업체, 그리고 원하는 미국 정부 부처까지도 접근할 수 있을 것으로 추정된다. 강력한 모델의 제한 자체에는 일부 타당성이 있지만, 최종 접근 결정권을 샘 알트먼과 다리오 아모데이에게 맡기고 행정부와 협의하게 하는 방식은 비민주적이라는 비판이 제기된다.

    오픈웨이트 모델은 어디까지 왔나

    오픈웨이트 모델은 오픈AI와 앤스로픽의 고급 독점 모델보다 약 4개월 뒤처지는 것으로 분석되며, 이 정도 격차는 크지 않다고 본다. GLM-5.3은 소프트웨어 엔지니어링 영역에서 Claude Opus 5.5와 대체로 비슷한 수준으로 보고됐고, 더 작은 GLM-5.3-Flash는 Claude Opus 4.8과 비슷한 수준으로 평가된다. 512GB RAM을 탑재한 Mac Studio를 구할 수 있다면 GLM-5.3을 개인이 직접 실행하는 것도 현실적으로 가능한 옵션이다.

    다만 모델의 유용성과 개발사를 데이터 수탁자로 신뢰할지는 구분해야 하며, GLM 개발사 Z.ai에 직접 계정을 만들거나 데이터를 보내는 것은 권장되지 않는다. Claude Code에 대응하는 코딩 하네스 ZCode가 사용자 동의 없이 로컬 소스 코드 저장소를 Alibaba Cloud에 업로드한 사실이 최근 드러난 만큼, 중국 기업에 제공한 데이터는 중국 정부와 공유될 수 있다고 가정하는 편이 안전하다. DeepSeek, Qwen, Kimi 계열도 인상적인 오픈웨이트 모델로 꼽히지만, 마찬가지로 개발사에 대화 데이터를 맡기는 일과는 구분해야 한다.

    프랑스 기업 Mistral은 미국이나 중국 기업이 아닌 유일한 주요 LLM 개발사로 분류되며, 새 프런티어 모델 Mistral Large 4의 별칭은 Le Chonk이다. 미국이나 중국 기업보다 Mistral에 데이터를 맡기는 편이 상당히 더 합리적이라는 평가가 나온다.

    보안 인클레이브가 바꾸는 비공개 추론의 모양

    보안 인클레이브 기반 추론은 로컬 호스팅 없이도 비공개 AI 사용을 가능하게 한다. 완벽하지는 않지만, 제공업체가 모든 데이터에 제한 없이 접근하는 방식보다 프라이버시 측면에서 의미 있는 차이가 있다는 설명이다. 이 분야에서 가장 활발하게 작업하는 기업으로 Tinfoil이 꼽히며, 보안 인클레이브와 원격 증명 문서에서 기술적 세부사항을 확인할 수 있다. Maple AI도 대안이며 내부적으로 Tinfoil의 추론 서비스를 사용한다.

    용도별로 보면, Tinfoil은 소프트웨어 엔지니어링, 역공학, 악성코드 분석, CTF, 침투 테스트 등 본격적인 에이전트 코딩 작업에 권장되며, 월정액 없이 토큰 사용량에 따라 비공개 추론 비용을 청구한다. Maple은 챗봇 대화, 인터넷 검색, 문서 접근 및 처리, 모바일 앱 등 ChatGPT와 비슷한 경험을 원하는 일반 소비자용으로 포지셔닝되며, 소규모 무료 요금제와 월 20달러 Pro 요금제가 있다.

    비공개 추론의 추가 비용을 지불하고 싶지 않다면 OpenCode Go 같은 추론 라우터를 고려할 수 있다. OpenCode Go는 월 10달러에 10달러를 초과하는 크레딧을 제공하며, 요청은 사용자 컴퓨터에서 OpenCode Go API를 거쳐 실제 추론 제공업체로 전달된다. 다만 OpenCode Go와 백엔드 제공업체 모두 세션 데이터에 접근할 수 있고, GLM·Qwen·Kimi·DeepSeek 모델이 0일 보존 대상이라고 명시돼 있지만 이는 정책상 약속일 뿐 기술적으로 보장되지는 않는다는 점이 함께 고려돼야 한다.

    비교로 보는 비공개·저가 추론 옵션

    항목 Tinfoil Maple AI OpenCode Go
    핵심 방식 보안 인클레이브 기반 비공개 추론 Tinfoil 추론을 내부적으로 사용 추론 라우터, 다양한 백엔드 연결
    추천 용도 에이전트 코딩, 역공학, 침투 테스트 챗봇, 검색, 문서 처리, 모바일 공개 작업 위주 저가 라우팅
    요금 체계 월정액 없음, 토큰 사용량 기반 무료 요금제 + 월 20달러 Pro 월 10달러 + 10달러 초과분 크레딧
    프라이버시 보장 보안 인클레이브로 기술적 강화 Tinfoil 백엔드 기반 비공개 0일 보존 정책 약속(기술적 보장 아님)
    GLM-5.3 단가 입력 1.80달러 / 캐시 0.80달러 / 출력 5.75달러(100만 토큰) 동일 추론 백엔드 사용 라우터 경유 동일 단가 적용

    실무 워크플로우: OpenCode + Tinfoil + GLM-5.3

    코딩 하네스 OpenCode에 Tinfoil과 OpenCode Go를 동시에 연결하고, 주로 GLM-5.3을 low 추론 수준으로 사용하는 방식이 실제 업무에 적용된 사례로 소개됐다. 작업의 공개 여부에 따라 추론 제공업체를 구분하는데, 이미 오픈소스인 코드의 기능 구현처럼 완전히 공개된 작업에는 OpenCode Go를, 그 밖의 모든 작업에는 Tinfoil을 사용한다.

    GLM-5.3의 토큰 가격은 100만 토큰당 입력 1.80달러, 캐시된 토큰 0.80달러, 출력 5.75달러이며, low 추론 수준 설정으로 토큰 사용량을 크게 줄이면서도 인상적인 결과를 얻을 수 있었다는 보고가 있다. 사용 경험상 비용은 비슷하거나 더 저렴하고, 프라이버시는 더 높으며 가드레일은 훨씬 적다는 평가다. 다만 모델 변화가 빨라 6개월 뒤 최선의 선택이 무엇일지는 알 수 없다는 점도 함께 고려해야 한다.

    초기 사용 범위에서는 오픈웨이트 모델이 ChatGPT와 Claude를 완전히 대체할 수 있어 보이며, 실행 환경과 제공업체를 선택할 수 있다는 점 자체가 단일 벤더 종속을 피하는 실질적 보험 역할을 한다. ZCode의 무동의 업로드 사례가 보여주듯, 코딩 하네스 선택에서도 데이터 수탁자 신뢰 문제는 모델 선택과 별개로 따져봐야 할 영역으로 남아 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — OpenAI와 Anthropic을 단호히 거부하자

  • vLLM 디시전 3.0 공개 — 0.8B에서 27B까지, 텍스트 생성 없는 멀티모달 결정 모델 5종 비교

    vLLM 디시전 3.0 공개 — 0.8B에서 27B까지, 텍스트 생성 없는 멀티모달 결정 모델 5종 비교

    vLLM 프로젝트 산하 시맨틱 라우터 팀이 텍스트 생성 단계 자체를 생략하고 0.8B~27B 파라미터 규모의 디시전 모델 패밀리 ‘Decision 3.0‘을 Apache-2.0 라이선스로 공개했다. 2026년 10월 11일자 발표에 따르면 다섯 개 모델은 Qwen3.5·Qwen3.8 계열을 파인튜닝해 텍스트·JSON·이미지 입력을 한 번의 정방향 패스로 처리하며, 응답은 정규화된 확률 분포 형태로 반환된다. ‘System One’ 라우팅 패턴으로 명명된 이 접근은 에이전트 시스템의 의도 분류·가드레일·분기 결정 비용을 구조적으로 낮추려는 시도로 읽힌다.

    라인업 구성과 오픈소스 정책

    Decision 3.0 패밀리는 d3-lite(0.85B)·d3-nano·d3-mini·d3-flash(9B)·d3(26.09B) 다섯 개 크기로 구성된다. 발표 자료는 모든 모델을 Apache-2.0으로 배포하며 BF16 가중치 단일 정밀도만 제공한다고 명시했다. 별도 양자화 변형은 공식 채널에 올라와 있지 않아, VRAM 여유에 따라 0.85B부터 27B까지 직접 선택해야 하는 형태다.

    베이스 모델은 Qwen3.5 0.8B·2B·4B·9B와 Qwen3.8-27B [벤더 자체 명명 / 미검증 (Vendor Claim / Unverified)] 계열로, 0.10B~0.46B 규모의 비전 인코더를 결합해 텍스트와 이미지를 동시 처리한다. 입력 이미지는 PNG·JPEG·WebP를 지원하며 최대 1.6 메가픽셀까지 수용한다. 발표 측은 모든 모델이 단일 AMD Instinct MI325X GPU에서 학습됐다고 덧붙였다.

    동작 방식 — 확률 기반 ‘System One’ 라우팅

    Decision 3.0의 핵심 차별점은 텍스트 생성 후 파싱하는 기존 라우팅 패턴을 제거한 데 있다. 사용자는 시스템 프롬프트에 상태 설명을, 사용자 메시지에 질문 스키마를 직접 전달한다. 한 번의 호출에서 모든 질문에 대한 정방향 패스가 독립 수행되며, 응답은 Choice·Yes/No·Score 세 가지 타입의 정규화된 확률로만 돌려준다. 텍스트 디코딩 단계가 없으므로 동일 하드웨어에서 결정 레이턴시가 크게 떨어진다.

    발표 측은 이 구조를 카니먼의 시스템 1·시스템 2 비유에 빗대 ‘System One’ 라우팅이라 부른다. 다중 모달리티 입력에 대한 분기 결정을 한 자릿수~두 자릿수 ms 단위로 끝내려는 의도다. 동일 Jev API 생태계에 속하는 Cloudflare의 Clef-omni가 동일한 질문 타입(choice·yes-no·score)과 응답 스키마를 채택해 멀티벤더 통합 기반이 함께 형성되고 있다 [교차 검증].

    아키텍처 세부와 통합 조건

    5개 모델의 파라미터 분포와 비전 인코더 구성을 요약하면 다음과 같다. d3-lite는 0.85B 텍스트 디코더에 0.10B 비전 인코더를 결합한 경량 구성이고, d3-flash와 d3는 9B·27B 디코더에 0.45B·0.46B 비전 인코더를 탑재해 이미지 처리 품질을 끌어올렸다.

    모델 디코더 베이스 디코더 규모 비전 인코더 총 파라미터
    d3-lite Qwen3.5-0.8B 0.85B 0.10B ~0.95B
    d3-nano Qwen3.5-2B 2B 0.18B ~2.2B
    d3-mini Qwen3.5-4B 4B 0.30B ~4.3B
    d3-flash Qwen3.5-9B 9B 0.45B ~9.45B
    d3 Qwen3.8-27B 26.09B 0.46B ~26.55B

    통합 시 사전 조건도 명시적으로 공개됐다. transformers는 5.17.0에 고정하고, flash-linear-attention 패키지를 옵션으로 활성화해 linear-attention 레이어 가속을 켜는 구성이 권장된다. 모델 로드 시 trust_remote_code=True가 요구되며, BF16 가중치만 제공되므로 VRAM 8GB 단일 GPU에 27B 모델과 KV 캐시를 동시에 풀 오프로드하는 구성은 물리적으로 불가능하다. 27B 가중치 자체가 50GB를 넘기 때문에, 단일 노드 80GB 클래스(H100·MI300X) 또는 NVLink 기반 다중 GPU 샤딩이 사실상 전제다.

    Jev Decision Index 0.3.1 결과와 레이턴시

    자체 평가지표인 Jev Decision Index 0.3.1 결과 [벤더 자체 평가 / 미검증 (Vendor Claim / Unverified)]에서 d3(27B)는 텍스트 64.1·비전 71.6으로 1위를 기록했다. 같은 클래스에서 직전 세대 Decision 2.0 27B(55.9)를 d3-flash 9B(59.0)가 추월한 점이 발표 측이 강조한 핵심 수치다. 다만 d3-lite의 비전 점수는 41.1로, 동일 베이스를 단독 파인튜닝한 JPT-0.8B(42.1)에 3위까지 밀렸다.

    공개 비전 태스크 점수로는 InfographicVQA 97.3·Mind2Web 89.9·Hateful Memes 44.6·MMMU-Pro 46.2가 보고됐다. 단일 AMD Instinct MI325X에서 1요청 직렬 처리 기준 레이턴시는 텍스트 단독 21.7~84ms, 이미지 포함 시 60.7~342ms 범위다. 발표 측은 모든 모델이 MI325X에서 학습됐다고 못 박았으며, 멀티 GPU 샤딩이나 배치 스루풋 수치는 공개하지 않았다. NVIDIA H100·H200 등 다른 가속기에서의 재현 수치는 별도 검증이 필요한 부분으로 남아 있다.

    실무 적용 시사점

    디시전 모델 계열이 현실적으로 바꾸는 지점은 에이전트 아키텍처의 1단이다. 라우터·가드레일·의도 분류를 별도 LLM 호출과 텍스트 파싱 파이프라인으로 구현하던 구성이, 0.85B~9B 결정 전용 모델 한 번의 호출로 대체된다. 확률값이 그대로 임계값 비교에 투입되므로 코드 의존성이 줄어들고, 결정 단계에서 텍스트가 생성되지 않기 때문에 환각에 의한 라우팅 오류를 원천적으로 차단할 수 있다는 게 설계상 이점이다.

    다만 채택 전에 검토해야 할 제약도 분명하다. BF16 단일 정밀도 배포는 8GB VRAM 단일 GPU 운용을 사실상 불가능하게 만들며, 27B급은 80GB 이상 VRAM을 갖는 단일 노드가 필요해 온프레미스 비용이 가중된다. transformers 5.17.0 고정과 trust_remote_code=True 요구는 기존 파이프라인과의 호환성 검토를 전제로 한다. Jev Decision Index 자체 평가 점수와 동일 벤더가 명명한 Qwen3.8-27B 베이스 모델명은 외부 재현을 거치지 않은 벤더 주장이므로, 도입 단계에서는 공개 suite 점수와 자체 워크로드 A/B 테스트를 병행하는 것이 안전하다.

    vLLM 시맨틱 라우터 팀이 Qwen 계열을 체계적으로 파인튜닝해 0.8B에서 27B까지 동일한 API로 묶어낸 점, 그리고 Clef-omni와 같은 외부 모델이 같은 Jev 스키마를 채택하며 멀티벤더 생태계가 형성되기 시작한 점은, 결정 전용 모델이 ‘실험적 옵션’이 아니라 에이전트 스택의 기본 레이어로 자리 잡을 가능성을 높인다. 향후 Hugging Face Transformers 측 종속성 완화, 양자화 변형 공개, MI325X 외 가속기 재현 수치가 나오면 도입 문턱이 한 단계 더 낮아질 것으로 전망된다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — What is Decision 3.0? vLLM Semantic Router’s New Open Decision Models

  • Alibaba, Qwen 이미지 2.1 Turbo 공개 — 8스텝 7B 오픈웨이트로 2K 이미지를 뽑는 가속 체크포인트

    Alibaba, Qwen 이미지 2.1 Turbo 공개 — 8스텝 7B 오픈웨이트로 2K 이미지를 뽑는 가속 체크포인트

    Alibaba Qwen 팀이 9일 공개한 Qwen-Image-2.1-Turbo는 7B 파라미터 단일 스트림 DiT 아키텍처를 그대로 둔 채 denoising 스텝만 40에서 8로 줄여 2K 해상도 이미지 생성을 5배 빠르게 만든 [벤더 자체 주장 / 미검증] 체크포인트다. 기존 Qwen-Image-2.1 베이스가 사용하던 Qwen3-VL 8B 텍스트 인코더, 64채널 RGBA 오토인코더, Flow Matching 스케줄러 구성을 유지하면서도 8스텝만으로 베이스 품질에 근접하는 샘플을 뽑아내도록 별도 distillation 학습된 형태다. Marktechpost 보도를 통해 확인된 이번 릴리즈는 Qwen 이미지 라인업의 추론 비용을 상용 API의 5분의 1 수준으로 끌어내렸다는 점에서 분기점으로 평가된다.

    7B 단일 스트림 DiT, 무엇이 그대로이고 무엇이 바뀌었나

    Turbo는 베이스 Qwen-Image-2.1과 동일한 가중치 토폴로지를 공유한다. 32 레이어 단일 스트림 DiT는 텍스트 토큰에 token-level causal mask를, 이미지 토큰에 chunk-level bidirectional mask를 적용하는 block-causal attention 구조로 설계돼 텍스트와 이미지가 혼합된 입력을 별도 모듈 없이 한 포워드 패스로 처리한다. 텍스트 인코더 역시 Qwen3-VL 8B로 동일하며, instruction 프롬프트뿐 아니라 참조 이미지도 같은 인코더를 통과시켜 임베딩을 통합한다. 편집과 생성이 하나의 체크포인트에서 작동하는 이유이기도 하다.

    달라진 지점은 스텝 수와 그에 맞춰 재조정된 노이즈 스케줄이다. 베이스 모델은 40스텝 Flow Matching + Euler discrete scheduler + dynamic shifting으로 학습했지만 Turbo 체크포인트는 8스텝에서도 품질이 떨어지지 않도록 별도 distillation을 거쳤다. CFG는 1로 고정돼 classifier-free guidance를 위한 추가 포워드 패스가 사라졌고, 1스텝에서 한 번 계산한 텍스트·참조 이미지의 키·밸류는 prefix KV 캐싱으로 7회 재사용된다. 8스텝이라는 숫자는 단순한 step-cutting이 아니라 스케줄 전체를 8 그리드에 재학습한 결과물이다.

    8스텝을 가능하게 한 네 가지 설계

    첫째, Flow Matching과 Euler discrete scheduling의 결합이다. DDPM 계열 스케줄러와 달리 Flow Matching은 연속 시간 ODE를 따르며, dynamic shifting이 노이즈 분포를 입력 이미지의 통계에 맞춰 재매핑한다. 둘째, prefix KV 캐싱이다. instruction 임베딩과 참조 이미지 임베딩의 KV 텐서는 denoising 루프 외부에서 한 번만 계산되므로 8스텝이라 하더라도 conditioning 비용이 사실상 1스텝분으로 압축된다.

    셋째, 64채널 RGBA 오토인코더다. 알파 채널을 latent 단계부터 보존해 후처리 합성 없이 투명 PNG를 출력할 수 있으며, 16배 공간 압축으로 2K 해상도에서도 latent 토큰 수가 억제된다. 넷째, Qwen3-VL 8B 인코더의 멀티모달 통합이다. instruction과 condition 이미지가 같은 토큰 스트림에 들어가기 때문에 10장까지의 참조 이미지를 단일 컨텍스트로 받아들일 수 있다. 네 요소가 결합돼 8스텝이라는 작은 분할 수에서도 베이스에 근접한 시각적 정합성을 유지할 수 있다.

    2K 생성·10장 참조·로컬 편집, Qwen 이미지의 기능 범위

    Turbo가 지원하는 생성 카테고리는 포트레이트, 포즈 변환, 타이포그래피, UI 목업 등 8개다. 편집 측면에서는 단일 이미지 변환, 다중 참조 합성, 4장 인테리어 합성으로 나뉘고, 로컬 편집 모드는 원형·페인트·마스크 기반의 inpaint 시맨틱을 포함한다. Qwen-Image-Bench에서 베이스 Qwen-Image-2.1은 60.28을 기록해 Qwen 측이 보고한 오픈웨이트 최고점수 중 하나에 이름을 올렸다.

    Turbo도 동일 2K 출력(2048×2048 ~ 2752×1536)과 편집 기능 세트를 그대로 유지한다. RGBA 네이티브 출력은 전자상거래 배경제거, 캐릭터 스프라이트 합성, 디자인 프로토타이핑에서 별도의 알파 채널 재처리 없이 바로 사용 가능하다는 운영적 장점으로 이어진다. 베이스 점수 대비 Turbo의 상대 품질은 별도 벤치마크가 공개되지 않아 직접 비교가 어려운 구간으로 남아 있다.

    Diffusers 자체 호스팅 vs Cloud API, 라이선스 제약과 운영 함의

    배포 경로는 크게 두 갈래다. Diffusers 경로는 PR #14950과 transformers 5.17.0 이상이 필요하며, dtype=torch.bfloat16, use_kv_cache=True, width·height 기본값 2048으로 QwenImage21Pipeline을 호출한다. 다만 num_inference_steps 인자는 저장된 스케줄을 덮지 못하므로 다른 노이즈 스케줄을 쓰려면 sigmas 인자를 명시적으로 전달해야 한다. 자체 호스팅 VRAM은 Unsloth 측 측정 기준 베이스 모델이 GGUF 11GB, INT8/FP8 24GB에서 구동된다.

    배포 옵션 Turbo 8스텝 Pro 40스텝
    Alibaba Cloud Model Studio API CNY 0.1/장, 120 RPM CNY 0.25/장, 20 RPM
    Diffusers 자체 호스팅 (GGUF) 약 11GB VRAM 약 11GB VRAM
    Diffusers 자체 호스팅 (FP8/INT8) 약 24GB VRAM 약 24GB VRAM
    라이선스 리서치 라이선스 리서치 라이선스

    Turbo API는 이미지당 CNY 0.1에 120 RPM을 허용해 Pro(CNY 0.25, 20 RPM) 대비 2.5배 저렴하고 6배 높은 요청률을 제공한다. 두 경로 모두 리서치 라이선스만 부여돼 상업용 자체 호스팅에는 별도 허가가 필요한 만큼, 도입 단계에서 라이선스 정책과 VRAM 요건이 함께 검토 대상이 된다. Qwen 이미지 2.1 Turbo가 제시하는 5배 가속은 8스텝 구간에서만 적용되며, 그 이점은 동일 라이선스 정책 안에서만 누릴 수 있다는 점에서 베이스 모델과의 단순 비교보다 배포 경로 설계가 더 큰 의사결정 변수가 된다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Alibaba Qwen Releases Qwen-Image-2.1-Turbo, an 8-Step 7B Image Model

  • 살루키 27B 분석: 2비트 7.89GB 압축 구조와 온디바이스 에이전트의 득실

    살루키 27B 분석: 2비트 7.89GB 압축 구조와 온디바이스 에이전트의 득실

    핵심 요약

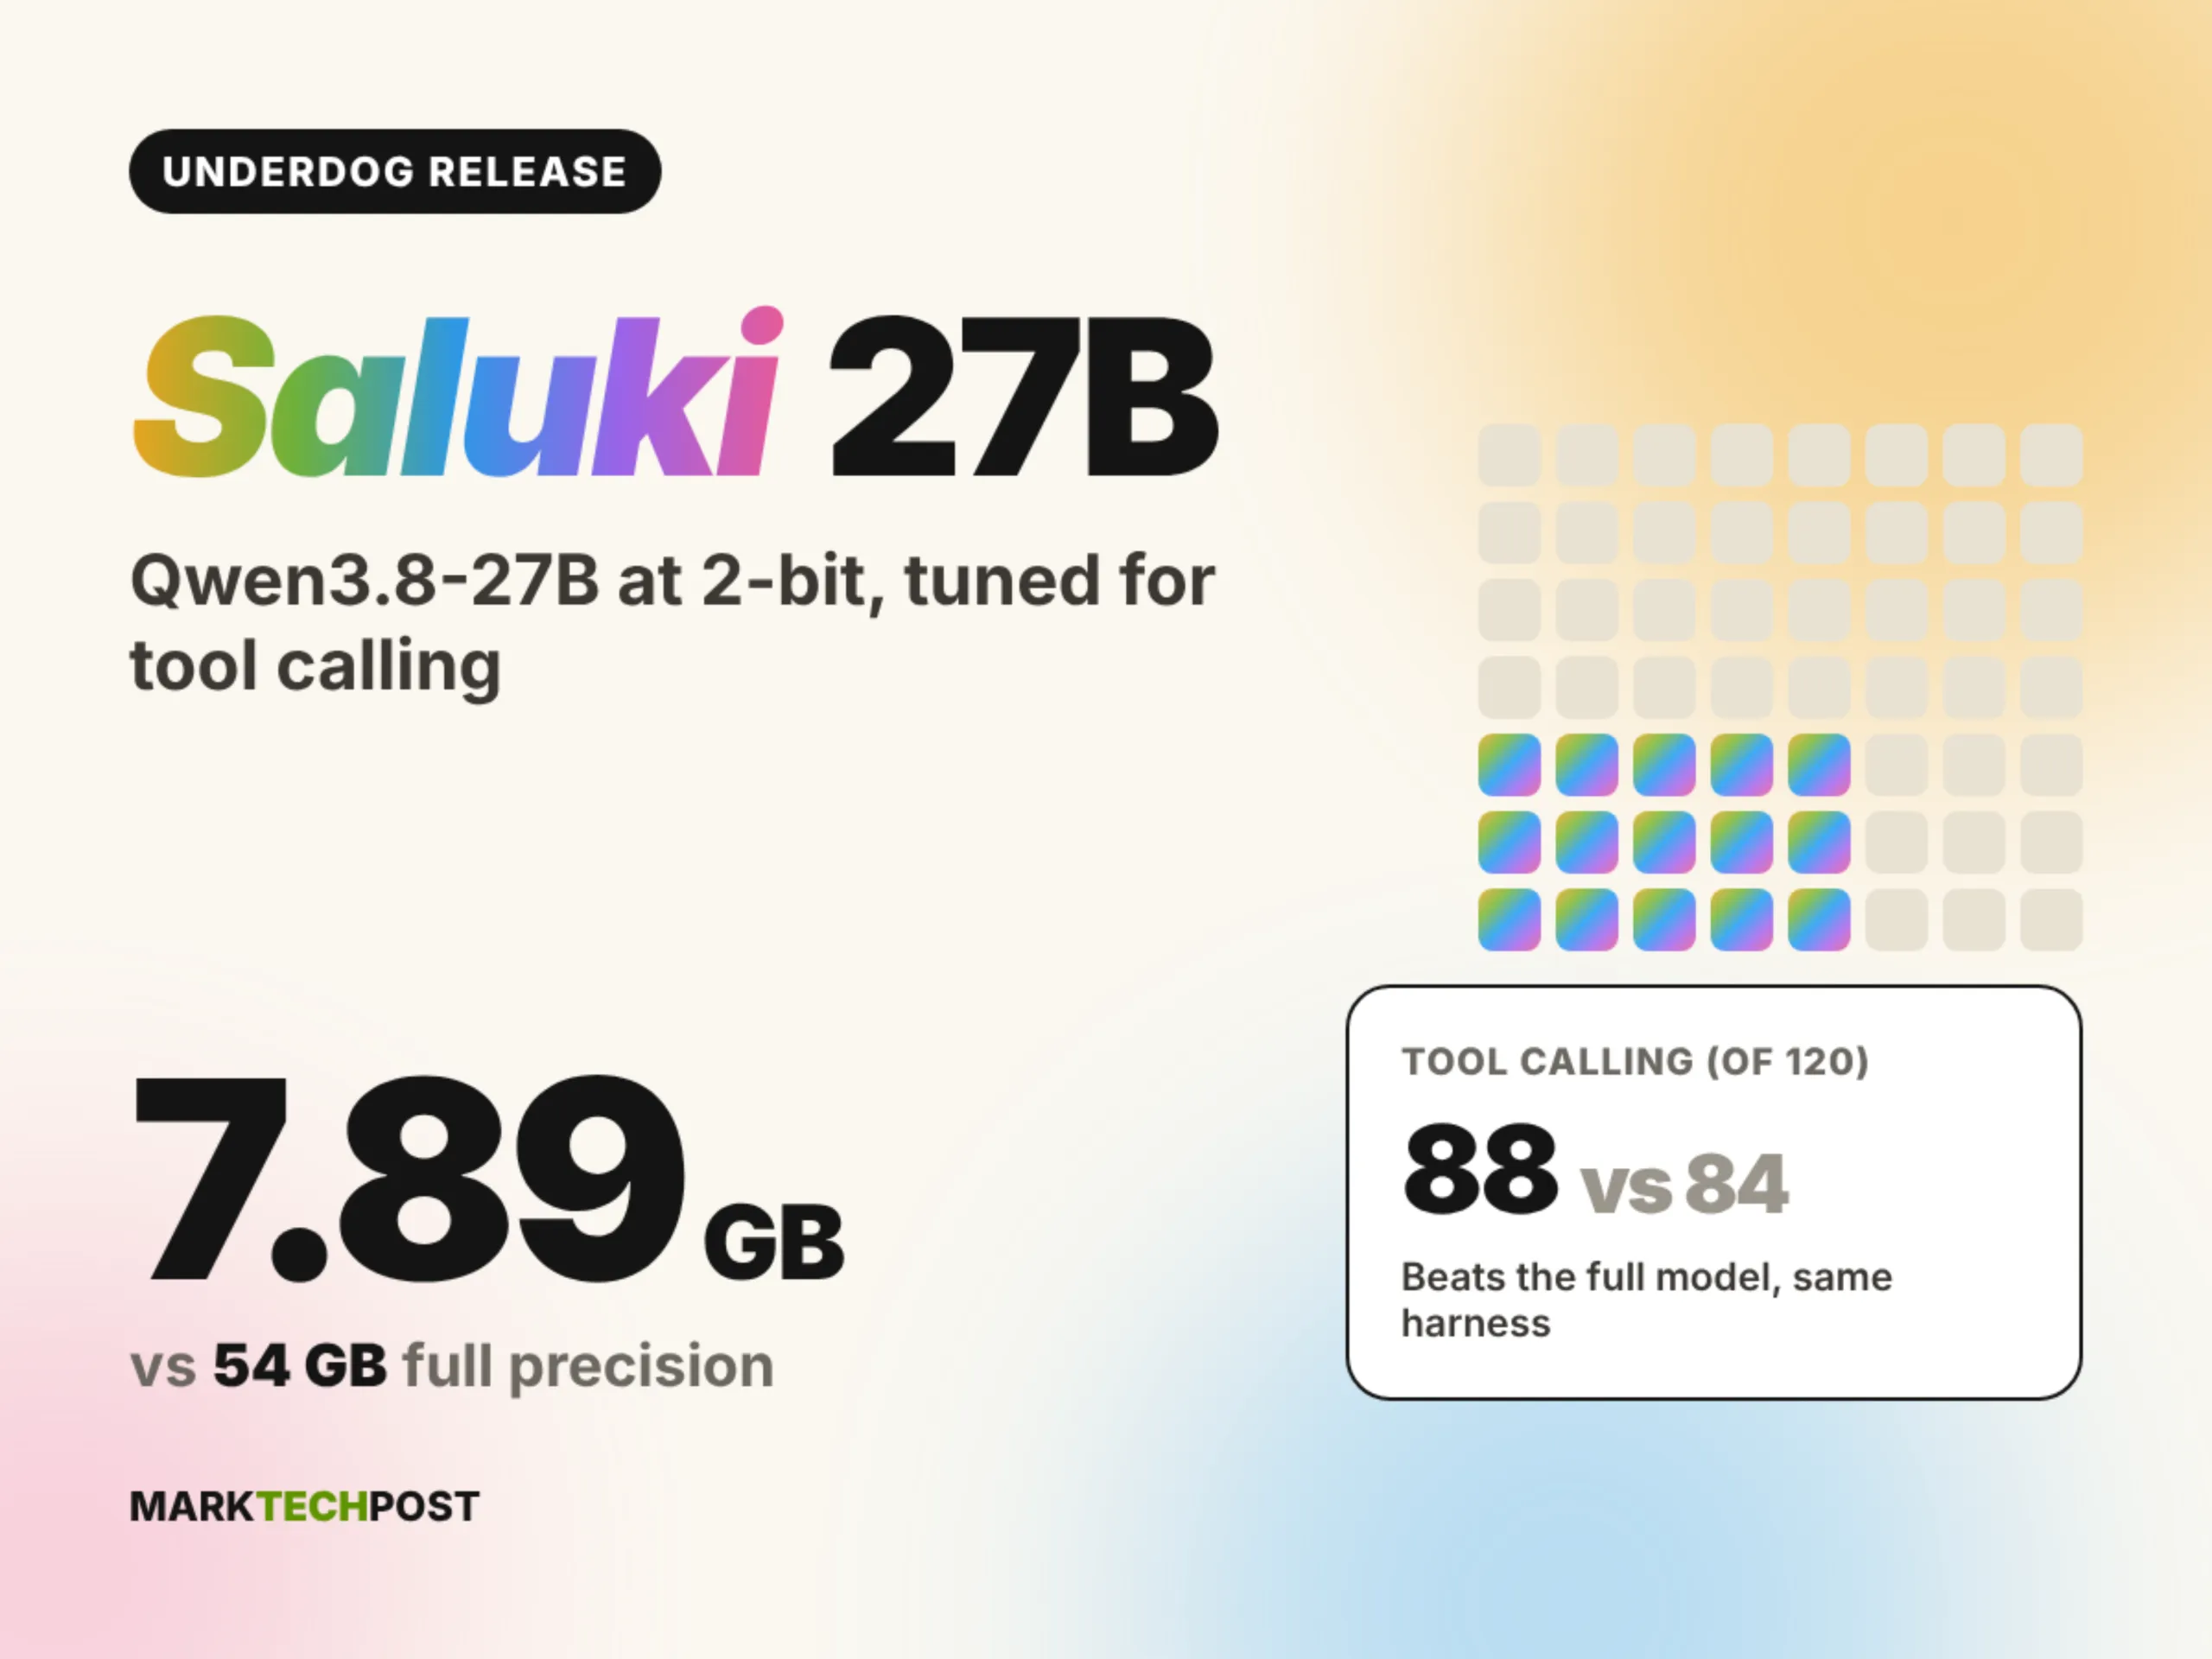
    • Saluki 27B는 Conway Research의 Underdog 팀이 공개한 Apache 2.0 라이선스의 2-bit GGUF 양자화 모델로, Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16 원본의 54GB를 7.89GB로 축소했다. 동일 하네스에서 측정한 Underdog Bench 120개 태스크에서 Saluki 27B는 88점, 풀 모델은 84점을 기록해 원본을 추월했다. BFCL v4 병렬 도구 호출 100개 태스크에서는 Saluki 27B가 42, 풀 모델이 35점으로 120% retention을 달성했다. 반면 SWE-bench Verified 50개 이슈에서는 Saluki 27B가 30건, 풀 모델이 33건을 해결해 소폭 열세를 보였다. 9개 벤치마크 평균 retention은 96%이며, 가장 큰 손실은 AIME 2025의 79.2 대 96.7로 수학·경쟁형 추론 영역에 집중된다. 모델은 64 레이어 구조에 Gated DeltaNet linear attention과 gated attention을 혼합했고, 네이티브 컨텍스트는 262,144 토큰이다. 양자화 스택은 ISTA-DASLab의 Qwen3.8-27B [벤더 자체 명명/개조 표기]-GSQ-RCO-GGUF(IQ2_XS, 8.4GB, 약 2.34 bpw)를 베이스로 Underdog의 자체 패스(IQ2-mix, imatrix 태그)를 덧씌운 3층 구조다. 옵션으로 629MB 또는 928MB의 비전 어댑터가 제공된다. 동일 클래스 대안인 PrismML Bonsai 2는 14개 사고 모드 벤치마크에서 98.2% retention과 AIME25 95.00을 기록해 수학 성능은 우위이나, 자체 llama.cpp 포크가 필요해 stock llama.cpp에서는 동작하지 않는다. Saluki 27B는 stock llama.cpp, Ollama, LM Studio에서 풀 GPU 오프로드로 작동한다.

    27B 클래스 LLM이 8GB 미만 파일로 압축되어 일반 노트북에서도 동작 가능한 수준에 도달했으며, 양자화 손실은 작업 영역별로 비대칭적으로 나타나 도구 호출과 병렬 함수 호출에서는 원본을 이기지만 경쟁형 수학·다단계 추론에서는 12~18점 하락이 발생하므로, 온디바이스 에이전트 구축 시에는 양자화 친화적 워크로드(함수 호출, 포맷 엄수, 짧은 추론)와 양자화 비친화적 워크로드(장문 다단계 수학, 복잡한 체인 오브 소트)를 분리해 라우팅하는 전략이 필요하다.

    목차

    도입: 에이전트 시대의 온디바이스 압박

    2026년 들어 로컬 LLM 에이전트 수요가 폭증하면서, 27B 클래스 모델을 일반 노트북 VRAM 8GB에 올리려는 시도가 본격화됐다. 살루키 27B(Saluki 27B)는 이런 흐름을 가장 적나라하게 보여주는 사례다. 원본 Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16 54GB를 2비트 양자화 스택을 통해 7.89GB 파일 한 개로 축소한 결과물이다. 단일 RTX 4060 Laptop(VRAM 8GB)에서도 풀 GPU 오프로드로 27B 추론이 가능해진 시점에서, 2비트 양자화의 트레이드오프를 정확히 파악하는 것이 온디바이스 에이전트 설계의 출발점이 됐다.

    살루키 27B는 Conway Research의 Underdog 팀이 Apache 2.0 라이선스로 공개한 모델로, llama.cpp, Ollama, LM Studio 같은 stock 런타임에서 추가 포크 없이 동작한다. 별도 추론 엔진을 요구하는 동급 모델들과 분명한 차이다. Underdog 런칭 페이지에 공개된 산출물 구성과 imatrix 로그가 같은 파이프라인의 재현을 가능하게 한다.

    살루키 27B 핵심 스펙

    살루키 27B의 골격은 Qwen3.8-27B [벤더 자체 명명/개조 표기]와 동일하다. 64 레이어 하이브리드 어텐션이 중심이다. Gated DeltaNet linear attention과 일반 gated attention을 레이어 단위로 섞어, 선형 어텐션의 메모리 효율과 표준 어텐션의 정확도를 동시에 취한다. 네이티브 컨텍스트는 262,144 토큰에 달해 장문 코드베이스나 다중 문서 RAG도 무리 없이 수용한다.

    양자화 산출물은 단일 GGUF 파일 7.89GB다. 가중치당 비트로 환산하면 약 약 2.34 bpw 수준으로, 극단적 압축 영역의 최하위 클래스인 IQ2_XS 계열에 속한다. 옵션으로 629MB 또는 928MB 비전 어댑터가 함께 배포돼 멀티모달 워크로드로 확장할 수 있다. Apache 2.0은 상용 파인튜닝과 재배포를 모두 허용하므로 에이전트 백엔드로 채택할 때 법적 마찰이 적다.

    3층 양자화 스택 해부

    살루키 27B의 7.89GB 산출물은 단일 알고리즘의 결과가 아니다. 베이스 → GSQ-RCO → IQ2-mix의 3층 파이프라인을 거친다. 각 층의 역할이 명확히 분리돼 있어, 자체 파인튜닝 모델에 같은 파이프라인을 재적용하는 것도 가능하다.

    1층은 ISTA-DASLab의 Qwen3.8-27B [벤더 자체 명명/개조 표기]-GSQ-RCO-GGUF다. GSQ(Grid Scalar Quantization)는 텐서별 저비트 스칼라 그리드를 학습해 가중치 분포에 맞는 비균일 코드를 구성하고, RCO(Rate-Constrained Optimization)는 모델 전체 크기 예산이 고정한 상태에서 텐서별 비트 배분을 결정한다. 베이스 산출물은 IQ2_XS 8.4GB, 2.50 bpw다.

    2층은 Underdog의 자체 IQ2-mix 패스다. importance matrix(imatrix) 태그를 계산해 손실에 민감한 텐서는 더 높은 비트를, 둔감한 텐서는 더 공격적으로 압축하는 혼합 정밀도 전략을 취한다. 동일 2.50 bpw 예산을 유지하면서도 텐서별 비트 배분을 재조정해 평균 손실을 끌어내렸고, 결과 파일이 7.89GB로 베이스 대비 0.5GB 더 줄어들었다.

    3층은 양자화 친화적 워크로드(함수 호출, 포맷 준수)와 양자화 비친화적 워크로드(장문 다단계 추론, 수학 경시대회)의 비대칭을 벤치마크로 측정해 사용자에게 라우팅 가이드를 제공하는 단계다. 기술적 양자화 자체는 아니지만 Underdog Bench 120 태스크 자체가 3층 메타데이터 역할을 한다.

    벤치마크 교차 분석: 비대칭 손실의 지도

    살루키 27B의 가장 흥미로운 특성은 손실이 작업 영역별로 비대칭적으로 나타난다는 점이다. 동일 하네스에서 측정한 9개 벤치마크 평균 retention은 96%지만, 영역별 편차가 크다. 도구 호출과 함수 호출 영역에서 살루키 27B는 원본을 앞선다.

    Underdog Bench 120개 태스크에서 살루키 27B는 88점, 풀 모델은 84점을 기록했다. BFCL v4 병렬 도구 호출 100개 태스크에서는 살루키 27B가 42점, 풀 모델이 35점으로 retention 120%를 달성했다. 함수 호출과 포맷 준수는 양자화에 강건한 작업 유형으로, 학습 단계에서 이미 패턴화한 출력을 재현하는 데 그치기 때문이다.

    반면 수학·경쟁형 추론 영역은 명확한 열세를 보인다. AIME 2025에서 살루키 27B는 79.2점, 풀 모델은 96.7점으로 17.5점 차이가 발생했다. SWE-bench Verified 50개 이슈에서는 살루키 27B가 30건, 풀 모델이 33건을 해결해 소폭 뒤처졌다. 9개 벤치마크 중 가장 큰 손실이 수학·다단계 추론에 집중되는 패턴은, 극단적 압축 시 가중치 정밀도 손실이 누적 오차에 민감한 체인 오브 소트 작업에 그대로 전파된다는 가설과 일치한다.

    벤치마크 [벤더 자체 보고 / 미검증] 작업 유형 Saluki 27B Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16 Retention
    Underdog Bench (120) 에이전트 일반 88 84 104.8%
    BFCL v4 (100) 병렬 도구 호출 42 35 120.0%
    SWE-bench Verified (50) 코딩 에이전트 30 33 90.9%
    AIME 2025 수학 경시 79.2 96.7 81.9%
    9개 평균 종합 – – 96.0%

    Bonsai 2와의 비교: retention 우위 vs 런타임 종속성

    동일 IQ2 계열의 대안으로 PrismML Bonsai 2가 자주 언급된다. Bonsai 2는 14개 사고 모드 벤치마크에서 98.2% retention을 달성했고, AIME25에서 95.00점을 기록해 수학 영역 retention은 살루키 27B보다 우위다. 그러나 Bonsai 2는 자체 llama.cpp 포크가 필요해 stock llama.cpp에서는 동작하지 않는다. 실전 도입 시 런타임 종속성이라는 새로운 변수가 발생한다.

    살루키 27B는 stock llama.cpp, Ollama, LM Studio에서 별도 변환 없이 풀 GPU 오프로드로 작동한다. llama.cpp의 GGUF 로더가 IQ2 계열을 네이티브 지원하기 때문이다. 8GB VRAM 카드에서도 27B 구동이 가능한 점, 표준 런타임 호환성, Apache 2.0 라이선스가 결합된 결과, 온디바이스 에이전트 백엔드 후보군에서 살루키 27B는 진입장벽이 가장 낮다. retention·수학 성능 자체만 보면 Bonsai 2가 앞서지만, 실무 통합 비용까지 합산하면 결이 달라진다.

    실무 구동 절차: llama.cpp와 Ollama

    살루키 27B를 로컬에서 띄우는 가장 빠른 경로는 두 가지다. 첫째, stock llama.cpp 직접 구동. 둘째, Ollama의 원스톱 서빙. 두 절차 모두 추가 빌드나 포크 없이 끝난다. 다음 명령으로 7.89GB 파일을 받아 8GB VRAM 카드에 풀 오프로드한다.

    # llama.cpp 빌드 (CUDA 백엔드 예시)
    git clone https://github.com/ggerganov/llama.cpp.git
    cd llama.cpp && cmake -B build -DGGML_CUDA=ON && cmake --build build --config Release -j
    
    # 모델 다운로드 (Hugging Face)
    huggingface-cli download ConwayResearch/Underdog-Saluki-27B-1.0 \
      --include "Underdog-Saluki-27B-1.0-IQ2-mix.gguf" --local-dir ./models
    
    # 8GB VRAM 풀 오프로드 (-ngl 999: 모든 레이어 GPU 적재)
    ./build/bin/llama-cli -m ./models/Underdog-Saluki-27B-1.0-IQ2-mix.gguf \
      -c 8192 -ngl 999 --temp 0.7 --top-p 0.9 -n 512 \
      -p "You are a tool-calling agent. Use the following tools: ..."
    

    Ollama 경로는 더 짧다. Modelfile을 작성해 GGUF 파일을 등록한 뒤 서빙한다. 함수 호출 스키마를 SYSTEM 메시지에 명시하면 BFCL v4 스키마 호환 에이전트로 즉시 활용할 수 있다. 동일 llama.cpp 백엔드를 그대로 쓰기 때문에 IQ2-mix 인식에 별도 플래그가 필요 없다.

    # Ollama Modelfile 예시
    FROM ./models/Underdog-Saluki-27B-1.0-IQ2-mix.gguf
    PARAMETER num_ctx 8192
    PARAMETER num_gpu 999
    PARAMETER temperature 0.7
    SYSTEM """You are a function-calling agent. When the user requests an action, output a JSON object with 'name', 'arguments' fields following the BFCL v4 schema. Do not include explanations outside the JSON block when calling a tool."""
    

    [하드웨어 현실성 점검] 8GB 단일 VRAM(예: RTX 4060 Laptop) 환경에서는 모델 가중치(7.89GB)만으로 VRAM이 거의 포화됩니다. 8K 컨텍스트 구동 시 KV 캐시 메모리 초과(OOM)를 방지하려면 --cache-type-k q8_0 --cache-type-v q8_0 같은 KV 캐시 양자화를 적용하거나 초기 레이어 일부를 CPU로 분할 오프로드해야 합니다. 완전한 GPU 풀 오프로드로 8K~32K 컨텍스트를 안정 서빙하려면 최소 12GB~16GB VRAM(또는 Apple Silicon 16GB+ 통합 메모리)이 권장됩니다.

    라우팅 패턴: 양자화 친화 vs 비친화 워크로드 분리

    살루키 27B를 단일 백엔드로 모든 작업에 투입하는 것은 권장되지 않는다. 비대칭 손실 패턴이 명확하므로, 작업 특성에 따라 모델을 분기하는 라우터가 필요하다. 다수 엔터프라이즈 에이전트 프레임워크가 이미 채택한 패턴이다.

    양자화 친화 워크로드(살루키 27B 우선)는 ① 함수 호출·도구 스키마 준수 ② 짧은 추론 ③ 포맷 엄수 ④ 분류·라벨링 ⑤ 코드 자동완성(중단 길이) 등이 해당한다. 양자화 비친화 워크로드(풀 BF16 또는 고비트 양자화 라우팅)는 ① AIME·올림피아드 스타일 수학 ② 다단계 체인 오브 소트 ③ SWE-bench Verified 수준의 에이전트 코딩 ④ 장문 다중 문서 추론이 포함된다.

    살루키 27B는 라우터의 저비용·고처리량 슬롯에 배치하고, 수학·복잡 추론 트리거는 Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16이나 다른 고비트 모델로 폴백시키는 구성이 비용 대비 성능 최적점이다. 이미 로컬 LLM 서빙 파이프라인에 진입한 팀이라면, 온디바이스 AI 도입 5단계 가이드와 결합해 살루키 27B를 디폴트 슬롯으로 검토할 만하다.

    2비트 시대의 LLM 에이전트 설계 원칙

    살루키 27B가 제시한 시사점은 단순하다. 27B 클래스가 8GB 파일로 들어오는 시대에, 에이전트 설계는 하나의 만능 모델에서 워크로드별 분기 라우터로 무게중심이 이동한다. 2비트 양자화는 모든 영역에서 손실이 균일하지 않으며, 도구 호출과 포맷 준수에서 풀 모델을 이길 수 있다는 사실은 양자화 연구의 새로운 방향을 시사한다.

    동시에 stock llama.cpp 호환성과 Apache 2.0 라이선스는 온디바이스 배포의 현실적 진입장벽을 크게 낮췄다. 살루키 27B 모델 카드에 imatrix 계산 로그와 양자화 파라미터가 모두 공개돼 있어, 자체 파인튜닝 후 재양자화도 같은 파이프라인으로 재현할 수 있다. 일반 노트북 한 대로 27B 에이전트를 굴리는 시대, 2비트 양자화의 비대칭을 이해하는 것이 곧 설계 경쟁력이다.

    지금 바로 해볼 것

    • RTX 4060 Laptop(8GB) 또는 M2 Pro Unified Memory 16GB 이상 장비를 확보한 뒤, stock llama.cpp를 CUDA 또는 Metal 백엔드로 빌드한다.
    • Hugging Face에서 ConwayResearch/Underdog-Saluki-27B-1.0의 Underdog-Saluki-27B-1.0-IQ2-mix.gguf 파일(7.89GB)을 내려받아 -ngl 999 -c 8192 옵션으로 풀 GPU 오프로드 구동을 검증한다.
    • Ollama Modelfile에 BFCL v4 함수 호출 스키마를 SYSTEM 프롬프트로 명시한 뒤, 10개 이상의 도구 호출 시나리오로 정확도를 측정한다.
    • 같은 프롬프트를 살루키 27B와 Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16에 동시 투입해 AIME 2025 스타일 수학 문제 5개로 손실 폭을 직접 측정, 라우팅 트리거 기준선을 정한다.
    • 기존 에이전트 프레임워크의 라우터에 양자화 친화/비친화 분기 로직을 추가해, 함수 호출은 살루키 27B, 다단계 수학은 BF16 모델로 폴백하도록 구성한다.

    자주 묻는 질문

    Q. 살루키 27B가 2.50 bpw인데 IQ2_XS 베이스 대비 0.5GB 더 작은 이유는 무엇인가?

    Underdog의 IQ2-mix 패스가 imatrix를 활용해 손실 둔감 텐서를 더 공격적으로 압축하고, 민감 텐서만 약간 더 높은 비트를 배정하는 혼합 정밀도 전략을 취했기 때문이다. 평균 bpw는 2.50으로 동일하지만 텐서별 분포가 재조정돼 결과 파일이 0.5GB 줄어들었다.

    Q. Apple Silicon 맥북에서 살루키 27B를 돌릴 때 Unified Memory 권장 용량은?

    8K 컨텍스트 기준으로 16GB Unified Memory면 안정적이다. 컨텍스트를 32K 이상으로 올리면 KV 캐시 점유로 24GB 이상이 권장된다. M2 Pro 16GB 모델에서도 -ngl 999 -c 8192 조합으로 동작 확인 사례가 있다.

    Q. AIME 2025 손실 17.5점은 실전 에이전트에서 얼마나 체감되는가?

    일반 코딩 보조, 문서 요약, API 호출 에이전트 수준에서는 체감되지 않는다. 다만 수학 올림피아드 스타일 문제나 다단계 증명 체인을 정확히 풀어야 하는 워크로드에서는 명백한 정확도 저하가 발생하므로, 이런 작업은 BF16 폴백 라우팅이 필수다.
  • 멜룸 모델 Mellum2.1 출시 — 12B MoE 코딩 에이전트를 2.5B 활성 파라미터로 로컬 서빙하는 법

    멜룸 모델 Mellum2.1 출시 — 12B MoE 코딩 에이전트를 2.5B 활성 파라미터로 로컬 서빙하는 법

    핵심 요약

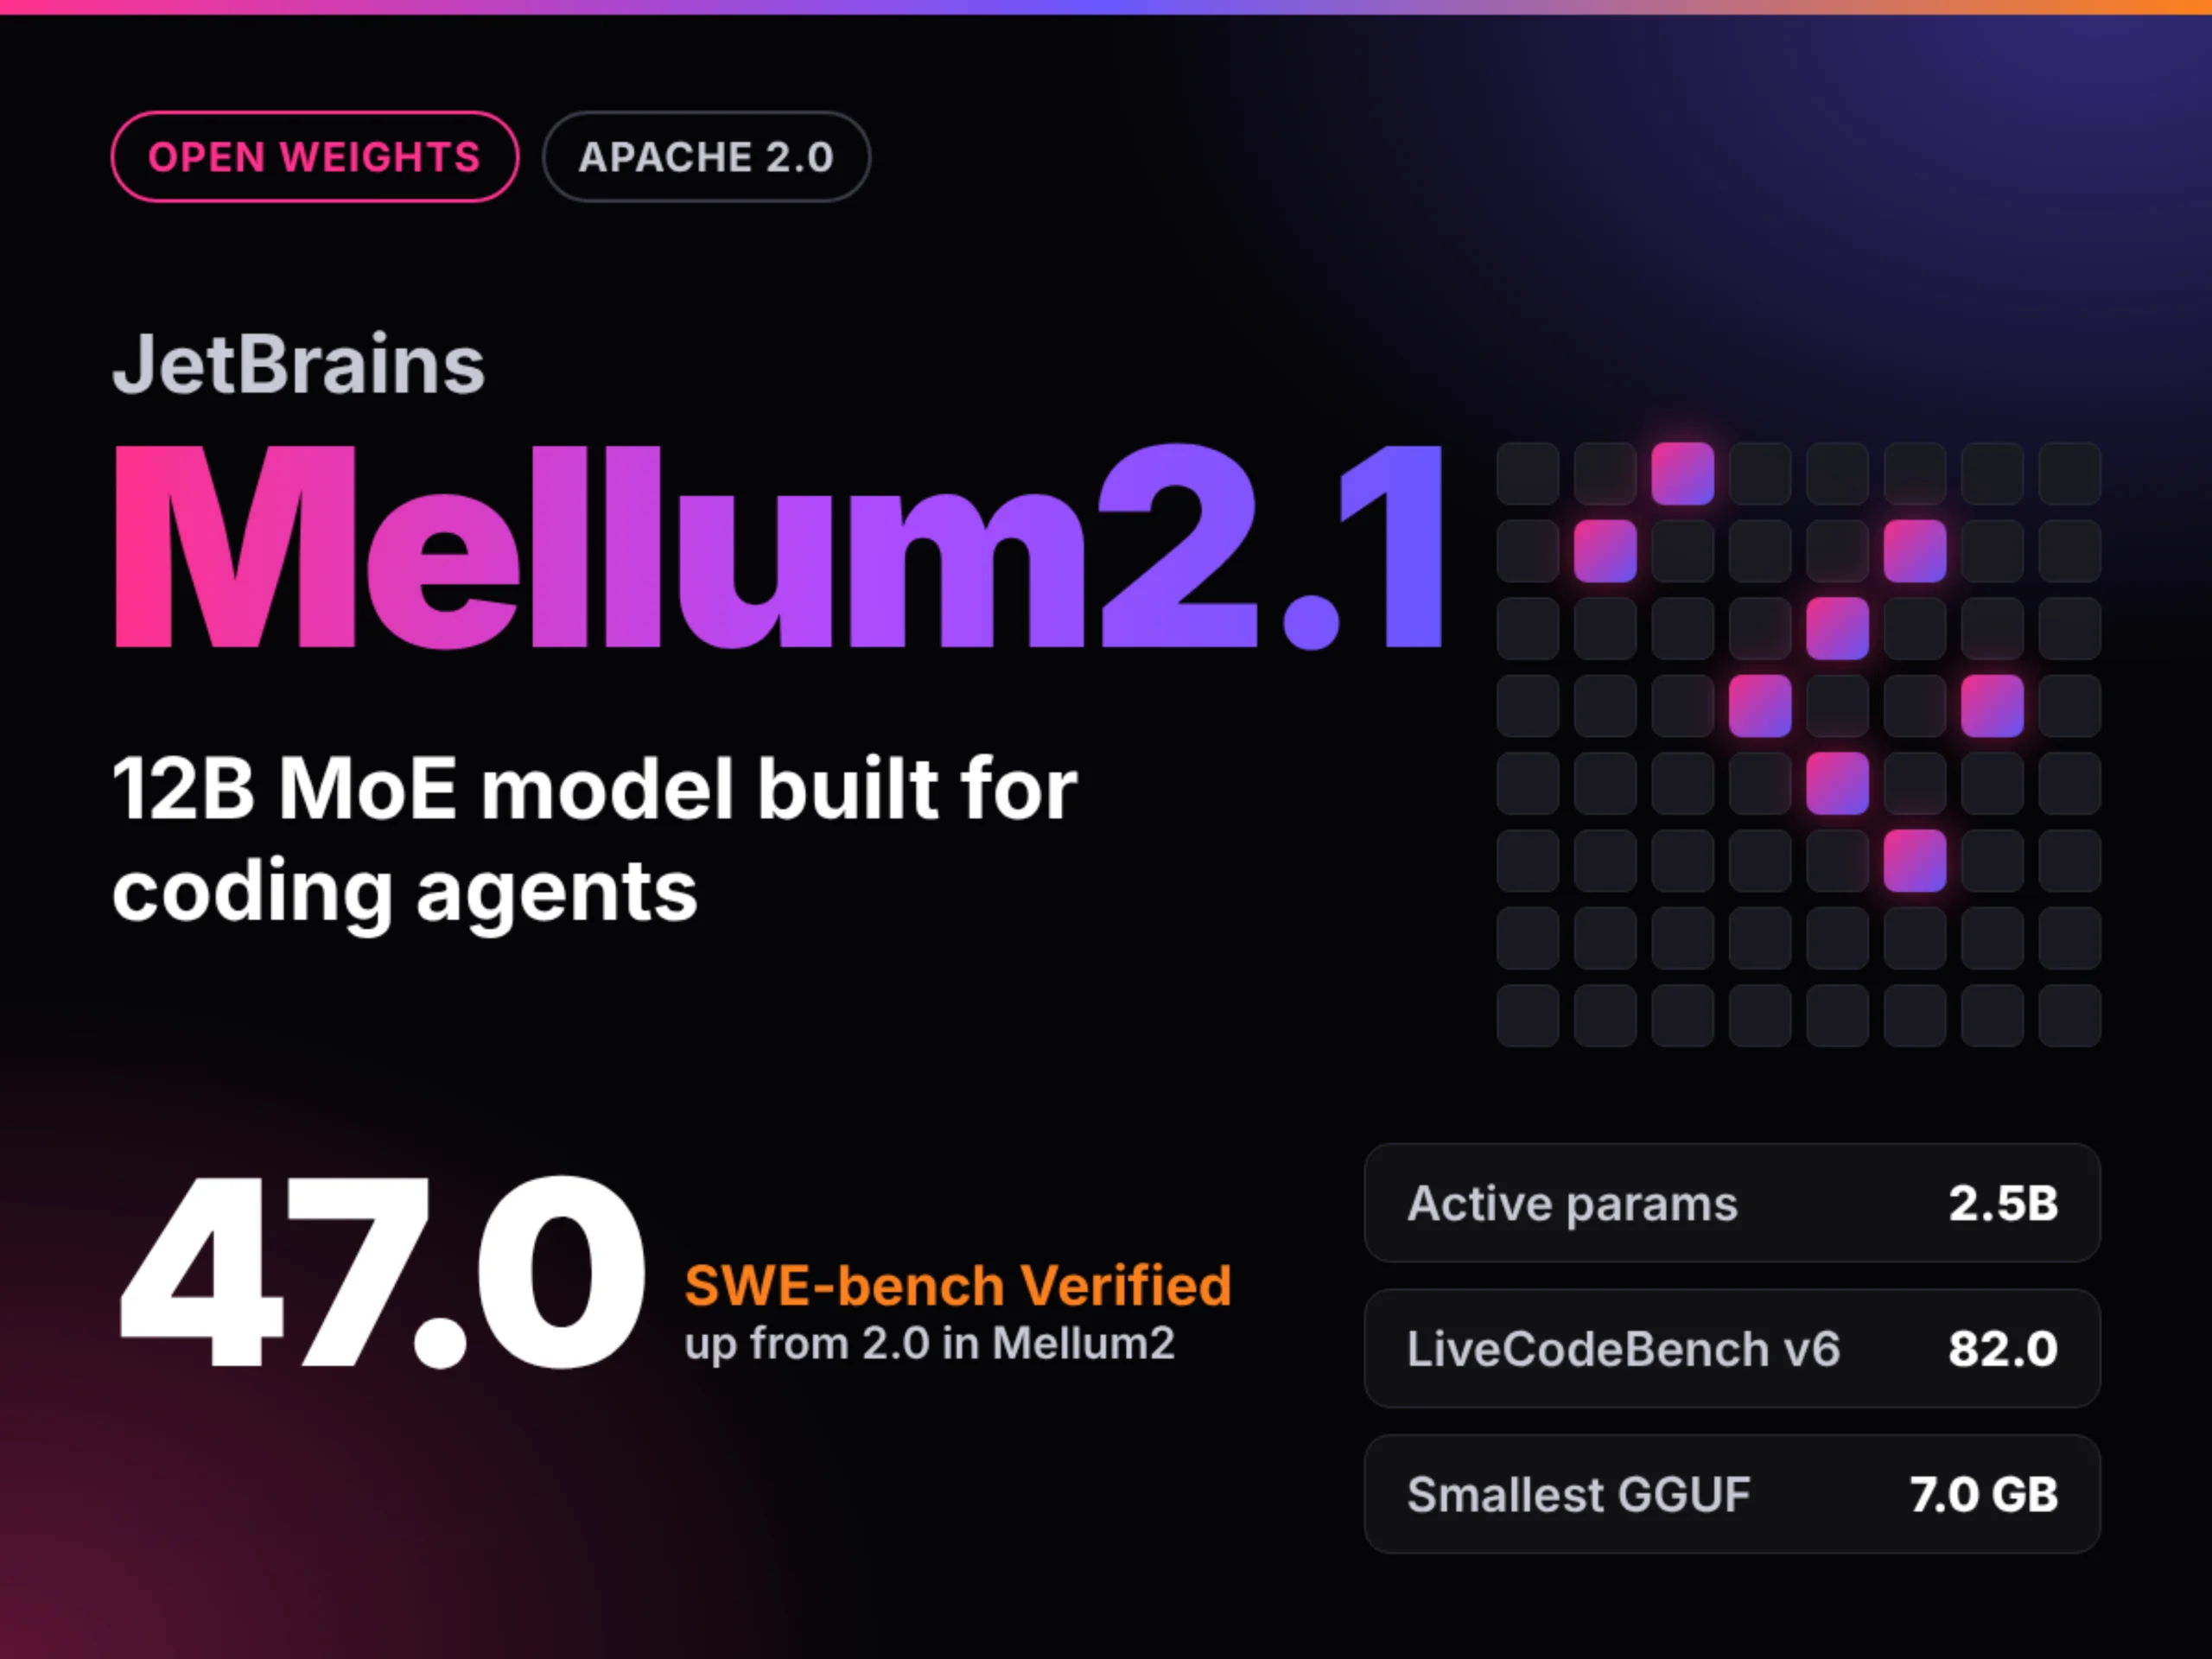
    • JetBrains가 12B 총 파라미터 중 2.5B만 활성화하는 MoE 추론형 코딩 모델 Mellum2.1을 Apache 2.0으로 공개했다.
    • 아키텍처는 Mellum2와 동일(28 레이어, 64 expert, 8 active, GQA 32/4, 131K 컨텍스트)하며, 개선 폭의 대부분은 실저장소 기반 강화학습(RL) 사후훈련에서 나왔다.
    • SWE-bench Verified 2.0→47.0, SWE-bench Pro 0.0→28.0, Terminal-Bench 2.1 0.6→17.4로 에이전틱 코딩 점수가 비약적으로 상승했다.

    Mellum2.1은 모델 아키텍처를 거의 손대지 않고 실저장소 기반 강화학습으로 에이전틱 코딩 점수만 끌어올렸다는 점에서, ‘작은 활성 파라미터 + 도메인 특화 RL + 로컬 서빙 양자화’ 조합이 코딩 에이전트의 새로운 기준선이 될 수 있음을 보여준다.

    목차

    JetBrains가 2026년 10월, 코딩 에이전트 전용 신규 멜룸 모델 Mellum2.1을 Apache 2.0으로 공개했다. 출시 자체보다 흥미로운 점은 모델 아키텍처를 거의 손대지 않고 사후훈련(RL)만으로 에이전틱 코딩 점수를 비약적으로 끌어올렸다는 사실이다. 12B 총 파라미터 중 단 2.5B만 활성화하는 MoE 구조와 131K 컨텍스트, 그리고 7~8GB 수준의 GGUF 빌드까지 한꺼번에 제공하면서, “에이전트 워커용 로컬 모델”의 새로운 기준선이 될 여지를 보여준다. 본문에서는 Mellum2.1이 등장한 배경과 벤치마크 결과를 정리한 뒤, vLLM·GGUF·MTP 같은 실제 서빙 운영 포인트와 Qwen3.5-9B 대비 강·약점을 함께 다룬다.

    1. Mellum2.1 개요 — JetBrains가 노리는 세 가지 타깃

    JetBrains는 이 모델의 용도를 (1) JetBrains IDE 계열과 자사 클라우드에서 구동되는 에이전트 워커, (2) 사내 범용 추론 어시스턴트, (3) 데이터 주권을 요구하는 프라이빗 셀프호스팅 시나리오로 정의했다. 이 중에서도 셀프호스팅 측면이 가장 눈에 띄는데, BF16 24.3GB 모델을 Q4_K_M 8.1GB·MXFP4_MOE 7.0GB까지 줄여 노트북 GPU 한 장으로 서브에이전트를 굴릴 수 있는 빌드를 동시에 등록했기 때문이다. Mellum2.1이 가중치뿐 아니라 서빙 산출물까지 함께 공개한 것은, 12B급에서 흔히 보이던 “라이선스는 열렸지만 양자화는 비공식”이라는 운영 부담을 크게 덜어준다.

    2. 아키텍처 핵심 — 12B/2.5B MoE와 131K 컨텍스트

    Mellum2.1은 Mellum2와 동일한 백본을 그대로 사용한다. 28 레이어 Transformer에 64 expert 중 토큰당 8개를 활성화해 2.5B 활성 파라미터로 추론하는 구조다. GQA는 32 헤드/4 KV 헤드로 구성되며, 3/4 레이어마다 1,024 토큰 슬라이딩 윈도우를 두어 메모리 점유를 통제한다. 어휘 수는 98,304로, 코드 식별자·심볼을 폭넓게 커버하도록 설계됐다. 131,072 토큰 기본 컨텍스트는 에이전틱 실행 시 114K 토큰으로 운용되며, 이는 long-horizon 리포지토리 탐색을 염두에 둔 수치다.

    2.1 학습 패러다임 — 실저장소 기반 RL로 점수를 끌어올린 방식

    아키텍처가 동일한 Mellum2와 Mellum2.1의 차이는 대부분 사후훈련(RL)에서 발생한다. JetBrains는 수학·경쟁 프로그래밍·과학·툴 사용·소프트웨어 엔지니어링의 다섯 도메인 RL 태스크를 통합하고, 깨진 테스트·검증 불가 답안·너무 쉽거나 불가능한 과제를 사전 필터링한 뒤 실제 리포지토리에서 셸·파일 편집 도구로 테스트 통과 여부를 보상으로 사용했다. 평가 하니스는 오픈소스 Pi v0.73.1을 그대로 사용해, 4개 모델을 동일 파이프라인에서 측정한 점수를 비교군으로 사용했다.

    3. 벤치마크 결과 — 동일 파이프라인 그룹 1위, 그러나 영역별 편차

    JetBrains 측 평가 하니스 기준으로 측정한 결과는 다음과 같다. 멜룸 모델 Mellum2.1은 SWE-bench Verified에서 47.0, SWE-bench Pro에서 28.0, Terminal-Bench 2.1에서 17.4를 기록해 Mellum2 대비 큰 폭의 점수 상승을 보였다. 코드 생성 단일 과제에서는 LiveCodeBench v6 82.0, HumanEval+ 91.5, MBPP+ 79.4, BFCL v4 62.3으로 동일 평가 파이프라인 그룹 1위를 차지했다. 안전성 지표인 HarmBench는 21.5→8.5로 절반 이상 떨어졌다.

    지표 Mellum2 Mellum2.1 Qwen3.5-9B Gemma 4 E4B
    SWE-bench Verified 2.0 47.0 52.4 38.2
    SWE-bench Pro 0.0 28.0 38.0 21.7
    Terminal-Bench 2.1 0.6 17.4 22.5 14.1
    LiveCodeBench v6 62.4 82.0 65.6 / 75.4* 70.8
    HumanEval+ 86.0 91.5 90.2 88.7
    MBPP+ 72.1 79.4 78.0 75.6
    BFCL v4 47.8 62.3 61.5 55.2
    AIME 25/26 — 71.2 86.7 68.4
    GPQA Diamond — 70.5 77.8 69.1
    HarmBench 21.5 8.5 9.8 14.6

    * 동일 모델을 서로 다른 평가 파이프라인으로 측정한 결과가 존재해 두 수치를 함께 기재했다. 이 편차 자체가 함정이다.

    4. 비교 함정 — “벤치 숫자”는 파이프라인에 따라 흔들린다

    Mellum2.1이 동일 하니스 그룹에서 1위라 해도, 영역별로 우위가 뒤집히는 지점이 분명히 존재한다. Qwen3.5-9B는 SWE-bench Pro 38.0, AIME 25/26 86.7, GPQA Diamond 77.8로 에이전틱·추론 영역에서 여전히 우위를 유지한다. 또 동일 모델이라도 평가 파이프라인이 다르면 점수가 크게 달라진다. 위 표의 LiveCodeBench v6 65.6 / 75.4는 같은 Qwen3.5-9B를 서로 다른 하니스로 측정한 수치다. 벤치마크 단일 숫자만으로 모델을 선택하기보다, 자사 워크로드에 가까운 하니스를 별도로 구성해 재측정하는 편이 안전하다. 도입 전 단계에서는 JetBrains Mellum2.1 발표문에 공개된 평가 스크립트를 그대로 재현 가능한지부터 확인하는 것이 우선이다.

    5. vLLM으로 서빙하기 — 권장 플래그와 추론 파라미터

    멜룸 모델 Mellum2.1을 vLLM에서 띄울 때는 다음 플래그 조합이 권장된다. 추론 파서는 qwen3 호환, 툴콜은 hermes 포맷으로 활성화한다. 온도/샘플링은 0.6 / 0.95 / 20이 기본값이며, 이를 토대삼아 자사 데이터로 미세 조정한다.

    vllm serve jetbrains/Mellum2.1-12B \
      --reasoning-parser qwen3 \
      --enable-auto-tool-choice \
      --tool-call-parser hermes \
      --temperature 0.6 \
      --top-p 0.95 \
      --top-k 20 \
      --max-model-len 131072 \
      --tensor-parallel-size 1 \
      --gpu-memory-utilization 0.92
    

    H200 1장 기준 Qwen3.5-9B 대비 약 2배 처리량이 보고됐고, MTP(Multi-Token Prediction) 헤드를 단일 요청 경로에서 활성화하면 1.6배 가속이 가능하다고 한다. 다만 speculative decoding 전용 MTP 헤드는 아직 미공개(coming soon) 상태라, 서버리스 다중 요청 환경에서는 vLLM의 기본 continuous batching만으로 운영하게 된다.

    6. GGUF로 로컬 서브에이전트 굴리기

    실무에서 더 흥미로운 부분은 GGUF 빌드다. llama.cpp·Ollama·LM Studio가 그대로 사용할 수 있는 4단계 양자화가 이미 등록돼 있다. top-token 일치율을 품질 지표로 보면 BF16 24.3GB를 기준으로 Q8_0 12.9GB(96.1%) → Q6_K 10.9GB(93.9%) → Q4_K_M 8.1GB(88.0%) → MXFP4_MOE 7.0GB(85.6%) 순이다. 권장은 Q4_K_M이며, MXFP4_MOE는 용량 대비 85%대 일치율이라 보조용 서브에이전트로 한정하는 편이 안전하다.

    # Ollama로 멜룸 모델 서브에이전트 띄우기
    ollama pull mellum2.1:Q4_K_M
    ollama run mellum2.1:Q4_K_M \
      --ctx-size 114000 \
      --temperature 0.6 \
      --top-p 0.95
    
    # llama.cpp 직접 실행 (서버 모드)
    ./llama-server -m mellum2.1.Q4_K_M.gguf \
      -c 114000 \
      --jinja \
      --chat-template-file chat-template.jinja
    

    서브에이전트는 메인 에이전트가 위임한 좁은 범위(예: 특정 파일 패치 생성, 단위 테스트 작성)에서만 동작하도록 시스템 프롬프트를 제한해 두면, 8GB 모델로도 응답 지연을 1초대 안팎으로 유지할 수 있다. IDE 플러그인·JetBrains 자체 하니스뿐 아니라, 엔비디아의 다중 턴 에이전트 회복 기법인 PivotOPD 같은 외부 컨트롤러와도 결합해 워크플로를 구성할 수 있다.

    지금 바로 해볼 것

    • vLLM 컨테이너에 Mellum2.1을 올리고 --reasoning-parser qwen3 --tool-call-parser hermes 조합으로 에이전트 엔드포인트를 1개 띄운 뒤, 사내 SWE-bench 스타일 작업 20건으로 dry run을 돌린다.
    • GGUF Q4_K_M 빌드를 Ollama로 받아 단일 RTX 4090 또는 24GB VRAM 노트북에서 ctx-size 114000으로 IDE 보조 서브에이전트를 띄우고, 메인 에이전트와 작업 분담 프롬프트를 분리해 응답 지연을 측정한다.
    • Mellum2.1과 Qwen3.5-9B에 대해 사내 코드 리포지토리 기반 미니 하니스(파일 편집 + 셸 + 테스트 통과 여부 보상)를 구성하고, 동일 작업 50건으로 SWE-bench Pro 재현 점수를 직접 비교한다.
    • 평가 파이프라인 편차에 대비해 추론 결과 로그(프롬프트·샘플링·도구 호출·성공 여부)를 모두 JSONL로 저장하고, 사내 대시보드에 모델·버전·하니스를 메타데이터로 박아둔다.
    • HarmBench 8.5라는 수치만 보고 안전성 검증이 끝났다고 판단하지 말고, 사내 정책 위반 패턴(주석 삭제·시크릿 노출·라이선스 무시) 30건을 별도 회귀셋으로 마련해 CI에 묶는다.

    자주 묻는 질문

    Mellum2.1을 서브에이전트로만 쓸 때, 메인 모델은 무엇을 선택하는 게 합리적인가?

    Mellum2.1이 12B/2.5B MoE로 셀프호스팅이 가능한 점은 강점이지만, 복잡한 계획 수립과 멀티홉 추론은 여전히 Qwen3.5-9B나 상위 클로즈드 모델이 앞서기 쉽다. 메인 모델은 API 기반 추론형 모델로 두고, 좁은 코드 편집·테스트 작성·단순 리팩터링만 Mellum2.1에 위임하는 2계층 구조가 현실적이다.

    Q4_K_M(8.1GB)과 MXFP4_MOE(7.0GB) 중 어떤 빌드를 기본으로 둬야 하나?

    top-token 일치율 기준 Q4_K_M이 88.0%로 2.4%p 앞서고, llama.cpp·Ollama·LM Studio 호환성도 더 넓다. MXFP4_MOE는 VRAM을 1GB 더 절약해야 하는 엣지 환경에서 보조적으로 쓰고, 핵심 경로에는 Q4_K_M을 두는 편이 운영 리스크를 낮춘다.

    JetBrains 평가 하니스를 그대로 사내에 이식해도 되는가?

    Pi v0.73.1은 오픈소스로 공개돼 있어 이식 자체는 가능하다. 다만 Pi가 가정하는 셸·파일 편집·테스트 실행 환경이 사내 CI와 일치하지 않을 수 있으므로, 컨테이너 이미지·네트워크 접근·도구 화이트리스트를 사내 정책에 맞춰 재구성한 뒤 dry run으로 회귀 동작을 확인해야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — JetBrains Releases Mellum2.1: A 12B MoE Open Model for Coding Agents

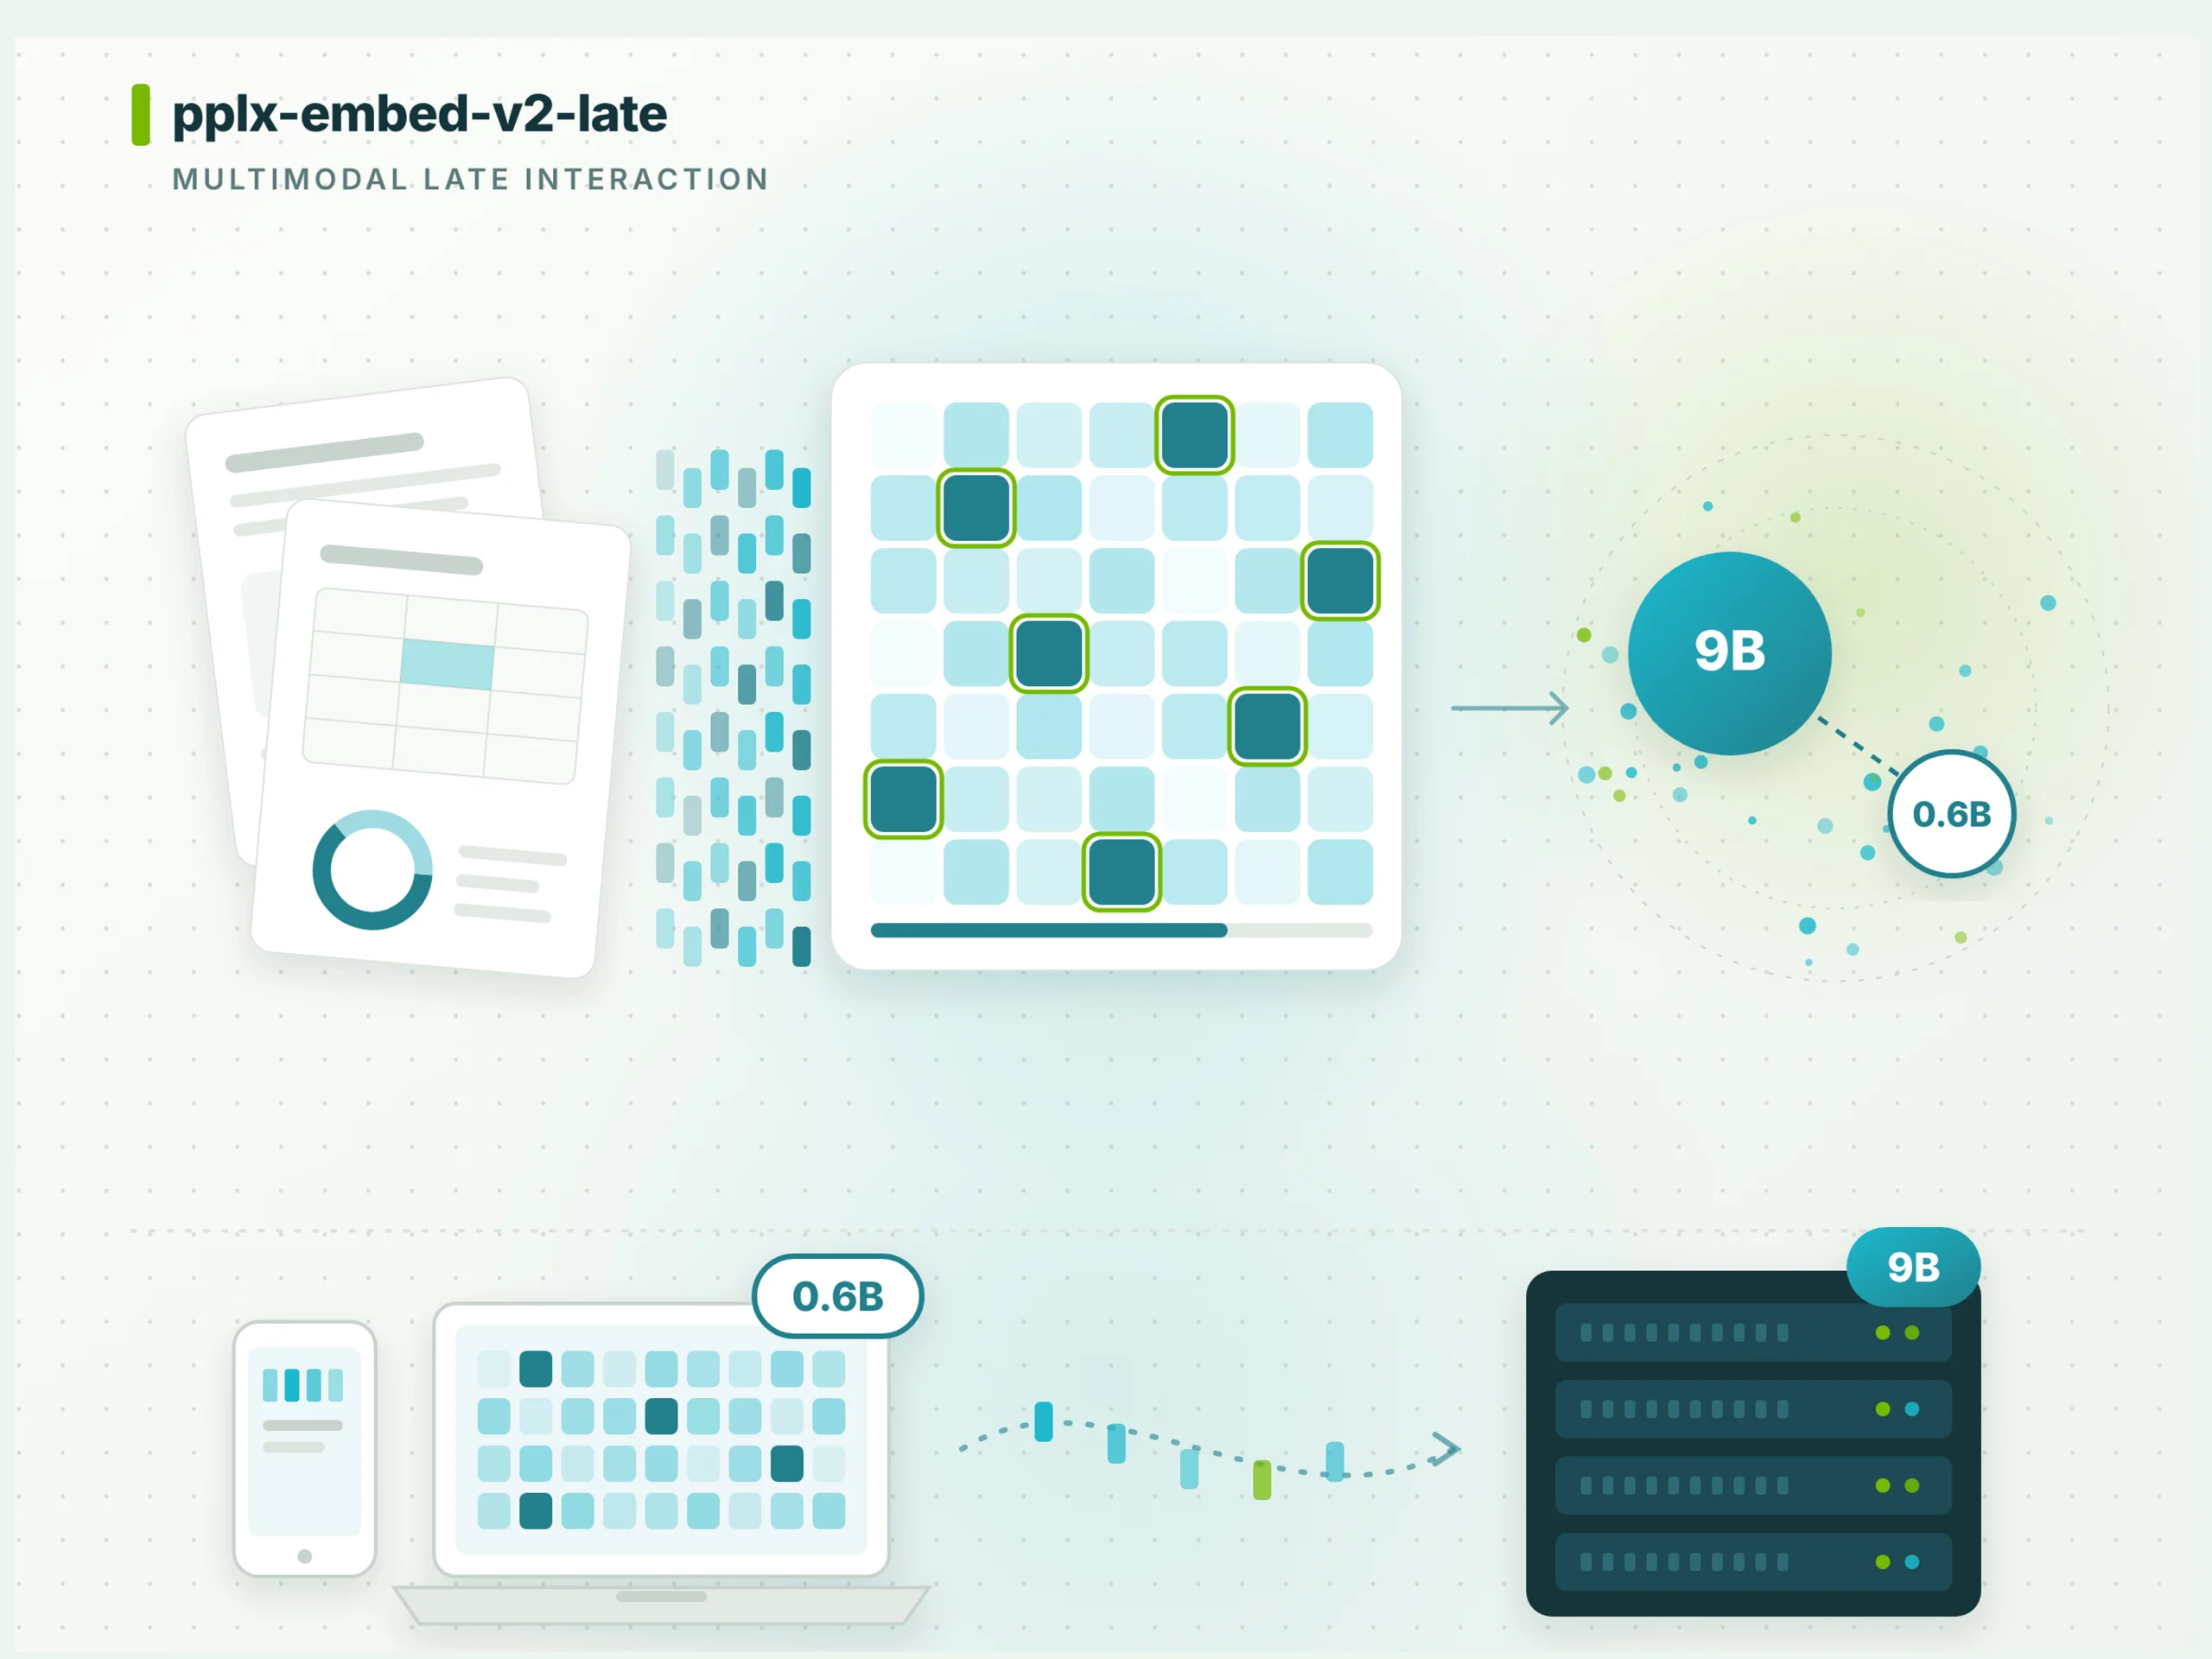
  • ColBERT 임베딩의 귀환: pplx-embed-v2-late로 0.6B 엣지·9B 인덱스 혼합 운용하는 법

    ColBERT 임베딩의 귀환: pplx-embed-v2-late로 0.6B 엣지·9B 인덱스 혼합 운용하는 법

    Perplexity가 2026년 10월 공개한 pplx-embed-v2-late는 ColBERT 스타일 late interaction을 텍스트·이미지·렌더링된 PDF 페이지에 단일 임베딩 공간으로 통합한 멀티모달 모델이다. 9B 모델은 에이전틱 PDF QA 벤치마크 MADQA에서 92.4%를 기록했고, 0.6B 모델은 ViDoRe v3 Markdown에서 61.2%로 최저선을 그렸다. 두 모델은 18B 티처로부터 LEAF 증류로 같은 임베딩 공간을 공유하기 때문에 9B 인덱스 위에 0.6B 쿼리 인코더를 얹는 혼합 운용이 가능하다.

    목차

    한 줄 요약

    pplx-embed-v2-late는 dense 임베딩이 놓치는 토큰 단위 매칭을 MaxSim으로 회복하면서도, 토큰당 벡터 차원을 128로 줄여 저장 비용을 통제한다. MIT 라이선스로 Hugging Face에서 자체 호스팅할 수 있지만 호스팅 API는 아직 제공되지 않으므로, 도입 결정은 인프라 팀의 운용 역량과 직결된다.

    왜 ColBERT 임베딩 late interaction이 다시 부상하는가

    dense 임베딩 모델은 문서 전체를 1개의 2,048~4,096차원 벡터로 압축한다. 이 방식은 코사인 유사도 한 번으로 후보를 추리는 1단계 검색에는 최적화돼 있지만, “A 규제 면제 조항이 B 조항을 어떻게 수정하는가”처럼 두 문서 구간 사이의 미세한 정합을 묻는 질문에서는 정밀도가 급격히 떨어진다. ColBERT 계열 late interaction은 이 문제를 MaxSim으로 해결한다. 쿼리의 모든 토큰이 문서의 모든 토큰과 독립적으로 점수를 매기고, 그 최댓값을 합산하기 때문이다.

    pplx-embed-v2-late는 같은 철학 위에서 두 가지를 과감하게 축소했다. 첫째, 토큰당 벡터 차원을 128로 줄였다. 경쟁 모델이 2,048~4,096차원을 쓰는 것과 비교하면 16~32배 가깝다. 둘째, 텍스트·이미지·PDF 페이지를 같은 인코더에 통과시켜 멀티모달 검색을 단일 파이프라인으로 묶었다. OCR 단계 없이 PDF를 그대로 이미지 인코딩하기 때문에 스캔본과 슬라이드까지 동일한 인덱스에 흡수된다.

    필자가 현업에서 RAG 파이프라인을 붙여본 바로는, dense 모델로 1차 후보를 걸러낸 뒤 ColBERT 스타일 리랭커로 정밀도를 다지는 2단 구조가 실무 표준이 되어가고 있다. 이런 흐름에서 128차원 late interaction은 “1단계부터 정밀도”를 노리는 선택지로 읽힌다.

    두 모델의 역할 분담: 0.6B는 쿼리, 9B는 인덱스

    Perplexity는 0.6B와 9B를 동시에 출시했지만 권장 운용 방식은 비대칭이다. 문서 인덱스는 9B로 구축해 검색 품질을 확보하고, 실시간 쿼리는 0.6B로 처리해 지연과 비용을 낮추는 것이다. 두 모델이 같은 임베딩 공간을 공유하기 때문에 이런 혼합 운용이 수학적으로 성립한다.

    하드웨어 가이드도 분리된다. 0.6B 모델은 bf16 기준 약 1.2GB로 RTX 3090/4090 한 장에서 충분히 돌아가고, 9B 모델은 약 18GB를 차지해 A100 40GB 또는 H100급이 필요하다. 0.6B 모델은 이미지 입력 시 약 340M 파라미터를 활성화하는데, 이는 일부 8B dense 멀티모달 모델과 근접한 성능을 단일 GPU에서 뽑아낸다는 의미다.

    현장에서 가장 흔한 실수는 두 모델을 “크기만 다른 옵션”으로 이해하고 동일한 워크로드에 동일 모델을 적용하는 것이다. 인덱스 품질은 빌드 시점에만 중요하지만 쿼리 모델은 매 요청마다 호출되므로, 비용-품질 곡선은 비대칭이라는 점을 설계 단계에서 명확히 분리해야 한다.

    벤치마크 디섹션: 92.4%와 61.2% 사이

    pplx-embed-v2-late가 공개한 점수는 도메인별로 큰 편차를 보인다. 가장 두드러진 건 MADQA 92.4%로, PDF 문서 기반 에이전틱 QA에서 9B 모델이 최고점을 찍었다. 반면 같은 모델이 도메인 특화 텍스트 검색에서는 9B도 최고 수준에 못 미치고, ViDoRe v3 Markdown에서 0.6B 모델은 61.2%로 최저선을 그렸다.

    평가 항목 0.6B 9B 비고
    MADQA (에이전틱 PDF QA) 89.1% 92.4% 9B 최고점
    ViDoRe v3 이미지 검색 62.3% 63.5% 9B+0.6B 혼합 63.5%
    ViDoRe v3 Markdown (nDCG@10) 61.2% 64.0% 0.6B 최저점
    BrowseComp+ (텍스트 검색) 73.0% 76.5% 9B 우세

    표에서 드러나듯, 이미지와 PDF에서는 두 모델의 격차가 좁은 반면 텍스트 도메인과 Markdown 구조화 문서에서는 9B가 명확한 우위를 보인다. EVIE·Mixedbread·Gemini Embedding 2와 비교했을 때 pplx-embed-v2-late는 멀티모달 영역에서 선두권에 들어와 있지만, 순수 텍스트 검색에서는 전용 텍스트 임베딩 모델을 완전히 대체하지는 못한다.

    혼합 크기 인덱싱의 실무 효과

    ViDoRe v3 이미지 검색에서 9B 인덱스 + 0.6B 쿼리 조합은 63.5%를 기록했다. 0.6B+0.6B(62.3%)보다 1.2포인트 높고, 9B+9B(63.5%)와 동등하다. 텍스트 도메인에서는 9B 품질 격차의 약 절반을 0.6B 쿼리 비용으로 회복할 수 있다는 게 Perplexity 측 주장이다.

    현업에서 이 패턴이 특히 유효한 시나리오는 두 가지다. 첫째, 의료·법률처럼 PDF·슬라이드 비중이 높은 코퍼스. 둘째, 엣지 디바이스나 온프레미스 환경에서 사용자 쿼리를 처리해야 하는 SaaS. 인덱스는 한 번만 빌드하므로 무거운 모델을 묶어두고, 사용자 요청 경로만 가볍게 유지하는 구도가 자연스럽게 맞아떨어진다.

    다만 토큰당 벡터를 저장하는 late interaction의 본질적 특성 때문에, 인덱스 크기는 문서 길이에 선형으로 증가한다. PLAID·ColBERTv2 같은 토큰 인덱서로 압축하지 않으면 10만 페이지 코퍼스에서 디스크 사용량이 dense 임베딩 대비 수십 배까지 부풀어 오를 수 있다. Qdrant·Milvus 같은 벡터 DB를 쓸 때도 토큰 ID를 별도 키로 관리하는 스키마 설계가 필요하다.

    배포 시 알아야 할 제약

    pplx-embed-v2-late를 실제 인프라에 올리기 전에 확인해야 할 제약이 여럿 있다.

    • 체크포인트 포맷: F32로 배포돼 bf16 대비 다운로드 크기가 2배다. 9B 모델은 약 36GB, 0.6B은 약 2.4GB를 받게 되므로 컨테이너 이미지 빌드 시 캐시 전략을 미리 설계해야 한다.
    • 단일 입력 제약: 한 번의 인코딩 호출에 텍스트와 이미지를 섞을 수 없다. PDF 페이지는 이미지 경로로만 처리되며, 페이지별 텍스트 추출을 함께 쓰려면 후처리 파이프라인을 별도로 구성해야 한다.
    • 라이브러리 버전: sentence-transformers 6.0.0 이상, transformers 5.4.0 이상을 요구한다. 기존 5.x 코드베이스와 호환되지 않으므로 의존성 업데이트 범위를 먼저 점검해야 한다.
    • 자체 보고 벤치마크: 모든 점수는 Perplexity의 자체 측정이며 기술 보고서는 아직 미발행 상태다. 도입 전에는 사내 코퍼스에서 A/B 리그레션 테스트를 돌려 실제 성능을 확인하는 게 안전하다.
    • API 미제공: 호스팅 엔드포인트가 없으므로 모든 운영 부담이 자체 팀으로 귀속된다.

    에이전틱 워크플로우 전반의 도구 통합 설계를 다시 점검하는 흐름은 MCP 비판 3가지 — 에이전트 도구 통합, 다시 설계해야 하는 시점에서 다룬 적 있는데, 임베딩 단계도 동일한 맥락에서 도구 계약을 새로 그려야 할 시점에 와 있다.

    지금 바로 해볼 것

    • pip install "sentence-transformers>=6.0.0" "transformers>=5.4.0"로 의존성을 올린 뒤 model = SentenceTransformer("perplexity-ai/pplx-embed-v2-late-0.6B")로 0.6B 모델을 로드해 GPU 메모리 피크와 첫 토큰 지연을 측정한다.
    • 사내 PDF 100건으로 9B 인덱스와 0.6B 인덱스를 각각 빌드한 뒤 동일 쿼리셋으로 nDCG@10을 비교한다. 이때 pplx-embed-v2-late 출시 공지의 벤치마크가 사내 코퍼스에서 그대로 재현되는지 확인한다.
    • 9B 인덱스를 PLAID 또는 ColBERTv2 토큰 인덱서로 압축해 디스크 점유율과 검색 지연을 함께 측정한다. indexer.encode_for_index(docs, max_document_length=512) 형태로 토큰 길이를 제한해 인덱스 폭발을 방지한다.
    • 쿼리 경로에는 0.6B 모델을 얹고 응답 지연 p95가 SLA를 만족하는지 부하 테스트를 돌린다. 이미지 입력 시 활성 파라미터가 340M으로 늘어나는 점을 감안해 동시 요청 수를 산정한다.
    • Hugging Face 모델 카드에서 MIT 라이선스 고지를 확인하고 사내 법무팀에 상업적 사용 범위를 공유한다. 호스팅 API 부재 사실을 운영 위키에 명시해 후속 팀이 같은 질문을 반복하지 않도록 한다.

    자주 묻는 질문

    기존 dense 임베딩으로 구축한 인덱스를 갈아엎어야 하나요?

    필수는 아니다. dense 모델로 1차 후보를 걸러낸 뒤 pplx-embed-v2-late로 리랭킹하는 2단 구조가 현실적인 마이그레이션 경로다. 인덱스 전체를 재구축하기 전, 리랭킹 단계에서 비용 대비 정확도 향상을 먼저 측정해 의사결정 근거를 만들면 팀 내 설득이 수월해진다.

    0.6B 모델로도 멀티모달 검색이 충분한가요?

    이미지·PDF 검색에서는 9B와의 격차가 1~2포인트 수준으로 좁다. 하지만 텍스트 도메인과 Markdown 문서에서는 9B가 명확한 우위를 보이므로 코퍼스 구성에 따라 모델 선택이 갈린다. 의료 PDF 위주라면 0.6B, 법률 계약서·기술 문서 혼합이라면 9B 인덱스가 안전하다.

    토큰당 벡터 저장으로 인한 비용을 어떻게 예측하나요?

    공식은 (평균 토큰 수 × 128 × 4바이트) × 문서 수다. 100토큰짜리 문서 10만 건이면 약 5GB, 512토큰으로 늘면 약 25GB다. PLAID 압축을 적용하면 5~10배 수준으로 줄어들지만, 압축 라이브러리 호환성과 검색 품질 트레이드오프를 사전 검증해야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Perplexity AI Releases pplx-embed-v2-late: A 0.6B Edge Model and a 9B Model Scoring 92.4% on MADQA

  • 미스트랄 라지4(르 숑크) 프리뷰, 1.05T MoE로 만든 가격과 거부 없는 보안 옵션

    미스트랄 라지4(르 숑크) 프리뷰, 1.05T MoE로 만든 가격과 거부 없는 보안 옵션

    핵심 요약

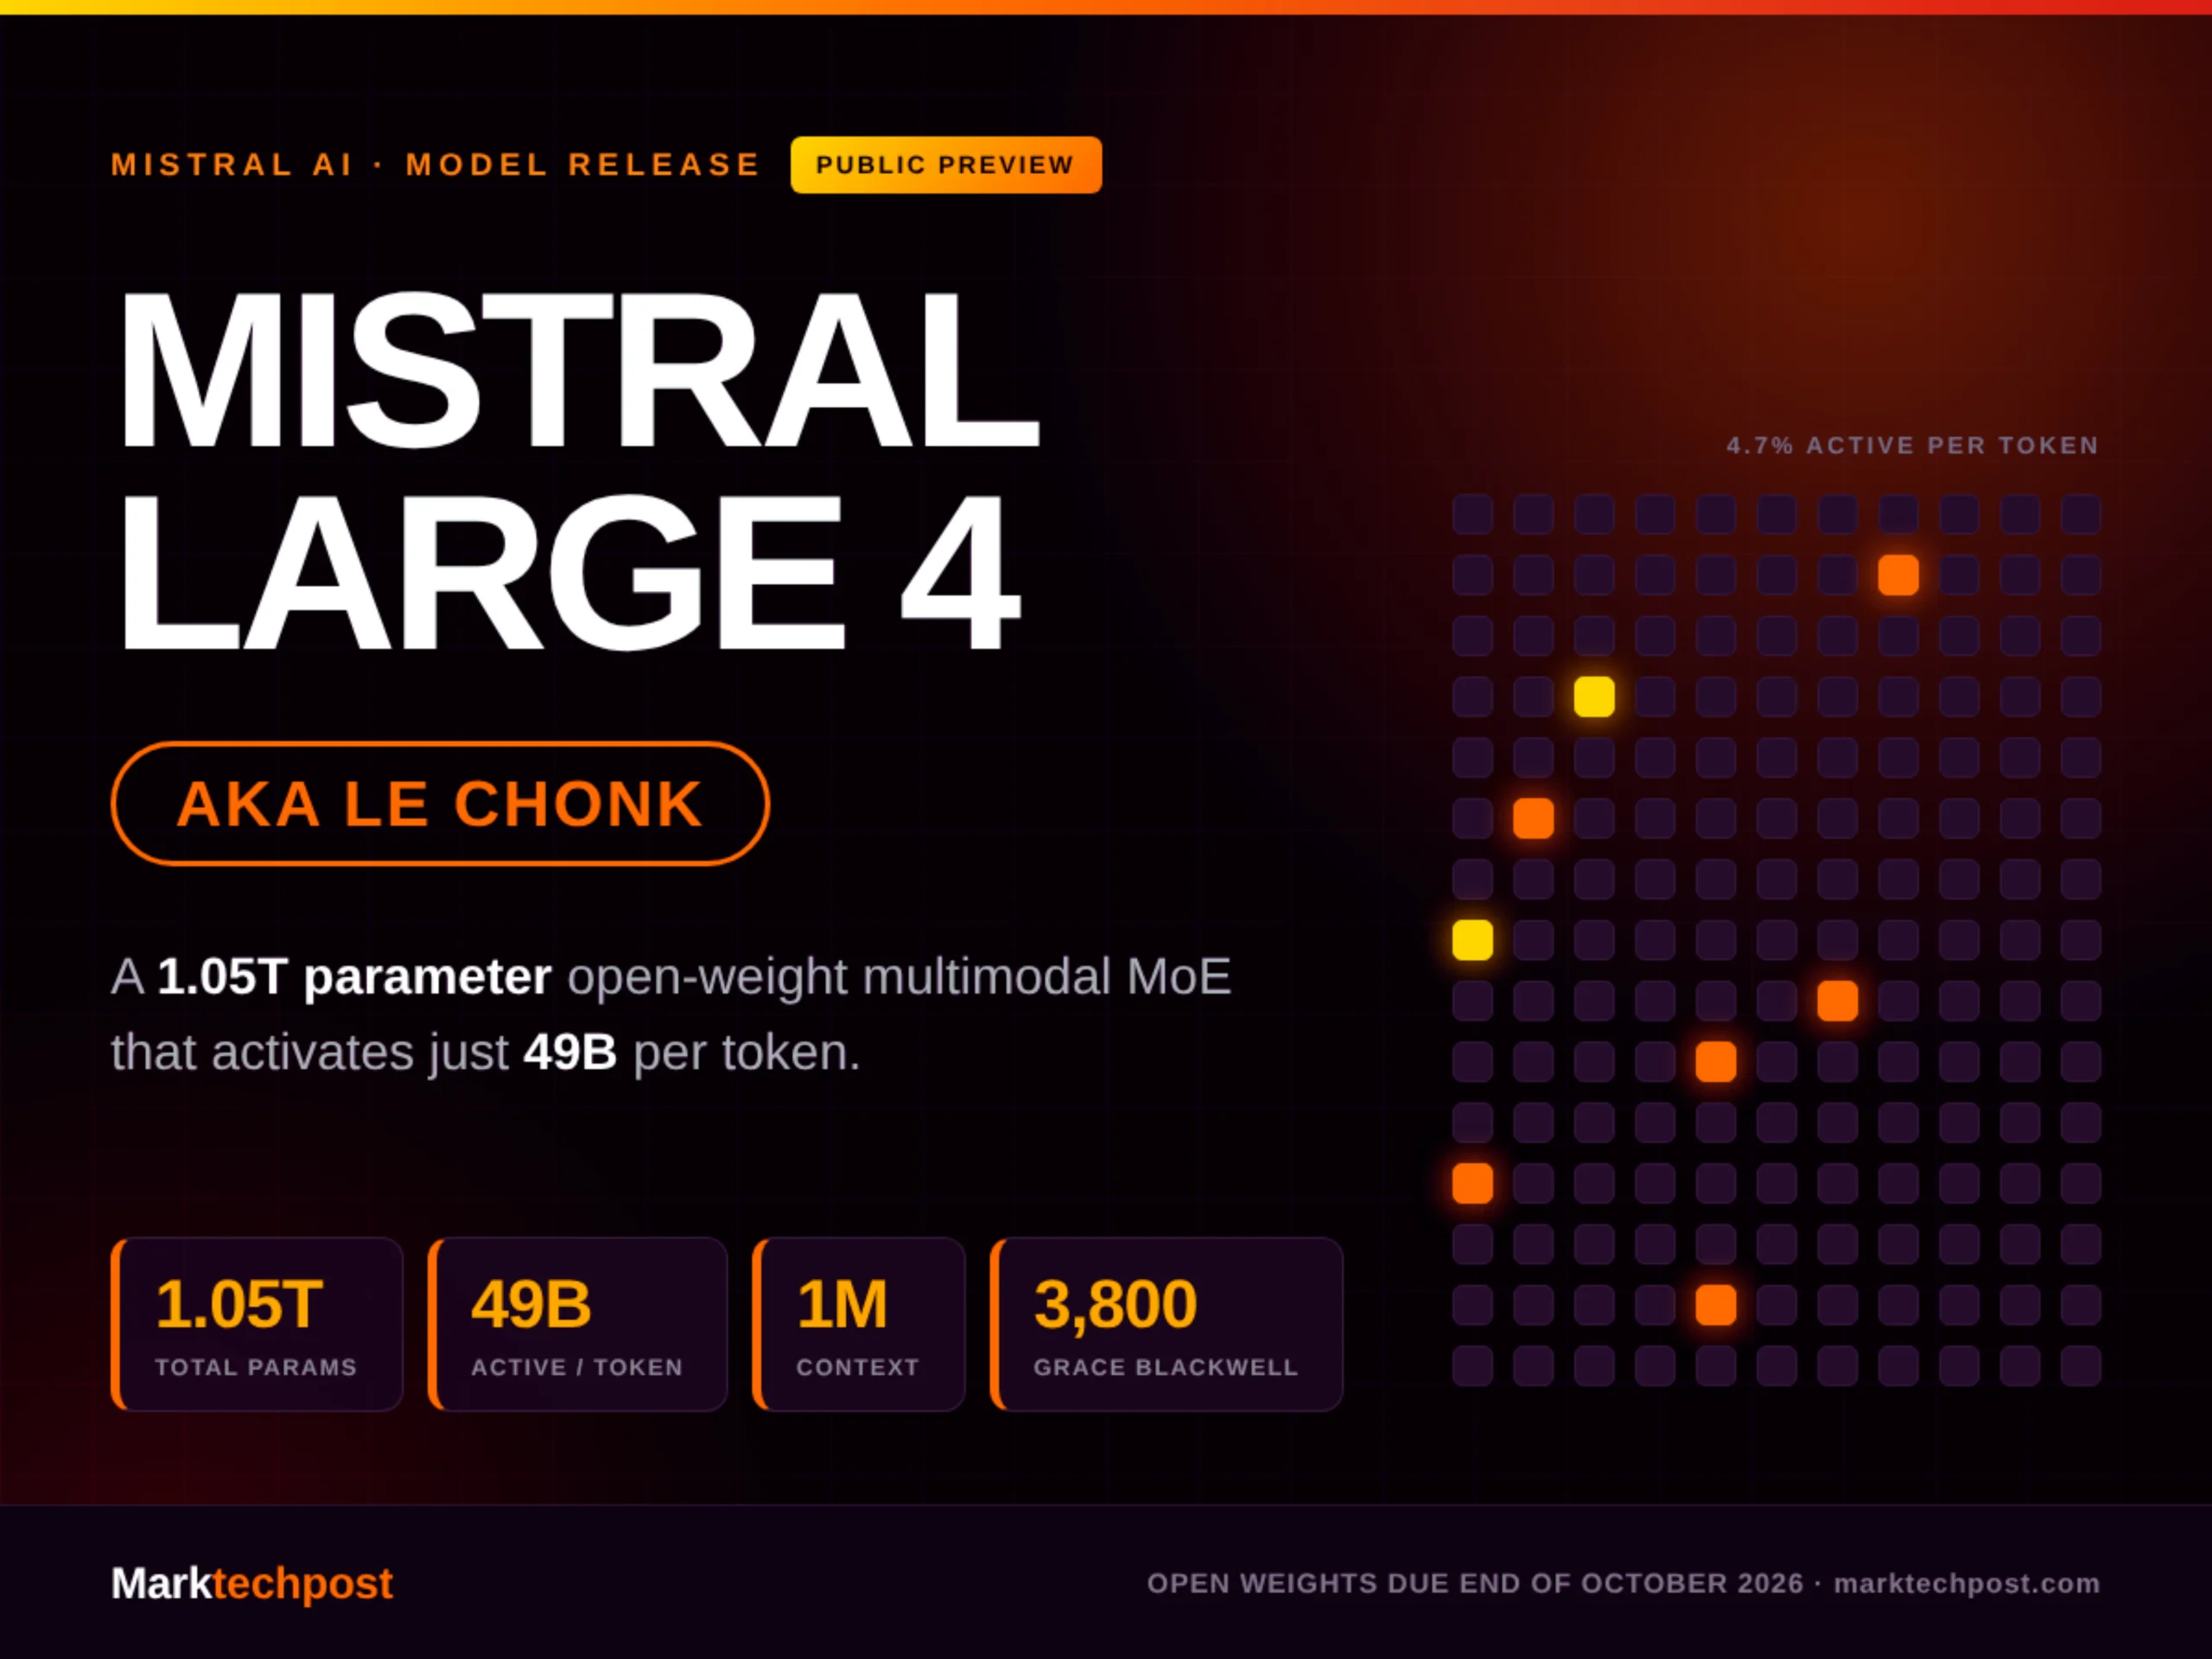
    • Mistral AI는 2026년 10월 6일 Mistral Large 4(내부 별명 Le Chonk)를 공개 프리뷰로 출시했으며, 1.05T 총 파라미터와 토큰당 49B 활성 파라미터(전체의 약 4.7%), 1.6B 파라미터 비전 인코더, 1M 토큰 컨텍스트 윈도우를 갖춘 그래뉼러 MoE 모델임
    • 학습은 Mistral의 유럽 내 자체 데이터센터에서 3,800개 NVIDIA Grace Blackwell GPU를 사용해 처음부터 진행됐으며 학습 데이터는 160개 이상 언어를 포괄하고 공식 EU 언어를 모두 포함함
    • 공개 시점에는 API만 즉시 이용 가능하고 가중치는 2026년 10월 말까지 공개될 예정이라 셀프 호스팅은 불가함. 입력 $1.36, 출력 $4.18, 캐시 입력 $0.14 per 1M 토큰으로 책정됨

    Mistral Large 4는 토큰당 4.7%만 활성화하는 그래뉼러 MoE 설계를 통해 1조 파라미터급 모델을 중간 가격대 API로 서비스하는 구조적 해법을 제시했고, 폐쇄형 프론티어 모델들이 task refusal로 사실상 점수가 0에 가까운 사이버보안 작업에서 정당화 가능한 우위를 확보했다는 점에서 실무자에게 의미 있는 선택지가 됨

    목차

    공개 배경과 한 줄 요약

    2026년 10월 6일, Mistral AI는 공개 프리뷰 형태의 새로운 플래그십 모델 미스트랄 라지4(Mistral Large 4, 내부 별명 Le Chonk)를 API로 먼저 노출했다. 총 1.05T 파라미터, 토큰당 49B 활성 파라미터(전체의 약 4.7%), 1.6B 파라미터 비전 인코더, 1M 토큰 컨텍스트 윈도우를 갖춘 그래뉼러 MoE 멀티모달 모델이다. 학습은 유럽 내 Mistral 자체 데이터센터에서 NVIDIA Grace Blackwell GPU 3,800장을 묶어 처음부터 진행됐으며, 학습 데이터는 160개 이상 언어를 포괄하고 EU 공용어를 전부 포함한다.

    필자가 현업에서 모델 카드를 읽을 때 가장 먼저 보는 항목이 학습 인프라와 데이터 출처인데, Grace Blackwell 3,800장이라는 스케일은 Mistral이 단순히 프롬프트 엔지니어링용으로 만든 모델이 아니라 1조급 weight를 처음부터 학습한 모델임을 시사한다. 같은 시기에 공개된 올모코어3의 스파스 학습 스택 분석 사례와 나란히 놓으면, 이 모델이 유럽에서 독자적으로 굴릴 수 있는 학습 역량을 갖췄다는 사실 자체가 모델 시장 구조의 변화 신호로 읽힌다.

    아키텍처 — 그래뉼러 MoE가 가격을 만드는 방식

    이 모델의 핵심은 1.05T라는 거대한 메모리 풀이면서도 토큰당 49B만 활성화해 추론 비용을 중간 티어로 끌어내렸다는 점이다. 일반적인 dense 1T 모델은 모든 파라미터를 매 토큰에 동원하므로 입력 1M 토큰당 단가 책정이 사실상 불가능에 가깝다. 반면 그래뉼러 MoE는 라우터가 토큰별로 소수의 expert를 선택하기 때문에 컴퓨트(49B)와 메모리 점유(1.05T)가 분리된다. Mistral이 입력 $1.36, 출력 $4.18 per 1M 토큰이라는 가격을 공개할 수 있었던 배경이 바로 이 분리 구조다.

    다만 전문가 수, top-k 라우팅, 레이어 레이아웃 같은 세부 제원은 가중치 공개(2026년 10월 말 예정) 시점까지 비공개로 유지된다. 운영 관점에서 이 차이는 작아 보이지만, 가중치가 풀려도 라우터 동작과 expert 편중을 독립 검증하려면 라우팅 로그를 별도로 적재해 두는 것이 안전하다. 라우팅 분포가 한쪽 expert로 몰리는 현상은 throughput은 정상으로 보이는데 특정 expert의 응답만 품질이 들쭉날쭉해지는 형태로 나타나기 쉽고, 사후 디버깅 비용이 매우 비싸다.

    비전 인코더는 1.6B 파라미터로 분리돼 네이티브 이미지 입력을 받는다. 별도 멀티모달 어댑터를 붙이지 않고도 텍스트·이미지를 단일 모델이 처리하기 때문에 RAG 파이프라인에서 OCR 단계를 거치지 않고 문서 QnA를 구성할 수 있다. 다만 비전 토큰이 컨텍스트 1M 안에 함께 잡히는지, 아니면 별도 슬라이스가 있는지는 모델 카드 본문으로 확인이 필요하다(공개된 자료만으로는 단정하기 어렵다).

    API 가격과 즉시 사용 가능 범위

    공개 시점 API 가격은 입력 $1.36, 출력 $4.18, 캐시 입력 $0.14 per 1M 토큰이다. 1M 컨텍스트 풀 윈도우를 매 호출마다 새로 결제하지 않고 캐시된 prefix를 $0.14/1M로 재사용할 수 있다는 점은 에이전트 루프에서 단가를 결정적으로 낮춘다. 매 턴마다 800K 토큰짜리 코드베이스와 대화 이력을 함께 넘기는 코딩 에이전트는 캐시 가격이 전체 비용의 70% 이상을 좌우하기 때문이다.

    API 스펙은 함수 호출, 구조화 출력(JSON Schema 강제), 문서 QnA, 배치 처리, 그리고 Agents·Conversations 엔드포인트를 한 API 키로 묶어서 제공한다. 즉시 가능한 통합 흐름은 다음과 같다.

    curl -s https://api.mistral.ai/v1/chat/completions \
      -H "Authorization: Bearer $MISTRAL_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "mistral-large-4",
        "messages": [
          {"role":"system","content":"You are a SOC analyst."},
          {"role":"user","content":"Summarize the last 24h of alerts."}
        ],
        "tools": [{"type":"function","function":{
          "name":"open_ticket",
          "parameters":{"type":"object","properties":{
            "severity":{"type":"string","enum":["low","med","high","crit"]},
            "cve":{"type":"string"}},
            "required":["severity"]}}}],
        "response_format":{"type":"json_schema","json_schema":{"name":"alert","schema":{...}}}
      }'

    위 호출에서 response_format으로 JSON Schema를 강제하면 파이프라인 다운스트림에서 Pydantic 모델로 바로 검증할 수 있어, 후속 Airflow/Dagster 태스크로 그대로 흘려보내기 좋다. 다만 셀프 호스팅은 10월 말 가중치 공개 전까지 막혀 있으므로 API 종속성을 처음부터 인정하고 리전별 failover 경로를 확보해 두는 편이 운영상 안전하다.

    사이버보안 성능과 폐쇄형 모델의 task refusal

    Cybench 93%, CyberGym-E2E 82%를 기록해 Artificial Analysis Cyber Index 글로벌 톱5에 진입했다. Mistral은 이 결과를 근거로 일부 폐쇄형 프론티어 모델들이 exploit PoC나 권한 상승 코드를 생성해 달라는 요청에서 task refusal로 점수가 사실상 0에 가깝다고 명시했다. 실무에서 가장 흔히 놓치는 함정은, 보안 자동화 에이전트에서 LLM이 정당한 payload 생성을 거절하면 그 뒤 단계인 exploit 검증, 로그 분석, IOC 추출까지 연쇄적으로 멈춘다는 점이다.

    운영 환경에서 이 갭이 체감되는 지점은 멀웨어 샌드박스 자동 트리아지다. Cuckoo Sandbox 결과를 받아 디코딩된 페이로드를 요약하고 YARA 룰 후보를 뽑는 워크플로우에서 모델이 응답을 거부하면 룰 생성 단계가 비어 버려 결국 사람이 직접 룰을 짜게 된다. 정당한 분석 결과를 거부 없이 제공할 수 있다는 점은 SOC 운영 비용에 직접 영향을 준다. 다만 가중치 공개 전까지는 동일 시나리오에서 API 모드와 셀프 호스팅 모드의 출력 차이가 존재할 수 있으므로, 보안 정책상 폐쇄망 배포가 필수인 조직은 가중치 공개 일정을 검토 체크포인트에 박아 두는 것이 좋다.

    코딩·일반 품질과 재현성 이슈

    에이전틱 코딩 벤치마크에서 DeepSWE v1.1 61.7%, SWE-Atlas-QnA 59.4%, Terminal-Bench 4.0 28.3%를 기록했고, 이를 묶은 Artificial Analysis Coding Agent Index는 49.8%다. Surge AI 블라인드 인간 평가에서는 5점 만점에 3.74로 5개 모델 중 2위를 차지해 Claude Opus 5(4.22) 뒤, GLM-5.3(3.60)과 Kimi K3(3.59) 앞선 위치를 보였다. 코딩 에이전트 하네스 측면에서 같은 매체에서 다룬 엔비디아 SoL-Pi 하네스 4종 정밀 해부와 비교하면, 이 모델이 하네스 단에서 토큰을 절약하기보다 모델 자체의 코드 이해 능력에 방점을 두고 있음을 짐작할 수 있다. 반대로 말하면 코딩 에이전트 토큰비를 우선시하는 팀이라면 모델 선택 이전에 하네스 최적화를 먼저 보는 편이 효과적일 수 있다.

    벤치마크 미스트랄 라지4(Le Chonk) 작업 유형
    Cybench 93% 사이버보안 에이전트
    CyberGym-E2E 82% 취약점 분석 end-to-end
    DeepSWE v1.1 61.7% 에이전틱 코딩
    SWE-Atlas-QnA 59.4% 저장소 QnA
    Terminal-Bench 4.0 28.3% 터미널 작업
    Surge AI 블라인드 3.74 / 5 5개 모델 중 2위
    Lakera B3 93.3% 프롬프트 인젝션 저항

    다만 모든 수치는 사전 비공개 평가로 수집된 것이며 독립 재현은 가중치 공개 이후에나 가능하다는 점을 명심해야 한다. 운영팀이 벤치마크 수치만 보고 도구를 교체했다가 내부 레퍼런스 셋에서 다른 결과가 나오는 일은 흔하다. 첫 2주 동안은 기존 모델과 A/B 라우팅을 켜 두고 미스트랄 라지4 호출 비율을 점진적으로 끌어올리는 방어적 도입이 안전하다.

    안전성 지표와 비교군

    안전성 측면에서 Lakera B3 벤치마크에 93.3% 저항률을 기록했고, KORABench는 1.691 / 2.0을 받았다. 프롬프트 인젝션 저항률은 폐쇄형 프론티어 모델들과 비슷한 수준으로, 도구 호출형 에이전트에서 외부 페이로드가 섞이는 시나리오에 그대로 투입해도 1차 방어선 역할은 할 수 있다는 의미다. 다만 Lakera B3는 단일 벤치마크이므로, 운영 환경에서는 사내 RAG 데이터셋에서 별도의 인젝션 회귀 테스트를 돌려 보는 편이 신뢰도를 크게 올린다.

    아직 공개되지 않은 정보와 후속 일정

    전문가 수, top-k 라우팅, 레이어 레이아웃은 가중치 공개 시점에 풀릴 예정이다. 10월 말 공개 직후 커뮤니티에서 라우팅 편중, expert dropout, fine-tuning 안정성 등이 빠르게 보고될 가능성이 크고, 그 결과에 따라 셀프 호스팅 TCO가 결정된다. 1M 컨텍스트를 그대로 쓰는 대신 슬라이딩 윈도우나 hierarchical compression을 함께 적용할지, 캐시 prefix 만료 정책을 어떻게 둘지도 같은 시점에 정해 두는 것이 합리적이다. 미스트랄 라지4는 가격·성능·거부 정책 세 축에서 동시에 옵션을 넓혔고, 도입 여부의 결정은 이 세 축의 가중치를 조직이 어디에 두느냐에 따라 갈린다.

    지금 바로 해볼 것

    • Mistral 대시보드에서 API 키를 발급하고 curl로 response_format을 강제하는 문서 QnA 호출을 1회 돌려 토큰 단가를 측정한다.
    • 기존 SOC 페이로드 생성 워크로드 50건을 추출해 동일 프롬프트로 모델 응답 거부율을 카운트한다.
    • Airflow/Dagster에 모델 응답을 Pydantic으로 검증하는 태스크를 추가해 JSON Schema 강제 호출과 레거시 자유 출력 호출의 다운스트림 실패율을 비교한다.
    • 1M 컨텍스트 + 캐시 prefix 조합의 비용 시뮬레이션을 사내 가격표에 반영하고, 동일 입력 기준으로 기존 모델과 미스트랄 라지4의 1만 회 호출 단가를 역산한다.
    • 가중치 공개(10월 말) 일정에 맞춰 폐쇄망 PoC 슬롯을 예약하고, 라우팅 로그 적재와 expert 편중 모니터링 템플릿을 미리 작성한다.

    자주 묻는 질문

    가중치 공개 전이라도 사내 평가용으로 도입해도 되나?

    API 종속성을 수용할 수 있는 워크로드라면 즉시 도입해도 무방하다. 다만 평가 단계에서 API와 셀프 호스팅의 응답 편차가 생길 수 있으므로, 1차 도입 후 두 번째 스프린트에서 가중치 공개 일정과 함께 내부 회귀 테스트를 다시 돌려야 한다.

    사이버보안 워크로드의 refusal이 줄면 책임 소재는 어떻게 되나?

    모델이 거부해서 사고를 막아 주는 영역과, 거부 없이 응답해서 분석 파이프라인이 굴러가는 영역의 경계가 분명해진다. 운영팀은 refusal이 줄었을 때의 secondary safety net(예: Trivy로 생성 YARA 룰 정적 검증, Semgrep 룰로 PoC 코드 정적 스캔)을 명시적으로 설계해 두는 것이 안전하다.

    1M 컨텍스트 호출이 실패하면 비용이 어떻게 청구되나?

    공식 가격표상 캐시 prefix를 활용한 호출은 $0.14/1M로 청구되고, 컨텍스트 처리 실패는 일반 입력 단가($1.36/1M)로 정산된다. 트래픽 폭주 시 fail-open 정책이 적용될 수 있으므로, 비용 알람은 캐시 적중률과 실패율을 분리해서 걸어 두는 편이 운영상 안전하다.


    참조: MarkTechPost의 Mistral Large 4 (Le Chonk) 출시 보도

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Mistral AI Releases Mistral Large 4 (Le Chonk): A 1.05T Parameter Multimodal MoE Model

  • 역전파 없이 1,000배 빠르게 — Dust가 다시 쓴 제로차 옵티마이저 트랜스포머 사전학습의 공식

    목차

    제로차 옵티마이저 Dust 트랜스포머 사전학습

    Sakana AI의 EGGROLL이 “역전파 없이 LLM을 사전학습한다”는 충격을 던졌을 때, 업계의 반응은 미묘했습니다. 가능성은 봤지만 전체 파라미터를 하나씩 흔드는 방식이 너무 느려 실용선엔 턱도 닿지 않았거든요. 1년여 만인 2026년 초, 후속 연구 Dust가 EGGROLL 대비 1,000~10,000배 효율을 달성했다는 보고가 올라왔습니다. 이 글에서는 제로차 옵티마이저가 대규모 트랜스포머에서 작동하도록 만드는 핵심 메커니즘과, 현업에서 어디까지 신뢰할 수 있는지 정리합니다.

    제로차 옵티마이저가 다시 화제인 이유

    역전파의 암묵적 비용

    딥러닝 엔지니어라면 “GPU 메모리의 절반은 backward graph를 위해 존재한다”는 사실을 체감합니다. 7B 모델 1개 step의 forward activation만 보관해도 시퀀스 길이에 비례해 메모리가 선형으로 늘어나고, gradient checkpointing을 걸지 않으면 activation이 4~5배로 폭증합니다. 필자가 현업에서 70B 모델을 다룰 때 가장 자주 부딪힌 한계가 바로 이 지점입니다 — H100 8장에서도 배치 사이즈 1, 시퀀스 2,048가 한계에 가깝습니다.

    제로차 옵티마이저는 이런 backward graph 자체를 없애버립니다. 그레이디언트를 직접 계산하지 않고, 파라미터를 약간 흔들어 보고 손실이 어디로 움직이는지만 측정하는 방식입니다. f(x+εu) − f(x−εu) 를 u 방향의 미분 근사로 쓰는 Gaussian smoothing 기법은 150년 넘게 쓰여 온 통계의 고전인데, 이를 LLM에 적용하는 것이 EGGROLL과 Dust의 출발점이었습니다.

    왜 EGGROLL은 1,000배 느렸나

    EGGROLL은 각 파라미터를 독립적으로 perturbation해서 양방향 forward를 돌렸습니다. 7B 모델 기준 파라미터 수만큼 forward를 쪼개 돌려야 하니, 통신과 동기화 비용이 말도 안 되게 커졌습니다. 이론적으로는 unbiased estimator지만 실용적으로는 불가능에 가깝다는 평가가 주류였고, 후속 시도들도 activation memory는 줄여도 wall-clock time은 그대로였습니다. 여기서 Dust의 핵심 질문이 나옵니다. “전체 파라미터를 다 흔들어야 할까?”

    Dust의 구조적 접근 — 샘플 복잡도를 파괴적으로 줄이다

    블록 단위 perturbation

    Dust의 가장 큰 기여는 “전체 파라미터를 perturb하지 말고, 저차원 부분공간에서 샘플링하라”는 것입니다. 70억 개 파라미터 전체에 ε을 더하고 빼는 대신, 랜덤 projection으로 만든 k차원 벡터(보통 k=수십~수백)에 대해서만 perturbation을 수행합니다. Johnson-Lindenstrauss 보조정리 기반의 차원 축소와 같은 원리로, 실제 손실의 움직임 대부분을 이 저차원 부분공간 안에서 포착할 수 있습니다.

    구체적으로는 PyTorch 기준으로 다음 패턴이 자주 쓰입니다. 먼저 가우시안 노이즈 u를 한 번 샘플링한 뒤, 모델 파라미터 θ를 두 개의 사본으로 복제하지 않고 in-place로 (θ + σu)와 (θ − σu)를 번갈아 적용합니다. forward 두 번만 돌리면 되므로 activation memory는 forward only로 충분하고, backward pass는 애초에 존재하지 않습니다. 메모리 프로파일링은 torch.profiler에 record_shapes=True를 켜고 activation size가 절반 이하로 떨어지는지 직접 확인하는 게 정석입니다.

    비대칭 estimator와 Adam 결합

    이전 세대 제로차 방법론이 모두 대칭적 양방향 추정을 쓴 데 반해, Dust는 단방향 estimator에 momentum을 결합한 변형을 사용합니다. g_t = (f(θ_t + σ_t u_t) − f(θ_t)) / σ_t · u_t 형태로 한쪽 forward만으로 estimator를 만들고, 여기에 Adam-style의 1차/2차 모멘텀을 그대로 입혀 분산을 억제합니다. 단방향이라 wall-clock이 절반, Adam 결합으로 분산이 작아지니, 결과적으로 sample complexity가 수백~수천 배 줄어드는 효과가 발생합니다.

    E[g] = ∇f 가 성립하려면 σ → 0 이어야 한다는 이론적 한계는 그대로지만, σ를 너무 줄이면 노이즈가 폭주하니 σ_t = σ_0 / (1 + t)^α 스케줄로 decay시키는 것이 실무 표준입니다. PyTorch라면 torch.optim.lr_scheduler.LambdaLR에 같은 형태의 closure를 넘기는 식으로 그대로 구현 가능합니다.

    EGGROLL vs Dust 비교

    항목 EGGROLL Dust
    Perturbation 차원 전체 파라미터 저차원 projection (k≪d)
    Forward pass 수/스텝 2× 파라미터 블록 수 1 또는 2 (단방향 옵션)
    Activation memory Forward only Forward only
    Wall-clock vs BP ~1,000× 느림 1×~10× (스케일에 따라)
    추정 분산 매우 큼 Adam 결합으로 억제
    7B 모델 실용성 Demo 수준 Fine-tuning 가능 영역

    실무에서 이 패러다임을 어디까지 믿을 수 있나

    Forward-only의 진짜 매력

    필자가 현업에서 주목하는 부분은 throughput 자체보다 메모리 효율입니다. activation을 저장하지 않으므로 시퀀스 길이 제한이 사실상 사라지고, 8B 모델을 100만 토큰 컨텍스트로 사전학습하는 시나리오가 GPU 메모리만 충분하면 이론적으로 가능합니다. 또 forward만 필요하므로 non-differentiable simulator(물리 엔진, 게임 환경, 실제 API 응답)를 loss로 직접 쓸 수 있는 길이 열립니다. 실무에서 가장 흔히 놓치는 함정은 이 부분을 “속도가 빨라졌다”로만 해석하는 것입니다 — 핵심 이득은 throughput이 아니라 activation memory 절감과 black-box 환경 학습 가능성에 있습니다.

    과대평가 영역과 진짜 실용 지점

    다만 솔직히 말해, 70B급 pretrain from scratch를 BP 없이 돌릴 수 있다고 보기는 어렵습니다. 공개된 결과는 1B 이하 스케일과 supervised fine-tuning 단계에 집중되어 있고, 100B 토큰 규모의 from-scratch pretrain과 EGGROLL/Dust의 비교는 아직 나오지 않았습니다. “역전파를 완전히 대체한다”는 서사는 아직 과대평가입니다. 제로차 옵티마이저가 당장 가치를 발휘할 영역은 LLM 전체를 처음부터 가르치는 게 아니라, 이미 학습된 모델을 특화 도메인에 맞게 조정하는 fine-tuning과, 환경 보상만 있고 gradient를 모를 때의 black-box RL입니다.

    지금 바로 해볼 것

    • torch.func의 functional_call로 모델을 복제하지 않고 perturbation만 가하는 forward-only 루프를 직접 작성해 베이스라인을 잡아보세요. 메모리 사용량은 torch.cuda.max_memory_allocated()로 BP 대비 절반 이하로 떨어지는지 확인합니다.
    • torch.profiler에 record_shapes=True를 켜고 동일 토큰 수 대비 activation 메모리를 BP 학습과 비교하세요. prof.key_averages().table(sort_by="self_cuda_memory_usage")로 backward 노드가 사라졌는지 직접 봅니다.
    • perturbation 차원 k와 σ decay schedule을 sweep할 수 있는 작은 ablation을 만드세요. σ_t = σ_0 / (1+t)^α 형태의 torch.optim.lr_scheduler.LambdaLR 변형으로 α ∈ {0.1, 0.3, 0.5}, k ∈ {32, 128, 512} 조합을 1B 모델에서 측정해 sweet spot을 찾습니다.
    • 단방향 estimator의 분산이 큰 문제는 exponential moving average로 보정합니다. 1차 모멘텀을 estimator에 직접 곱하지 말고 m_t = β·m_{t-1} + (1-β)·g_t 형태로 가중 평균을 두세요. β=0.9에서 시작해 noise scale이 클수록 0.99까지 올립니다.
    • 도메인 adaptation이나 black-box RL 환경에서 forward-only 루프로 A/B 테스트하세요. reward나 held-out loss가 BP fine-tuning과 ±2% 안에 들어오는지, 학습 토큰 수 대비 수렴 속도는 어떤지 메트릭을 직접 쌓는 것이 가장 빠른 검증입니다.

    자주 묻는 질문

    제로차 옵티마이저로 처음부터 LLM을 pretrain할 수 있나요?

    이론적으로는 가능하지만 공개된 실험은 1B 이하 스케일에 집중되어 있습니다. 70B급 from-scratch pretrain이 BP 대비 실용적인 속도로 돌아간다는 증거는 아직 부족하며, 현업에서는 fine-tuning이나 도메인 adaptation 단계에서 먼저 검증하는 쪽이 안전합니다.

    역전파를 완전히 대체하면 GPU 인프라가 어떻게 달라지나요?

    Backward graph가 사라지면 activation memory가 크게 줄어 GPU 한 장에 더 긴 시퀀스를 올릴 수 있습니다. 반면 perturbation과 forward 두 번이 필요해 flops는 오히려 늘어나므로, throughput을 따지면 H100 같은 학습 특화 GPU보다 메모리 대역폭이 넓고 inference에 강한 칩(B200, 추론 전용 ASIC)이 더 유리해질 수 있습니다.

    non-differentiable 시스템의 loss로도 학습할 수 있나요?

    네, 이 부분이 제로차 옵티마이저의 가장 확실한 강점입니다. forward만 필요하므로 게임 시뮬레이터, 물리 엔진, 실제 API 응답 같은 black-box 환경을 reward 신호로 직접 사용 가능합니다. 다만 분산이 크므로 multi-sample estimator로 한 step에 8~16회 forward를 묶어 분산을 줄이는 패턴이 일반적입니다.

  • 2026 광유전학 노벨상, 빛으로 뇌 회로를 켜고 끄는 세 명의 개척자

    핵심 요약

    • 2026년 노벨 생리의학상이 Karl Deisseroth(Stanford/HHMI), Peter Hegemann(Humboldt University of Berlin), Georg Nagel(University of Würzburg) 세 연구자에게 공동 수여됨
    • 수상 업적은 빛으로 열리는 이온 채널과 광유전학이며, 상금 1,200만 스웨덴 크로나를 세 수상자가 균등하게 나눔
    • Hegemann과 Nagel은 2000년대 초 단세포 조류 Chlamydomonas의 세포 표면에서 청색광에 반응해 이온 통로를 여는 채널로돕신(channelrhodopsin)을 발견함

    광유전학은 살아 있는 뇌에서 특정 신경세포를 ms 단위 정밀도로 켜고 끄는 첫 인과적 조작 도구를 제공해, 신경과학을 단순 관찰에서 인과관계 입증 단계로 전환시켰다는 점에서 2026년 노벨 생리의학상 수상에 충분한 의의가 있음

    목차

    2026년 노벨 생리의학상은 카를 다이세로스(Karl Deisseroth, 스탠퍼드·HHMI), 페터 헤게만(Peter Hegemann, 베를린 훔볼트대), 게오르크 나겔(Georg Nagel, 뷔르츠부르크대) 세 사람에게 돌아갔다. 상금 1,200만 스웨덴 크로나는 균등하게 나뉘며, 수상 업적은 한 문장으로 압축된다. “빛으로 열리는 이온 채널”—단일세포 조류가 광원을 향해 헤엄치도록 만드는 분자 하나가, 살아 있는 포유류 뇌의 특정 신경세포만 ms 단위로 켜고 끄는 도구로 확장된 20년의 여정이다. 이번 광유전학 노벨상 수상이 신경과학 공동체에서 별다른 이견 없이 받아들여진 이유도, 그 도구가 실험실 밖 임상 파이프라인까지 관통하고 있기 때문이다.

    단세포 조류에서 시작된 20년 추적

    헤게만은 1990년대 후반 단세포 녹조류 Chlamydomonas reinhardtii가 안점(eyespot)을 통해 청색광을 감지해 편모 운동을 바꾸는 현상에 매료됐다. 문제는 이 수용체의 분자 정체였다. 당시까지는 시각 로돕신과 같은 GPCR 기반 경로가 떠올랐지만, 헤게만과 나겔은 2002~2003년 발표 논문에서 retinal 결합 단백질이 직접 이온 통로로 작동한다는 사실을 보여줬다. 채널로돕신(Channelrhodopsin-2, ChR2)은 470nm 근처의 청색광을 흡수하면 알로-트랜스 retinal이 이성질화하면서 통로 입구를 열게 되고, 그 안으로 Na⁺과 Ca²⁺이 세포 내로 흘러들어 탈분극을 일으킨다. 분자량이 70kDa 안팎인 이 단백질 하나가 “빛 → 전류” 변환기를 자체 내장하고 있다는 점이, 기존 GPCR-시그널 캐스케이드와는 본질적으로 다른 발견이었다.

    필자가 현업에서 인상적이었던 지점은, 이 발견이 “분자 자체의 신기함”이 아니라 “신경과학 도구로의 확장 가능성”으로 빠르게 평가됐다는 사실이다. 마이크로몰 농도의 retinal이 포유류 신경세포에도 존재하기 때문에, 채널로돕신 유전자를 이식하기만 하면 외부 광 자극만으로 활동전위를 띄울 수 있다는 계산이 맞았던 셈이다.

    신경세포로의 도약, 그리고 2005·2007의 두 전환점

    다이세로스 팀은 2005년 Neuron에 발표한 논문에서 ChR2를 랫드 해마 신경세포에 발현시키고, 1~2ms짜리 청색광 펄스로 1Hz 이상의 안정적인 활동전위 열차를 만들어냈다. 기존 전기자극이 “전부 또는 무(all-or-none)”의 비특이적 자극이었던 데 반해, 이 방식은 특정 유전자가 발현된 세포만을 선택적으로 흥분시킬 수 있다는 차원이 다른 잠재력을 보여줬다.

    2년 뒤인 2007년, 같은 그룹은 살아 있는 생쥐의 운동피질에 AAV(아데노부합바이러스) 벡터로 ChR2를 도입하고, 두개골에 고정된 광섬유 페룰(optical fiber ferrule)을 통해 빛을 쬐어 행동을 조작하는 데 성공했다. 이때부터 “자유롭게 움직이는 동물의 특정 신경세포를 실시간으로 켜고 끄기”가 실험실 표준이 됐다. AAV9·AAV-PHP.eB 등 혈뇌장벽 투과형 혈청형이 등장하면서 유전자 전달 효율은 한 단계 더 끌어올려졌고, CaMKIIα·hSyn·mDlx 같은 세포유형 특이 프로모터, 그리고 Cre-lox 시스템의 조합으로 “원하는 세포만” 켜는 정밀도가 강화됐다.

    현업 표준 파이프라인: 4개 레이어의 조합

    오늘날의 광유전학 실험은 거의 항상 네 개 레이어로 구성된다. (1) 유전자 전달, (2) 세포유형 특이 발현 제어, (3) 광 자극 하드웨어, (4) 신호 기록. 단일 레이어만 강화해서는 ms 단위 인과관계 입증이 어렵고, 네 레이어의 지연(latency)과 직진성(off-target)을 동시에 관리해야 비로소 “어떤 세포가 어떤 행동을 만들었다”는 주장이 힘을 얻는다.

    레이어 대표 도구/소자 핵심 파라미터 실무에서 자주 놓치는 함정
    유전자 전달 AAV9, AAV-PHP.eB, AAV-DJ 역가(titer, vg/mL), 혈청형-부위 매칭 역가 과다 시 신경염증, 과소 시 발현 미달
    발현 제어 CaMKIIα, hSyn, mDlx, Cre/loxP, DIO/OFF 프로모터 누출(leakage) 비율 흥분성 표적인데 mDlx 쓰면 GABA 세포만 잡힘
    광 자극 옵로섬(optical fiber) + 473nm 레이저, 2P 홀로그래피 출력 mW, 펄스 폭, duty cycle 조직 가열(>10mW 장시간)으로 행동 변화 오염
    억제형 도구 할로로돕신(eNpHR3.0, 황색광 Cl⁻ 펌프), 아르카이로돕신(Arch, 양성자 펌프) 광 파장 분리에 의한 교차 활성화 Arch의 양성자 펌프가 pH를 떨어뜨려 주변 세포까지 영향

    위 표에서 보듯 “채널로돕신만 넣자”는 식의 단순 접근은 실무에서 잘 작동하지 않는다. 실무에서 가장 흔히 놓치는 함정은 광섬유 출력의 조직 가열이다. 1Hz 실험이라고 20mW로 30분씩 비추면 국부 온도가 1~2°C 오르면서 신경발화가 비특이적으로 변한다. 필자가 본 한 랩 노트에서는 출력 5mW 이하로 캘리브레이션한 뒤 매 세션마다 열전대로 재측정하는 SOP를 만들어 돌렸고, 그것이 논문 리뷰어의 “가열 효과 통제” 코멘트를 한 번에 통과시킨 사례가 있었다.

    단백질 한계와 도구의 진화

    초기 ChR2는 채널이 닫히는 시정수(off-kinetics)가 10ms 이상으로 느려 고빈도 연발(spike train)을 정확히 재현하기 어려웠다. 이를 극복하기 위해 등장한 변이체가 H134R, E123A, ChETA, CoChR, Chronos 등이다. Chronos는 off-kinetics가 4ms 이하로 단축돼 200Hz 자극도 따르며, 최근에는 활성화 파장을 470nm에서 630nm 근처로 옮긴 빨간빛 변이체 ChRmine, ChrimsonR이 등장해 다채널 동시 자극이 가능해졌다. 같은 시점에 억제형 도구도 진화했다. 할로로돕신은 Cl⁻을 세포 안으로 들여보내 과분극을 만들고, 아르카이로돕신은 양성자를 밖으로 빼내는 광구동 펌프다. 두 도구를 직교(orthogonal) 파장인 청색·황색·적색으로 분리해 쓰면, “흥분/억제를 같은 뇌 회로에서 ms 단위로 토글”하는 실험이 현실이 된다.

    신경과학이 이 도구 덕에 “관찰”에서 “인과관계 입증”으로 넘어갔다는 평가는 학계 안팎에서 반복된다. 20세기 후반의 뇌 지도 프로젝트가 손상 lesion이나 전기자극에 의존했다면, 광유전학은 “어떤 세포가 꺼지면 그 행동이 사라진다”는 켜기-끄기 대칭 실험을 가능하게 했다. 파킨슨병 모델에서 기저핵의 특정 아형만 억제하면 운동 증상이 완화된다거나, 공포 조건화 회로의 특정 억제성 interneuron을 광으로 끄면 공포 기억이 사라진다 같은 결과가 이 도구의 인과적 힘을 보여주는 대표 사례다.

    임상 적용, 아직 “초기 단계”라는 단서가 필요한 이유

    임상 영역에서 가장 많이 언급되는 응용은 시각 회복이다. 2026 노벨위원회 보도자료가 언급한 대로, Nanoscope Therapeutics 등 여러 회사는 채널로돕신 변이체를 망막의 잔존 신경절세포(ganglion cell)에 도입해 외부 시야 자극을 시신경으로 전달하는 유전자 치료를 시도 중이다. 1상·2상 임상에서 빛 인식 능력이 일부 회복된 사례가 보고됐지만, 시야 해상도, 단백질 발현의 장기 안전성, AAV에 대한 면역 반응 등이 여전히 풀어야 할 변수다. 같은 도구가 우울증·강박장애·PTSD 회로 규명에 쓰이고, DREADD나 chemogenetic 도구와 결합해 약물학적 광제어까지 영역을 넓히고 있다는 점도 짚어둘 만하다.

    쟁점 정리

    • 표적 외 발현의 안전성: AAV는 혈청형에 따라 간·말초신경에도 도달할 수 있어, 의도하지 않은 세포에서 채널로돕신이 켜질 경우 생체 리듬·심장박동 같은 자율기능이 교란될 가능성이 검토 대상이다.
    • 임상 도구로서의 해상도 한계: 단일 세포 수준이 아닌 회로 수준의 광유전학은 가능해졌지만, 사람 뇌의 모든 회로를 1μm 정밀도로 조작하는 단계는 아직 2-photon 홀로그래피의 임상 적용이 성숙해야 도달 가능하다.
    • 윤리적 경계선: 행동·기억을 빛으로 바꾼다는 발상은 곧 “정상/비정상”의 정의가 흐려질 수 있는 영역이다. 비임상 목적의 두개골 광자극(예: 인지능력 향상을 가정용 디바이스로) 시나리오는 규제와 사회적 합의가 동시에 필요한 영역이다.
    • 도구 표준화 vs. 변이체 카탈로그: 매년 새로운 변이체가 쏟아지면서 실험실 간 재현성 위기가 생긴다. 프로토콜 공유, 광 출력 캘리브레이션 SOP, Cre 라인 유전배경 표준화가 공동체 차원의 과제다.

    자주 묻는 질문

    광유전학 실험을 처음 셋업하려면 어느 정도 예산이 필요한가?

    최소 구성은 AAV 생산(자체 또는 코어 의뢰, 100~300만 원), 광섬유 페룰 임플란트 키트, 473nm 레이저 다이오드와 펄스 발생기, 그리고 패치클램프 또는 fiber photometry 기록 장비다. 광유전학 노벨상 수상 이후 학계 표준이 빠르게 정착하면서 open-hardware(예: 3D 프린터로 만든 광섬유 홀더, Arduino 기반 자극기) 옵션도 늘어나 비용 진입장벽은 과거보다 크게 낮아졌다.

    기존 전기자극이나 DREADD와 비교해 광유전학이 갖는 결정적 차이는 무엇인가?

    시간 정밀도(ms vs 분)와 세포유형 특이성(유전자 단위 vs 수용체 단위) 두 축에서 광유전학이 우위에 있다. 다만 조직 가열·발현 누출 같은 고유 한계가 있어, 연구 목적에 따라 두 도구를 병용하는 하이브리드 설계가 늘어나는 추세다.

    빛으로 기억을 지운다는 보도는 어디까지 사실인가?

    쥐 수준의 공포 기억 소거 실험은 다수 재현됐지만, 사람 기억의 선택적 삭제는 현재 기술로 불가능하다. 인간 뇌의 회로 복잡도와 윤리적 규제 모두 아직 그 단계에 닿지 못했다.

    광유전학 노벨상이 의미하는 가장 큰 전환은, 분자생물학의 발견이 20년 만에 신경과학의 “렌즈” 자체를 바꿔놨다는 점이다. 전기자극이 “회로 전체를 두드리는 망치”였다면, 광유전학은 “특정 세포만 콕 집어 켜는 핀셋”이다. 이 도구가 일상 임상으로 내려오는 데는 AAV 면역원성, 표적 세포 특이성, 윤리 합의라는 세 개의 산이 남아 있고, 그 산을 넘는 과정에서 10년 후의 신경과학 지형이 다시 한 번 크게 그려질 가능성이 높다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — 보도자료: 2026년 노벨 생리의학상