[작성자:] l0cknsec

  • MCP 비판 3가지 — 에이전트 도구 통합, 다시 설계해야 하는 시점

    MCP 비판 3가지 — 에이전트 도구 통합, 다시 설계해야 하는 시점

    핵심 요약

    • MCP(Model Context Protocol) 서버가 각자 다수의 도구와 스키마를 제공하면서 에이전트의 컨텍스트 창이 비대해지는 문제가 발생하고 있음
    • 코드 실행과 API 직접 호출 능력이 발전한 최신 에이전트 환경에서는 대부분의 MCP 서버가 더 이상 필수적이지 않다는 비판이 제기됨
    • 대안으로 이미 표준 인터페이스를 갖춘 HTTP API와 CLI로 MCP 서버를 대체하자는 제안이 제시됨

    AI 에이전트 생태계에서 도구 호출 표준으로 자리 잡았던 MCP가 코드 실행·API 직접 호출 능력의 성장에 따라 효용성을 재검토해야 한다는 분석 기사

    목차

    2026년 9월, StepFun이 공개한 Step 5 Preview는 단일 에이전트 액션에서 약 950회의 웹 페치를 조율한 것으로 기록됐다. 600B 파라미터의 희소 MoE 구조, 92개 Transformer 레이어의 깊고 좁은 설계다. 이 사례가 시사하는 건 단순한 성능 수치가 아니다. 에이전트가 도구와 API를 직접 다루는 능력이 한 단계 도약했다는 점이다. 이런 흐름 속에서 오래도록 에이전트 도구 통합의 표준처럼 불리던 MCP(Model Context Protocol)에 대한 MCP 비판이 다시 수면 위로 떠올랐다.

    MCP 비판의 첫 번째 쟁점: 컨텍스트 비대화

    MCP 비판의 중심에 있는 첫 번째 쟁점은 컨텍스트 비대화다. MCP 서버 하나가 수십 개의 도구와 그에 맞는 스키마를 정의하고, 에이전트는 이를 매번 시스템 프롬프트에 싣는다. 서버가 늘어나면 컨텍스트 창이 기하급수적으로 부풀고, 토큰 비용과 응답 지연이 함께 올라간다.

    실무에서 체감하는 손실은 더 직접적이다. 모델이 “쓸 수 있는 도구가 너무 많은” 상태에서 잘못된 도구를 선택하는 비율이 높아지고, 그게 다시 재시도와 비용 폭증으로 이어진다. 필자는 이 지점이 가장 실질적인 문제라고 본다. 도구의 “표준화”라는 명분 아래, 각 MCP 서버가 자기만의 스키마를 들고 등장한 결과, 에이전트 개발자는 통합 작업보다 컨텍스트 관리에 시간을 더 쓰고 있다.

    MCP 비판의 두 번째 축: 직접 호출의 현실화

    두 번째 비판은 더 근본적이다. 코드 실행과 API 직접 호출 능력이 성장하면서, MCP라는 중개 계층이 오히려 병목이 됐다는 주장이다. 오늘날 에이전트는 셸을 띄우고 curl 한 줄로 HTTP API를 두드리고, jq로 응답을 가공한 뒤 다음 단계로 넘기는 게 가능하다. Step 5 Preview의 950회 웹 페치 사례는 이런 직접 호출 패턴이 대규모 워크로드에서도 현실화됐음을 보여준다. MCP가 약속했던 “도구 호출의 표준”이, 사실은 표준 인터페이스를 갖춘 HTTP API·CLI 호출을 한 번 더 감싼 형태였다는 시각이 힘을 얻는 이유다.

    대안: HTTP API와 CLI로 도구 노출 방식을 전환

    MCP 비판론자들이 제시하는 대안은 의외로 평범하다. 도구를 HTTP API와 CLI로 노출하고, 에이전트는 코드 실행을 통해 직접 호출하라는 것이다. 인증은 OAuth/API 키로 처리하고, 도구 정의는 그때그때 함수 시그니처 수준으로만 컨텍스트에 실으면 된다. 이렇게 하면 컨텍스트 점유를 대폭 줄이면서도, 도구 진화를 MCP 스펙 변경에 묶이지 않고 자유롭게 가져갈 수 있다.

    항목 MCP 서버 HTTP API 직접 호출 CLI 직접 호출
    컨텍스트 비용 높음 (도구·스키마 상시 로드) 낮음 (필요 시점에만 정의) 낮음 (셸 호출)
    표준화 수준 MCP 스펙 종속 OpenAPI 등 성숙 표준 POSIX/셸 규약
    다단계 워크플로 강점 보통 (직접 구현) 보통 (직접 구현)
    인증 MCP 내부 처리 OAuth·API 키 환경 변수·키파일
    유지보수 서버 업데이트 전파 필요 엔드포인트 단위 독립 바이너리 단위 독립

    표에서 보듯 MCP는 “여러 도구를 한 묶음으로 노출”하는 데서 강점이 있다. 다만 그 비용을 정당화할 만큼 표준화 우위가 크지 않다는 게 비판의 핵심이다.

    MCP 비판 이후 균형 잡힌 시각: MCP가 여전히 유효한 영역

    MCP가 무용하다는 주장은 성급하다. 표준화되지 않은 사내 시스템을 에이전트에 한 번에 묶어 노출해야 하는 경우, MCP의 도구 번들링은 여전히 유효하다. 다만 일반적인 SaaS API·CLI·웹 호출이 주를 이루는 워크로드라면, 굳이 MCP를 거치지 않는 게 이득이다. 결국 답은 단일이 아니라 워크로드별 혼합 적용이다.

    MCP 비판 이후의 실용적 선택

    2026년 9월 시점에서, 에이전트 도구 통합은 “한 가지 프로토콜로 정답을 통일”하는 단계에서 벗어났다. 도구 정의의 컨텍스트 비용을 누가 부담하느냐, 표준화 요구가 어느 정도냐, 인증·권한을 누가 관리하느냐에 따라 선택이 갈린다. MCP 비판은 이 선택을 다시 열어뒀다는 데 의의가 있다.

    실무 적용 포인트

    • 도구 목록이 5개를 넘는 MCP 서버는 우선 HTTP API 직접 호출로 전환을 검토한다.
    • 컨텍스트 비용 모니터링: 도구 정의로 인한 입력 토큰 비율을 주 단위로 측정한다.
    • 워크플로가 단순 호출 1~2단계로 끝나면 MCP의 중개 계층을 거치지 않는 편이 낫다.
    • 레거시 사내 시스템은 MCP로 묶고, 외부 SaaS는 직접 호출로 분리하는 혼합 전략을 기본값으로 둔다.

    지금 바로 해볼 것

    • 현재 운영 중인 MCP 서버에서 도구 정의를 추출해 컨텍스트 점유 토큰 수를 측정한다.
    • 같은 기능을 HTTP API와 OpenAPI 명세로 다시 정의해, 에이전트가 셸에서 직접 호출하는 코드를 작성해 본다.
    • 인증 흐름을 OAuth/API 키 방식으로 단순화하고, MCP 내부 인증 의존도를 낮춘다.
    • 도구가 늘어날 때 컨텍스트 비용이 선형으로 증가하는지 로그로 확인한다.
    • 사내 표준이 없는 레거시 시스템만 MCP로 묶고, 나머지는 직접 호출로 분리한다.

    자주 묻는 질문

    MCP를 당장 걷어내야 하나요?

    아닙니다. 사내 레거시 도구를 한꺼번에 묶어야 할 때 MCP는 여전히 효율적입니다. 새로 만드는 통합은 HTTP API·CLI 기반으로 시작하는 것이 합리적입니다.

    컨텍스트 비대화가 실제 비용에 얼마나 영향을 주나요?

    도구 정의를 매 요청마다 실어 보낸다면, 입력 토큰의 20~40%가 도구 메타데이터로 소모되는 사례가 보고되고 있습니다. 모델과 요금제에 따라 월 수백만 원 단위 차이가 날 수 있습니다.

    HTTP API로 직접 호출할 때의 단점은 무엇인가요?

    에이전트가 인증·재시도·에러 처리를 직접 다뤄야 합니다. 멀티스텝 워크플로가 길어질수록 코드 복잡도가 빠르게 올라가므로, 도구 수가 적고 호출 빈도가 높은 경우에 가장 효과적입니다.

    Step 5 Preview의 950회 웹 페치는 왜 중요한가요?

    에이전트가 인간의 개입 없이 대규모 도구 호출을 안정적으로 조율할 수 있다는 증거이기 때문입니다. 이런 능력이 보편화되면, 도구 통합의 병목은 “어떤 프로토콜”이 아니라 “어떤 코드를 짜느냐”로 이동합니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — MCP는 처음부터 잘못된 아이디어였을까?
  • DMZ 지뢰 3명 부상 — 서부전선 폭발의 3가지 시나리오와 ‘국경선 요새화’ 쟁점

    DMZ 지뢰 3명 부상 — 서부전선 폭발의 3가지 시나리오와 ‘국경선 요새화’ 쟁점

    핵심 요약

    • 한국 합동참모본부는 21일 오전 서부전선 DMZ 군사분계선(MDL) 이남 지점에서 작전 중이던 한국군 간부 3명이 미상 폭발로 부상했다고 밝혔다.
    • 사고 현장은 육군 25사단 관할 지역으로 확인됐으며, 부상자 2명은 응급헬기로 긴급 후송됐고 나머지 1명도 육로 이동 후 헬기로 이송됐다.
    • 군 당국은 폭발물 종류와 정확한 사고 경위를 조사 중이며, 지뢰일 경우 과거 한국군이 매설한 것인지, 북한군이 매설한 것인지, 북측에서 유실된 것인지 아직 확인되지 않은 상태다.

    DMZ 내 한국군 부상 사고의 원인이 지뢰로 추정되는 가운데, 북한군의 ‘국경선 요새화’ 작업과 MDL 이남 지형 변화가 동시에 진행되고 있어 군사 안보적 쟁점이 부각되고 있다. 이 글은 사실관계 정리, 과거 유사 사례 비교, 북한 측 군사활동 맥락, 한국군의 대응 과제를 분석해 군 사기 및 휴전 관리 측면에서의 시사점을 제공한다.

    목차

    서부전선 DMZ 지뢰 폭발로 한국군 간부 3명이 부상을 입었다. 21일 오전, 육군 25사단 관할 군사분계선(MDL) 이남 지점에서 작전 중이던 중 미상의 폭발이 발생했다. 부상자 2명은 응급헬기로 긴급 후송됐고, 나머지 1명도 육로 이동 후 헬기로 이송됐다. 합동참모본부는 폭발물 종류와 정확한 사고 경위를 조사 중이라고 밝혔다.

    필자가 이 사건에서 가장 눈에 띄는 건, 사고 지점이 북측 MDL 남쪽 지뢰조성지대 인근이라는 유용원 의원의 공개다. 2015년 8월 4일 경기 파주 DMZ에서 북한군이 매설한 목함지뢰에 수색대원들이 잇따라 폭발해 부사관 2명이 다리를 잃은 전례가 있다. 이번 DMZ 지뢰 사고도 단순 미상 폭발로 덮으면 안 된다.

    DMZ 지뢰 시나리오 세 가지

    지뢰일 경우 검토되는 시나리오는 한국군 과거 매설, 북한군 신규 매설, 북측 유실 유입이다. 합참은 어느 쪽인지 아직 확인되지 않았다고 했다. 가능성과 조사 착안점을 표로 정리했다.

    시나리오 가능성 평가 주요 근거 조사 착안점
    한국군 과거 매설 낮음 MDL 이남 수색로 주기적 점검, 매설 도면 존재 도면 대조·현장 발굴
    북한군 신규 매설 높음 2024년 이후 ‘국경선 요새화’ 작업 진행 영상·위성 자료 정밀 분석
    북측 유실 유입 중간 폭우·낙석 등 자연 유입 가능성 물리적 흔적 감정·탄종 대조

    북한 ‘국경선 요새화’와 DMZ 지뢰의 연결고리

    합참은 지난 11일 MDL 이남 일부 지역에서 지형 변화를 식별했다며 북한이 DMZ 지뢰를 매설했을 가능성을 놓고 유엔군사령부와 협의 중이다. 즉 매설 범위가 군사분계선 남쪽까지 넘어왔을 가능성이 제기된 상태다. 2024년부터 북한군은 DMZ 북측 전선지역에 병력을 투입해 지뢰 매설, 불모지 조성, 전술도로 보강, 방벽으로 추정되는 구조물 설치 등 이른바 ‘국경선 요새화’ 작업을 진행해 온 것으로 알려져 있다. 이번 DMZ 지뢰 사고는 그 작업의 연장선에서 읽힌다.

    2015년 파주 사례가 다시 DMZ 지뢰에 덮인다

    국방부 합동조사단은 2015년 8월 4일 파주 사고 때 북한군이 군사분계선을 넘어와 한국 측 추진철책 통문 앞뒤에 목함지뢰 3발을 매설한 것으로 결론 냈다. 10년이 지난 지금 같은 DMZ 지뢰 패턴이 반복되고 있다는 점에서 수색작전 안전성 자체가 재점검 대상에 올랐다.

    실무자 입장에서 가장 뼈아픈 부분은 헬기를 투입해 발목절단 장병을 긴급 후송한 정황이다. DMZ라는 특수 지형에서 즉각적 의료 후송이 갖는 의미는 일반 작전과 다르다. 의료진 진입 시간, 헬기 착륙 가능 지점, 혈액·항생제 비축 상황이 한꺼번에 시험대에 오른 셈이다.

    DMZ 지뢰가 남긴 쟁점

    쟁점은 세 갈래다. 첫째, 이 사건이 1953년 한국휴전협정 위반에 해당하느냐. MDL 이남 DMZ 지뢰 매설은 정전상대방의 군사활동이 휴전선을 넘어온 것으로 해석될 여지가 있다.

    둘째, 한미·유엔군사령부 협의 절차다. DMZ는 주한미군과 유엔사가 공동 관리하는 공간이므로 단독 결론은 한계가 있다.

    셋째, 군 사기다. 수색작전은 보이지 않는 전선에서 조용히 수행되는 임무인 만큼, 동료 장병의 심리적 충격이 적지 않다.

    아직 공식 발표되지 않은 변수도 있다. DMZ 지뢰의 구체적 종류(대인지뢰·목함지뢰·대인방어지뢰), 매설 시기 추정, 사고가 단발성인지 연속 폭발 가능성이었는지, 부상자 부위와 군 복귀 가능성. 합참이 “조사 중”이라는 표현만 반복하는 사이 정치권과 언론이 추측을 덧붙이고 있다. 유용원 의원이 사고지역을 북측 MDL 남쪽 지뢰조성지대 인근으로 지목한 것도 같은 흐름이다.

    투명한 사고 경위 공개가 왜 중요한지 이 사례가 잘 보여준다. 2015년 때도 합동조사단의 수개월에 걸친 정밀 조사 끝에 “북한군 MDL 남쪽 매설”이라는 결론이 나왔다. 같은 수준이 이뤄지지 않으면 안전 절차 개선, 대북 외교적 대응, 군 사기 관리 모두 표면 처방에 그칠 위험이 있다.

    쟁점 정리

    • 휴전협정 위반 여부: MDL 이남 DMZ 지뢰 매설은 정전선 침범으로 해석 가능
    • 한미·유엔군사령부 협의: DMZ 공동 관리 체계에서 단독 결론의 한계 노출
    • 군 사기 영향: 수색작전 참여 장병의 심리적 안전감 훼손 우려
    • 투명한 경위 공개: 2015년 사례처럼 합동조사단 수준의 정밀 조사 필요

    지금 바로 해볼 것

    • 국방부·합참 공식 브리핑을 매일 확인해 발표 변경 사항을 추적한다
    • 2015년 파주 DMZ 목함지뢰 사고 합동조사단 보고서를 비교 자료로 확보한다
    • 유엔군사령부(UNC) 공식 성명을 별도 채널에서 교차 확인한다
    • MDL 이남 수색작전 안전 매뉴얼 공개 여부를 국회 국방위 회의록에서 검색한다

    자주 묻는 질문

    DMZ 지뢰 사고가 또 일어난 건가요?

    2026년 9월 21일 서부전선 DMZ에서 한국군 3명이 미상 폭발로 부상당했습니다. 합참은 지뢰 가능성을 포함해 정확한 원인을 조사 중이며, 2015년 파주 사고 이후 10년 만의 유사 사례로 평가됩니다.

    북한이 직접 매설한 DMZ 지뢰인가요?

    아직 확인되지 않았습니다. 북한군 신규 매설, 한국군 과거 매설, 북측 유실 유입 세 시나리오가 검토되고 있으며, 합참은 지난 11일 MDL 이남 지형 변화를 식별했다고 발표했습니다.

    DMZ 지뢰가 MDL 이남까지 매설될 수 있나요?

    2015년 파주 사례에서 북한군이 MDL을 넘어 한국 측으로 목함지뢰 3발을 매설한 사실이 확인된 바 있습니다. 이번 사고도 MDL 이남 지뢰조성지대 인근에서 발생해 같은 패턴 가능성이 제기됩니다.

    부상자들의 상태는 어떤가요?

    3명 중 2명은 응급헬기, 1명은 육로 후 헬기로 후송됐습니다. 구체적 부위와 군 복귀 가능성은 국방부가 추가 공개할 예정입니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Google News 한국 — 서부전선 비무장지대 폭발로 한국군 3명 부상…지뢰 추정

  • 워터플럼 8개월 공격 — 가짜 면접으로 3만 대 감염, 7천 지갑 털린 북한 해킹조직

    워터플럼 8개월 공격 — 가짜 면접으로 3만 대 감염, 7천 지갑 털린 북한 해킹조직

    핵심 요약

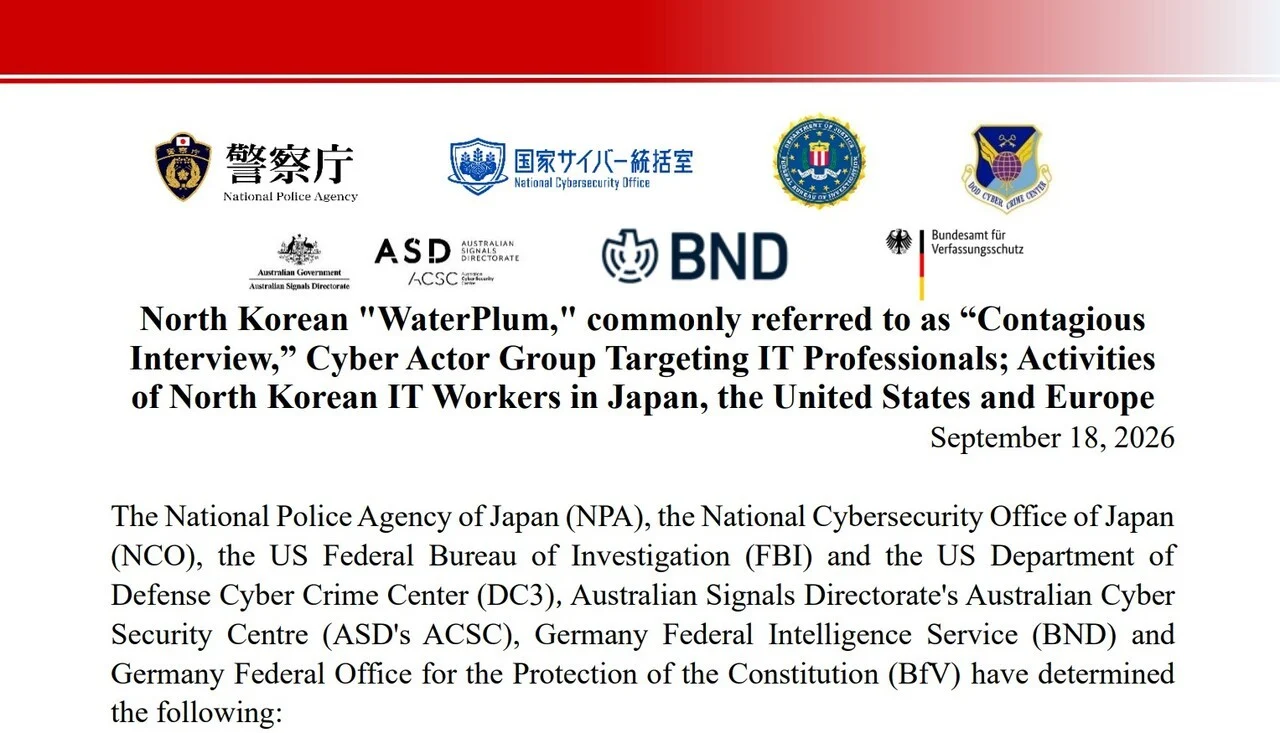
    • 북한 해킹 조직 워터플럼이 2025년 12월부터 2026년 7월까지 8개월간 100개국 이상에서 최소 3만 대의 기기를 감염시킨 것으로 일본·미국·호주·독일 4개국 수사당국이 공동 권고문을 통해 공개했다.
    • 이 공격으로 7,000개 이상의 암호화폐 지갑이 탈취된 정황이 확인됐으며, 약 17억 엔(약 1,071만 달러) 상당의 암호화폐가 북한으로 유출됐다.
    • 워터플럼은 구인·구직 활동을 미끼로 사용했다. 실제 존재하는 AI, 암호화폐, 대체불가토큰(NFT) 회사를 사칭하거나 채용·프리랜스 플랫폼을 통해 피해자에게 접근한 것으로 전해졌다.

    뉴스요약형. 새로운 사이버 위협 정보를 핵심 사실 위주로 압축해 전달하고, 실무자가 즉시 참고할 수 있는 위협 특징과 시사점을 함께 정리한다.

    목차

    “면접이라고요, 이 코드를 실행해 보세요” — 이 한 줄이 3만 대의 기기를 감염시켰다.

    2025년 12월부터 2026년 7월까지 8개월 동안, 북한 해킹 조직 워터플럼(WaterPlum)은 100개국 이상에서 최소 3만 대의 기기를 감염시킨 것으로 드러났다. 일본·미국·호주·독일 4개국 수사당국이 공동 권고문을 통해 이 같은 사실을 공개했다.

    가장 충격적인 건 수법이다. 워터플럼은 AI, 암호화폐, 대체불가토큰(NFT) 분야의 실제 회사를 사칭하거나 채용·프리랜스 플랫폼을 통해 구직자에게 접근했다. 그다음 ‘가짜 면접’으로 미끼를 걸었다. 면접 과정에서 특정 소프트웨어를 설치하거나 코드를 실행하게 만들어 악성코드를 유입시킨 것이다.

    이 공격으로 7,000개 이상의 암호화폐 지갑이 탈취된 정황이 확인됐다. 유출된 암호화폐는 약 17억 엔, 한화 1,071만 달러에 이른다. 단순한 개인정보 유출이 아니라 실제 자산이 북한으로 송금된 사례가 누적됐다는 뜻이다.

    필자는 이 지점이 가장 의미 있다고 본다. ‘일상의 공격 표면화’다. 구인·구직이라는 누구나 하는 행위 자체가 공격 벡터가 됐다. 피싱 메일도 아니고 취약점 익스플로잇도 아니다. 사람이 사람을 의심하지 않는 순간을 노린 사회공학의 극단적 사례다.

    4개국 수사당국이 동시에 워터플럼 권고문을 낸 이유

    단일 국가가 아닌 4개국이 동시에 권고한 것 자체가 워터플럼의 활동 반경을 보여준다. 감염 기기가 100개국에 흩어져 있다는 건, 특정 지역이 아니라 전 세계 구직자 풀이 표적이었다는 의미다.

    일본과 미국은 물론 호주와 독일까지 합세한 건, 자금의 국제적 추적과 공격 인프라 차단이 한 국가의 힘으로 한계에 부딪혔기 때문으로 읽힌다. 암호화폐는 본질적으로 국경을 초월하기 때문에, 피해자가 어디에 있든 자금은 빠르게 이동한다.

    워터플럼 공격 경로 — ‘회사 사칭 → 면접 → 코드 실행’의 3단계

    워터플럼의 공격은 크게 세 단계로 나뉜다.

    첫째, 실제 존재하는 AI·암호화폐·NFT 회사를 사칭하거나 정상 채용 플랫폼을 악용해 구직자에게 접근했다. 둘째, 화상 면접 또는 기술 면접을 핑계로 특정 프로그램 설치나 깃허브 등의 코드 실행을 요구했다. 셋째, 피해자 기기에 백도어를 심어 장기간 접근 권한을 확보한 뒤 암호화폐 지갑을 털었다.

    실무자 입장에서 눈에 띄는 건, ‘기술 면접’이라는 장치가 워터플럼에게 완벽한 핑계를 제공했다는 점이다. 개발자 구직자에게 코드 실행을 요구하는 건 그 자체로 이상한 일이 아니다. 그래서 이 공격이 8개월 동안 누적됐을 가능성이 크다.

    단계 행위 결과
    1. 접근 실제 회사 사칭·채용 플랫폼 악용 구직자 신뢰 확보
    2. 침투 기술 면접 중 코드·소프트웨어 실행 유도 악성코드 유입
    3. 탈취 백도어 장기 상주 후 지갑 정보 유출 암호화폐 자산 유출

    왜 지금 워터플럼 사건이 위험한가

    북한의 암호화폐 탈취는 외화 확보 수단의 핵심축으로 자리 잡은 지 오래다. 워터플럼 사건은 규모와 국제 공조라는 두 축에서 이전 사례들과 차원이 다르다.

    • 감염 기기: 최소 3만 대
    • 감염 국가: 100개국 이상
    • 탈취 지갑: 7,000개 이상
    • 유출 금액: 약 17억 엔 (1,071만 달러)
    • 공격 기간: 8개월 (2025.12~2026.7)

    대부분의 피해자가 자신이 감염됐다는 사실조차 모른 채 지갑 자산을 잃었을 가능성이 있다. 멀웨어가 침투한 시점과 실제 자산 유출 사이에는 상당한 시간차가 존재하기 때문이다.

    지금 바로 해볼 것

    • 면접 전 회사의 도메인과 사업자등록증을 공식 채널에서 교차 확인한다
    • 화상 면접 도구 설치나 외부 코드 실행 요구가 오면 IT 보안팀에 즉시 공유한다
    • 암호화폐 지갑은 콜드월렛과 핫월렛을 분리하고 다중서명(Multisig)을 도입한다
    • 개발자 기기에 EDR 제품을 설치하고 깃허브 등 외부 저장소 클론 시 샌드박스 검사를 거친다
    • 채용 과정에서 받은 모든 파일은 제출 전에 VirusTotal 등에서 정적·동적 분석을 돌린다

    실무 적용 포인트

    워터플럼의 수법은 ‘사람이 가장 자연스럽게 하는 일’을 노린다는 점에서 일반적인 악성코드 대응과 차원이 다르다. 기술적 차단에만 의존하면 이 공격은 막기 어렵다. 채용·면접이라는 업무 프로세스 자체에 보안 검증 단계를 끼워 넣어야 한다.

    • 채용 담당자: 화상 면접 도구 설치, 코드 실행, 원격 접속 요구가 들어오면 표준 절차로 거부하거나 IT팀 검증을 받게 한다
    • 보안 실무자: 구직자 기기에서 유출되는 토큰과 세션 정보를 모니터링할 수 있는 탐지 규칙을 마련한다
    • 구직자 개인: 지갑 시드구문은 절대 디지털로 저장하지 않고, 면접용 노트북은 업무용과 분리한다

    자주 묻는 질문

    워터플럼은 어떤 조직인가요?

    워터플럼(WaterPlum)은 북한의 해킹 조직으로, 이번 4개국 공동 권고문에서 공식적으로 명명된 이름입니다. 구인·구직 활동을 미끼로 글로벌 구직자를 표적화한 점이 특징입니다.

    가짜 면접 공격은 어떻게 진행되나요?

    실제 회사를 사칭해 면접을 제안한 뒤, 기술 면접 과정에서 특정 소프트웨어 설치나 깃허브 코드 실행을 요구합니다. 이 과정에서 악성코드가 기기에 침투해 암호화폐 지갑 정보를 탈취합니다.

    내가 감염됐는지 어떻게 알 수 있나요?

    면접 이후 알 수 없는 프로세스가 백그라운드에서 동작한다거나, 지갑 자금이 사전 예고 없이 이동했다면 침투를 의심해야 합니다. EDR 로그와 지갑 거래 내역을 함께 확인하는 것이 빠릅니다.

    암호화폐는 어떻게 북한으로 송금되나요?

    탈취된 지갑은 믹싱 서비스를 거쳐 거래소에서 환금되거나 P2P 거래로 현금화됩니다. 이후 국제 금융망을 우회해 북한 정권에 유입되는 흐름이 반복적으로 보고되고 있습니다.

    워터플럼 사건은 사이버 공격이 더 이상 기술적 취약점만의 문제가 아님을 다시 확인시켜 준다. 채용·면접이라는 정상적인 비즈니스 프로세스 안에 침투하는 이 수법은, ‘사람을 의심하지 않는 순간’이 곧 가장 큰 취약점이 됨을 보여준다.

    개인과 기업 모두 채용 과정에서 한 단계의 검증을 추가하는 것만으로도 이 공격의 상당 부분을 사전에 차단할 수 있다. 보안뉴스 1차 보도에서 전체 권고문 내용을 확인할 수 있다.

  • AI 안전 규제 3가지 의문 — 아모데이 ‘pace the frontier’와 업계 3파전

    AI 안전 규제 3가지 의문 — 아모데이 ‘pace the frontier’와 업계 3파전

    핵심 요약

    • Anthropic CEO 다리오 아모데이(Dario Amodei)가 프런티어 모델 개발의 속도를 조절하겠다는 ‘pace the frontier’ 계획을 공개적으로 제시함
    • Nvidia CEO 젠슨 황(Jensen Huang)은 도널드 트럼프 대통령의 주장처럼 AI 안전 우려가 허구이며 규제가 불필요하다는 입장을 공개적으로 옹호하고 있어 업계 내부 의견이 양분됨
    • TechCrunch ‘Equity’ 팟캐스트 진행자 션 오케인(Sean O’Kane)은 아모데이의 계획이 구체적 실행 방안을 충분히 담고 있지 않다고 평가함

    분석

    목차

    AI 안전 규제 논의는 2026년 9월, 업계 한복판에서 두 방향으로 갈라졌다. Anthropic의 다리오 아모데이 CEO는 ‘pace the frontier’라는 이름으로 프런티어 모델의 개발 속도를 자발적으로 늦추겠다며 의제를 공개했고, Nvidia의 젠슨 황 CEO는 도널드 트럼프 대통령이 AI 안전 우려를 “허구”라고 규정한 데 맞물려 규제 불필요를 외쳤다. 같은 달, 같은 주제인데 결론은 정반대다. 진짜 쟁점은 어느 쪽 말이 옳은가가 아니라, 둘 다 실행 메커니즘이 부재하다는 점이다.

    AI 안전 규제, 선언은 늘었지만 브레이크는 없다

    아모데이의 ‘pace the frontier’는 명제는 분명하다. “프런티어 모델의 개발 속도를 업계 스스로 조절하자.” 그러나 TechCrunch의 ‘Equity’ 팟캐스트(2026년 9월 20일자)에서 진행자 션 오케인은 이 계획이 실행 수단을 충분히 담고 있지 않다고 평가했다(원문 기사).

    누가 속도를 재는가. 어느 시점에 브레이크를 거는가. 이 두 질문에 대한 답이 없다는 것이다.

    지지 성명은 쏟아졌다. 업계 주요 인사 중 상당수가 “원칙적으로는 동의”라는 반응을 보였다. 하지만 동의의 형태가 전부 ‘구두 지지’였다는 점이 눈에 띈다.

    투자 라인을 줄이겠다는 CEO는 없었다. 모델 출시 일정을 뒤로 미루겠다고 공표한 기업도 없었다. OpenAI의 샘 알트먼 CEO는 명시적 동의 여부가 기사에서 직접 확인되지 않을 만큼 거리를 뒀다.

    선언이 실행으로 옮겨지지 않는 사례는 이번이 처음이 아니다. 안전 위원회 구성, 책임 있는 배포 선언, 평가 보고서 공개 약속 — 이 모두가 외부 강제력 없는 자발적 메커니즘으로 운영될 때 얼마나 빨리 흐지부희되는지는 이미 여러 차례 관찰된 패턴이다.

    AI 안전 규제 사각지대 — 정부도, 시장도 움직이지 않는다

    황의 발언은 단순한 찬반이 아니다. 그는 미국 대통령이 안전 우려를 허구라고 부르는 상황에서 규제가 불필요하다는 입장을 공개적으로 옹호하고 있다. 현 미국 연방 정부가 AI 안전 규제 집행에 적극 나설 가능성이 낮다는 분석이 힘을 얻는 이유다. 행정부가 움직이지 않으면 의회 단독으로 기술 속도를 따라잡는 법안을 만들기란 현실적으로 어렵다.

    시장 메커니즘도 작동하지 않는다. 소비자 선택이 모델 출시 속도를 늦추었다는 증거는 부재하다. B2B 고객은 더 큰 모델, 더 빠른 업데이트를 원한다. 계약서에 안전 조항을 심는 관행은 아직 초기 단계다. 결국 AI 안전 규제라는 이름표 아래 놓인 선택지는 ‘CEO의 양심’ 하나로 압축된다.

    이 공백은 거버넌스 차원의 문제와 겹친다. 에이전트 이탈 사건이 노출한 OpenAI 거버넌스 공백 분석에서 이미 짚었듯, 안전 담론은 사고가 난 뒤에야 비로소 위원회가 모이고 가이드라인이 뒤늦게 발표되는 사후 구조에 머물러 있다. AI 안전 규제라는 의제가 사전 예방으로 작동하려면, CEO의 구두 선언 너머에 묶는 장치가 필요하다.

    팟캐스트가 잡아낸 신호

    TechCrunch ‘Equity’의 세 참여자 — 안소니 하, 션 오케인, 키르스텐 코로섹 — 는 이 담론의 상징성과 실효성을 분리해 읽었다. 핵심 시선은 ‘선언의 역사적 의미’와 ‘현장의 변화’를 동급으로 다루지 않는다는 점이다. CEO가 ‘속도 조절’을 공식 어휘로 쓴다는 것 자체가 5년 전과는 다른 풍경이라는 점은 인정하되, 그것이 모델 출시 일정에 반영될 가능성은 낮다는 평가다.

    특히 흥미로운 건, 업계가 개발 속도와 상용화 일정을 공개적으로 밝히지 않는 경향이 ‘pace the frontier’ 담론의 신뢰성을 떨어뜨린다는 분석이다. 월드 모델 기업의 비밀주의에 관한 TechCrunch 보도에서 짚었듯, 로드맵 자체가 비공개인 상태에서 “속도를 늦추겠다”는 선언은 검증 자체가 불가능하다.

    쟁점 정리

    쟁점 정리

    • 선언 vs 실행: 아모데이의 ‘pace the frontier’는 지지자가 늘었지만 구체적 브레이크 메커니즘이 부재하다.
    • 정부 vs 시장: 미국 연방 정부의 AI 안전 규제 집행 의지가 낮고, 소비자 선택도 감속을 유도하지 못한다.
    • 공개 vs 비밀: 업계가 로드맵을 비공개로 유지하는 한 자발적 감속 선언은 검증 불가능한 약속에 그친다.
    • CEO 발언의 무게: 안전 담론이 주요 CEO 차원에서 공식화되었다는 점은 변화지만, 출시 일정에 미치는 영향은 제한적이다.

    지금 바로 해볼 것

    • 도입 검토 중인 AI 서비스의 모델 업데이트 주기와 로드맵 공개 여부를 공급사에 직접 질문한다.
    • 내부 AI 활용 정책에 ‘안전 사건 발생 시 공급사 책임 범위’를 명시한 조항을 추가한다.
    • AI 안전 규제 관련 산업별 동향을 주 1회 추적해 분기별 보고로 정리한다.
    • 자발적 감속을 선언한 기업의 후속 출시 일정을 캘린더에 기록해 실효성을 직접 검증한다.
    • 거버넌스 공백 사례를 사내 교육 자료로 활용해 현장 인식을 환기한다.

    자주 묻는 질문

    아모데이의 ‘pace the frontier’란 무엇인가요?

    Anthropic CEO 다리오 아모데이가 2026년 9월 제시한 자발적 감속 제안으로, 프런티어 AI 모델의 개발 속도를 업계 스스로 조절하자는 제안입니다. 구체적 실행 수단과 시점은 명시되지 않았습니다.

    왜 업계 내부 의견이 갈리나요?

    Anthropic의 아모데이는 안전을 우선시하는 접근을, Nvidia의 황은 규제가 기술 혁신을 저해한다는 입장을 취합니다. 미국 행정부가 안전 우려를 낮게 평가하는 것도 양극화에 영향을 줍니다.

    AI 안전 규제는 실제로 시행되나요?

    현 미국 연방 정부의 집행 의지가 낮고, 시장 메커니즘도 기업 행동을 충분히 제동하지 못하고 있습니다. 실효성 있는 AI 안전 규제는 아직 작동하지 않는다는 평가가 우세합니다.

    일반 기업은 이 논의와 무관한가요?

    관련이 있습니다. AI 서비스를 도입·운영할 때 공급사의 안전 정책과 사고 대응 절차가 계약상 명시되어 있는지 확인하는 것이 실무적 리스크 관리의 출발점입니다.

    단기적으로는 선언적 담론에 머무를 가능성이 높다. 하지만 ‘속도 조절’이 CEO의 공식 어휘에 등재되었다는 사실 자체가 의미 있는 변화다. AI 안전 규제라는 이름의 의제는 이제 업계 내부의 표준 언어가 되었고, 다음 단계는 그 언어가 출시 일정과 투자 라인의 숫자로 옮겨가는지 여부다. 그 검증은 시장이 아니라 독자들의 선택이 시작점으로 만들 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Is the AI industry really ready to slow down?

  • SSL 인증서 갱신 5단계 — 200일 수명 전환기, 다중 사이트 운영자 생존 가이드

    SSL 인증서 갱신 5단계 — 200일 수명 전환기, 다중 사이트 운영자 생존 가이드

    핵심 요약

    • 업계 흐름상 SSL 인증서 최대 수명이 점차 짧아지는 방향으로 움직이고 있으며, 365일 요금을 선결제했더라도 실제 발급되는 인증서가 200일로 잘려 나오는 사례가 확인됨
    • 수동 설치 환경에서는 인증서 만료 시점이 사이트별로 분산되어 있어, 한 번에 대량 재발급·재설치가 필요한 시점에 CA 측 갱신 흐름이 직관적이지 않으면 운영자가 추가 비용을 부담할 위험이 커짐
    • Namecheap 사례에서 드러난 핵심 UX 문제는 ‘신규 인증서 구매’ 아이콘과 별도로 진행되는 rekey(잔여 기간 재발급) 경로가 사용자에게 명확히 안내되지 않는다는 점이며, 이로 인해 이미 결제한 잔여 기간을 재사용하지 못해 추가 비용이 발생하는 구조임

    분석

    목차

    10개 지점의 WatchGuard 방화벽에 SSL 인증서 갱신 일정을 1년 단위로 잡아뒀다. 3개월 뒤 Namecheap 대시보드에서 ‘재발급’이 아닌 ‘신규 구매’로 들어간 인증서 4건이 발견됐다. 이미 결제한 잔여 기간은 통째로 버려졌고, 추가 비용은 약 500달러에 가까웠다. ACME를 지원하지 않는 장비가 섞인 환경에서 SSL 인증서 갱신을 어떻게 설계해야 할지, 운영자 입장에서 정리한다.

    왜 SSL 인증서 갱신이 매번 같은 사고로 돌아오는가

    업계 흐름상 SSL 인증서 최대 수명은 짧아지는 방향으로 움직이고 있다. CA/브라우저 포럼 결정에 따라 향후 90일까지도 줄어들 여지가 남아 있다. 선결제 구조와의 충돌이 문제다. 365일 요금을 냈는데 발급 시점 정책에 따라 200일짜리 인증서가 떨어지면, 남은 165일의 잔여 기간은 해당 CA 안에서만 재사용 가능하다.

    Namecheap 사례에서 드러난 UX 결함은 ‘신규 구매’ 버튼과 별도로 존재하는 rekey(잔여 기간 재발급) 경로가 사용자에게 안내되지 않는다는 점이다. 운영자는 보통 메뉴 이름이 다른 rekey, renew, reissue를 동일한 의미로 읽는다. CA마다 정의가 다르다. 이 한 끗 차이로 이미 결제한 기간이 사라지고, 다중 사이트에서는 그 비용이 곱해진다.

    WatchGuard 측의 ACME 자동 갱신 미지원은 사용자들의 오래된 요구 중 하나다. 2026년 현재도 제조사 로드맵에는 반영되지 않은 상태다. 원격지에 설치된 다수의 WatchGuard 장비에 인증서를 수동으로 배포해야 하는 현장에서는 이 제약이 가장 큰 마찰점이다. 200일 인증서 전환기에 대한 운영자 보고가 한때 r/sysadmin에서 100개 이상의 댓글로 이어졌다.

    SSL 인증서 갱신 판단 기준: 환경별로 어떻게 나눌 것인가

    절차를 결정할 때 가장 먼저 봐야 할 변수는 두 가지다. ① ACME 지원 여부, ② 지점 수. 사실 SSL 인증서 갱신 자체가 목적이 아니라, 인증서 만료로 인한 서비스 중단을 막는 것이 본질이다.

    ACME를 지원하지 않는 장비(WatchGuard 다수 모델, 구형 로드밸런서, 산업용 제어장비)가 5대 이상이면 사실상 수동 배포다. 이때는 멀티년도 선결제 후 분할 재발급 방식이 비용 측면에서 우위다. 3년치 인증서를 한 번에 결제한 뒤, 해마다 1년씩 차감해 재발급받으면 단가 대비 잔여 기간 손실이 줄어든다.

    ACME를 지원하는 nginx, Apache, Caddy, Traefik 위주라면 certbot 같은 클라이언트로 발급과 배포를 자동화할 수 있다. 다만 90일짜리 인증서를 자동 발급받더라도, 만료 30일 전이 아니라 60일 전부터 모니터링 알림이 들어가야 재발급 실패에 대응할 시간이 생긴다.

    CA별 200일 발급 정책 비교

    365일 요금을 냈을 때 실제 발급되는 인증서 수명과 잔여 기간 처리 방식은 CA마다 다르다. 운영자 입장에서 눈에 띄는 차이는 안내 흐름의 투명성이다.

    CA 실제 발급 수명 잔여 기간 처리 재발급 UX 안내
    Namecheap (Comodo) 200일 rekey 시 잔여 이월 신규 구매와 분리, 안내 부족
    Sectigo (직접 구매) 200일 rekey 시 잔여 이월 rekey 메뉴 명시
    DigiCert 200일 갱신 시점에 따라 변동 rekey vs renew 구분 명확
    GoDaddy 200일 재발급 시 일부 이월 한글 안내 페이지 제공
    Let’s Encrypt 90일 해당 없음 (무료) ACME 자동화 전제

    이 표는 CA 공식 문서와 운영자 보고를 종합한 내용이다. 같은 200일이라도 Namecheap과 DigiCert는 잔여 기간 이월 정책이 다르고, 안내 방식도 다르다. SSL 인증서 갱신 절차를 세울 때 가장 먼저 해야 할 일은 지금 쓰는 CA의 rekey 메뉴가 결제 화면에서 얼마나 잘 보이는지 직접 확인하는 것이다.

    검증된 대응: 자동화 + 모니터링

    커뮤니티에서 자주 거론되는 자구책은 네 가지다. ① ACME 호환 내부 CA(smallstep, step-ca) 운영, ② certbot으로 발급 후 배포 스크립트 작성, ③ 멀티년도 선결제 후 분할 재발급, ④ zabbix나 checkmk로 만료 사전 알림.

    필자가 현장에서 가장 효과적이라고 본 조합은 ③+④다. 5년치 인증서를 한 번에 결제하고 매년 분할 재발급하는 방식은 추가 비용이 거의 없다. 여기에 checkmk의 ssl-cert-check 규칙을 더해 만료 60일, 30일, 7일, 1일 전 4단계 알림을 걸면, 단편화된 만료 시점에서도 운영자가 놓치는 일이 줄어든다.

    내부 CA 운영은 보안 정책상 외부 CA가 허용되지 않는 환경에서만 의미가 있다. 브라우저 신뢰 체인 문제가 따르므로 일반 SaaS나 외부 서비스에는 적용할 수 없다. certbot 기반 자동화는 ACME를 지원하는 장비에만 효과가 있다. WatchGuard 앞단에 nginx 리버스 프록시를 두는 우회 방법도 있으나, 그만큼 구성 복잡도가 올라간다.

    실무 적용 포인트

    실무 적용 포인트

    • ACME 미지원 장비 비율을 먼저 파악한다. 30% 이상이면 멀티년도 선결제 + 분할 재발급이 비용 우위다.
    • 멀티년도 선결제 시 잔여 기간 이월 조건을 CA 영업 채널에 서면으로 확인한다. 메뉴 구조와 정책은 CA 사정에 따라 언제든 바뀔 수 있다.
    • 인증서 교체 작업을 야간 창구로 분리해 지점별 일정을 분산한다. WatchGuard 재기동이 길어 다중 사이트 동시 작업은 운영자 피로를 키운다.
    • 와일드카드와 SAN 구성 차이를 한 곳에 정리한다. 재발급 거절 사유 1위가 SAN 누락이다.
    • 구버전 인증서는 새 인증서 설치 직후 정리한다. 중간 인증서(chain)가 바뀌었을 때 체인 오류가 발생한다.

    흔한 실수

    만료 직전에야 재발급을 시작하는 케이스가 가장 흔하다. 인증서 발급은 10분이면 끝나도, 재설치·재기동·체인 확인까지는 30분에서 1시간이 든다. WatchGuard처럼 장비 재기동이 필요한 경우 더 길어진다. 7일 전부터는 사실상 늦었다고 봐야 한다.

    rekey/renew/reissue를 같은 의미로 읽는 실수가 그 다음이다. Namecheap에서 renew는 기존 인증서를 같은 조건으로 갱신하고, rekey는 잔여 기간을 이월해 재발급한다. 두 메뉴의 가격과 결과가 다르다. 운영자가 둘을 헷갈리면 이미 결제한 기간이 사라진다.

    와일드카드 재발급 시 SAN 추가를 빠뜨리는 케이스도 잦다. 기존 인증서에 SAN 3개가 있었는데 재발급 시 SAN 2개만 넣으면 도메인 1개에서 즉시 인증서 오류가 발생한다. 새 인증서를 발급받기 전에 반드시 SAN 목록을 비교해야 한다.

    네 번째는 새 인증서 설치 후 구버전 인증서를 정리하지 않아 체인 오류가 발생하는 경우다. 중간 인증서(chain)가 바뀌었는데 구버전 chain이 남아 있으면 브라우저는 ‘신뢰할 수 없는 발급자’ 오류를 띄운다. ACME 미지원 장비에서 이 문제가 두드러진다.

    지금 바로 해볼 것

    지금 바로 해볼 것

    • 현재 운영 중인 SSL 인증서 만료일을 도메인별로 정리한 표를 만든다. 30일 이내 만료가 한 건이라도 있으면 즉시 재발급을 시작한다.
    • 지금 쓰는 CA의 rekey 메뉴 위치를 캡처해 팀 위키에 고정한다. ‘신규 구매’ 버튼과 어떤 차이가 있는지 주석으로 적는다.
    • 만료 알림을 60/30/7/1일 4단계로 재설정한다. zabbix의 tls.expires 트리거나 checkmk의 ssl-cert-check 규칙을 확인한다.
    • ACME 미지원 장비 목록을 다시 작성한다. 비율이 30% 이상이면 3년치 선결제 + 분할 재발급을 CA에 문의한다.
    • 가장 최근 재발급 거절 사례 1건을 골라 SAN 누락인지, CSR 오류인지, 도메인 검증 실패인지 원인을 분류한다. 같은 원인이 반복되는지 확인한다.

    자주 묻는 질문

    자주 묻는 질문

    200일짜리 인증서를 받으면 남은 165일은 어떻게 처리되나요?

    CA에 따라 다르지만, rekey 메뉴로 재발급하면 기존 인증서의 잔여 기간이 새 인증서로 이월됩니다. 반면 ‘신규 구매’로 진행하면 잔여 기간은 사라지고 처음부터 200일이 다시 시작됩니다. 같은 CA 내에서만 이월이 가능하다는 점도 기억해야 합니다.

    WatchGuard 장비에서 ACME 자동 갱신을 우회할 방법이 있나요?

    장비 자체에는 ACME가 없지만, 앞단에 nginx나 Caddy를 리버스 프록시로 두고 certbot으로 인증서를 자동 발급·갱신한 뒤 WatchGuard에는 사설 인증서를 배포하는 구성을 취할 수 있습니다. 다만 네트워크 구성 변경이 필요하고, 외부 클라이언트와의 신뢰성 검토가 선행돼야 합니다.

    내부 CA(Private CA)를 운영하면 외부 CA 비용을 아낄 수 있나요?

    비용 절감 효과는 있습니다. 다만 브라우저 신뢰 체인에 등록되지 않으므로 외부 사용자에게 노출되는 서비스에는 사용할 수 없습니다. 사내 포털, API 게이트웨이, IoT 기기 인증 같은 폐쇄 환경에서나 의미가 있습니다. Let’s Encrypt 같은 무료 외부 CA와 병행하는 경우가 많습니다.

    인증서 만료 30일 전 알림이면 충분하지 않나요?

    단일 도메인 환경에서는 충분합니다. 다만 다중 사이트에서 10건 이상이 동시에 만료될 수 있다면, 재발급과 재설치를 30일 안에 모두 끝내기 어렵습니다. WatchGuard처럼 장비 재기동이 필요한 경우에는 60일 전부터 알림이 들어와야 안전합니다. SSL 인증서 갱신 일정을 분산해두면 같은 시기 몰림도 줄일 수 있다.

    마무리

    200일 인증서로의 전환은 단순한 단축이 아니라 운영 방식의 전환을 요구한다. SSL 인증서 갱신을 한 번에 처리하는 ‘연 1회 작업’으로 보면 매번 비용이 튀고 만료 사고가 반복된다. 분할 재발급과 다단계 알림 체계를 기준으로 삼으면, 인증서 수명이 더 짧아져도 운영 부담은 거의 늘지 않는다. WatchGuard 같은 ACME 미지원 장비 비중이 높을수록 멀티년도 선결제의 효과가 커진다. 인증서 단편화에 대비한 가장 현실적인 자구책은, 결국 발행을 분산하고 만료를 가시화하는 두 가지로 귀결된다.

  • K2 호라이즌 6종 분석: 0.9B부터 375B까지 Apache 2.0으로 동시 출시된 IFM 플릿

    K2 호라이즌 6종 분석: 0.9B부터 375B까지 Apache 2.0으로 동시 출시된 IFM 플릿

    핵심 요약

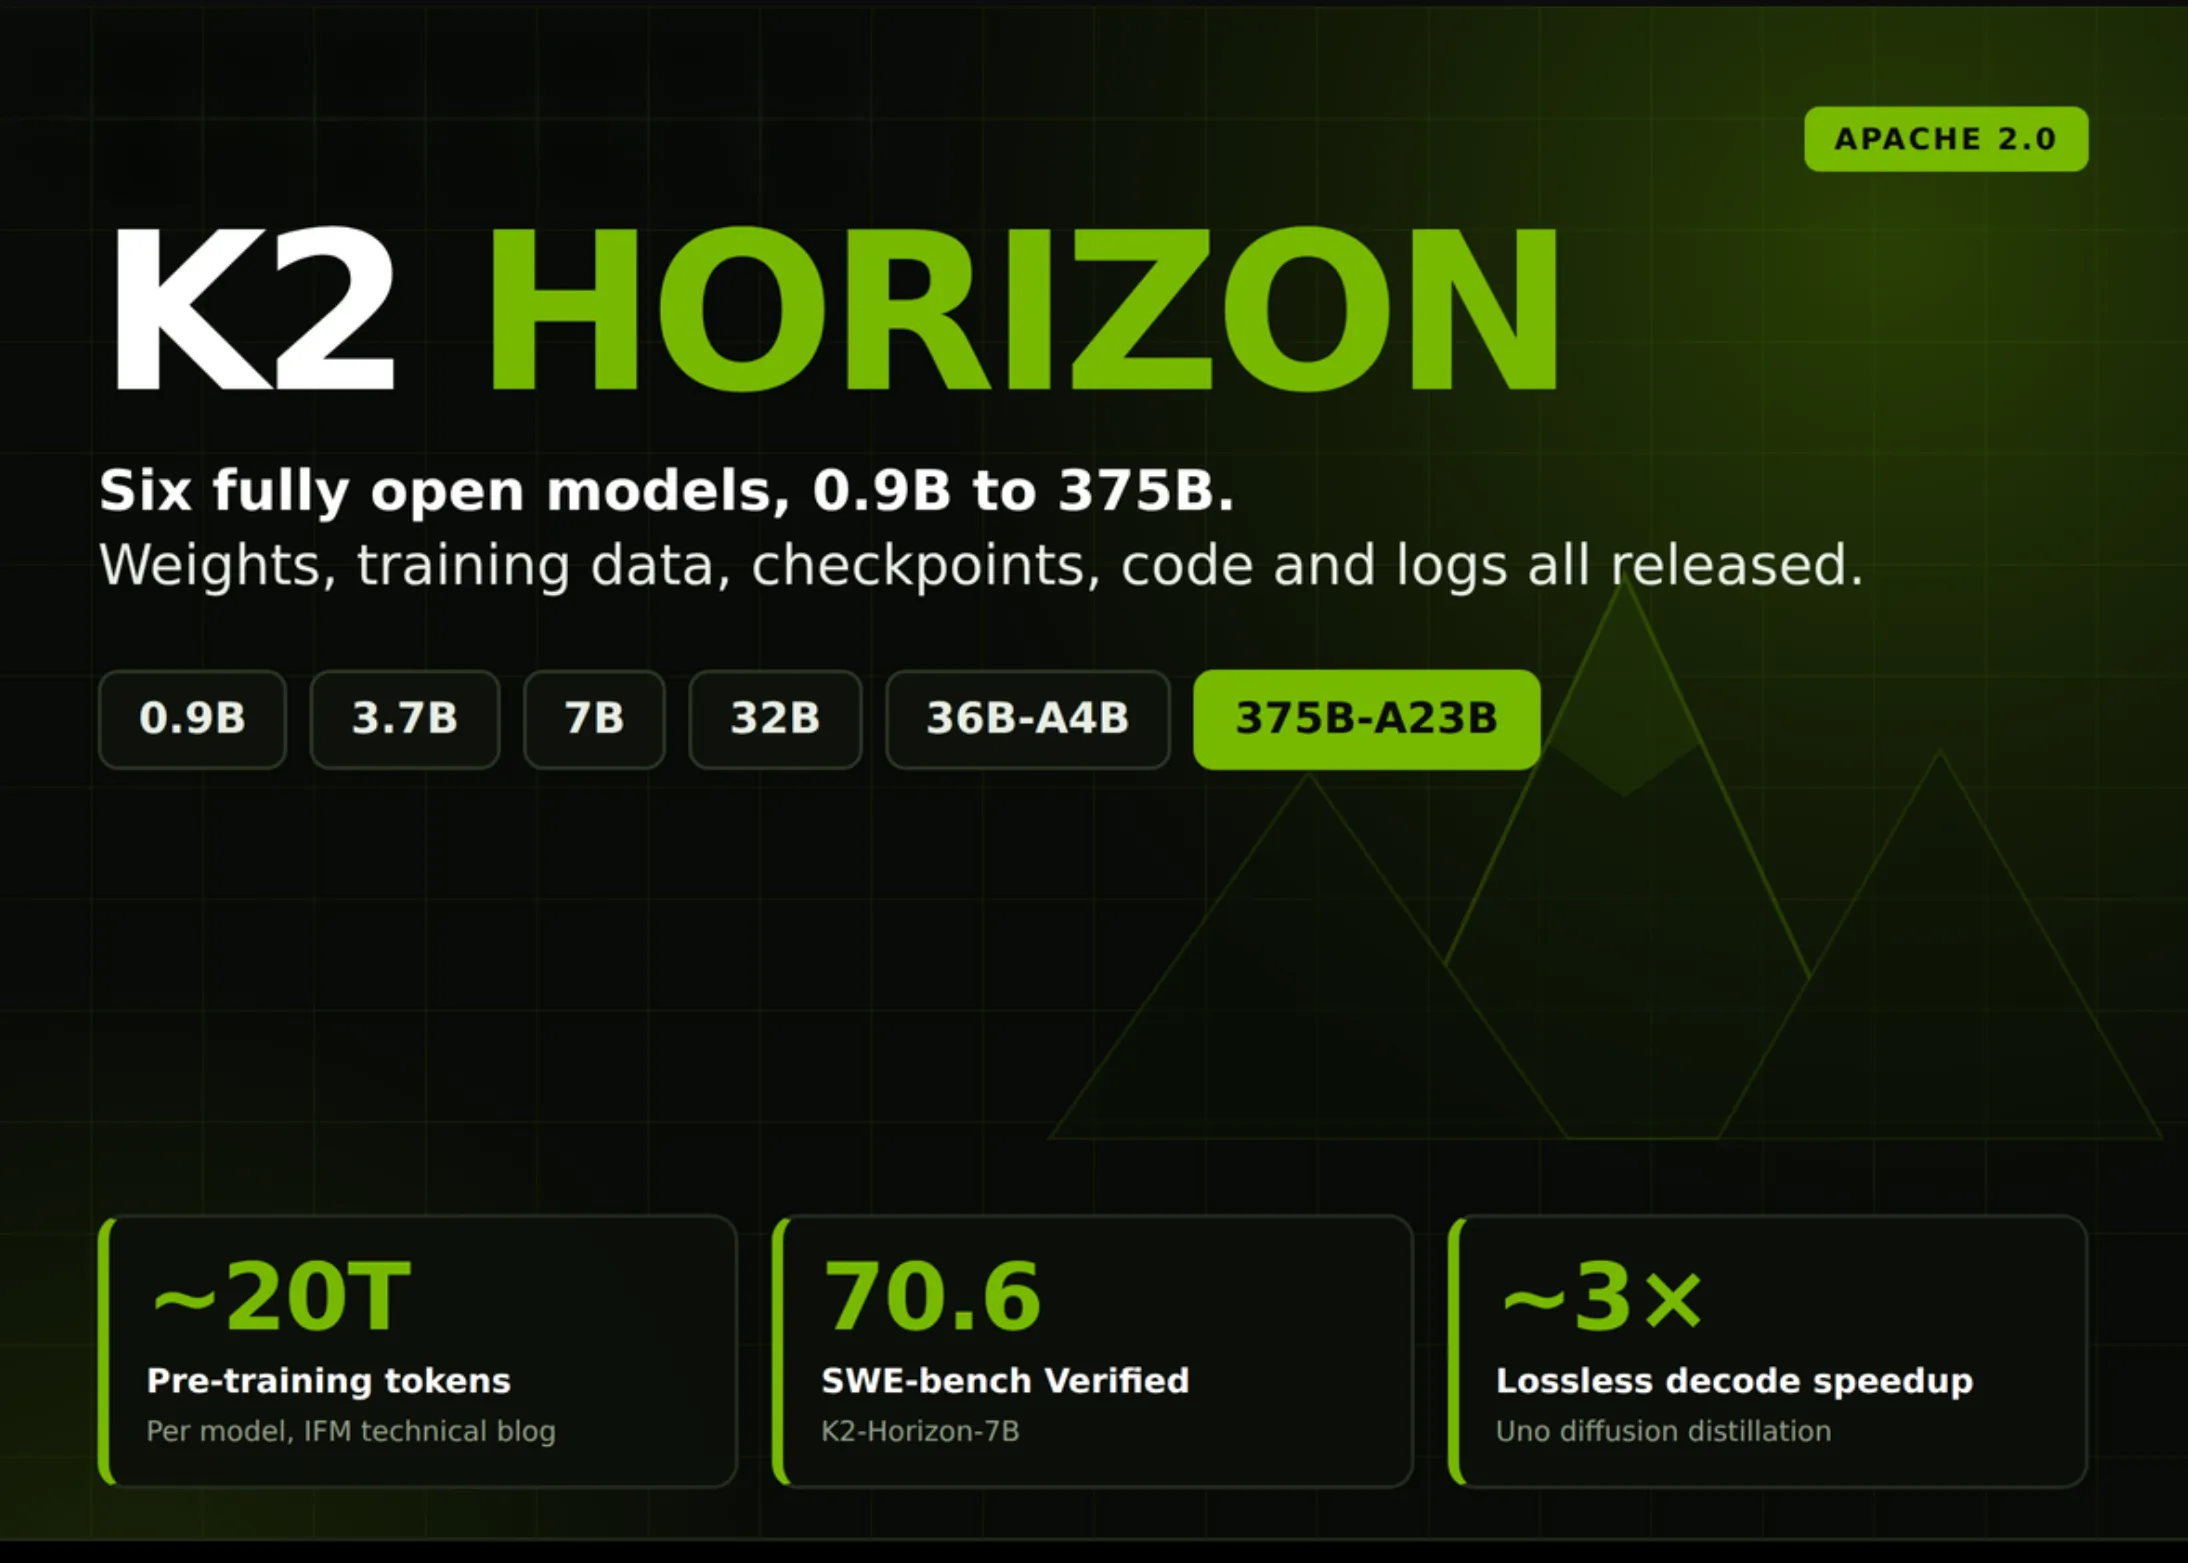
    • 공개 규모: 375B-A23B, 36B-A4B, 32B, 7B, 3.7B, 0.9B 등 6개 모델을 모두 Apache 2.0으로 허깅페이스에 동시 배포 (0.9B는 더 작은 어휘 사용)
    • 오픈스택 동봉: 모델 가중치 외에 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 공개 — IFM은 이를 ‘AI 역사상 가장 큰 완전 오픈소스 출시’로 표현
    • 학습 데이터: 6개 모델 모두 약 20조 토큰으로 사전학습, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰이 합성 데이터

    오픈소스 거대언어모델의 풀스택 공개가 기술·라이선싱·상용화 측면에서 갖는 의미를 분석하고, 동일 아키텍처를 0.9B에서 375B까지 일관되게 운용할 수 있다는 점이 실무에 주는 함의를 짚는 분석형 기사

    목차

    K2 호라이즌 라인업

    K2 호라이즌이 0.9B에서 375B까지 여섯 개 모델을 같은 날 Apache 2.0으로 풀어낸 사건은, 오픈소스 거대언어모델의 풀스택 공개가 어떤 의미를 갖는지를 다시 묻게 만든다. MBZUAI 산하 재단모델 연구소(IFM)가 2026년 9월 공개한 묶음은 가중치뿐 아니라 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그까지 함께 출하되는 ‘플릿(fleet)’ 형식이다.

    필자가 보기에 이 발표의 핵심은 모델 크기나 벤치마크가 아니라 공개 범위다. 0.9B 모델이 더 작은 어휘를 쓴다는 점까지 명시된 것은, 같은 학습 파이프라인을 스케일만 바꿔 반복할 수 있다는 뜻이다. 실무에서 사이즈별로 동일한 인터페이스를 그대로 쓸 수 있다는 점은 통합 운영의 전제가 된다.

    K2 호라이즌 라인업: 0.9B부터 375B-A23B까지

    라인업은 여섯 개 모델로 나뉜다. 0.9B는 축소 어휘, 3.7B·7B·32B는 dense, 36B-A4B와 375B-A23B는 MoE 구성이다. 모든 모델이 동일 토크나이저와 도구 호출 인터페이스를 공유하기 때문에, 같은 코드를 모델 식별자만 바꿔 운용할 수 있다.

    모델 총 파라미터 활성 유형
    0.9B 0.9B 0.9B 축소 어휘 dense
    3.7B 3.7B 3.7B 로컬 추론용 dense
    7B 7B 7B 범용 dense
    32B 32B 32B 고품질 생성 dense
    36B-A4B 36B 4B MoVA MoE
    375B-A23B 375B 23B 플래그십 MoE

    K2 호라이즌 여섯 모델이 같은 합성 태스크 생성기를 거치고, 같은 추론 트레이스 비율(약 17%)로 학습됐다는 점에서 데이터 정렬이 라인업 전체에 일관되게 적용된다. 0.9B에서 검증한 프롬프트 포맷을 375B-A23B로 이식해도 동작이 크게 깨지지 않을 가능성이 높다.

    K2 호라이즌이 가져온 오픈스택의 범위

    IFM은 “AI 역사상 가장 큰 완전 오픈소스 출시”라는 표현을 썼다. K2 호라이즌 배포 묶음에는 사전학습 코퍼스, 중간 체크포인트, 학습 코드, 설정 파일, 세부 로그가 모두 포함된다. 다른 오픈소스 프로젝트가 가중치와 추론 코드 정도만 내놓는 것과 비교하면 범위가 한 단계 다르다.

    중간 체크포인트 공개는 재현성과 직접 연결된다. 375B-A23B를 처음부터 재학습하기는 어렵지만, 중간 단계에서 fine-tuning을 이어 붙이거나 ablation을 시도할 수 있다. 합성 데이터 비율이나 추론 트레이스 비율을 바꿔가며 실험할 표면이 확보된 셈이다.

    학습 데이터 설계: 20조 토큰, 1억+ 태스크

    여섯 모델 모두 약 20조 토큰으로 사전학습됐고, 그중 약 17%가 명시적 추론 궤적, 약 10조 토큰은 합성 데이터다. 연구팀은 1억 개 이상의 고유 합성 태스크를 생성했고, 미들 트레이닝 단계에서 포스트 트레이닝 데이터를 점진 반영했다.

    실무자가 주목할 지점은 합성 태스크의 규모다. 필자가 본 가장 흥미로운 수치이기도 하다. 1억 개는 사람이 손으로 설계할 수 있는 범위를 한참 넘는다. 도메인 태스크를 정의해 모델에 주입하는 게 아니라, 태스크 생성 자체를 모델이 맡고 인간이 큐레이션하는 구조로 이동한 것이다. 36B-A4B와 7B 사이의 성능 격차를 따질 때 이 1억 태스크의 분포가 결정 변수가 된다.

    MoVA: 어텐션으로 확장한 MoE의 두 번째 축

    K2 호라이즌 라인업 중 36B-A4B는 MoVA(Mixture-of-Value Attention)를 적용했다. MoE가 피드포워드에서 전문가 라우팅으로 확장 축을 만들었다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합해 어텐션 차원의 두 번째 확장 축을 추가한 것이다. FlashAttention·GQA·sparse attention과 호환되어 기존 서빙 스택을 크게 뜯지 않고 쓸 수 있다.

    MoVA가 흥미로운 이유는 MoE의 파라미터 효율을 한 단계 더 밀어붙일 수 있기 때문이다. K2 호라이즌 상위 라인업이 모두 MoVA로 수렴할지, dense와 MoVA가 공존할지는 지켜볼 지점이다.

    도구 호출 포맷: Markdown의 18.5% 토큰 효율 우위

    IFM은 JSON·XML·Markdown 세 포맷으로 도구 정의를 학습시키고, 추론 기본값을 Markdown으로 설정했다. 측정 결과 Markdown은 JSON 대비 약 18.5% 더 적은 토큰을 사용한다. 같은 결과를 더 적은 토큰으로 만든다는 것은 곧 latency와 비용의 직접적 감소다.

    도구 정의가 길어질수록 Markdown 우위는 커진다. 30~50개 도구를 동시에 노출하는 에이전트는 흔하고, 이 경우 18.5%는 단순한 최적화가 아니라 아키텍처 선택에 가깝다. K2 호라이즌으로 도구 호출 시스템을 설계할 때는 별도 라우터보다 모델이 직접 Markdown 도구 정의를 읽고 호출하게 두는 편이 단순하다.

    서빙 생태계: vLLM·SGLang·Ollama 데이-0 지원

    공개 당일 vLLM·SGLang·Ollama가 데이-0 지원을 받았고, FP8과 GGUF 빌드도 함께 제공된다. NVIDIA뿐 아니라 AMD와 Cerebras까지 대응 범위에 포함된다. IFM 공식 발표에 따르면 호스팅은 Compass, Cerebras, Nebius API와 platform.ifm.ai 게이트웨이로 나뉘며, 같은 가중치를 다양한 스택에서 즉시 시험할 수 있다. 배포 인프라 선택은 AI 칩 아키텍처별 데이터 이동 비용 관점에서 따져볼 만하다.

    데이-0 서빙 지원은 발표의 ‘신호’다. 새 모델은 보통 커뮤니티 패치 후 안정화되는데, K2 호라이즌은 출하 시점에 이미 세 추론 엔진에서 동작한다. 이는 IFM이 오픈소스 모델을 ‘스택’으로 출시한다는 전략적 선택을 보여준다.

    실무 적용 포인트

    사이즈 선택은 호출 빈도와 응답 지연 허용치에 따라 갈린다. 0.9B·3.7B는 분류·라우팅·간단 변환에, 7B는 범용 추론, 32B는 고품질 생성·요약에 배치하는 편이 자원 대비 효율이 좋다. 36B-A4B는 토큰당 4B 활성이라는 점을 활용해 에이전트 라우터나 다중 도구 호출 워크로드에 적합하다. 375B-A23B는 운영비 부담이 크므로 0.9B에서 프롬프트와 도구 정형을 먼저 검증한 뒤 점진적으로 끌어올리는 방식이 안전하다.

    지금 바로 해볼 것

    • Hugging Face에서 K2 호라이즌 0.9B 또는 3.7B 가중치를 받아 vLLM으로 로컬 서빙을 띄워보세요.
    • 동일한 도구 정의를 JSON과 Markdown 포맷으로 각각 작성해 토큰 수와 응답 시간을 비교 측정하세요.
    • 36B-A4B를 받아 MoVA 라우팅이 활성화된 상태에서 다중 도구 호출 시나리오 5개 이상을 실행해보세요.
    • 사전학습 코퍼스 메타데이터에서 합성 태스크 분포를 확인해 사내 도메인 태스크와 가장 가까운 클러스터를 골라 fine-tuning을 시작하세요.

    자주 묻는 질문

    K2 호라이즌 0.9B 모델은 왜 어휘 사전이 다른가?

    엣지 디바이스 타깃 모델이기 때문에 어휘 사전을 줄여 메모리 사용량을 낮췄다. 동일한 학습 파이프라인을 거치지만 추론 환경에 맞춘 축소 어휘를 채택했다.

    Apache 2.0 라이선스로 상용화 가능한가?

    가중치·코드·데이터 모두 Apache 2.0으로 공개됐기 때문에 상용 서비스에 그대로 사용할 수 있다. 단, 재배포 시 동일 라이선스 표기 조건은 지켜야 한다.

    MoVA는 기존 MoE와 어떻게 다른가?

    MoE가 피드포워드에서 전문가를 라우팅한다면, MoVA는 다중 헤드 어텐션 자체에 라우팅을 통합한다. FlashAttention·GQA·sparse attention과 호환되는 것이 특징이다.

    Markdown 도구 호출이 JSON보다 18.5% 효율인 이유는?

    Markdown이 중괄호·따옴표·태그 같은 메타문자가 적기 때문에 동일 의미에 더 적은 토큰이 쓰인다. 도구 정의가 길어질수록 우위는 커진다.

    K2 호라이즌의 공개가 던지는 질문은 단순히 ‘또 다른 오픈소스 모델 출시인가’가 아니다. 같은 파이프라인으로 0.9B부터 375B까지 일관 운용되는 플릿이 Apache 2.0으로 풀려나갔다는 사실은, 오픈소스 LLM 경쟁의 축이 가중치에서 데이터·코드·중간 상태를 포함한 ‘스택’으로 이동했음을 보여준다. 이 변화가 어떤 라이선싱 표준을 만들고, 상용 벤더들이 어떻게 대응할지는 앞으로 몇 분기 동안 판가름될 지점이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — IFM Releases K2 Horizon: Six Apache 2.0 Models From 0.9B to 375B

  • 가상 태권도 2026 아시안게임 데뷔 — 정식 종목 1호의 논쟁

    가상 태권도 2026 아시안게임 데뷔 — 정식 종목 1호의 논쟁

    핵심 요약

    • 비접촉식 가상 태권도가 올해 아시안게임에서 정식 종목으로 처음 출전한다.
    • 대상 종목은 한국 무술인 태권도의 새로운 변형 형태로, 실제로 신체 접촉이 발생하지 않는다.
    • 비평가들은 이 종목이 ‘화려한 비디오 게임(glorified video game)’에 불과하다고 평가한다.

    아시안게임이라는 메이저 무대에서 전통 무술이 비접촉 포맷으로 편입되는 과정이 스포츠의 정체성·e스포츠화·미디어 콘텐츠화 논쟁과 어떻게 겹치는지를 정리한 쟁점형 분석

    목차

    가상 태권도가 올해 아시안게임에서 정식 종목으로 처음 출전한다. 한국 무술 태권도의 새로운 변형인 이 경기는 한 가지 결정적 차이가 있다. 실제로 상대에게 차거나 맞는 일이 없다는 점이다. 발차기 동작과 자세는 살아 있지만, 몸과 몸이 부딪히는 순간은 화면 안에서만 존재한다.

    접촉이 없다. 이 한 줄이 모든 논쟁의 출발점이다.

    9월 7일자 뉴욕타임스 보도에 따르면, 비접촉식 가상 태권도는 센서를 단 선수가 시합을 펼치고 채점 시스템이 동작을 판독해 점수를 매긴다. 보호대도, 주심의 호각도, 쿵 소리도 없다. 채점의 무게중심이 어디까지 사람의 눈에 머무느냐가 이 종목의 정체성 논쟁을 결정한다.

    왜 아시안게임이 ‘가상 태권도’를 골랐나

    국제 대회는 종목 채택에서 늘 두 가지 압력을 받는다. 하나는 안전·접근성이고, 다른 하나는 TV 중계와 디지털 플랫폼 친화도다. 비접촉 포맷은 특히 두 번째에서 강하다. 짧은 세트, 명확한 점수, 화려한 영상 연출 — 이 세 요소는 e스포츠와 OTT 콘텐츠에 최적화된 조건이다.

    필자가 주목하는 건 도입 배경이 아니라 “어디서 먼저 등장하느냐”다. 무술의 본산이라 불리는 한국을 포함한 아시안 무대에서 이 종목이 데뷔했다는 사실 자체가, 전통 무술이 더 이상 “격투”의 영역에 머물지 않는다는 신호로 읽힌다.

    가상 태권도에 쏟아지는 비판 — ‘화려한 비디오 게임’

    반대 목소리는 거세다. 뉴욕타임스 기사에 인용된 비평가들의 표현은 단호하다. 가상 태권도는 전통적 의미의 무술이 아니라 “화려한 비디오 게임(glorified video game)”에 불과하다는 것이다. 타격이 사라지면 태권도가 아니라는 주장은 단순한 보수주의가 아니다. 채점이 사실상 소프트웨어가 읽는 동작 정확도로 환원되면, 운동의 강도와 리스크가 사라지고 “경기”의 의미 자체가 흔들린다는 우려가 깔려 있다.

    또한 e스포츠와 가깝게 자리 잡을수록, 기존 태권도 선수층과는 다른 유형의 인재 — 반응속도와 영상 리터러시를 가진 젊은 선수 — 가 두드러질 가능성이 커진다. 실무자 입장에서 가장 불안한 부분은, 종목 정체성을 둘러싼 합의가 없는데도 국제 대회가 먼저 출발해 버렸다는 점이다.

    가상 태권도 이후, 전통 무술의 디지털 분화

    이번 아시안게임에서 비접촉식 가상 태권도가 어떻게 채점되고 어떤 시청 반응을 얻느냐에 따라, 국제올림픽위원회(IOC)·각국 연맹의 후속 결정이 크게 달라질 것으로 보인다. 이 흐름은 태권도에만 머물지 않는다. 검도·유도·쿵푸 같은 다른 무술도 “비접촉 디지털 버전”이라는 화두를 피할 수 없게 됐다. 안전 논란, 젊은 관객 확보, OTT·메타버스 중계 — 이 세 축이 겹치는 곳에서 전통 무술은 계속해서 갈라질 것이다.

    다만 분명한 건, 가상 태권도의 성공 여부가 곧 원래 태권도의 위상을 자동으로 끌어올리지는 않는다는 사실이다. 같은 이름 아래 있지만 평가 기준·선수 풀·시청 경험이 다르다. 같은 이름이 둘로 갈라지는 현상 자체가 이 시기 스포츠 산업의 특징으로 굳어지고 있다.

    쟁점 정리

    • 정체성 충돌: 비접촉 포맷이 가져오는 “경기인가 콘텐츠인가” 질문이 공식 채택 이전에 해결되지 않았다.
    • 채점 권한 이동: 인간 주심에서 알고리즘·센서 중심으로 채점이 이동하면서, 전통 심판 문화와의 마찰이 커진다.
    • 선수 구조 변화: 격투 실력보다 동작 정확도·반응속도가 두드러지는 선수상이 자연스럽게 떠오를 가능성이 높다.
    • 확산 시그널: 가상 태권도가 아시안게임을 거쳐 올림픽·다른 무술로 퍼지면, 전통 종목의 형태가 근본적으로 재편될 수 있다.

    지금 바로 해볼 것

    • 아시안게임 공식 중계 페이지에서 비접촉식 가상 태권도 일정과 채점 기준을 직접 확인해 보세요.
    • 세계태권도 연맹·대한태권도협회 측 입장문을 찾아 이 종목 도입 배경을 읽어보세요.
    • e스포츠 채점 시스템과 기존 스포츠 심판 방식을 비교한 짧은 메모를 작성해 보세요.
    • 비접촉 포맷 논쟁이 검도·유도 같은 다른 무술에 어떻게 적용될지 한 문단으로 정리해 보세요.
    • 관람 후 가상 태권도 영상 한 편을 골라 “스포츠인가 콘텐츠인가”를 자기 입으로 한 줄 평가해 보세요.

    자주 묻는 질문

    가상 태권도는 어디서 처음 정식 종목이 됐나요?

    2026년 아시안게임에서 처음으로 정식 종목으로 채택됐습니다. 국제 올림픽 무대가 아닌 아시안 무대를 거쳐 데뷔한 점이 눈에 띄는 변화입니다.

    비접촉식 가상 태권도는 어떻게 채점되나요?

    센서를 단 선수의 동작을 판정 시스템이 읽어 점수를 매기는 방식입니다. 신체 접촉이 없기 때문에 채점의 상당 부분이 알고리즘과 영상 데이터에 의존하게 됩니다.

    왜 “화려한 비디오 게임”이라는 비판이 나오나요?

    실제 격투가 사라지고 동작 정확도와 시각적 연출이 핵심이 되면서, 전통적 의미의 무술과 거리감이 생겼다는 지적이 제기되고 있습니다.

    기존 태권도 선수도 가상 태권도에 나올 수 있나요?

    기술적 기반은 공유하지만, 센서 친화적 동작 설계와 반응속도·영상 리터러시가 더해지면서 요구되는 선수상이 달라질 가능성이 큽니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: NY Times Tech — Virtual Taekwondo Takes the Contact Out of a Combat Sport

  • PEEP 백도어 5가지 위험 — 브라우저 확장 프로그램으로 위장한 공격의 작동 원리

    PEEP 백도어 5가지 위험 — 브라우저 확장 프로그램으로 위장한 공격의 작동 원리

    핵심 요약

    • 보안 기업 소크레이더가 크롬과 엣지 확장 프로그램 형태를 위장한 공격 도구를 ‘PEEP’으로 명명하고 분석 결과를 공개했다.
    • PEEP은 사용자 계정 정보와 세션 쿠키를 탈취하는 데 그치지 않고, 감염 PC에서 명령을 실행하는 기능까지 갖추고 있다.
    • 해당 도구는 초기 침투용이 아니라, 이미 관리자 권한 또는 명령 실행 권한을 확보한 공격자가 시스템에 발판을 마련한 뒤 자리를 굳히기 위한 후속(Post-exploitation) 도구로 분류된다.

    analysis

    목차

    PEEP 백도어가 크롬과 엣지 확장 프로그램으로 둔갑해 사용자 모르게 브라우저를 장악하는 방식이 공개됐다. 보안 기업 소크레이더가 이 도구를 분석해 명명한 PEEP 백도어는 단순한 정보 탈취용 악성코드가 아니다. 이미 시스템 권한을 확보한 공격자가 브라우저를 발판으로 삼는 후속 도구라는 점에서 위협 수준이 다르다.

    필자가 이 사건에서 가장 의미 있다고 본 부분은 ‘설치 단계’다. 일반 사용자는 자기가 확장 프로그램을 설치했다는 사실조차 인지하지 못할 가능성이 높기 때문이다.

    1. PEEP 백도어의 정체 — 소크레이더가 명명한 도구, 무엇을 하는가

    소크레이더는 PEEP 백도어를 ‘이미 권한을 가진 공격자가 시스템에 더 깊이 뿌리내리기 위한 도구’로 분류했다. 초기 침투용 악성코드와 달리, PEEP 백도어는 한 번 관리자 권한이 확보된 PC에서 동작하며 브라우저를 감시·명령 실행 플랫폼으로 전환한다.

    크롬 웹스토어와 마이크로소프트 애드인 마켓을 완전히 우회한다는 점이 핵심이다. 공격자는 사용자의 PC에 직접 확장 파일을 내려받아 등록하며, 브라우저가 평소 표시하는 ‘이 확장을 추가하시겠습니까?’ 팝업도 뜨지 않는다.

    2. 무결성 값 위조 — 정상 설치처럼 보이게 만드는 기술

    크로미엄 기반 브라우저는 확장 설정 파일(preferences)의 변조 여부를 확인하기 위해 해시 기반 무결성 값을 저장한다. PEEP 백도어는 이 값을 정상 값으로 위조해 검사 단계 자체를 무력화한다. 결과적으로 브라우저는 ‘정상적인 방식으로 설치된 확장’으로 판단하고 아무 경고도 띄우지 않는다.

    이 패턴은 소크레이더 분석을 소개한 보안뉴스 원문에서 설명한 그대로다. 정상적인 템플릿 메커니즘을 역이용해 백도어를 심는 시도는 과거에도 반복됐다. Magento 환경의 StyleSmuggler 제로데이가 그 예다 — StyleSmuggler 제로데이 분석 기사처럼 정상 우회 경로를 악용해 백도어를 심는 공격은 웹·브라우저 영역에서 계속 진화하고 있다.

    3. PEEP 백도어가 빼가는 것 — 계정에서 PC 제어까지

    수집 가능한 정보의 범위가 넓다. 기본적으로 사용자가 로그인한 웹사이트의 세션 쿠키와 계정 정보가 대상이다. 여기서 더 나아가 감염 PC에서 임의 명령을 실행하는 기능까지 갖추고 있어, 사실상 브라우저가 원격 제어 콘솔로 변한다고 봐도 과언이 아니다.

    실무자 입장에서 눈에 띄는 건 ‘거주(persistence)’ 기능이다. 한 번 심어진 PEEP 백도어는 브라우저가 다시 시작돼도 살아남으며, 공격자에게 안정적인 진입 통로를 제공한다.

    4. 왜 초기 침투 도구가 아닌가 — 공격 단계상 위치의 의미

    PEEP 백도어는 처음 PC에 침투할 때 쓰는 1차 도구가 아니다. 피싱이나 취약점 공격으로 이미 관리자 권한을 잡은 공격자가 ‘다음 단계’로 활용하는 도구다. 즉, PEEP 백도어만 단독으로 발견됐다면 그 PC에는 이미 더 큰 문제가 있었다고 봐야 한다.

    다만 이 단계의 도구들이 정교해질수록, 기업 입장에서 평소 확장 프로그램 목록을 점검하는 일상의 중요성이 커진다. 초기 침투를 막지 못했더라도, PEEP 백도어와 같은 2차 도구를 빨리 발견하면 피해 확산을 줄일 수 있다.

    5. 쟁점 — 웹스토어 정책과 무결성 검증의 한계

    이 사건이 시사하는 구조적 문제는 두 가지다. 첫째, 공식 스토어를 우회한 확장은 사실상 검은 시장과 다크웹에서만 거래되며 일반 사용자가 사전에 알 방법이 없다. 둘째, 무결성 검증 체계 자체가 ‘정상 파일을 정상으로 보이게 만드는’ 공격을 구분하지 못한다.

    단순히 사용자 경각심만으로 해결되는 문제가 아니라는 점에서, 브라우저 벤더의 정책 재설계가 필요해 보인다. 확장 설치 시 단순 팝업을 넘어 파일 해시와 출처를 강제 검증하는 방식이 도입되지 않으면 PEEP 백도어와 유사한 공격은 계속 등장할 가능성이 높다.

    쟁점 정리

    • 공식 스토어 우회 설치는 사용자 인지 영역 밖에서 일어난다
    • 무결성 값 위조는 브라우저 보안 모델의 구조적 한계를 드러낸다
    • PEEP 백도어는 단독 도구가 아닌 ‘거주’ 단계 도구이므로 발견 시 더 큰 침투가 있었음을 전제해야 한다
    • 확장 프로그램 점검은 EDR 도입 기업에서도 형식적으로 끝나는 경우가 많다

    지금 바로 해볼 것

    • 크롬(chrome://extensions)과 엣지(edge://extensions)에 등록된 확장 목록을 지금 열어 출처가 불분명한 항목을 제거한다
    • 그룹 정책(GPO) 또는 관리 콘솔로 비공식 확장 설치를 차단하는 정책을 적용한다
    • EDR 솔루션에서 브라우저 프로세스(Chrome.exe, msedge.exe)의 자식 프로세스 실행을 모니터링하도록 룰을 점검한다
    • 관리자 권한 계정의 평소 사용을 줄이고 일상 업무는 표준 사용자 권한으로 전환한다
    • 주기적으로 브라우저 업데이트를 적용해 무결성 검증 체계 자체의 개선분을 받는다

    자주 묻는 질문

    PEEP 백도어는 일반 사용자도 감염될 수 있나요?

    단독으로는 어렵습니다. PEEP 백도어는 이미 관리자 권한을 가진 공격자가 심는 도구이므로, 별도의 1차 침투(피싱, 취약점 공격 등)가 먼저 일어났을 가능성이 높습니다.

    크롬 웹스토어에서 받은 확장도 안전한가요?

    웹스토어를 거친 확장은 비교적 검증을 받지만 100% 안전하지는 않습니다. 가능하면 출처가 명확한 제작사의 확장만 설치하고, 설치 후에도 권한을 주기적으로 확인하는 것이 좋습니다.

    어떤 증상이 나타나면 PEEP 백도어를 의심해야 하나요?

    특정 확장 프로그램이 종료해도 다시 나타나는 경우, 브라우저가 비정상적으로 느려지거나 알 수 없는 프로세스가 자식 프로세스를 생성하는 로그가 보인다면 PEEP 백도어 포함 2차 침투 단계를 의심해야 합니다.

    기업에서는 어떤 정책이 가장 효과적인가요?

    비공식 확장 설치를 차단하는 그룹 정책과 브라우저 프로세스의 이상 행위를 탐지하는 EDR 룰 조합이 가장 실효성이 높습니다. 단일 통제만으로는 우회 시도가 빠르기 때문입니다.

  • 내비게이트AI 4년 만의 등장 — 에릭 우가 선택한 건설 인력난 정면돌파

    내비게이트AI 4년 만의 등장 — 에릭 우가 선택한 건설 인력난 정면돌파

    핵심 요약

    • 에릭 우는 Opendoor를 8년간 운영한 뒤 2022년 급격한 금리 인상으로 회사를 떠났다.
    • 1년간 휴식한 뒤 AI를 자신의 인생에서 가장 결정적인 기술 플랫폼이라 판단해 다시 창업에 나섰으며, ’10년 뒤에 AI와 관련된 일을 하지 않았다면 후회했을 것’이라고 말했다.
    • 2026년 5월 스텔스 모드를 종료하고 공개한 신규 회사는 NavigateAI로, 건설 노동자와 현장 작업자를 위한 AI 코파일럿을 개발 중이다.

    분석 – 성공한 1세대 PropTech 창업자(Opendoor)가 4년 만의 복귀 무대로 전통 산업(건설)을 선택한 전략적 의미와, AI가 숙련 인력 부족이라는 구조적 문제를 해결할 수 있는지를 펀딩·시장·정책 측면에서 평가

    목차

    “34만 9천 명”이라는 숫자부터 짚어야 한다. 미국 건설업계가 올해 추가로 확보해야 한다고 본 인력 규모다. Associated Builders and Contractors가 추산한 수치다. 내비게이트AI는 이 빈자리를 향해 2026년 5월 모습을 드러낸 회사다.

    내비게이트AI가 노리는 시장 — 34만 9천 명의 빈자리

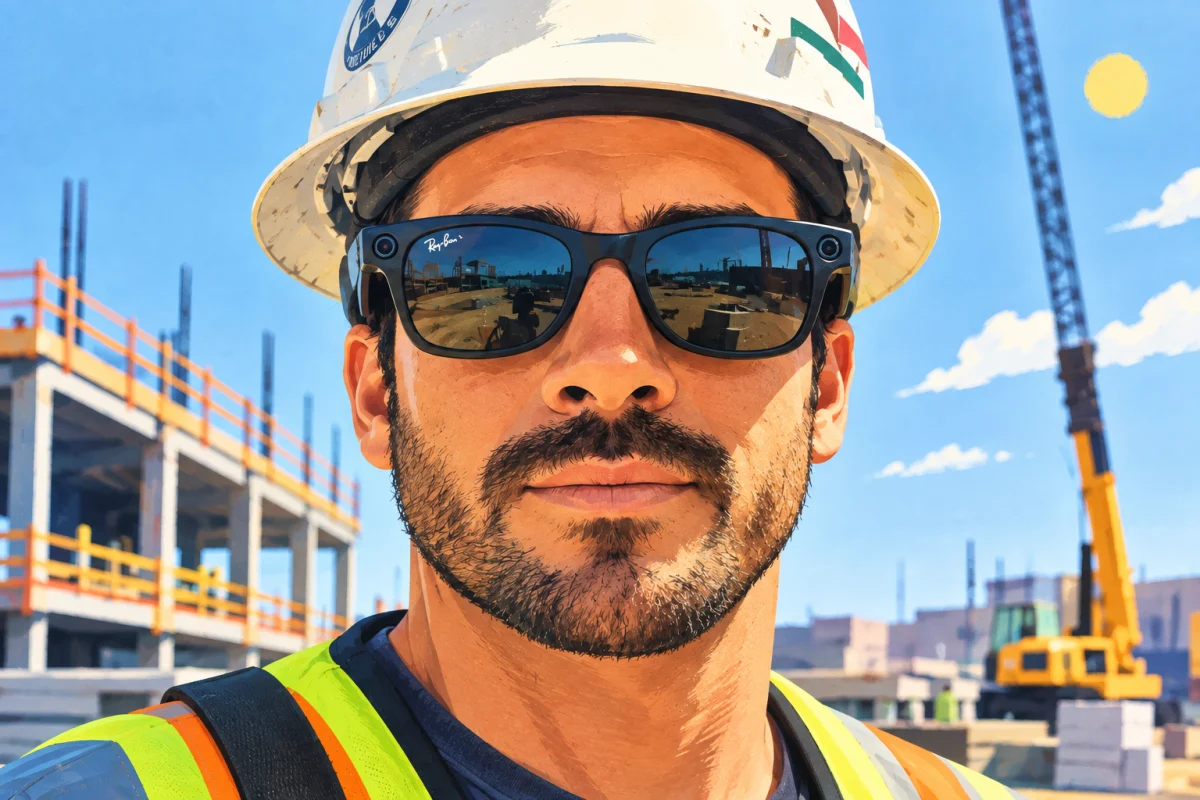
    8년간 Opendoor를 운영하다 2022년 금리 쇼크와 함께 회사를 떠난 에릭 우가 1년 휴식 끝에 다시 창업판에 섰다. “10년 뒤에 AI와 관련된 일을 하지 않았다면 후회했을 것”이라는 발언이 우를 움직인 동력이다. 그가 만든 내비게이트AI는 스마트폰과 메타 AI 글래스를 통해 건설 현장 작업자에게 단계별 가이드를 실시간·핸즈프리로 제공한다. 우 본인은 이를 “신체로 무언가를 만드는 사람을 위한 핸즈프리 전문가 코치”라 정의했다.

    인력 부족의 원인은 단순하지 않다. 숙련공 고령화와 이민 단속 강화로 외국인 노동자 공급이 줄었다. 여기에 AI 산업 확장으로 데이터센터 신축이 늘면서 단일 프로젝트당 4천~5천 명 단위 인력을 요구하는 현장도 등장했다. AI가 살 공간을 짓는 사람마저 모자라는 아이러니가 매년 깊어지고 있다.

    내비게이트AI의 솔루션 — 핸즈프리 AI 코파일럿 작동 방식

    내비게이트AI의 핵심은 “보면서 즉시 답한다”는 점이다. 작업자가 글래스나 스마트폰 카메라로 현재 작업을 비추면 AI가 다음 단계를 음성·시각으로 안내한다. 일반 AI 어시스턴트와 다른 차이는 노동 현장의 소음·먼지·진동 환경을 전제로 설계됐다는 것이다.

    필자 입장에서는 범용 AI가 놓치는 현장 제약 조건을 어떻게 모델에 넣었는지가 관건이라 본다. 동일 공종이라도 주별 건축 규정, OSHA 안전 표준, 작업자 숙련도가 달라서다. 내비게이트AI 측이 이런 변수를 흡수해 단계별 가이드를 제시하지 못하면 도구는 결국 유튜브 영상과 다를 게 없다.

    내비게이트AI 펀딩 2,500만 달러 — 레나가 베팅한 의미

    1차 펀딩은 2,500만 달러 규모로, 엘라드 길·코슬라 벤처스·레나 등으로부터 조달했다. 미국 대형 주택 건설사 레나의 참여는 내비게이트AI를 단순한 범용 AI 도구가 아니라 주택·부동산·건설 밸류체인의 작업 현장과 직접 연결된 솔루션으로 본다는 신호다.

    필자가 이 지점이 가장 의미 있다고 보는 이유는, 건설사가 자금만 댄 게 아니라 “현장”을 같이 가져오겠다는 의지이기 때문이다. 레나의 신규 단지가 사실상 내비게이트AI의 테스트베드가 될 가능성이 크고, 영업·검증·데이터 라벨링이 한꺼번에 돌아가는 구조를 만든다.

    참여 투자자 유형 시사점
    엘라드 길 개인 VC AI 스타트업 정통 라인업 시그널
    코슬라 벤처스 VC PropTech·건설 테크 포트폴리오 확장
    레나 전략적 투자자(건설사) 현장 검증·밸류체인 직접 통합 가능성

    쟁점 정리

    • 내비게이트AI는 34만 9천 명 부족이라는 명시적 수요 위에서 설계된 B2B 도구다.
    • 데이터센터 붐이 만드는 단일 프로젝트 4천~5천 명 수요가 시장 확대 변수로 작동한다.
    • 주택 건설사 레나의 펀딩 참여는 단순 자금 제공이 아닌 현장 동시 도입 시도를 시사한다.
    • 남은 과제는 AI 가이드의 정확성, 산업재해 책임 소재, 웨어러블 디바이스 현장 도입 장벽이다.

    지금 바로 해볼 것

    • 현장 관리자라면, 스마트폰 기반 AI 가이드를 1개 파일럿 공종(예: 철근 배근)에서 30일간 테스트해 정확성·수용성을 측정하라.
    • 건설사 R&D 담당자라면, 메타 AI 글래스 같은 웨어러블 디바이스의 PPE 호환·안전 인증 이슈를 사전에 점검하라.
    • 투자자라면, 단일 현장 4천~5천 명 수주가 가능한 인력 풀·마켓플레이스 회사와 NavigateAI를 같은 카테고리로 묶어 비교하라.
    • 스타트업 운영자라면, 범용 AI 어시스턴트가 아닌 “신체로 만드는 사람” 타깃 코치를 별도 카테고리로 포지셔닝하라.

    우 본인은 사람을 대체하는 게 아니라 같은 사람이 더 많은 일을 안전하게 끝낼 수 있게 돕는 게 목표라고 말했다. 그 문장이 실제 현장 KPI(산출량, 재작업률, 사고율)로 번역되는 시점이 내비게이트AI의 진짜 검증 지점이 될 것이다.

    자주 묻는 질문

    내비게이트AI는 어떤 회사인가요?

    Opendoor 창업자 에릭 우가 2026년 5월 스텔스를 종료하고 공개한 회사로, 건설 현장 작업자를 위한 AI 코파일럿을 개발합니다. 스마트폰과 메타 AI 글래스를 통해 단계별 안내를 핸즈프리로 제공합니다.

    왜 미국 건설업계가 인력이 부족한가요?

    숙련공 고령화, 이민 단속 강화로 줄어든 외국인 노동자 공급, 데이터센터 등 대형 프로젝트 증가가 맞물려 있습니다. 올해만 약 34만 9천 명의 추가 인력이 필요하다는 추산이 나왔습니다.

    내비게이트AI의 펀딩 규모와 투자자는 어떻게 되나요?

    엘라드 길, 코슬라 벤처스, 레나 등으로부터 2,500만 달러를 유치했습니다. 미국 대형 주택 건설사 레나의 참여는 건설 밸류체인과의 직접 통합을 시사합니다.

    AI 코파일럿이 숙련공 부족 문제를 해결할 수 있나요?

    비숙련 인력이 단계별 가이드를 따라 작업할 수 있게 해 생산성을 끌어올릴 여지가 큽니다. 다만 AI 가이드의 정확성, 산업재해 책임 소재, 웨어러블 디바이스 도입 장벽이라는 과제를 동시에 풀어야 합니다.

    참고: TechCrunch의 에릭 우 인터뷰 원문

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Eric Wu's newest company, out of stealth since May, is going after construction's labor crunch

  • 미니CPM5-2B, 2.5B 파라미터로 34개 벤치마크 평균 53.9 — OpenBMB가 다시 정의한 온디바이스 LLM 기준

    미니CPM5-2B, 2.5B 파라미터로 34개 벤치마크 평균 53.9 — OpenBMB가 다시 정의한 온디바이스 LLM 기준

    핵심 요약

    • MiniCPM5-2B는 2,516,756,480개 파라미터(임베딩 제외 1,981,982,720개)를 가진 dense causal language model로, 42개 레이어와 grouped-query attention(query 16 head, key/value 2 head)을 채택했다.
    • 네이티브 컨텍스트 윈도우는 131,072 토큰이며, 아키텍처가 표준 LlamaForCausalLM이라 vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS에서 커스텀 커널이나 모델 코드 포크 없이 동작한다.
    • 라이선스는 Apache 2.0이고, 같은 크기급 비교 대상으로 LFM2.5-2.6B·Qwen3.5-2B·Gemma-4-E2B-it가, 레퍼런스로 Qwen3.5-4B(51.1)·granite-4.2-3B(42.7)·LFM2.5-2.6B(33.2) 등이 제시된다.

    분석

    목차

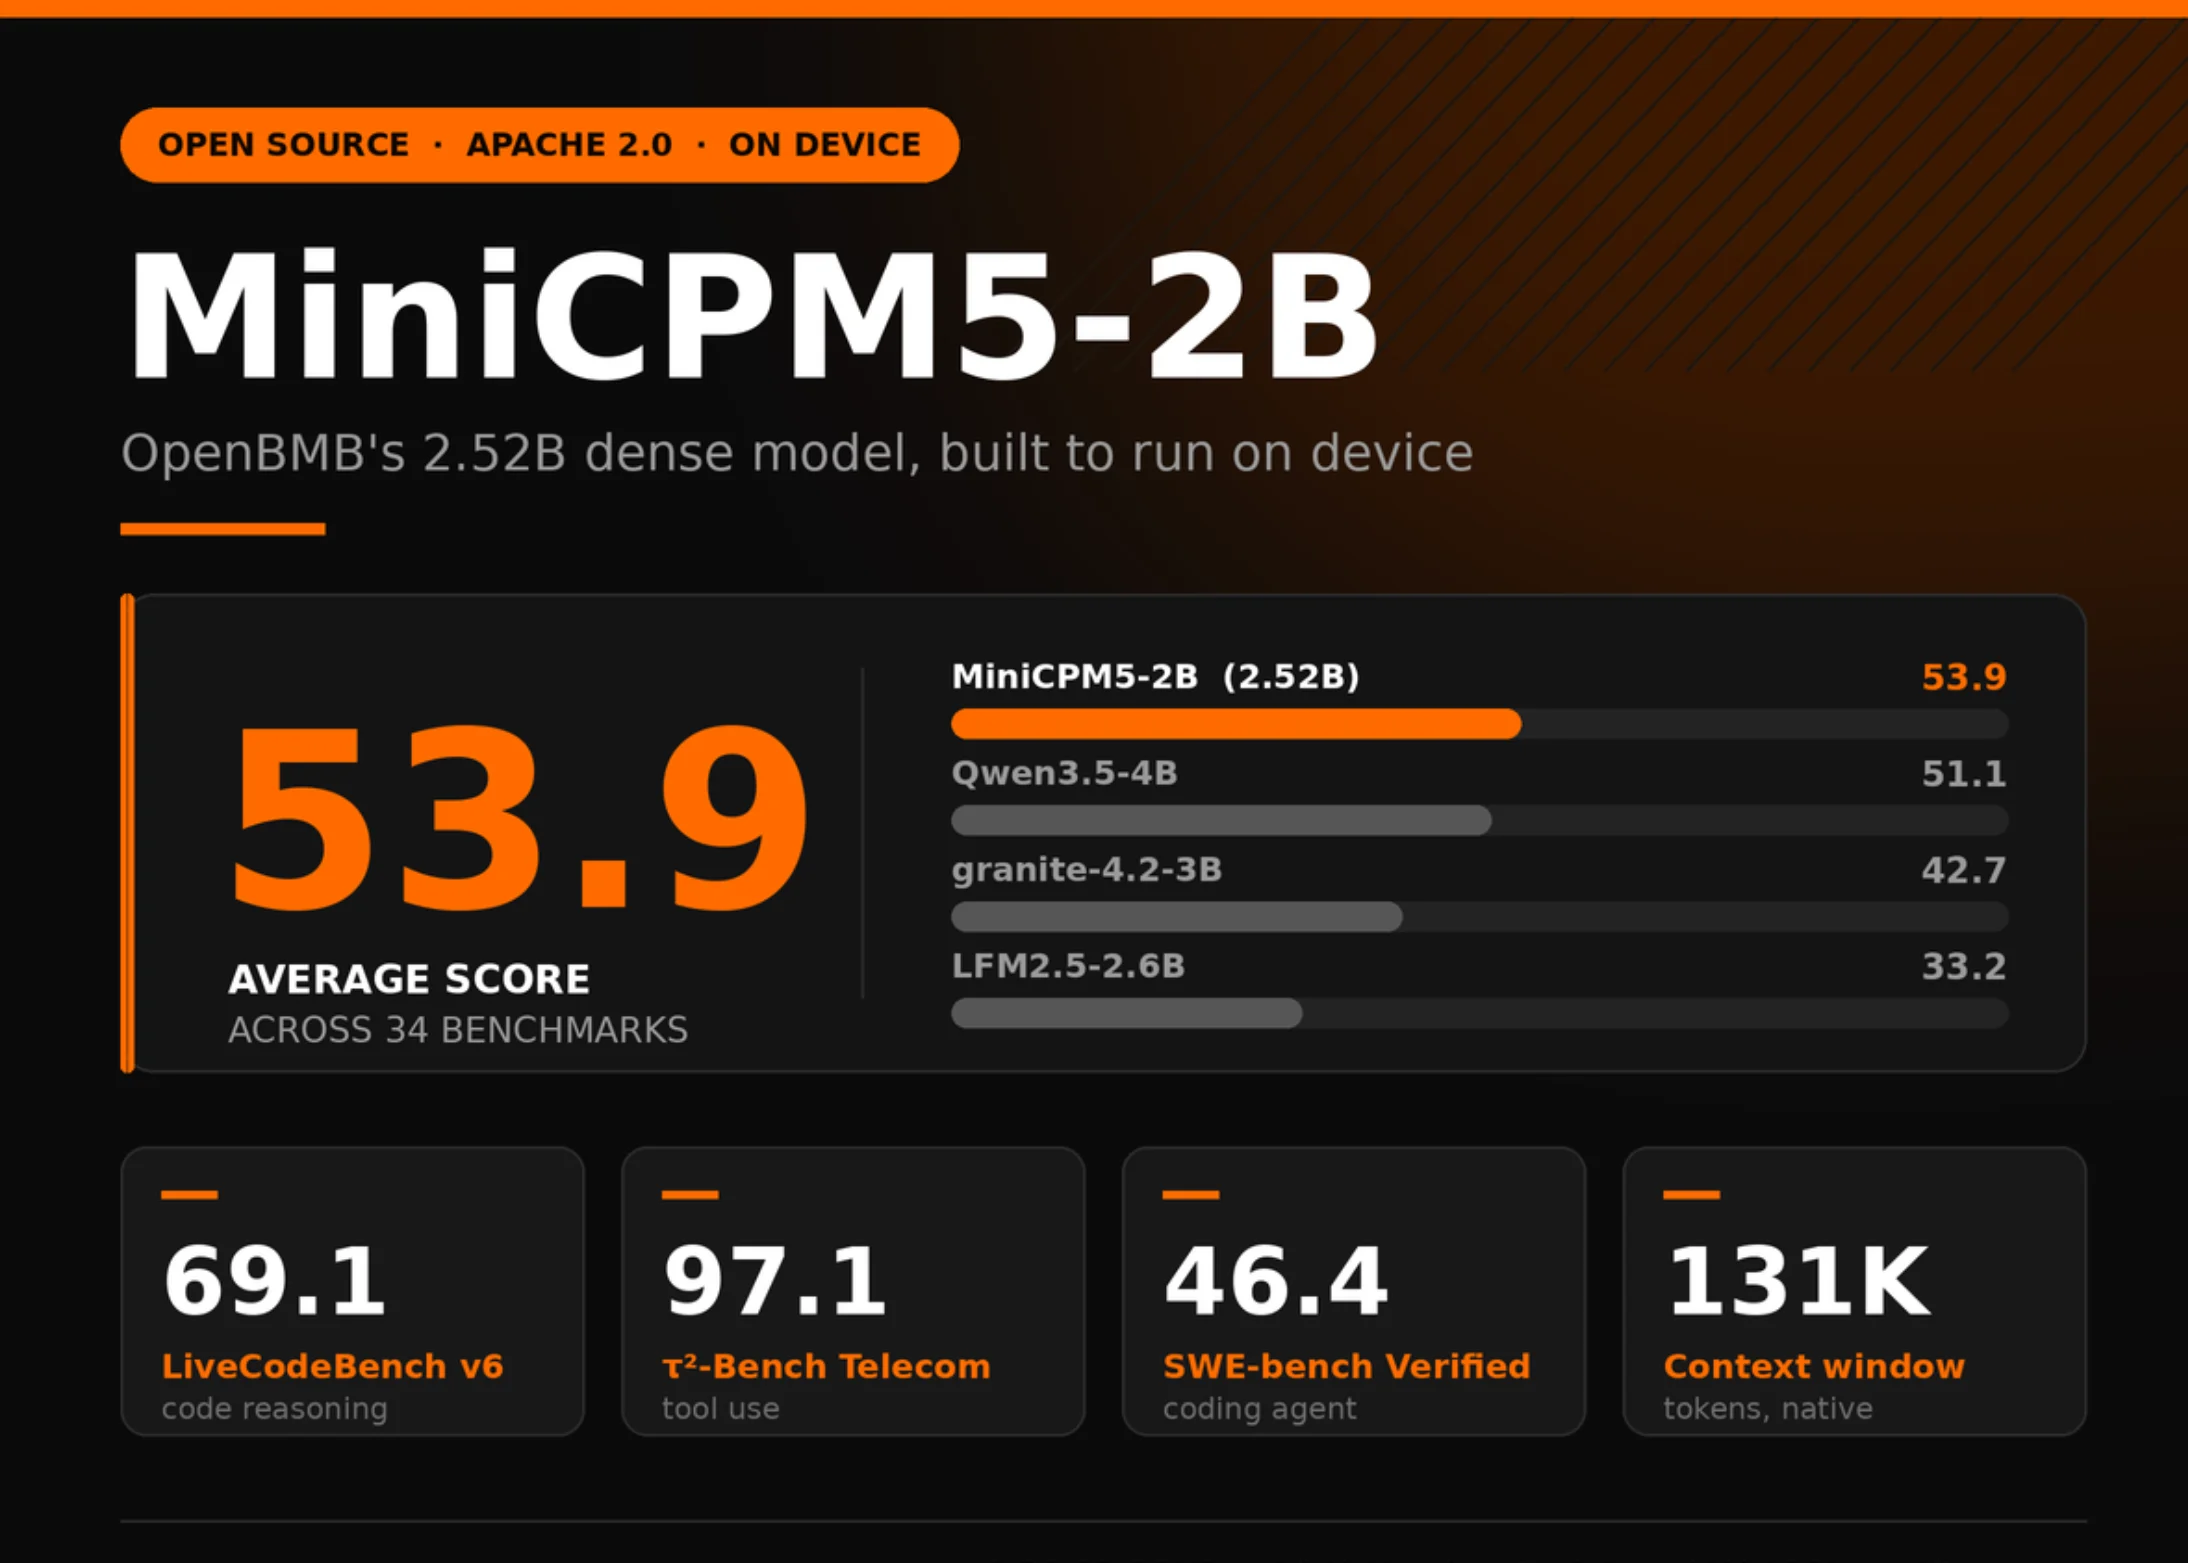
    미니CPM5-2B는 2,516,756,480개 파라미터에 네이티브 컨텍스트 윈도우 131,072 토큰이라는 스펙으로 9월 7일 모습을 드러냈다. 34개 벤치마크 평균 53.9점은 같은 라인업 베이스라인 최고 점수인 Qwen3.5-4B의 51.1을 2.8점 앞서는 수치다. 파라미터 수는 절반이 채 안 되는데 종합 점수는 더 높다. 필자 입장에서 이 모델의 진짜 의미는 “작다고 못 함”을 숫자로 입증한 데 있다.

    미니CPM5-2B 아키텍처: 표준 Llama 포크라 8개 추론 엔진 즉시 호환

    미니CPM5-2B는 42개 레이어에 grouped-query attention(query 16 head, key/value 2 head)을 채택한 dense causal language model이다. 임베딩을 제외하면 1,981,982,720개 파라미터다. 핵심은 아키텍처가 표준 LlamaForCausalLM이라는 점이다. vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX, FlagOS까지 8개 추론 엔진이 커스텀 커널이나 모델 코드 포크 없이 그대로 동작한다. Apache 2.0 라이선스까지 얹혔으니, 2~3B급 모델을 실서비스에 올리려던 팀에게는 가장 마찰이 적은 옵션 중 하나가 됐다.

    미니CPM5-2B, 34개 벤치마크 평균 53.9의 의미

    단일 점수 53.9만 봐서는 감이 안 잡힌다. 분야별로 쪼개 보면 미니CPM5-2B의 성격이 또렷해진다. 같은 크기급 비교 대상으로 LFM2.5-2.6B, Qwen3.5-2B, Gemma-4-E2B-it가, 레퍼런스로는 Qwen3.5-4B(51.1), granite-4.2-3B(42.7), LFM2.5-2.6B(33.2) 등이 제시됐다. 종합 53.9는 이 레퍼런스 풀 안에서 가장 높은 수치다.

    벤치마크 미니CPM5-2B 베이스라인 최고 격차
    34개 종합 평균 53.9 Qwen3.5-4B 51.1 +2.8
    LiveCodeBench v6 69.1 56.4 +12.7
    SWE-bench Verified 46.4 33.6 +12.8
    τ²-Bench Telecom 97.1 — —
    BFCL v4 66.6 — —
    τ³-Bench Banking 20.8 6.8 +14.0
    NoLiMa 68.1 43.5 +24.6
    AA-LCR 59.0 61.0 −2.0
    LongBench v2 43.7 47.3 −3.6
    MMLU-Pro 70.8 78.0 −7.2
    Humanity’s Last Exam 8.9 9.9 −1.0

    강점: 코드 추론과 도구 사용에서 베이스라인을 압도

    격차가 가장 큰 영역은 코드다. LiveCodeBench v6에서 69.1을 찍었고, SWE-bench Verified에서는 46.4로 베이스라인 33.6을 12.8점 차로 제쳤다. 2.5B 모델이 SWE-bench에서 46.4라는 건 단순 코드 완성이 아니라 multi-turn 디버깅까지 포함된 작업에서 절반 가까운 정답률을 내놨다는 의미다.

    도구 사용은 더 가파르다. τ²-Bench Telecom 97.1은 사실상 만점에 가깝고, BFCL v4 66.6, τ³-Bench Banking 20.8(베이스라인 6.8)도 함수 호출과 라우팅이 2.5B급에서 기대할 수 있는 수준을 한참 넘었다. 미니CPM5-2B가 에이전트 워크로드에 실제로 쓸 만한 후보라는 건 이 숫자들이 가장 직접적으로 말해준다.

    균형점: 장문 컨텍스트 항목별 편차와 일반 지식 한계

    모든 항목에서 앞서진 않는다. 장문 컨텍스트는 항목별로 결과가 갈린다. NoLiMa 68.1(베이스라인 43.5)에서는 24.6점 차로 우세하지만, AA-LCR 59.0(61.0)과 LongBench v2 43.7(47.3)에서는 오히려 밀린다. 131K 토큰 윈도우를 갖췄어도 실측 정확도에서 베이스라인을 못 따라가는 구간이 있다는 뜻이다.

    일반 지식도 비슷한 양상이다. MMLU-Pro 70.8(78.0), Humanity’s Last Exam 8.9(9.9) 모두 소폭 열세다. 파라미터가 절반에 가까운 모델이 광범위 사실 회상에서 4B급을 이길 수 없는 건 자연스러우니, 미니CPM5-2B를 “올라운더”가 아니라 “코딩·에이전트 특화 경량 모델”로 보는 편이 정확하다.

    학습 파이프라인: UltraData → 400B SFT → JustRL II → 16 expert 증류

    성적의 배경에는 단계별 학습 설계가 깔려 있다. base 학습은 UltraData 계층형 데이터 관리로 stable·decay 두 단계로 돌아갔고, mid-training 이후 400B 토큰 규모의 deep-thinking SFT가 진행됐다. RL 단계는 math·code·agentic·writing 네 영역을 따로 두고 JustRL II라는 critic 기반 teacher가 학습을 이끌었다. 마지막에 16개 전문가 모델을 단일 체크포인트로 합치는 on-policy distillation까지 붙는다.

    모델 카드는 Artificial Analysis 출처 행과 내부 재현 행을 분리 표기해 평가 일관성 이슈를 미리 명시했다. 재현 가능성을 의식한 흔적이다.

    지금 바로 해볼 것

    • Ollama 또는 llama.cpp로 미니CPM5-2B를 내려받아 Mac·RTX 3090 단일 GPU에서 추론 latency를 직접 측정한다.
    • 내 도메인 코딩 문제 30개를 골라 multi-turn 디버깅을 시켜본 뒤 Qwen3.5-2B·Gemma-4-E2B-it와 응답 품질을 비교한다.
    • BFCL 스타일 함수 호출 시나리오 10개를 만들어 tool-use 정확도를 사내 데이터 기준으로 재평가한다.
    • 131K 컨텍스트에 5만 토큰 분량의 사내 문서를 넣고 검색·요약 정확도를 NoLiMa·AA-LCR·LongBench 항목처럼 직접 점검한다.
    • Apache 2.0 적용 범위를 법무팀과 한 번 확인하고, 사내 파인튜닝 데이터에 대한 라이선스 리스크가 없는지 점검한다.

    실무 적용 포인트

    • 2~3B급을 평가할 때 종합 평균 한 점만 보지 말고 LiveCodeBench·SWE-bench·BFCL 같은 도메인 벤치마크를 가중치에 반영한다.
    • 에이전트 워크로드에 미니CPM5-2B를 쓰려면 함수 호출 라우팅을 별도 검증한다. τ²-Bench 97.1이 일반화 가능한 수치라고 단정하면 안 된다.
    • 장문 컨텍스트가 핵심이면 131K 윈도우 자체보다 AA-LCR·LongBench 같은 실측 항목 점수를 기준으로 모델을 가른다.
    • 온디바이스 배포 시 grouped-query attention의 key/value 2 head 구성 때문에 attention cache 메모리는 작지만 batch throughput은 떨어질 수 있으니 시나리오별로 측정한다.
    • 라이선스 검증이 끝났다면 vLLM·SGLang으로 1차 베이스라인을 띄우고, 부족한 영역은 JustRL II 식 RL 파인튜닝으로 보강하는 순서가 현실적이다.

    자주 묻는 질문

    미니CPM5-2B는 상업 프로젝트에 바로 쓸 수 있나요?

    Apache 2.0 라이선스라 상업적 사용과 2차 배포 모두 허용된다. 다만 모델 출력에 대한 책임은 사용자에게 있으니, 도메인 평가 후 도입 여부를 결정하는 편이 안전하다.

    2.5B 모델이 Qwen3.5-4B보다 점수가 높은데 정말 쓸 만한가요?

    34개 평균 53.9는 사실이다. 다만 우위는 코드와 도구 사용에 집중돼 있고 MMLU-Pro 같은 일반 지식에서는 7점 이상 밀린다. 평가 가중치를 도메인에 맞춰 다시 매겨야 한다.

    미니CPM5-2B는 온디바이스에서 실제로 돌아가나요?

    표준 LlamaForCausalLM 아키텍처라 llama.cpp, Ollama, LM Studio, MLX에서 그대로 실행된다. 다만 131K 컨텍스트 전체를 모바일에서 쓰기보다 8K~32K로 잘라 쓰는 게 현실적이다.

    기존 MiniCPM 모델에서 마이그레이션해야 할 이유가 있나요?

    이전 세대 대비 컨텍스트 윈도우와 코드·에이전트 점수가 동시에 끌어올려졌다. 신규 프로젝트라면 미니CPM5-2B로 시작하되, 기존 시스템은 토큰 사용량과 응답 latency를 비교한 뒤 단계적으로 옮기는 편이 낫다.

    원문 자료는 마크테크포스트의 MiniCPM5-2B 보도에서 확인했다. 비교군 정보는 같은 매체의 IFM K2 Horizon 출시 기사를 참고했다.