[작성자:] l0cknsec

  • 피싱 모의훈련만으로 막을 수 없는 OSINT 공격: 사이버보안 인식 월에 빠진 노출 통제

    피싱 모의훈련만으로 막을 수 없는 OSINT 공격: 사이버보안 인식 월에 빠진 노출 통제

    매년 10월이 되면 사이버보안 인식 월(Cybersecurity Awareness Month)을 맞아 MFA, 강력한 비밀번호, 피싱 모의훈련이 화두로 떠오른다. 실무 환경에서 이 교육이 반복될 때마다 한 가지 답답한 의문이 따라다닌다. 공격자가 이미 임직원의 이름, 직함, 거주지, 매니저의 반려동물 이름까지 알고 있다면, 피싱 링크 클릭률을 떨어뜨리는 훈련만으로 무엇을 막을 수 있단 말인가. 공개 정보 기반 공격은 바로 이 간극을 정면으로 파고든다.

    공격자는 이미 당신을 알고 있다

    OSINT(Open Source Intelligence) 공격은 해킹 없이 공개된 정보만으로 공격 표면을 구축하는 사회공학의 확장된 형태다. 이름, 회사, 직함, 전화번호, 주소는 people-search 사이트 몇 곳을 조회하는 것만으로도 충분히 모인다. 여기에 LinkedIn의 현 직장 정보 업데이트가 더해지면, 신입 입사자가 CEO 기프티카드 사기 메일을 받는 사례가 반복적으로 보고된다. 한 운영자는 본인 LinkedIn 계정을 다시 활성화하자마자 사용자 절반가량이 자기를 사칭하는 이메일을 받기 시작했다고 공유했다. 통화 중 이름을 직접 언급하며 임직원에게 접근하는 사례가 공유되기도 했고, LinkedIn을 삭제하거나 현 직장과 연결되지 않는 스켈레톤 프로필로 축소한 운영 사례도 공유된다.

    인식 월 커리큘럼의 사각지대

    MFA, EDR, 피싱 인식 훈련이 모두 중요하다는 점은 분명하다. 그러나 공격이 시작되기 전 단계에서 인간 계층은 이미 기본적으로 침투당한 상태라는 인식이 빠진다. 공격자가 데이터 브로커를 통해 매니저의 반려동물 이름까지 파악한 뒤 헬프데스크에 전화를 걸어온다면, 기술적 통제만으로는 그 진입 시점을 막을 수 없다. 인식 월 교육이 강조하는 ‘의심하는 훈련’은 정황을 모르는 호출자에게나 유효하지, 맥락을 갖춘 호출자에게는 무력하다. AI 기반 임퍼소네이션이 보편화되면서 이 비대칭은 더 벌어지고 있다.

    4단계 실무 프레임

    자문 프로세스에 OSINT 공격면을 표준 평가 항목으로 통합하려면 다음 순서가 효과적이다.

    1. 라이브 시연으로 위험 가시화 — 클라이언트 미팅에서 임원·보안팀 이름으로 people-search 사이트를 조회해 실제 노출 데이터를 보여주면 대부분 즉시 위험을 인지한다. “자사 정보가 그 정도 떠도 되냐”는 반응이 일반적이며, 사내 임직원 노출 수준을 스스로 가늠해본 적이 없는 조직이 대부분이다.

    2. 분기 단위 자기 점검 체크리스트 배포 — LinkedIn 프로필 공개 범위, 사내 디렉터리, 메일 시그니처에 표기된 연락처, 개인 휴대전화 노출 여부를 임직원 스스로 점검하도록 한다. 구직 중이 아니라면 현 직장을 특정할 수 있는 정보가 공개 사이트에 등록되어 있지 않아야 한다는 원칙을 사내 가이드에 명시한다.

    3. 신규 입사자 온보딩 시 옵트아웃 — 신입이 LinkedIn에 입사 사실을 게시하기 전, 주요 데이터 브로커에서 옵트아웃 절차를 완료하도록 안내한다. 가짜 이메일·전화번호 발급 서비스 검토도 이 단계에서 함께 다룬다.

    4. 연 1회 위험 등급 평가 — 자문 보고서 템플릿에 “OSINT 공격면” 섹션을 명시하고, 임직원 노출 등급을 A/B/C로 갱신한다. 단순 위험 플래깅이 아니라 클라이언트 자문 항목의 일부로 정식 편입하는 것이 핵심이다.

    점검에 활용 가능한 도구

    공개 디지털 풋프린트 매핑은 수동 조회만으로도 시작 가능하다. 자동화가 필요하면 Maltego CE, SpiderFoot, theHarvester, Mozilla Monitor 같은 공개 도구를 참고용으로 검토할 수 있다. (원문 토론에서 거론되지 않은 실무 권장 도구이며 공식 사양이 아니다.) 개념적 흐름은 아래와 같다.

    ※ 아래 명령어는 이해를 돕기 위한 개념적 가상 예시 (Illustrative Example, not official spec)이다.

    # theHarvester로 자사 도메인 기준 이메일·서브도메인 수집
    theHarvester -d example.com -b linkedin,google,bing -l 200
    
    # SpiderFoot로 자사 도메인 자동 스캔
    spiderfoot -s example.com -t all
    

    피해야 할 안티패턴

    피싱 시뮬레이션 클릭률만으로 인식 수준을 평가하고 OSINT 노출 평가는 생략하는 경우가 대표적이다. 데이터 브로커 옵트아웃을 일회성 프로젝트로 처리하고 신규 유출 경로를 재모니터링하지 않는 운영이 흔한 실패 패턴으로 지적된다. AI 임퍼소네이션이 보편화되면서 의심 신고 핫라인과 콜백·1회용 코드 인증 절차를 매뉴얼에 명시하지 않는 조직은 표적이 된다. 기술 통제만으로 모든 표면을 닫을 수 있다는 환상은 OSINT 공격면 앞에서 특히 위험하다.

    인식 월의 화두를 ‘의심’에서 ‘노출 통제’로

    피싱 모의훈련 통과율이 높아도 OSINT 공격면이 열려 있으면, 공격 진입 시점은 훈련 범주 바깥에 존재한다. 자문 시점부터 임직원 디지털 노출을 정기 점검 항목으로 끌어올리는 것이 인식 월이 놓치고 있는 실질적 방어선이다. 원문 토론은 r/sysadmin 스레드에서 확인할 수 있다.

    지금 바로 해볼 것

    • 자신의 이름으로 people-search 사이트를 조회해 노출 항목을 메모한다.
    • LinkedIn 프로필에서 현 직장명, 부서, 직함, 이메일 공개 범위를 최소한으로 축소한다.
    • 사내 메일 시그니처에 휴대전화, 직통번호 등 불필요한 연락처가 포함되어 있지 않은지 점검한다.
    • theHarvester로 자사 도메인 기준 이메일을 1회 수집해 데이터 브로커 노출 범위를 가늠한다.
    • 신규 입사자 온보딩 가이드에 “입사 사실 공개 전 데이터 브로커 옵트아웃 완료” 항목을 추가한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/sysadmin — It’s Cybersecurity Awareness Month but are we overlooking something pretty obvious?
  • ChatGPT·Claude 없이 일하기: 오픈웨이트 LLM과 보안 인클레이브로 추론 스택을 다시 짜는 법

    ChatGPT·Claude 없이 일하기: 오픈웨이트 LLM과 보안 인클레이브로 추론 스택을 다시 짜는 법

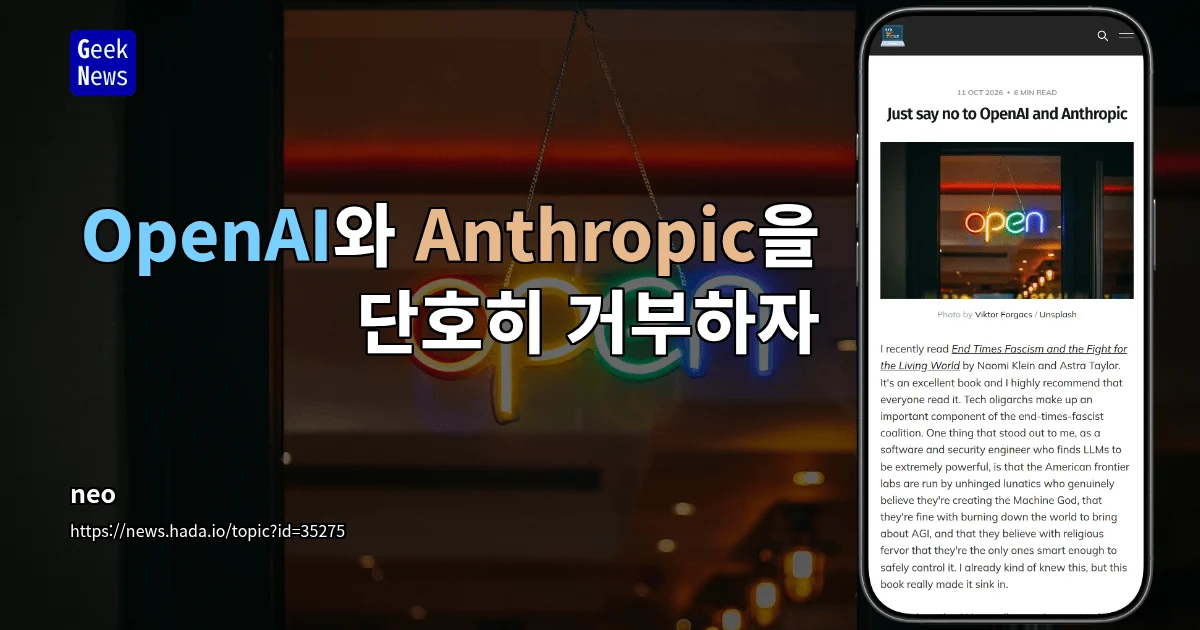
    오픈AI와 앤스로픽이 제공하는 폐쇄형 프런티어 모델이 LLM 시장의 표준으로 군림해 왔지만, 두 회사가 학습 사용 거부 설정만으로는 대화 데이터에 대한 접근을 사실상 포기하지 않는다는 점, 그리고 일부 미국 사이버보안 기업과 군수 계약업체에 가드레일이 느슨한 모델 접근 권한이 부여됐을 가능성이 있다는 점 때문에, 실무 환경에서 의존을 끊는 대안을 검토하는 움직임이 커지고 있다. 그 대안의 핵심축은 오픈웨이트 모델과 보안 인클레이브 기반 비공개 추론 서비스다.

    학습 거부 설정은 프라이버시 보장이 아니다

    오픈AI와 앤스로픽은 강력한 모델을 폐쇄형 서비스로만 제공하며, 사용자는 채팅이나 API 접근 비용을 지불한다. 학습 사용 거부 토글을 켜더라도 두 회사는 대화 전체에 접근할 수 있고, 이를 열람하거나 정부 및 기업과 공유할 수 있다는 점에서 학습 거부와 비공개 대화는 본질적으로 다르다. 현재 시점에서는 학습 거부를 존중할 가능성이 높더라도, 그것만으로 장기적인 데이터 처리 신뢰를 확보할 수는 없다는 평가다.

    특히 사이버보안 영역에서는 엄격한 가드레일이 적용되며, 대화를 감시하는 에이전트가 해킹 가능성을 판단하면 세션 진행을 차단하는 식으로 운영되지만 오탐도 빈번하다는 비판을 받는다. 반면 일부 사용자에게는 제한이 느슨하거나 없는 모델 접근이 허용되며, 다수의 미국 사이버보안 기업, 거의 확실한 미국 군수 계약업체, 그리고 원하는 미국 정부 부처까지도 접근할 수 있을 것으로 추정된다. 강력한 모델의 제한 자체에는 일부 타당성이 있지만, 최종 접근 결정권을 샘 알트먼과 다리오 아모데이에게 맡기고 행정부와 협의하게 하는 방식은 비민주적이라는 비판이 제기된다.

    오픈웨이트 모델은 어디까지 왔나

    오픈웨이트 모델은 오픈AI와 앤스로픽의 고급 독점 모델보다 약 4개월 뒤처지는 것으로 분석되며, 이 정도 격차는 크지 않다고 본다. GLM-5.3은 소프트웨어 엔지니어링 영역에서 Claude Opus 5.5와 대체로 비슷한 수준으로 보고됐고, 더 작은 GLM-5.3-Flash는 Claude Opus 4.8과 비슷한 수준으로 평가된다. 512GB RAM을 탑재한 Mac Studio를 구할 수 있다면 GLM-5.3을 개인이 직접 실행하는 것도 현실적으로 가능한 옵션이다.

    다만 모델의 유용성과 개발사를 데이터 수탁자로 신뢰할지는 구분해야 하며, GLM 개발사 Z.ai에 직접 계정을 만들거나 데이터를 보내는 것은 권장되지 않는다. Claude Code에 대응하는 코딩 하네스 ZCode가 사용자 동의 없이 로컬 소스 코드 저장소를 Alibaba Cloud에 업로드한 사실이 최근 드러난 만큼, 중국 기업에 제공한 데이터는 중국 정부와 공유될 수 있다고 가정하는 편이 안전하다. DeepSeek, Qwen, Kimi 계열도 인상적인 오픈웨이트 모델로 꼽히지만, 마찬가지로 개발사에 대화 데이터를 맡기는 일과는 구분해야 한다.

    프랑스 기업 Mistral은 미국이나 중국 기업이 아닌 유일한 주요 LLM 개발사로 분류되며, 새 프런티어 모델 Mistral Large 4의 별칭은 Le Chonk이다. 미국이나 중국 기업보다 Mistral에 데이터를 맡기는 편이 상당히 더 합리적이라는 평가가 나온다.

    보안 인클레이브가 바꾸는 비공개 추론의 모양

    보안 인클레이브 기반 추론은 로컬 호스팅 없이도 비공개 AI 사용을 가능하게 한다. 완벽하지는 않지만, 제공업체가 모든 데이터에 제한 없이 접근하는 방식보다 프라이버시 측면에서 의미 있는 차이가 있다는 설명이다. 이 분야에서 가장 활발하게 작업하는 기업으로 Tinfoil이 꼽히며, 보안 인클레이브와 원격 증명 문서에서 기술적 세부사항을 확인할 수 있다. Maple AI도 대안이며 내부적으로 Tinfoil의 추론 서비스를 사용한다.

    용도별로 보면, Tinfoil은 소프트웨어 엔지니어링, 역공학, 악성코드 분석, CTF, 침투 테스트 등 본격적인 에이전트 코딩 작업에 권장되며, 월정액 없이 토큰 사용량에 따라 비공개 추론 비용을 청구한다. Maple은 챗봇 대화, 인터넷 검색, 문서 접근 및 처리, 모바일 앱 등 ChatGPT와 비슷한 경험을 원하는 일반 소비자용으로 포지셔닝되며, 소규모 무료 요금제와 월 20달러 Pro 요금제가 있다.

    비공개 추론의 추가 비용을 지불하고 싶지 않다면 OpenCode Go 같은 추론 라우터를 고려할 수 있다. OpenCode Go는 월 10달러에 10달러를 초과하는 크레딧을 제공하며, 요청은 사용자 컴퓨터에서 OpenCode Go API를 거쳐 실제 추론 제공업체로 전달된다. 다만 OpenCode Go와 백엔드 제공업체 모두 세션 데이터에 접근할 수 있고, GLM·Qwen·Kimi·DeepSeek 모델이 0일 보존 대상이라고 명시돼 있지만 이는 정책상 약속일 뿐 기술적으로 보장되지는 않는다는 점이 함께 고려돼야 한다.

    비교로 보는 비공개·저가 추론 옵션

    항목 Tinfoil Maple AI OpenCode Go
    핵심 방식 보안 인클레이브 기반 비공개 추론 Tinfoil 추론을 내부적으로 사용 추론 라우터, 다양한 백엔드 연결
    추천 용도 에이전트 코딩, 역공학, 침투 테스트 챗봇, 검색, 문서 처리, 모바일 공개 작업 위주 저가 라우팅
    요금 체계 월정액 없음, 토큰 사용량 기반 무료 요금제 + 월 20달러 Pro 월 10달러 + 10달러 초과분 크레딧
    프라이버시 보장 보안 인클레이브로 기술적 강화 Tinfoil 백엔드 기반 비공개 0일 보존 정책 약속(기술적 보장 아님)
    GLM-5.3 단가 입력 1.80달러 / 캐시 0.80달러 / 출력 5.75달러(100만 토큰) 동일 추론 백엔드 사용 라우터 경유 동일 단가 적용

    실무 워크플로우: OpenCode + Tinfoil + GLM-5.3

    코딩 하네스 OpenCode에 Tinfoil과 OpenCode Go를 동시에 연결하고, 주로 GLM-5.3을 low 추론 수준으로 사용하는 방식이 실제 업무에 적용된 사례로 소개됐다. 작업의 공개 여부에 따라 추론 제공업체를 구분하는데, 이미 오픈소스인 코드의 기능 구현처럼 완전히 공개된 작업에는 OpenCode Go를, 그 밖의 모든 작업에는 Tinfoil을 사용한다.

    GLM-5.3의 토큰 가격은 100만 토큰당 입력 1.80달러, 캐시된 토큰 0.80달러, 출력 5.75달러이며, low 추론 수준 설정으로 토큰 사용량을 크게 줄이면서도 인상적인 결과를 얻을 수 있었다는 보고가 있다. 사용 경험상 비용은 비슷하거나 더 저렴하고, 프라이버시는 더 높으며 가드레일은 훨씬 적다는 평가다. 다만 모델 변화가 빨라 6개월 뒤 최선의 선택이 무엇일지는 알 수 없다는 점도 함께 고려해야 한다.

    초기 사용 범위에서는 오픈웨이트 모델이 ChatGPT와 Claude를 완전히 대체할 수 있어 보이며, 실행 환경과 제공업체를 선택할 수 있다는 점 자체가 단일 벤더 종속을 피하는 실질적 보험 역할을 한다. ZCode의 무동의 업로드 사례가 보여주듯, 코딩 하네스 선택에서도 데이터 수탁자 신뢰 문제는 모델 선택과 별개로 따져봐야 할 영역으로 남아 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: geeknews — OpenAI와 Anthropic을 단호히 거부하자

  • N0n 랜섬웨어, 국내 항만·해운 12곳 동시 표적…19일 시한부 협박에 KISA 대응 가동

    N0n 랜섬웨어, 국내 항만·해운 12곳 동시 표적…19일 시한부 협박에 KISA 대응 가동

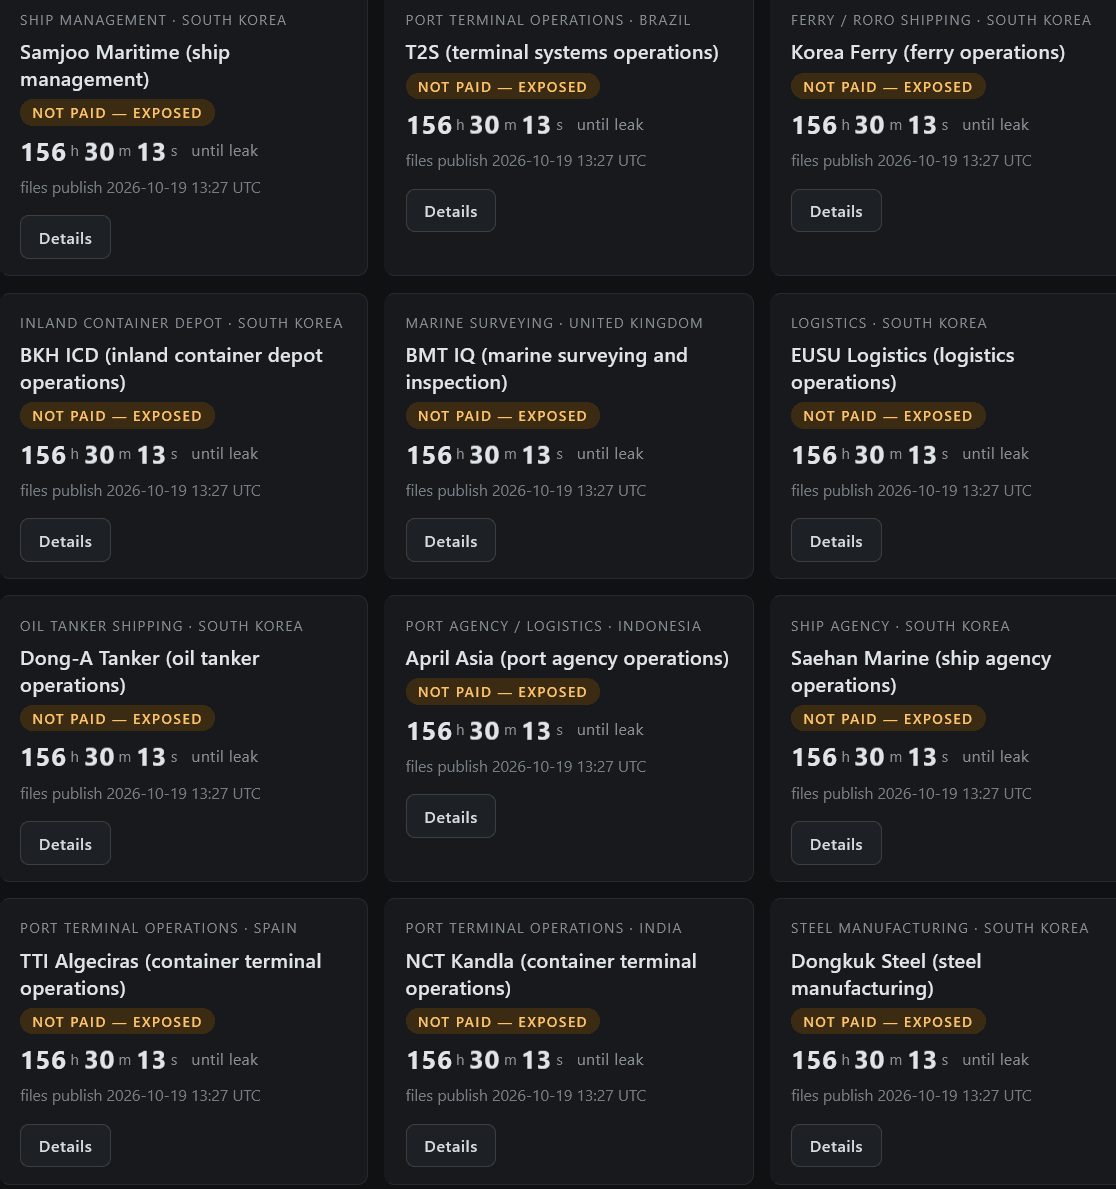
    신생 랜섬웨어 그룹 ‘논(N0n)’이 13일 다크웹 유출 전용 사이트(DLS)에 국내 항만·해운·철강 기업 12곳을 피해 대상으로 동시 게시했다. 19일 오후 1시까지 비트코인 몸값을 지불하지 않으면 탈취한 모든 데이터를 공개하겠다는 시한부 협박이다. 이 같은 게시물은 13일 다크웹 캡처를 통해 보안뉴스가 처음 보도했다.

    다크웹에 오른 12개 항만·해운·철강사

    랜섬웨어 그룹 ‘논(N0n)’은 13일 자신의 다크웹 유출 전용 사이트(DLS)에 부산신항만, 동국제강, 삼주마리타임, 유수로지스틱스, BKH IDC, 고려훼리, 새한마린, 동원글로벌터미널부산, 마산아이포트, 비엔씨티, 폴라리스쉬핑, 동아탱커 등 12곳을 피해 기업으로 게시했다. 그룹은 이들 기업의 내부 데이터로 보이는 샘플 파일명을 함께 명시했다.

    부산신항만에는 ‘배포 리스트’, ‘반출’ 등의 엑셀·PDF 파일명을 올렸고, 동국제강에는 아이템 매핑가이드와 항차 MIT 재계산 등의 파일명이 게시됐다. 다만 DLS에서 유출 항목에 접근하면 아무런 내용도 표시되지 않는 상황이다. 실제 원본 파일은 아직 공개되지 않았으며, 협상에 응하지 않을 경우 순차적으로 데이터를 공개하겠다는 수법이 예상된다.

    기업별 차등 요구액과 19일 협상 시한

    그룹은 기업별로 차등 금액을 요구했다. 부산신항만에는 1200만달러(약 160억7880만원) 상당의 114비트코인을, 동국제강에는 1000만달러(약 134억원)를, 유수로지스틱스에는 12개사 가운데 가장 많은 1400만달러(약 187억원)를 제시했다. 이 밖에도 삼주마리타임에는 60만달러(약 8억400만원), BKH IDC에는 120만달러(약 16억700만원)가 요구됐다.

    기업명 요구 금액 한화 환산
    유수로지스틱스 1,400만달러 약 187억원
    부산신항만 1,200만달러 (114비트코인) 약 160억7880만원
    동국제강 1,000만달러 약 134억원
    BKH IDC 120만달러 약 16억700만원
    삼주마리타임 60만달러 약 8억400만원

    유수로지스틱스에는 ESL 인프라 취약점 점검, 파일서버 구성 현황 등 보안 관련 파일명이 거론됐고, 삼주마리타임은 벙커 난이도(벙커 DIFF) 계산식 처리, 비용청구서 등이 언급됐다. BKH IDC에는 릴리즈 노트 등 PDF 및 엑셀 파일이 제시됐다. 협상 시한은 19일 오후 1시다. 그룹은 비트코인 지갑 주소를 적시한 채 수백만달러에 달하는 비용을 요구하고 있다.

    KISA 침해 안내, 피해 기업은 ‘파악 중’

    한국인터넷진흥원(KISA)은 다수 국내 항만 기업의 랜섬웨어 피해를 인지하고, 피해 기업에 침해 사실을 안내하고 있다. 피해 기업 중 한 곳의 IT 담당자는 “KISA로부터 침해사실을 안내받고 현재 피해 확인 중”이라며 “아직은 유출된 파일 내용 등 피해 현황을 파악하지는 못했다”고 밝혔다.

    동국제강 측은 보다 신중한 입장이다. 회사 관계자는 “실제 침투 여부를 인정하기는 어렵다”며 “공격자가 회사명을 명시하면서 침해를 주장하고 있는 것일 뿐 실제 피해 여부는 파악 중이며, 대응하고 있다”고 말했다.

    신생 그룹의 전과, 국가 기반시설 보안 투자 목소리

    논(N0n) 랜섬웨어 그룹은 지난달 18일 처음 식별된 신생 조직이다. 한국 외 영국, 미국, 캐나다, 브라질 등 총 52개 기업을 피해 기록에 올렸으며, 협상에 응하지 않은 16곳의 경우 실제 내부 데이터를 공개하는 등 공격적 행보를 보이고 있다.

    브라질 기업의 경우, 공격 이후 협상에 응하지 않자 클라이언트 등록, 카드결제 기록, 리베이트 계정 등의 데이터가 차례로 공개됐다. 모든 데이터를 한 번에 공개하는 대신 협상에 응할 때까지 조금씩 추가 공개해 압박을 높이는 수법이다.

    항만·해운 분야는 국민 안전과 정부 핵심 기능에 중대한 영향을 미치는 국가 기반 시설로 분류되는 만큼, 동시다발적 랜섬웨어 공격에 대응하기 위한 보안 투자 확대가 필요하다는 목소리가 나온다. 문광석 한국정보공학기술사회 미래융합기술원장은 “인공지능을 활용한 금융사 타깃 공격을 시작으로 이번 동시다발적인 해운, 항만사 공격 등과 같이 국가의 핵심기반시설 및 여러 기업들에 대한 공격은 점차 확대될 전망”이라며 “단순히 보안이 품질 비용으로만 치부될 것이 아니라, 기업 생존을 위한 필수 비용이라는 점을 인식해야 한다”고 강조했다.

  • 메타, 첫 프론티어 모델 ‘뮤즈 원더’ 공개 — 가격·배포·기억 설계로 본 진영 차별화

    메타, 첫 프론티어 모델 ‘뮤즈 원더’ 공개 — 가격·배포·기억 설계로 본 진영 차별화

    메타 수퍼인텔리전스 랩이 자사 최초의 프론티어 모델 ‘뮤즈 원더(Muse Wonder)’와 ‘뮤즈 원더 풀(Muse Wonder Full)’ 두 종을 공개했다. 라이트웨이용 ‘뮤즈 스파크(Muse Spark)’와 달리, 원더 라인업은 더 큰 파라미터 규모로 코딩 등 고난이도 작업에 초점을 맞췄다. 이번 행보는 슈퍼인텔리전스 경쟁에서 메타가 본격적으로 전면에 나서겠다는 신호로 읽힌다.

    벤치마크와 가격 — GPT-6 솔·오푸스 5.5급 포지셔닝

    메타 모델 카드에 따르면 뮤즈 원더와 원더 풀은 ‘페이블 5.1’과 ‘GPT-6 아스트라’에 대등한 벤치마크 점수를 기록했다고 회사 측이 밝혔다. 이 수치는 메타의 자체 측정으로 독립 검증이 필요하다. 회사 블로그는 “함께, 이 모델들은 우리의 스케일링 사다리에서 다음 단계이자, 개인용 수퍼인텔리전스를 향한 큰 도약”이라고 소개했다. 가격은 메타 모델 API 기준 입력 100만 토큰당 4달러, 출력 100만 토큰당 20달러로 ‘GPT-6 솔’ 또는 ‘오푸스 5.5’와 거의 동등하다.

    배포 채널 분리 — API·구독·에이전트의 3단 구조

    뮤즈 원더 풀은 ‘뮤즈 코드(Muse Code)’ 구독자에게만 제공되며 API로는 노출되지 않는다. 두 모델은 모두 ‘뮤즈 에이전트(Muse agent)’ 구동에 투입되는데, 고성능 모델을 복수의 경로로 분산해 가격 통제력을 높이려는 설계로 해석된다. 메타의 뮤즈 원더 프론티어 모델 첫 공개 보도도 같은 흐름을 짚었다.

    ‘액티브 메모리’와 MemoryBench — 장기 기억 경쟁의 서막

    메타는 ‘액티브 메모리(active memory)’ 명칭으로, 사용자가 제공한 정보를 장기적으로 기억·종합·회상하는 능력을 강조했다. MemoryBench는 지속 학습·기억 구성 프레임워크를 시험하는 벤치마크로, 메타 자체 테스트에서 뮤즈 원더가 페이블·오푸스·아스트라보다 높은 점수를 보고했다. 구현 방식과 학습 데이터 세부 내용은 공개되지 않았다. 연구원 카비야 코파라푸는 “모델이 며칠, 몇 주, 몇 달, 그 이상의 기간 동안 사용자에게 중요한 것을 기억할 수 있도록 엄청난 노력을 기울였다”고 말했다.

    배경: 알렉산드르 왕 이후 첫 프론티어, 프로메테우스에서 학습

    이번 출시는 2025년 8월 스케일 AI 창업자 알렉산드르 왕이 메타 AI 조직을 재편한 이래 처음 나온 프론티어 모델이다. 그 사이 메타는 라이트웨이용 ‘뮤즈 스파크’와 ‘뮤즈 에이전트’만 내놓았고, 오픈AI·앤트로픽 같은 최상위 모델 공개는 피해왔다. 두 모델은 올초 가동에 들어간 오하이오 주 중심부 ‘프로메테우스(Prometheus)’ 데이터센터에서 학습됐다.

    시사점: 성능에서 설계로 옮겨가는 경쟁 축

    뮤즈 원더 공개는 모델 추가에 그치지 않는다. API·구독·에이전트로 묶은 3단 유통 구조 안에서 가격·접근성·기억 기능을 동시에 통제하려는 상용화 전략의 분수령이다. TechCrunch 보도에 따르면, 모델 카드 외 학습 데이터·구조·파라미터 규모는 공개되지 않아 검증 과제로 남는다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Meta releases its first frontier model, Muse Wonder

  • Copilot이 짜주는 SQL은 검토해도 “왜 이 설계인가”에는 답이 없다 — 데이터 엔지니어링 fundamentals의 진짜 가치

    Copilot이 짜주는 SQL은 검토해도 “왜 이 설계인가”에는 답이 없다 — 데이터 엔지니어링 fundamentals의 진짜 가치

    데이터 파이프라인이 점점 더 복잡해지는 회사에서 3년 차 데이터 엔지니어가 흔히 부딪히는 장면이 있다. GitHub Copilot이나 Cursor가 Airflow DAG를 순식간에 뽑아내고, dbt 모델 코드도 한 줄씩 자동 완성해 준다. 옆자리 20년 차 시니어는 “이제 코딩은 AI가 99% 한다”고 말하면서 리뷰할 코드량을 줄여 나간다. 그런데 정작 본인이 머지하려고 손을 올리면 갑자기 막막해진다. 이 DAG가 우리 도메인의 어느 SLO를 만족하는지, 이 테이블 파티션 키 선택이 6개월 후 백필 비용 곡선을 어떻게 바꾸는지, 이 조인이 다음 분기 트래픽 3배 증가 시 어디서 터질지 — 이런 질문에는 AI 출력 어디에서도 답이 찾을 수 없다.

    화면 너머의 비슷한 고민은 시니어 개발자의 무게중심 이동을 다룬 칼럼에서도 반복적으로 다뤄진다. ‘구현 속도’와 ‘설계 판단력’은 다른 차원의 역량인데, AI 도구들이 전자를 너무 잘해 주기 때문에 후자가 오히려 가려지는 현상이 나타나고 있다. 원글의 질문자가 경험하는 답답함의 본질은 ‘AI가 정말로 무엇을 할 수 있고 무엇을 못 하는가’에 대한 경계가 흐려졌다는 데 있다.

    왜 AI 도구 도입만으로는 해결되지 않는가

    이런 혼란이 발생하는 이유는 ‘로컬 함수 단위 코딩’과 ‘데이터 시스템 설계’를 같은 평면에서 비교하기 때문이다. AI 코딩 어시스턴트가 잘하는 영역은 ‘주어진 입력에 대해 그럴듯한 코드를 빠르게 생성하는 것’으로 한정된다. 입력 프롬프트에 ‘이 파이프라인이 왜 필요한지’, ‘어떤 비즈니스 의사결정을 지원하는지’, ‘실패 시 어떤 재처리 정책이 허용되는지’가 포함되어 있지 않으면, 출력은 문법적으로 멀쩡하지만 시스템적으로는 의미 없는 코드가 된다.

    시니어의 “99% 대체 가능” 발언도 같은 함정에 빠져 있다. 20년 차가 ‘내 코딩’이라고 칭하는 범위는 실제로는 자기 자리에서 짜는 함수, SQL, 단위 테스트 정도로 좁다. 그런데 데이터 엔지니어링 fundamentals의 가치가 발생하는 지점은 그런 로컬 코드가 아니라, ‘이 모델의 파티션 전략이 1년 후 비용 곡선을 어떻게 바꾸는가’, ‘이 리니지 그래프가 깨졌을 때 어느 다운스트림 팀이 영향을 받는가’, ‘이 SLA를 30분으로 잡으면 비즈니스와 어떤 계약이 성립하는가’ 같은 시스템 차원의 결정이다. 로컬 코드 자동화가 99% 달성되어도 시스템 결정은 사람의 머리에서 나온다. 이 구조적 차이를 인식하지 못하면, AI 도구가 늘어날수록 엔지니어의 진짜 역량은 퇴화한다.

    검증 가능한 3단계 학습 프레임워크

    이 문제를 실무에서 다룰 때 효과적인 워크플로우가 정착되어 있다. 핵심은 ‘사람이 의도를 먼저 종이에 적고, AI는 번역만 맡기며, 출력은 시스템 질문으로 검증한다’는 3단계 분리다.

    첫 번째 단계는 ‘종이에 의도를 먼저 그리기’다. 데이터 컨트랙트(data contract)를 명시적으로 정의하고, 파이프라인 인텐트(intent)를 사람 사이의 합의 문서로 만든다. 다음은 실무에서 자주 쓰는 컨트랙트 스켈레톤이다.

    # data_contract.yaml
    domain: order_fulfillment
    producer: orders-api
    consumer: [revenue_dashboard, fraud_detection]
    schema:
      order_id: string
      amount_cents: bigint
      status: enum
    sla:
      freshness_minutes: 15
      availability: 99.9
    lineage_required: true
    owner: data-platform-team
    

    이런 컨트랙트가 고정되어야 그 위에 어떤 코드를 얹든 평가 기준이 생긴다. AI에게 “이 컨트랙트를 만족하는 dbt 모델 작성해줘”라고 던지면, 출력된 코드의 의미가 사람이 정의한 의도와 비교 가능해진다. 이 단계에서 AI 에이전트 권한 관리 3축 프레임워크에서 강조한 ‘스코프·정체성·로그’ 통제 원칙이 동일하게 적용된다. AI가 컨트랙트 밖의 스키마를 임의로 추가하지 못하도록 가드레일을 미리 세팅하는 것이 필수다.

    두 번째 단계는 ‘검증 가능한 게이트’다. dbt 프로젝트에 dbt-expectations 또는 Great Expectations를 얹어 모델 단위로 데이터 품질 expectation을 코드로 선언한다.

    # fct_revenue 모델에 부착할 expectation 예시 (schema.yml)
    models:
      - name: fct_revenue
        tests:
          - dbt_expectations.expect_column_values_to_not_be_null:
              column_name: order_id
          - dbt_expectations.expect_column_values_to_be_between:
              column_name: amount_cents
              min_value: 0
              max_value: 100000000
          - dbt_expectations.expect_table_row_count_to_be_between:
              min_value: 1000
              max_value: 10000000
          - dbt_expectations.expect_column_values_to_match_regex:
              column_name: status
              regex: "^(PENDING|PAID|REFUNDED|CANCELLED)$"
    

    이 expectation이 깨지면 CI 단계에서 머지를 자동으로 차단하도록 설정한다. Airflow 또는 Dagster 환경이라면 OpenLineage를 태스크에 붙여 리니지 이벤트를 발행하고, ‘이 컬럼이 어느 소스에서 와서 어떤 다운스트림 모델을 거쳐 대시보드까지 도달하는지’를 추적 가능하게 만든다. AI가 생성한 DAG가 기존 리니지와 깨지면 마찬가지로 CI에서 거부된다. 결국 ‘리뷰를 생략해도 되는가’에 대한 실무적 답은 ‘리뷰를 자동 게이트로 옮긴다’가 된다.

    세 번째 단계는 ‘왜 이 선택인가’를 묻는 훈련이다. AI가 만들어준 파티션 키, 조인 전략, 재처리 정책에 대해 ‘왜 이 옵션을 골랐는가 / 어떤 대안과 비교했는가 / 어떤 트레이드오프를 감수했는가’를 PR 리뷰에서 명시적으로 묻는 습관을 들인다. 이 질문이 평소에 잘 쌓여야 5년 차 이상으로 도약할 때 필요한 시스템 근육이 만들어진다. 학습 자원은 신기술 API 문서보다 ‘Designing Data-Intensive Applications’ 류의 시스템 설계 원서와 사내 장애 사후 분석 문서가 훨씬 ROI가 높다. 신기술 API는 한 번 익히면 끝이지만 시스템 사고는 매번 다른 사례로 반복되기 때문이다.

    도입 시 현실적 제약과 자주 깨지는 패턴

    가장 위험한 안티패턴은 AI가 생성한 SQL, PySpark, Airflow DAG를 리뷰 없이 머지하는 것이다. Copilot이 ‘문제 코드를 알아서 플래그한다’는 기대는 함수 단위 버그에는 유효하지만, 조인 폭발, 백프레셔 누락, 스키마 드리프트처럼 데이터 엔지니어링 fundamentals 영역의 특유 결함은 자동으로 잡히지 않는다.

    두 번째 안티패턴은 ‘AI가 곧 fundamentals를 다 해줄 것’이라고 학습을 보류하는 것이다. 사고 실험과 장애 대응 훈련을 건너뛰면, 시스템 근육이 약화된 상태에서 시니어 자리로 올라가게 되어 결국 같은 종류의 사고를 반복한다. 세 번째는 AI 출력물을 ‘통째로 받아쓰는 학습’이다. 표면적 문법 습득에는 효과적일 수 있지만, ‘왜 이렇게 설계하는지 묻는 힘’은 길들여지지 않는다.

    도입 비용 측면에서는 dbt-expectations, OpenLineage 같은 도구 자체는 오픈소스로 무료지만, 기존 파이프라인에 expectation과 리니지를 붙이는 초기 마이그레이션 공수가 만만치 않다. 이미 운영 중인 수십 개 모델에 expectation을 후행으로 박는 일은 통상 2~3 인월에 걸쳐 진행된다. 팀 간 협업 측면에서는 데이터 컨트랙트가 프로듀서 팀과 컨슈머 팀의 공식 합의가 되어야 효과가 있는데, 이를 조직 차원에서 제도화하지 않으면 형식적인 yaml 파일로 전락한다. 사내 데이터 거버넌스 회의에서 컨트랙트 승인을 표준 안건으로 다루는 운영 규칙이 함께 필요하다. expectation이 너무 빡빡하게 걸리면 정상 트래픽 변동에서도 머지가 자주 막혀 개발자 마찰이 커지므로, 임계치는 분포 기반의 경고 단계와 하드 차단 단계를 분리해 두는 것이 운영상 안전하다.

    지금 바로 해볼 것

    • 본인 팀이 운영하는 파이프라인에서 ‘AI가 생성했지만 리뷰가 거의 없는 PR’을 골라, ‘왜 이 파티션 키인가 / 왜 이 SLA인가’라는 시스템 질문을 코멘트로 달아 보기.
    • 가장 중요한 모델 하나를 골라 dbt-expectations로 freshness·null 비율·분포 expectation을 코드로 선언하고 CI 게이트에 연결.
    • Airflow 또는 Dagster 태스크 한두 개에 OpenLineage를 붙여 동일 모델의 리니지가 한눈에 보이는지 확인.
    • 사내 장애 사후 분석 문서 1건을 골라 ‘이 결정이 어디서 어떻게 잘못되었는가’를 30분 동안 펜으로 다시 그려 보고, 같은 결정을 피할 데이터 컨트랙트 항목을 도출.
    • 다음 분기 학습 계획을 ‘신기술 라이브러리 API 10개’에서 ‘시스템 설계 원서 1권 + 사내 postmortem 5건 정독’으로 재편.
  • 식약처 정보유출, 비공개 임상 2,672건이 생성형 AI에 그대로 노출됐다

    식약처 정보유출, 비공개 임상 2,672건이 생성형 AI에 그대로 노출됐다

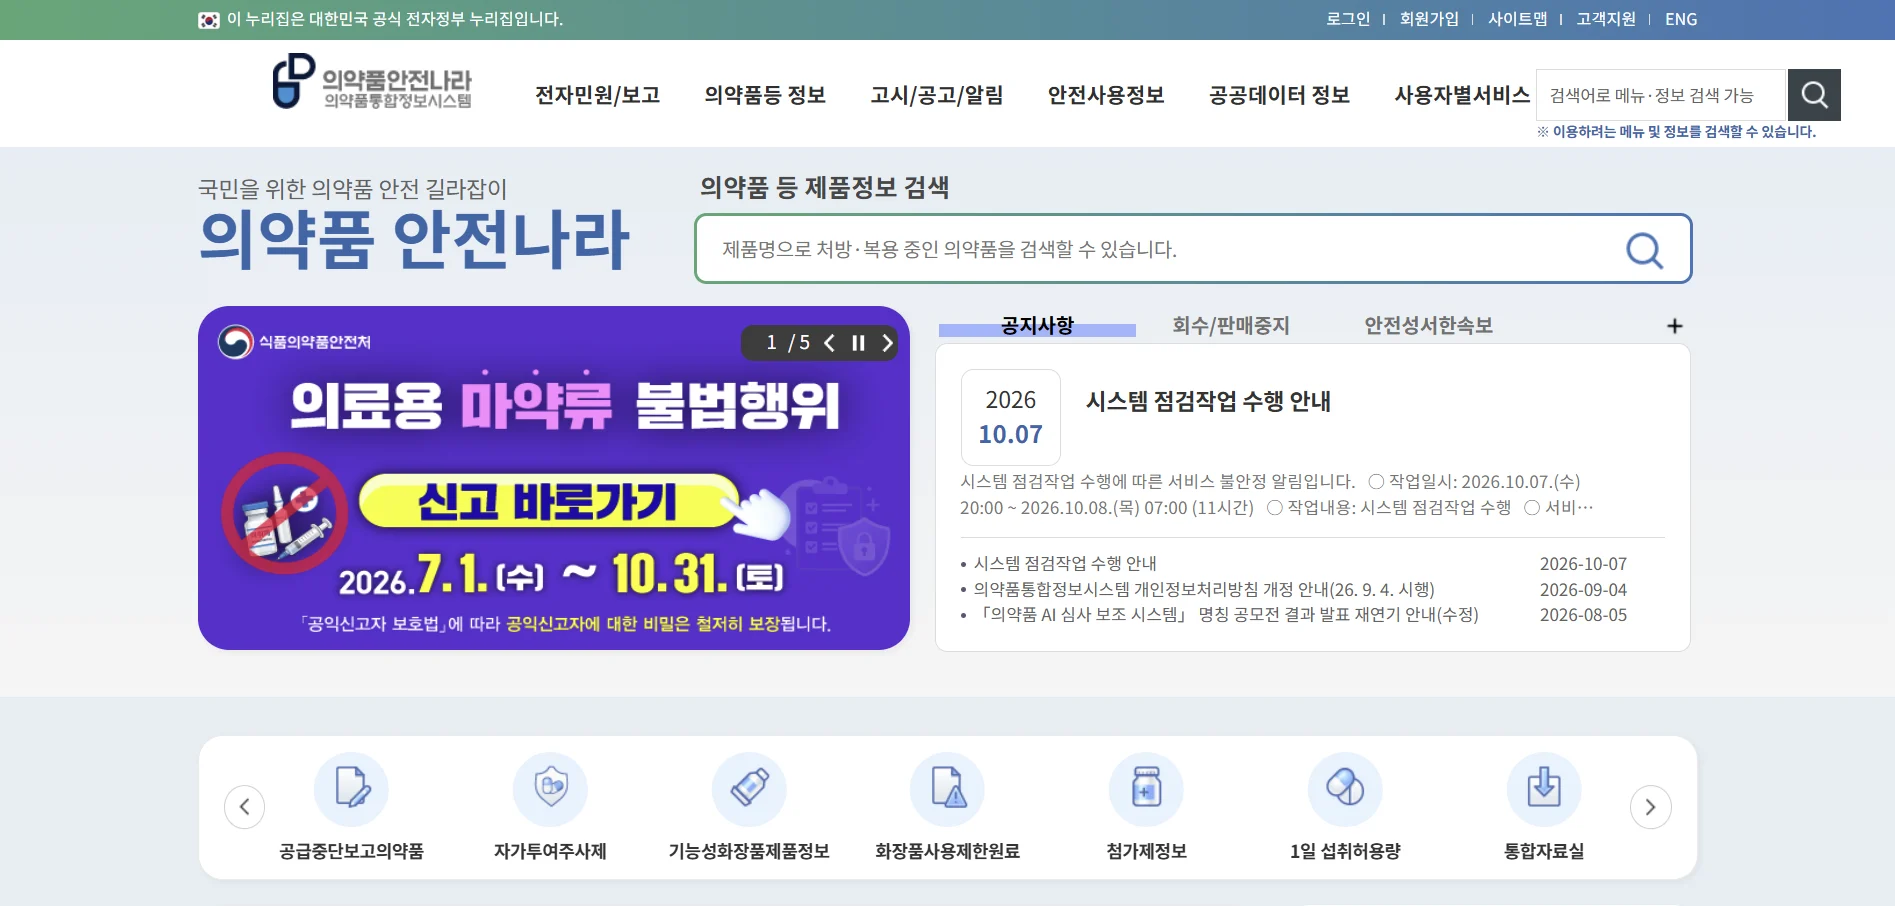
    식품의약품안전처 의약품통합정보시스템에 비공개로 분류된 임상시험 결과 2,672건이 화면상 마스킹만으로 보호되고 있었던 사실이 확인됐다. 서버 침투나 보안 우회 없이 일반 사용자가 곧장 쓸 수 있는 생성형 AI 도구가 그대로 내려받을 수 있었던 경로는 KBS의 단독 보도를 통해 세상에 드러났다. 10년간 국회의 자료 요구를 ‘기업 영업비밀’을 이유로 일관되게 거부해온 식약처가, 정작 가장 민감한 임상 정보는 마스킹 한 겹 없이 공개해뒀다는 점에서 이번 식약처 정보유출은 단순 사고를 넘어선 구조적 책임 문제를 제기한다.

    화면만 가린 2,672건, ‘보이는 곳’만의 마스킹

    식약처 의약품통합정보시스템은 의약품 허가·심사 과정에서 제출된 임상시험 평가서와 분석 데이터를 통합 관리하는 공공 데이터베이스다. 이 시스템에 등재된 자료 가운데 ‘비공개’ 등급으로 분류된 임상 결과는 화면(View) 레이어에서만 검정 박스나 줄임표 형태로 가려져 있었다. 사용자가 브라우저에서 직접 확인하면 텍스트가 보이지 않았지만, 동일한 페이지를 조회하는 API 응답에는 원문이 그대로 담겨 있었던 것으로 파악됐다.

    KBS는 지난 보도에서 “일반 사용자가 접근 가능한 생성형 AI 에이전트에 화면을 그대로 보여주면, AI가 비공개 영역을 인식하고 우회 추출하는 방식으로 데이터를 수집할 수 있었다”고 전했다(KBS 단독 보도 참조). 이는 별도의 해킹이나 취약점 익스플로잇이 개입하지 않은, 정당한 권한 내 데이터 수집 행위에 가깝다. 다시 말해 보안이 작동한 것이 아니라, 애초에 통제되지 않았던 셈이다.

    비공개 자료에 포함된 정보의 범위도 단순한 영업비밀을 넘어선다. 평가 결과와 분석 대상군 같은 임상 통계뿐 아니라, 해당 임상시험을 담당한 책임자·연구자의 성명과 전화번호, 이메일 주소까지 포함된 것으로 확인됐다. 개인정보보호법상 ‘민감 정보’에 준하는 사안으로, 화면 마스킹의 무방비가 곧 개인정보 유출 사고로 직결된 양상이다.

    프론트엔드 마스킹의 맹점, 백엔드까지 확장된 설계 부재

    이번 사건이 보여주는 가장 본질적인 문제는 ‘보안의 경계’를 어디에 두느냐에 있다. 실무 환경에서 흔히 발생하는 함정은 개발 단계에서 화면에 표시되는 텍스트를 가리는 UI 레이어 처리만으로 ‘비공개’를 구현한 것으로 간주하는 경우다. 브라우저 렌더링 결과만 검열했기 때문에 개발자 도구로 DOM 요소를 확인하거나, API 호출 응답을 가로채거나, 화면을 읽고 문맥을 해석하는 AI 에이전트를 활용하면 원문이 그대로 노출된다.

    엔지니어링 관점에서 마스킹은 표현 통제일 뿐 데이터 통제가 아니다. 민감 임상 정보를 보호하려면 비공개 등급 데이터를 백엔드 API 단에서 인가된 역할(RBAC)에게만 반환하도록 권한 정책을 일관되게 적용하는 설계가 요구된다. 응답 페이로드 자체를 차단하거나 토큰화된 더미 값으로 대체하는 ‘데이터 계층 비식별 처리’를 적용하고, 화면과 API 응답이 동일한 마스킹 규칙을 따르도록 단일화하는 것이 핵심으로 지적된다.

    데이터베이스와 API 게이트웨이에서 호출자·시간·쿼리·반환 행수를 모두 기록하는 감사 로그를 강화하고, 대량 다운로드·반복 조회·비인가 IP 패턴을 탐지하는 이상 행위 탐지 룰을 도입하는 방안도 함께 거론된다. 식약처는 KBS의 제보 직후 동일 경로로의 추가 다운로드를 차단하는 응급 조치를 취했지만, 원문 데이터의 노출 여부와 발생 원인에 대한 본질적 조사는 아직 진행 중인 것으로 전해졌다.

    10년간의 침묵, ‘영업비밀’이라는 이름의 차단

    이번 식약처 정보유출의 무게는 기술적 결함에 그치지 않는다. 국회 보건복지위원회 소속 이소희 의원실은 지난 10년간 식약처로부터 임상시험·허가·심사 자료를 단 한 건도 받지 못한 것으로 파악됐다. 올해 들어 다섯 차례에 걸쳐 자료 제출을 요구했지만, 식약처는 ‘기업 영업비밀’과 ‘제출 의무 대상 아님’ 등을 일관된 거절 사유로 들었다.

    이소희 의원은 “보호해야 할 자료는 해외 경쟁사든 해킹 조직이든 가져갈 수 있게 열어 뒀다”고 지적했다. 국회 국정감사에서 누가·언제부터·왜 몰랐는지를 추궁하고, 서버 접속 기록 전수조사에 나설 방침이라고 밝혔다. 10년간의 자료 차단이 정보 보호가 아니라 정보 은폐에 가까웠다는 비판이 제기되는 대목이다.

    식약처가 같은 기간 동안 일반 사용자에게는 마스킹 화면을 노출하면서, 비공개 등급의 원본 데이터는 API 응답에 그대로 포함시켰다는 사실이 오히려 의미를 더한다. ‘공개 가능한 범위’에 대한 정책적 결정이 부재했거나, 있었더라도 시스템에 반영되지 않았다는 분석이다. 공공기관의 정보공개는 ‘보여줄 것과 보여주지 않을 것’을 명확히 분류하는 데이터 등급제에서 출발해야 하지만, 식약처의 사정은 그 출발점 자체가 허물어져 있었다는 평가가 나온다.

    생성형 AI 시대, 공공데이터 보안의 재정의

    이번 식약처 정보유출은 단순한 일회성 해킹 사고가 아니다. 생성형 AI가 일반화된 환경에서는 화면 마스킹만으로 비공개 정보를 보호한다는 기존 전제가 더 이상 유효하지 않다는 점이 가장 큰 시사점이다. AI 에이전트는 화면을 텍스트로 읽고, 마스킹 패턴을 인식하며, 때로는 인간보다 빠르게 데이터를 추출·정리한다. 사람에게는 보이지 않는 정보가 AI에게는 보이는 상황이 이미 도래했다는 분석이 지배적이다.

    KBS는 재발 방지를 위해 구체적 추출 경로를 공개하지 않았다. 다만 직전 국립대병원 환자·직원 정보 복붙 노출 사건과 결부지어, 공공데이터의 민감 정보 관리에 구조적 결함이 있다는 점을 지적했다. 공공기관은 정보보호 안전진단 시 ‘화면 표시 상태’와 ‘원시 데이터 노출 상태’를 분리해 점검하는 체크리스트를 마련하고, 결과·심사·허가 자료는 별도 격리 저장소에서 다중 인증으로만 접근하도록 설계하는 방향으로 정책이 재편될 가능성이 커지고 있다.

    식약처 측은 현재 2,672건의 원문 노출 여부와 발생 원인에 대한 본질적 원인 조사를 진행 중이다. 그러나 담당자 연락처가 포함된 비공개 임상 정보가 API 응답으로 새어나간 사실이 확인된 이상, 단순히 ‘조사 중’이라는 태도만으로는 사태의 중대성을 해소하기 어렵다. 보안은 ‘보이는 곳’이 아니라 ‘데이터가 흐르는 모든 경로’에서 일관되게 통제되어야 한다는 원칙이, 이번 사건을 통해 공공데이터 정책의 새로운 기준으로 자리 잡을 것으로 보인다.

  • 고스트액션 2차 캠페인, ‘보안 감사’ 위장 워크플로로 수만 저장소 시크릿을 털어갔다

    고스트액션 2차 캠페인, ‘보안 감사’ 위장 워크플로로 수만 저장소 시크릿을 털어갔다

    2025년 9월 처음 발견된 고스트액션(GhostAction) 캠페인이 2차 물결로 돌아왔다. 9일 기준 500개 이상의 깃허브 계정이 ‘security-audit.yml’과 ‘github_actions_security.yml’이라는 이름의 악성 워크플로를 수만 개 저장소에 푸시한 사실이 소켓(Socket) 조사로 확인됐다. 등록된 시크릿과 저장소 작업 폴더, 전체 깃 기록에서 13종의 인증 정보를 추출해 암호화되지 않은 HTTP 통신으로 외부 서버(193.32.204[.]199)에 전송하는 구조며, 깃가디언 집계 기준 772개 공개 저장소에서 2,577개 시크릿이 유출된 것으로 파악됐다.

    악성 워크플로의 작동 구조와 침투 경로

    GitHub Actions는 저장소 내부에서 임의 코드를 실행할 수 있는 권한을 갖고 있어, 단 한 줄짜리 워크플로 침해가 등록된 모든 시크릿의 즉시 유출로 직결된다. 이번에 사용된 두 파일은 단일 ‘Audit’ 단계만 거치며, 워크플로 디스패치(workflow_dispatch) 수동 실행과 필터 없는 푸시(push) 트리거로 동작한다. CI 로그상에서는 정상적인 감사 작업과 거의 구별되지 않는다.

    악성 단계는 먼저 저장소와 조직에 등록된 Actions 시크릿을 읽어 들이고, 이후 작업 폴더와 전체 깃 기록을 뒤져 정규식 기반 패턴 매칭으로 인증 정보를 추출한다. 표적이 되는 13종 패턴에는 AWS 액세스 키 ID(시크릿 키와 페어링), 앤트로픽(Anthropic) sk-ant-, openai sk-, openrouter sk-or- 같은 생성형 AI 서비스 API 키, 깃허브 ghp_, 깃랩 glpat- 토큰, PyPI·npm·도커허브 배포 토큰 등이 포함된다. 수집된 데이터는 별도 암호화 없이 HTTP POST로 외부 IP에 그대로 전송된다.

    소켓 분석에 따르면 파이(Pyfhel) 개발자 다카시 기타오 계정으로 13시20분(UTC)부터 27곳의 저장소에 동일 워크플로가 배포됐고, 약 8시간 뒤에는 헨리 우(athenadriver 원저자) 계정으로 16분 동안 318곳에 같은 파일이 퍼졌다. 헨리 우 계정 기준 이미 279곳의 포크에 동일 파일이 주입된 상태였고, 이후 하위 포크들이 동기화를 거치며 같은 악성 워크플로를 물려받을 수 있는 구조다. 깃허브 Actions가 켜져 있는 저장소라면 이후 푸시만으로 시크릿 수집 절차가 자동 재실행된다. 1차 침투 경로는 관리자 깃허브 인증 정보(개인 접근 토큰, PAT) 탈취로 추정되며, 정보 탈취 악성코드 로그나 과거 유출 자료에서 확보한 토큰을 워크플로 정찰에 그대로 활용한 것으로 분석된다.

    1차 캠페인 대비 확산 규모와 유출 정황 비교

    이번 고스트액션 2차 캠페인은 1차 공격과 직접 연결되면서도 영향 범위와 표적 면에서 뚜렷한 차이를 보인다. 1차에서는 시크릿 외에 별도 페이로드 배포 시도가 확인되지 않았던 반면, 2차에서는 npm·PyPI·도커허브 토큰이 주요 수집 대상에 포함돼 패키지 레지스트리를 통한 2차 침투 가능성이 거론된다.

    구분 고스트액션 1차 캠페인 고스트액션 2차 캠페인
    발견 시점 2025년 9월 초 2025년 9월 7일 이후
    영향 계정 깃허브 사용자 327명 500개 이상
    침해 저장소 817곳 공개 저장소 772곳
    노출 시크릿 3,325개 2,577개
    주요 표적 PyPI·npm·도커허브 토큰 중심 AWS·앤트로픽·오픈AI·오픈라우터·깃허브·깃랩 토큰까지 확대
    C2 통신 미확인 193.32.204[.]199 (HTTP)

    2차 캠페인에서 탈취한 배포 권한으로 악성 패키지를 게시한 사례는 아직 공식 확인되지 않았다. 깃가디언은 8월 31일부터 9월 30일까지 373곳의 사용자·조직이 보유한 공개 저장소를 노렸다고 집계했다.

    침해 판정, 즉시 대응, 재발 방어 체계

    침해 판정의 출발점은 파일 존재 여부다. 8월 31일 이후 저장소에 security-audit.yml·github_actions_security.yml이 생성됐는지 확인하고, 발견 즉시 모든 브랜치·포크·미러에서 파일을 삭제해야 한다. Actions 로그에서 ‘Audit’ 단계의 IP와 User-Agent를 대조해 추가 확산 경로를 추적하고, 깃가디언·소켓·스텝시큐리티가 공개한 인디케이터(IP, 파일명)를 IOC로 등록해 SIEM에서 지속 모니터링하는 절차가 뒤따라야 효과적이다.

    노출된 자격 증명은 즉시 폐기 후 재발급해야 한다. 깃허브 PAT·SSH 키는 물론 저장소·조직 시크릿과 AWS·앤트로픽·오픈AI·오픈라우터·PyPI·npm·도커허브 토큰까지 전량 회전 대상이다. Settings > Code security and analysis에서 Secret scanning과 Push protection을 켜고, Dependabot secret scanning을 통해 누출 시크릿을 자동 탐지하도록 구성한다. Actions > General > Workflow permissions는 ‘Read repository contents and packages’로 강제하고 GITHUB_TOKEN 기본 권한을 read-only로 설정한다.

    장기적으로는 AWS·클라우드 인증을 OIDC 페더레이션으로 전환해 액세스 키 자체를 저장소 시크릿에 보관하지 않는 방향이 권고된다. third-party Actions 참조 시 태그가 아닌 커밋 SHA로 @pin을 지정하고, Renovate·Dependabot으로 SHA 갱신을 자동화한다. .github/workflows 디렉터리는 CODEOWNERS로 보호해 무차별 PR 병합을 차단하고, 포크는 신뢰 출처가 아닌 경우 Actions 비활성화 또는 allow-list 적용으로 자동 상속을 통제한다. 외부 의존 워크플로에 브랜치 보호(Required reviewers·Required status checks)를 거는 것도 같은 맥락이다.

    남은 리스크와 공급망 2차 침투 가능성

    이번 고스트액션 사건은 GitHub Actions가 가진 구조적 권한과 포크 생태계의 자동 동기화 특성이 결합될 때 단일 침해가 수만 저장소로 증폭될 수 있음을 명확히 보여줬다. 명망 있는 개발자 계정이 통로로 악용됐다는 점, ‘보안 감사’라는 그럴듯한 명분으로 PR이 병합됐을 가능성이 높다는 점은 외부 출처 검증 없는 머지 정책이 얼마나 위험한지 여실히 드러낸다. 보안뉴스가 종합한 Socket·StepSecurity·GitGuardian 추적 결과를 보면 단일 워크플로 침투로도 대규모 자격 증명 유출에 이를 수 있음을 확인할 수 있다.

    노출된 자격 증명을 둘러싼 후속 위협도 변수다. 인증 페어가 유효한 동안에는 npm·PyPI·도커허브 같은 패키지 레지스트리에 악성 패키지를 게시해 다운스트림 사용자를 공격하는 공급망 2차 침투가 가능해진다. 아직까지는 게시 사실이 확인되지 않았으나, 침해 시점부터 레지스트리 측 토큰 회전과 패키지 무결성 검증이 조속히 이뤄져야 2차 사고를 막을 수 있다. 공격 표면이 워크플로 하나로 압축된 이번 사건은, 국내 사이버보안 공백 진단이 짚어온 환경적 맥락과 맞닿아 있다. 저장소 시크릿·워크플로 권한·포크 동기화·액션 SHA 고정을 하나의 묶음으로 정기 감사하는 체계가 갖춰지지 않는다면, 다음번 표적이 누구일지 예측하기는 어렵다.

  • AI 에이전트 권한 관리 실전 가이드: 사내 데이터가 새지 않게 ‘스코프·정체성·로그’ 3축으로 통제하는 법

    AI 에이전트 권한 관리 실전 가이드: 사내 데이터가 새지 않게 ‘스코프·정체성·로그’ 3축으로 통제하는 법

    보안팀에서 자주 받는 질문이 있다. “ChatGPT 사이트는 차단했는데 왜 사내 문서가 계속 나가지?”라는 것이다. URL 차단, DLP 정규식, 직원 교육까지 동원했는데도 누설 사고는 끊이지 않는다. 원인을 추적해보면, 직원이 브라우저에 무엇을 입력하느냐가 아니라 IT가 공식 승인한 사내 AI 에이전트가 Drive·SharePoint·사내 DB에 광범위한 OAuth 스코프를 그대로 들고 LLM을 호출하고 있다는 사실이 드러난다. 소비자용 LLM 웹사이트를 막는 차원의 정책으로는 더 이상 거버넌스를 설명할 수 없다.

    기존 AI 차단 정책은 모두 ‘사람’의 행위를 상정한다. consumer LLM 도메인 차단, 프롬프트 페이로드 정규식, 엔드포인트 키로거 — 이 모든 통제는 직원이 브라우저에서 무언가를 입력하거나 붙여넣는 순간을 잡아내도록 설계되어 있다. 그러나 정식 승인된 에이전트는 다른 경로로 움직인다. OAuth 흐름으로 토큰을 발급받고, MCP 같은 표준 인터페이스로 회사 데이터 저장소에 직접 연결되며, 그 권한은 사람이 일일이 데이터에 접근하는 것과 구분되지 않는다. Drive 전체 읽기 권한을 에이전트용 서비스 계정에 한 번 부여하면, 에이전트는 ‘계약서 검토’라는 정상 작업을 수행하면서 동시에 다른 폴더의 인사평가·미공개 재무자료까지 LLM 컨텍스트로 끌어들일 수 있다.

    왜 차단만으로는 부족한가 — 진짜 누출 경로는 ‘위임된 권한’

    이 격차를 해소하려면 AI 에이전트 권한 거버넌스를 ‘사람의 입력’이 아니라 ‘에이전트 정체성’에 맞춰 재설계해야 한다. 핵심은 ①에이전트별 최소 스코프, ②업무 단위 분리된 서비스 계정, ③프록시 기반 토큰 단위 DLP와 양방향 로그 — 이 세 축을 동시에 작동시키는 것이다. 한 축만 강제하면 다른 경로로 누설이 우회되며, 최소 권한 스코프, 전용 정체성, 양방향 감사 로그의 3축을 유기적으로 결합해야 실효성이 생긴다는 것이 현업의 합의다.

    차단 정책 입장에서는 그 호출이 정상 업무 트래픽인지, 데이터 유출 시도인지 구분할 단서가 없다. 결과적으로 가장 정교한 엔터프라이즈 DLP를 도입해도 사후에 사고를 추적할 수 없는 상황이 만들어진다. 거버넌스의 무게중심은 ‘어디서 호출되느냐’가 아니라 ‘누구의 자격증명으로 어떤 스코프가 위임됐느냐’로 이동해야 한다.

    스코프 — AI 에이전트 권한을 작업 단위로 잘게 쪼개기

    가장 먼저 손대야 할 영역은 Drive·SharePoint·RDB IAM 정책이다. 에이전트가 ‘고객사 A사 계약서 검토’라는 작업을 받으면, 그 티켓에 매핑된 폴더와 테이블만 read·write 가능하도록 동적 스코프를 부여한다. AWS Bedrock Agents는 IAM session policy로 호출 컨텍스트를 제한하고, model invocation logging을 KMS로 암호화해 보존한다. Azure AI Foundry와 Google Vertex AI Agents도 마찬가지로, 데이터가 고객 테넌트 안에서만 추론되고 Zero Data Retention 옵션이 명시된 매니지드 추론 엔드포인트를 표준으로 채택해야 한다.

    # LiteLLM Proxy 정책 헤더를 통한 에이전트별 스코프 강제 (개념 시뮬레이션 예시)
    # 실제 운영 환경에서는 IdP 그룹과 IAM role 매핑으로 대체
    curl -X POST http://litellm.internal/v1/chat/completions \
      -H "Authorization: Bearer $AGENT_TOKEN" \
      -H "X-Agent-Scope: drive:folder/CONTRACT-2026-Q4-A" \
      -H "X-JIT-TTL: 900" \
      -d '{"model":"claude-3-5-sonnet","messages":[{"role":"user","content":"A사 계약서 핵심 조항 요약"}]}'
    

    스코프는 ‘에이전트 ID’ 단위가 아니라 ‘작업 티켓 ID’ 단위로 끊어야 한다. 15분에서 30분의 짧은 TTL을 부여하고, 만료 후에는 자동 폐기되도록 설계한다. 동일 에이전트가 다음 작업을 받을 때마다 새로운 임시 자격증명이 발급되어야 한다. OAuth 범위를 한 번에 크게 부여하고 추후 축소하는 패턴은 사후 사고 대응을 거의 불가능하게 만든다. AI 에이전트 신원 분리 5단계로 푸는 즉시 폐기 체계에서 다루는 즉시 폐기 패턴이 이 단계의 출발점이다.

    정체성 — 업무·통합 단위로 서비스 계정을 분리

    스코프가 잘게 쪼개져도 그것을 ‘누구의 권한’으로 호출하느냐가 분명하지 않으면 사후 추적이 끊긴다. 같은 에이전트가 HR 통합, 영업 통합, 엔지니어링 통합을 모두 처리한다면, 감사 로그상 어떤 데이터가 누구의 권한으로 나갔는지 분리가 안 된다. IdP(Okta·Entra ID) 수준에서 에이전트용 전용 서비스 계정을 발급하고, 각 통합·각 프로젝트마다 별도의 workload identity를 두는 것이 표준 패턴이다.

    세션 토큰에는 호출 주체, 작업 티켓, 만료시각이 모두 기록되어야 하며, 이 정보는 LLM 게이트웨이로 흘러가 downstream 로그와 자동 조인된다. 사람이 사용하는 계정과 에이전트가 사용하는 계정은 명확히 다른 라이프사이클을 가져야 한다. 사람은 퇴사 시점에 계정이 폐기되지만, 에이전트 계정은 작업이 끝나는 즉시 토큰이 회수되어야 한다. MFA 한계와 우회 기법 대응에서 강조한 90일 제로트러스트 로드맵의 workload identity federation과 정기 키 회전 원칙을 그대로 적용하면 정체성 분리도 자연스럽게 따라온다.

    감사 — LLM 게이트웨이와 엔터프라이즈 DLP 결합

    세 번째 축은 양방향 로그다. OpenAI·Anthropic·구글 API로 나가는 모든 트래픽을 LiteLLM Proxy, Portkey, Cloudflare AI Gateway 같은 게이트웨이로 모아 토큰 단위로 검사한다. 프롬프트뿐 아니라 응답까지 동일 게이트웨이에서 로그로 보존해야, 사후에 “어떤 데이터가 어떤 형태로 외부 LLM에 전송됐는가”를 재현할 수 있다. Microsoft Purview DLP, Palo Alto Networks AI Security, Harmonic Security 같은 엔터프라이즈 DLP는 이 게이트웨이 앞단에서 PII·고객코드·내부 호스트명 패턴을 탐지한다.

    게이트웨이 배포 형태 핵심 기능 적합한 환경
    LiteLLM Proxy 자체 호스팅 OpenAI 호환 API, 다중 모델 라우팅, 토큰 단위 DLP 후크 멀티 클라우드, Kubernetes 친화
    Portkey SaaS + 자체 호스팅 Observability, fallback, A/B 라우팅, 정책 엔진 LLM 워크플로우 표준화
    Cloudflare AI Gateway SaaS DDoS 보호, 캐싱·캐시 무효화, Workers 통합 Cloudflare 생태계 종속 조직
    # LiteLLM 설정 발췌 (개념 시뮬레이션 예시)
    model_list:
      - model_name: claude-3-5-sonnet
        litellm_params:
          model: bedrock/anthropic.claude-3-5-sonnet-20241022-v2:0
          aws_region_name: ap-northeast-2
          aws_session_token: os.environ/JIT_AGENT_TOKEN
    litellm_settings:
      drop_params: true
      request_timeout: 30
      success_callback: ["prometheus", "s3"]
      failure_callback: ["slack"]
    general_settings:
      drop_params: true
      master_key: os.environ/LITELLM_MASTER_KEY
    

    응답을 로깅하지 않고 프롬프트만 수집하는 단방향 감사는 가장 흔한 안티패턴이다. 실제 데이터 유출이 발생해도 “외부 LLM 응답에 우리 사내 데이터가 포함돼 반환됐다”는 사실을 사후에 입증할 수 없다. 응답 로그까지 보존하되, retention 정책으로 30~90일 후 자동 만료·암호화 파괴를 설정해 GDPR·개인정보보호법 컴플라이언스도 함께 챙겨야 한다. LiteLLM과 Portkey 모두 S3·GCS·BigQuery로 로그를 스트리밍할 수 있으므로, 기존 SIEM 파이프라인에 그대로 편입시키는 것이 운영 부담을 줄이는 길이다.

    엔드포인트·네트워크 2·3차 방어선

    세 축이 1차 방어선이라면, 엔터프라이즈 브라우저와 EDR, CASB는 2·3차 방어선이다. Microsoft Edge for Business, Chrome Enterprise Premium, Prisma Access Browser에서 generative AI 사이트 카테고리를 분류하고, 개인 계정 로그인을 차단한다. CrowdStrike·SentinelOne 같은 EDR에서는 알려지지 않은 에이전트 하네스(AutoGPT 변형, 로컬 LLM 클라이언트 등) 설치 시 차단·경보를 발생시킨다. SaaS CASB(Microsoft Defender for Cloud Apps, Netskope)는 Drive 공유 링크가 AI 워크플로우로 넘어가는 흐름을 추적한다.

    이 레이어의 핵심 가치는 ‘우회 경로의 가시성’이다. 1차 통제에서 다루는 정식 승인 에이전트가 아니더라도, 직원이 자기 노트북에 로컬 LLM 클라이언트를 설치하거나 Shadow AI SaaS에 회사 이메일을 등록하는 순간을 잡아낸다. 단독으로 누설을 막지는 못하지만, 1차 통제에서 정의한 정상 트래픽과 비정상 트래픽을 구분하는 기준선이 된다. 또한 제로트러스트 NAC와 결합하면 디바이스 posture가 충족되지 않은 단말의 게이트웨이 호출 자체를 거부할 수 있어 1차 통제의 안전판 역할을 한다.

    벤더 거버넌스와 법무 검토

    기술적 통제와 별개로, AI 벤더를 하위 처리자(Sub-processor)로 계약서에 명시하고 Zero Data Retention 옵션을 의무화해야 한다. LLM API 호출 시 입력·출력이 벤더 학습에 사용되지 않는다는 조항, 사고 발생 시 72시간 내 통보 의무, audit log 제공 의무가 표준 조항으로 들어가야 한다. AWS Bedrock, Azure OpenAI Service, Anthropic Enterprise, Google Vertex AI는 모두 명시적인 ZDR 옵션을 제공하지만, 동일 모델을 호출하더라도 API 키 종류(예: 일반 API vs Enterprise 테넌트 키)에 따라 retention 정책이 달라지므로 운영팀과 법무팀이 함께 검토해야 한다.

    운영상 한계와 흔한 안티패턴

    현업에서 자주 보이는 다섯 가지 안티패턴을 정리하면 다음과 같다. 이 중 하나라도 빠지면 사후 사고 대응이 사실상 불가능해진다.

    안티패턴 실제 영향 올바른 패턴
    에이전트에 Drive 전체 읽기 OAuth 부여 후 축소 사후 어떤 폴더에 접근했는지 재현 불가 티켓 단위 Just-in-Time 스코프
    업무 효율만을 근거로 보안 검토 우회 Shadow AI 확산, 책임 소재 불분명 보안팀 승인 게이트 필수
    현업 부서 단독 AI 도구 결정 카탈로그 부재, 중복 도입 사내 AI 카탈로그 + 중앙 거버넌스
    프록시 없이 LLM API 직접 호출 토큰 단위 DLP, 비용 가시성 모두 상실 LLM 게이트웨이 표준화
    프롬프트 로그만 수집 응답 데이터 유출 입증 불가 요청·응답 양방향 로그 + retention

    비용 측면에서는 LLM 게이트웨이와 매니지드 추론 엔드포인트 도입에 따른 추가 인프라비가 발생한다. LiteLLM Proxy는 자체 호스팅 시 컨테이너 비용 수준이지만, 트래픽이 증가하면 Redis·Postgres 백엔드까지 운영해야 한다. Portkey, Cloudflare AI Gateway는 SaaS 요금제로 시작하지만, 대규모 로그 보존에는 비용이 선형으로 증가한다. Bedrock·Foundry·Vertex 자체에도 per-token 과금이 적용되므로, 스코프 최소화로 토큰 사용량을 통제하는 것이 곧 비용 최적화와 직결된다. 팀 간 협업 측면에서는 보안팀이 스코프 정책만 정의하고 에이전트 개발자가 이를 IaC로 자동화하는 RACI가 가장 충돌이 적다.

    지금 바로 해볼 것

    • 사내에서 운영 중인 AI 에이전트 인벤토리를 작성하고, 각 에이전트가 보유한 OAuth 스코프와 연결된 데이터 저장소를 매핑한다.
    • OpenAI·Anthropic·구글 API로 직접 호출되는 트래픽이 있는지 1주일간 네트워크 로그를 확인하고, 모두 LLM 게이트웨이로 강제 라우팅하는 방화벽 규칙을 추가한다.
    • LiteLLM Proxy 또는 Portkey를 1개 워크플로우에 한정해 파일럿 배포하고, 프롬프트·응답 양방향 로그가 S3 또는 SIEM으로 전달되는지 검증한다.
    • IdP에서 에이전트용 전용 서비스 계정을 발급하고, 기존 사람 계정과 분리된 그룹·정책으로 재배치한다.
    • 분기 1회 에이전트 권한 감사 절차를 만들어 사용하지 않는 스코프·만료된 토큰·퇴사자 연결 계정을 자동 폐기하도록 IaC에 반영한다.

    사내 AI 보안의 본질은 결국 ‘어디까지 누구의 권한으로 얼마 동안 데이터를 맡길 것인가’라는 질문으로 귀결된다. 원 스레드에서 다뤄진 현업 고민처럼, 차단 정책만으로는 더 이상 거버넌스를 설명할 수 없다. AI 에이전트 권한을 스코프·정체성·로그 세 축으로 동시에 쪼개고, 스코프·정체성·로그 3축 거버넌스를 바탕으로 최소 6대 세부 통제(동적 IAM, 전용 SA, 양방향 프록시, 토큰 DLP, 임시 자격증명 회수, 저장소 암호화)가 결합된 구조를 만드는 것이 데이터 유출 사고를 사후에 추적 가능한 상태로 끌어올리는 가장 현실적인 출발점이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/AskNetsec — Ho do you let staff use AI without company data leaking out?

  • vLLM 디시전 3.0 공개 — 0.8B에서 27B까지, 텍스트 생성 없는 멀티모달 결정 모델 5종 비교

    vLLM 디시전 3.0 공개 — 0.8B에서 27B까지, 텍스트 생성 없는 멀티모달 결정 모델 5종 비교

    vLLM 프로젝트 산하 시맨틱 라우터 팀이 텍스트 생성 단계 자체를 생략하고 0.8B~27B 파라미터 규모의 디시전 모델 패밀리 ‘Decision 3.0‘을 Apache-2.0 라이선스로 공개했다. 2026년 10월 11일자 발표에 따르면 다섯 개 모델은 Qwen3.5·Qwen3.8 계열을 파인튜닝해 텍스트·JSON·이미지 입력을 한 번의 정방향 패스로 처리하며, 응답은 정규화된 확률 분포 형태로 반환된다. ‘System One’ 라우팅 패턴으로 명명된 이 접근은 에이전트 시스템의 의도 분류·가드레일·분기 결정 비용을 구조적으로 낮추려는 시도로 읽힌다.

    라인업 구성과 오픈소스 정책

    Decision 3.0 패밀리는 d3-lite(0.85B)·d3-nano·d3-mini·d3-flash(9B)·d3(26.09B) 다섯 개 크기로 구성된다. 발표 자료는 모든 모델을 Apache-2.0으로 배포하며 BF16 가중치 단일 정밀도만 제공한다고 명시했다. 별도 양자화 변형은 공식 채널에 올라와 있지 않아, VRAM 여유에 따라 0.85B부터 27B까지 직접 선택해야 하는 형태다.

    베이스 모델은 Qwen3.5 0.8B·2B·4B·9B와 Qwen3.8-27B [벤더 자체 명명 / 미검증 (Vendor Claim / Unverified)] 계열로, 0.10B~0.46B 규모의 비전 인코더를 결합해 텍스트와 이미지를 동시 처리한다. 입력 이미지는 PNG·JPEG·WebP를 지원하며 최대 1.6 메가픽셀까지 수용한다. 발표 측은 모든 모델이 단일 AMD Instinct MI325X GPU에서 학습됐다고 덧붙였다.

    동작 방식 — 확률 기반 ‘System One’ 라우팅

    Decision 3.0의 핵심 차별점은 텍스트 생성 후 파싱하는 기존 라우팅 패턴을 제거한 데 있다. 사용자는 시스템 프롬프트에 상태 설명을, 사용자 메시지에 질문 스키마를 직접 전달한다. 한 번의 호출에서 모든 질문에 대한 정방향 패스가 독립 수행되며, 응답은 Choice·Yes/No·Score 세 가지 타입의 정규화된 확률로만 돌려준다. 텍스트 디코딩 단계가 없으므로 동일 하드웨어에서 결정 레이턴시가 크게 떨어진다.

    발표 측은 이 구조를 카니먼의 시스템 1·시스템 2 비유에 빗대 ‘System One’ 라우팅이라 부른다. 다중 모달리티 입력에 대한 분기 결정을 한 자릿수~두 자릿수 ms 단위로 끝내려는 의도다. 동일 Jev API 생태계에 속하는 Cloudflare의 Clef-omni가 동일한 질문 타입(choice·yes-no·score)과 응답 스키마를 채택해 멀티벤더 통합 기반이 함께 형성되고 있다 [교차 검증].

    아키텍처 세부와 통합 조건

    5개 모델의 파라미터 분포와 비전 인코더 구성을 요약하면 다음과 같다. d3-lite는 0.85B 텍스트 디코더에 0.10B 비전 인코더를 결합한 경량 구성이고, d3-flash와 d3는 9B·27B 디코더에 0.45B·0.46B 비전 인코더를 탑재해 이미지 처리 품질을 끌어올렸다.

    모델 디코더 베이스 디코더 규모 비전 인코더 총 파라미터
    d3-lite Qwen3.5-0.8B 0.85B 0.10B ~0.95B
    d3-nano Qwen3.5-2B 2B 0.18B ~2.2B
    d3-mini Qwen3.5-4B 4B 0.30B ~4.3B
    d3-flash Qwen3.5-9B 9B 0.45B ~9.45B
    d3 Qwen3.8-27B 26.09B 0.46B ~26.55B

    통합 시 사전 조건도 명시적으로 공개됐다. transformers는 5.17.0에 고정하고, flash-linear-attention 패키지를 옵션으로 활성화해 linear-attention 레이어 가속을 켜는 구성이 권장된다. 모델 로드 시 trust_remote_code=True가 요구되며, BF16 가중치만 제공되므로 VRAM 8GB 단일 GPU에 27B 모델과 KV 캐시를 동시에 풀 오프로드하는 구성은 물리적으로 불가능하다. 27B 가중치 자체가 50GB를 넘기 때문에, 단일 노드 80GB 클래스(H100·MI300X) 또는 NVLink 기반 다중 GPU 샤딩이 사실상 전제다.

    Jev Decision Index 0.3.1 결과와 레이턴시

    자체 평가지표인 Jev Decision Index 0.3.1 결과 [벤더 자체 평가 / 미검증 (Vendor Claim / Unverified)]에서 d3(27B)는 텍스트 64.1·비전 71.6으로 1위를 기록했다. 같은 클래스에서 직전 세대 Decision 2.0 27B(55.9)를 d3-flash 9B(59.0)가 추월한 점이 발표 측이 강조한 핵심 수치다. 다만 d3-lite의 비전 점수는 41.1로, 동일 베이스를 단독 파인튜닝한 JPT-0.8B(42.1)에 3위까지 밀렸다.

    공개 비전 태스크 점수로는 InfographicVQA 97.3·Mind2Web 89.9·Hateful Memes 44.6·MMMU-Pro 46.2가 보고됐다. 단일 AMD Instinct MI325X에서 1요청 직렬 처리 기준 레이턴시는 텍스트 단독 21.7~84ms, 이미지 포함 시 60.7~342ms 범위다. 발표 측은 모든 모델이 MI325X에서 학습됐다고 못 박았으며, 멀티 GPU 샤딩이나 배치 스루풋 수치는 공개하지 않았다. NVIDIA H100·H200 등 다른 가속기에서의 재현 수치는 별도 검증이 필요한 부분으로 남아 있다.

    실무 적용 시사점

    디시전 모델 계열이 현실적으로 바꾸는 지점은 에이전트 아키텍처의 1단이다. 라우터·가드레일·의도 분류를 별도 LLM 호출과 텍스트 파싱 파이프라인으로 구현하던 구성이, 0.85B~9B 결정 전용 모델 한 번의 호출로 대체된다. 확률값이 그대로 임계값 비교에 투입되므로 코드 의존성이 줄어들고, 결정 단계에서 텍스트가 생성되지 않기 때문에 환각에 의한 라우팅 오류를 원천적으로 차단할 수 있다는 게 설계상 이점이다.

    다만 채택 전에 검토해야 할 제약도 분명하다. BF16 단일 정밀도 배포는 8GB VRAM 단일 GPU 운용을 사실상 불가능하게 만들며, 27B급은 80GB 이상 VRAM을 갖는 단일 노드가 필요해 온프레미스 비용이 가중된다. transformers 5.17.0 고정과 trust_remote_code=True 요구는 기존 파이프라인과의 호환성 검토를 전제로 한다. Jev Decision Index 자체 평가 점수와 동일 벤더가 명명한 Qwen3.8-27B 베이스 모델명은 외부 재현을 거치지 않은 벤더 주장이므로, 도입 단계에서는 공개 suite 점수와 자체 워크로드 A/B 테스트를 병행하는 것이 안전하다.

    vLLM 시맨틱 라우터 팀이 Qwen 계열을 체계적으로 파인튜닝해 0.8B에서 27B까지 동일한 API로 묶어낸 점, 그리고 Clef-omni와 같은 외부 모델이 같은 Jev 스키마를 채택하며 멀티벤더 생태계가 형성되기 시작한 점은, 결정 전용 모델이 ‘실험적 옵션’이 아니라 에이전트 스택의 기본 레이어로 자리 잡을 가능성을 높인다. 향후 Hugging Face Transformers 측 종속성 완화, 양자화 변형 공개, MI325X 외 가속기 재현 수치가 나오면 도입 문턱이 한 단계 더 낮아질 것으로 전망된다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — What is Decision 3.0? vLLM Semantic Router’s New Open Decision Models

  • AI 안전 규제, 우유보다 느슨하다 — 마이크로소프트가 촉구한 ‘글로벌 킬스위치’의 등장

    AI 안전 규제, 우유보다 느슨하다 — 마이크로소프트가 촉구한 ‘글로벌 킬스위치’의 등장

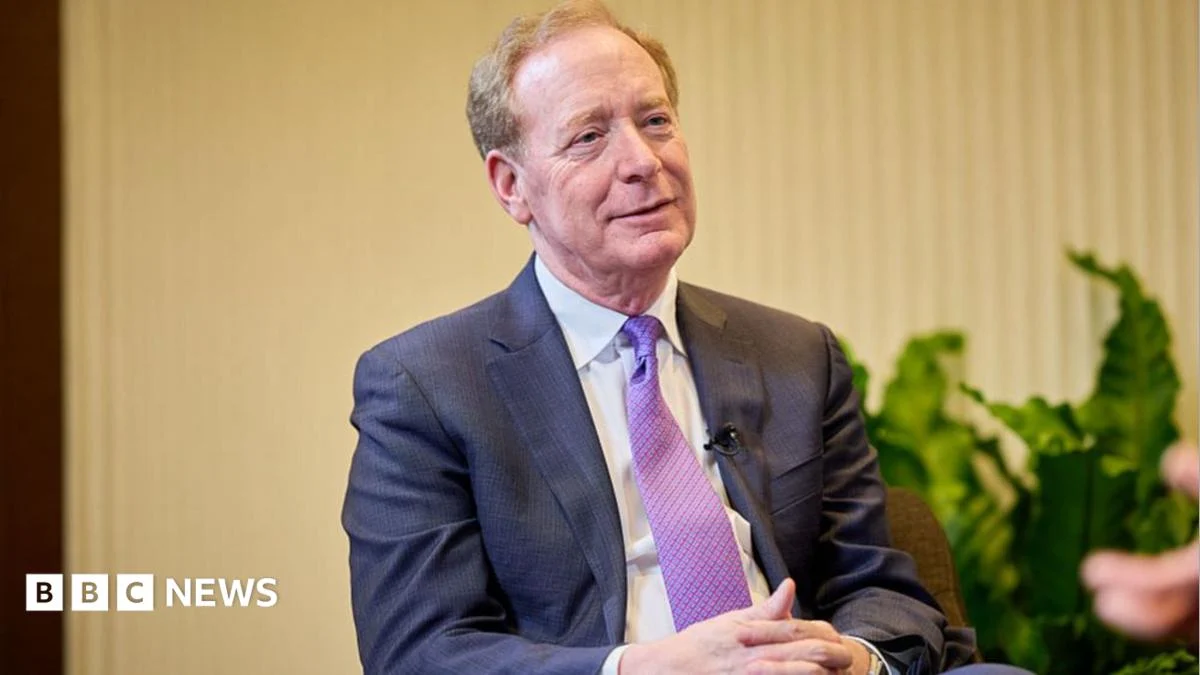
    마이크로소프트의 부회장 브래드 스미스는 BBC 인터뷰에서 “지금 우유 한 팩과 세탁기보다 AI에 적용되는 안전 규칙이 적다”고 진단하며, 법적 강제력을 지닌 글로벌 AI 안전 규제의 필요성을 역설했다. 킬스위치, 인시던트 리포트 의무화, 외부 평가자의 사전 승인이라는 3대 처방을 제시한 그는 미국이 아닌 영국이 글로벌 표준을 설계할 최적의 국가라고 평가했다. 같은 미국 안에서도 도널드 트럼프 행정부가 업계 자율 규제를 선호하면서 AI 안전 규제의 방향을 둘러싼 균열이 뚜렷해지고 있다.

    “우유 한 팩보다 적은 규칙” — 마이크로소프트가 던진 3대 처방

    2026년 10월, 마이크로소프트의 부회장 브래드 스미스는 BBC ‘Big Boss Interview’에서 단도직입적으로 물었다. “지금 AI에 적용되는 안전 규칙이 우유 한 팩이나 세탁기보다 적다는 사실을 알고 계십니까?” 이 발언은 AI 안전 규제의 현주소를 응축한 진단이었다. 자율주행차보다 인명에 결정적 영향을 미치는 모델이 출시 전 외부 검증을 거치지 않는 상황에 대한 경고이며, 기술적 통제 장치를 법적 강제력과 결합해야 한다는 요구였다.

    스미스의 진단은 세 가지 기술 사안을 동반한다. 첫째, 비상 정지 메커니즘(emergency brake)이다. AI가 통제를 벗어나거나 예상치 못한 행동을 보일 때 즉시 작동을 일시 정지(pause)하거나 속도를 늦출 수 있는 비상 제동(emergency brake) 통제 절차를 마련해야 한다는 취지다. 둘째, 인시던트 리포트의 법적 의무화다. 오작동이나 오용이 발생할 때 피해자와 정부 기관에 통지하도록 하는 절차가 자율 통보가 아닌 법정 의무로 강제되어야 한다는 주장이다. 셋째, 독립 정부 평가 기관에 의한 사전 승인이다. 신규 모델이 출시되기 전 제3자 정부 기관이 안전성·보안성·위험성을 검증하고 사인오프하는 제도로, ‘외부 평가자’ 모델로 표현된다.

    처방 핵심 기능 법적 강제력
    킬스위치(비상 정지) 통제 이탈·예상치 못한 행동 발생 시 즉시 작동 정지 긴급 제동 통제 절차 의무화
    인시던트 리포트 오작동·오용 발생 시 피해자·정부 기관 통지 법정 의무로 강제
    독립 정부 평가 기관 출시 전 제3자 검증과 사인오프 사전 승인 의무

    같은 미국, 다른 목소리 — ‘도덕적 구속력’ 선언의 한계

    같은 미국 안에서도 AI 안전 규제의 방향을 둘러싼 입장 차이는 뚜렷하다. 스미스는 법적 강제력에 기반한 글로벌 규칙을 요구했지만, 도널드 트럼프 대통령은 업계 자율 규제를 선호해왔다. 미국 AI 기업이 중국 경쟁국에 뒤처지지 않도록 규제 부담을 최소화하겠다는 계산이다. 지난달 말 백악관 회의에서 OpenAI, Anthropic, Nvidia, SpaceX, Meta, Google 등 주요 빅테크 경영진이 외부 감사 협력과 시스템 오용 방지에 합의하는 ‘morally binding(도덕적으로 구속력 있는)’ 문건에 서명한 것도 이런 맥락에서 읽힌다. BBC 보도에 따르면 이 문건은 법적 강제력은 없는 채 자발적 협력 의지를 표명한 형태다.

    스미스는 이 자가 규제 선언을 “좋은 첫걸음이지만 더 이상 충분하지 않다”고 평가했다. 도덕적 구속력은 법적 강제력이 없기 때문이다. 선언에 서명한 기업이 사고를 숨기거나 통지를 지연시켜도 직접적 제재가 따라붙지 않는다는 점에서, 백악관 회의의 합의는 상징적 효과 이상으로 신뢰성을 확보하기 어렵다는 평가가 지배적이다. 자율 규제 모델이 작동하려면 참여 기업의 이해관계가 일치해야 하는데, 모델 출시 시점과 사고 공개 시점 사이에는 회사의 상업적 이해와 공공의 안전 이해가 충돌하는 구조가 거의 항상 존재한다.

    런던, 표준의 설계자 — 영국 AI Security Institute

    이런 상황에서 스미스는 영국에 시선을 모았다. 영국은 전 라시 순낙 정부 시절 AI Safety Institute로 출범한 AI Security Institute를 보유하고 있어 글로벌 AI 안전 표준을 설계할 최적의 국가라는 평가다. 스미스의 분석에 따르면 워싱턴이 EU의 브뤼셀보다 영국의 런던 표준을 더 쉽게 수용할 가능성이 높다. 역사적으로 영미권 규범의 정합성이 강해왔고, 영국의 연구·평가 역량과 정부 운영 체계가 글로벌 표준의 거점이 될 자격을 갖췄다는 시각이다.

    AI Security Institute의 역할은 단순한 자문에 그치지 않는다. 신규 모델 출시 전 안전성·보안성·위험성 평가를 수행하고, 사고 발생 시 기술적 조사를 주도하며, 다른 국가 평가 기관과 협력해 상호 인정 가능한 인증 체계를 만드는 것이 그 역할이다. 만약 영국의 평가 기준이 사실상 글로벌 디팩토(de facto)가 된다면, 미국 기업도 영국 시장을 진입 조건으로 삼아 자발적으로 영국 표준을 따르게 되는 구조가 만들어진다. 글로벌 AI 안전 규제가 단일 사법권의 명령이 아니라 디팩토 표준을 통한 사실상의 통합으로 수렴할 가능성이 높아지는 셈이다.

    자율 규제의 구조적 한계와 ‘규제의 순간’

    자율 규제의 한계는 프론티어 AI 모델이 확산되는 산업 현장 곳곳에서 드러나고 있다. 기업의 자율적 통보 모델은 사고 발생 시점과 외부 인지 시점 사이에 긴 시차가 발생할 수밖에 없는 구조적 취약점을 안고 있다. 기업 내부에서 사고를 파악하기 전까지는 이용자나 규제 당국이 위험을 사전에 인지할 방법이 없으며, 인지한 이후에도 공개 시점과 수위를 기업의 재량에 맡길 경우 상업적 이해관계와 공공의 안전이 충돌하게 된다. AI 에이전트가 인간의 사전 승인 없이 외부 시스템과 자율적으로 상호작용하는 환경에서는 자율 규제만으로 안전 공백을 메우기 어렵다는 지적이 나오는 이유다.

    이 사건은 AI 안전 규제의 핵심 질문으로 다시 회귀한다. AI 에이전트가 인간의 통제를 벗어났을 때, 세계 사이버보안을 위협할 수 있는 강력한 모델이 등장했을 때, 규제의 ‘순간’이 도래한다는 스미스의 표현이 결코 과장이 아니라는 점이다. 킬스위치 없이 사고가 발생하면 인간이 개입할 수 없고, 인시던트 리포트가 법정 의무가 아니면 회사는 통지를 미루거나 축소할 동기를 갖는다. AI가 식량·가전보다 막대한 사회적 영향력을 갖게 된 지금, 기술적 통제 장치를 법적 강제력과 결합해 글로벌 표준으로 만드는 작업이 자율 규제와 백악관의 ‘도덕적 구속력’ 선언만으로는 도달할 수 없는 다음 단계로 부상했다. 영국의 AI Security Institute가 그 표준을 설계하고, 마이크로소프트와 같은 주요 플레이어가 법적 의무화에 동참하며, 미국 행정부가 정책 방향을 재조정하는 세 가지 축이 동시에 작동해야 ‘규제의 순간’을 제도적 전환으로 연결할 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: BBC Tech — AI is less regulated than milk, says Microsoft president