[작성자:] l0cknsec

  • “소프트웨어는 끝났다”는 한마디 뒤에 — 7개 어도비 앱 AI 클론이 남긴 쟁점 3가지

    “소프트웨어는 끝났다”는 한마디 뒤에 — 7개 어도비 앱 AI 클론이 남긴 쟁점 3가지

    핵심 요약

    • 배경과 행위자: 소프트웨어 개발자 Brandon Thomas는 약 10년 경력의 Rust 대규모 프로젝트 경험을 바탕으로, Anthropic의 Claude Opus 5.5만을 사용해 7종의 어도비 크리에이티브클라우드 앱 클론을 작성했다고 주장함
    • 출시 구성: Photoshop, Illustrator, Premiere, Lightroom, After Effects, InDesign, Acrobat Pro에 대응하는 7개 앱을 MIT/Apache 라이선스로 공개했으며, WebAssembly 기반 브라우저 버전도 함께 제공함
    • 기술 방식: 어도비의 소스 코드를 직접 복사하지 않고 기능과 UI를 재현하는 클린룸 리버스엔지니어링 방식을 채택했으며, Reddit과 HackerNews 반응에서는 현 상태가 ‘super early alpha’ 수준에 머물러 있음이 반복적으로 지적됨

    AI 코딩 모델의 비약적 성능 향상으로 클린룸 리버스엔지니어링의 경제성이 극적으로 개선되면서, 단일 개발자 팀이 수개월 안에 주요 상용 소프트웨어의 기능 등가물을 공개하는 새로운 경쟁 구도가 현실화되고 있으며, 이는 기능 복제 가능성과 trade dress 같은 외형적 권리 보호 사이의 법적 회색지대를 다시 한번 부각시킴

    목차

    어도비 크리에이티브클라우드를 통째로 대체하겠다는 선언이 Reddit과 HackerNews에 동시에 올라왔다. 약 10년 경력의 Rust 개발자 Brandon Thomas는 자사 프로젝트 Artcraft에서 Photoshop, Illustrator, Premiere, Lightroom, After Effects, InDesign, Acrobat Pro에 대응하는 7개 앱을 MIT·Apache 이중 라이선스로 공개했다. 본인 스스로 내건 문구는 단호하다. “Software is over.”

    7종은 단순한 외형 모방이 아니다. Rust로 작성되어 WebAssembly로 컴파일된 풀스택 애플리케이션이며, 브라우저에서 바로 실행되는 버전도 함께 제공된다. 자사 시각 AI 모델을 1급 옵션으로 임베드했다는 점이 핵심 차별점이다. AI 클론이 생성형 워크플로우까지 흡수하면서, “무료 대체재”를 넘어 “AI 네이티브 편집기”로 영역을 확장하려는 시도로 읽힌다.

    Claude Opus 5.5 하나로 7개를 동시에?

    Thomas는 2026년 2월부터 AI 도구로만 코딩해왔다고 밝히며, 이번 7개 앱도 Anthropic의 Claude Opus 5.5를 단독 코딩 어시스턴트로 사용했다고 했다. 필자도 현업에서 Claude 계열 모델을 페어 프로그래밍에 활용하고 있지만, “단독 코더”라는 표현에는 회의적이다. 디자인 명세 작성, 자산 파이프라인 구성, 테스트 시나리오 설계 단계에서는 결국 사람의 판단이 결정적이기 때문이다.

    실제로 Thomas는 직접 한 발 물러서며 일정을 수정했다. Reddit에서 “1개월 내 100% 패리티”라고 했다가, HackerNews에서는 “99% 패리티가 수개월 단위” 발언으로 조정한 것이다. 동일인이 이틀 만에 목표치를 낮춘 셈이다. Claude Opus 5.5가 코드를 짜주더라도, 포토샵의 RAW 디모자이크 처리나 프리미어의 타임라인 렌더링 엔진을 처음부터 설계하는 일은 1개월 안에 끝나지 않는다. 코딩 모델이 골격을 잡고 사람이 미세 조정과 회귀 테스트를 반복하는 “주니어-시니어 페어” 형태가 현실적 모델이다.

    “클린룸”이라는 단어가 안 먹히는 지점

    Thomas는 어도비의 소스나 바이너리를 직접 복사하지 않았다고 강조한다. 기능과 UI를 사양 측면에서 재구성하는 전통적 클린룸 리버스엔지니어링이다. 아이디어와 기능 자체는 저작권법상 보호 대상이 아니므로 이 방식은 합법으로 본다. 다만 실무에서 가장 흔히 놓치는 함정은 따로 있다. 도구 팔레트, 패널 배치, 단축키 구조까지 픽셀 단위로 재현하면 trade dress 침해 소송의 문턱에 걸린다.

    trade dress는 미국 Lanham Act뿐 아니라 한국 부정경쟁방지법에서도 보호하는 “상표적 외관” 개념이다. Apple의 iPhone 디자인이나 luxury 브랜드 패키지 룩이 대표적이다. 어도비 워크스페이스의 다크 테마, 좌측 도구 모음, 우측 레이어 패널 구성이 그대로라면, 기능이 달라져도 외형 유사성만으로 소송장이 열릴 수 있다. Artcraft 팀은 UI를 의도적으로 어도비와 다른 디자인 시스템으로 재구성하는 작업이 필수다. “안 비슷하게”가 아니라 “상당히 다르게” 만들어야 한다.

    토큰 과금이 받쳐주는 무료 앱

    7개 앱 자체는 무료다. 자금을 만드는 곳은 Artcraft 시각 AI 모델과 IDE 사용료를 토큰 단위로 과금하는 부분이다. 사용자는 무료 앱에서 작업하되, AI 생성·업스케일·인페인팅 호출에만 비용을 내는 구조다. 오픈소스 자체가 흑자를 내는 것이 아니라, “오픈소스 + AI 호출 종량제”의 조합으로 수익을 만든다. Thomas는 별도의 “필름메이커용 인기 소프트웨어 팀”이 수익을 만들고 있다고 덧붙였다.

    다만 토큰 과금 모델이 B2B 크리에이티브 워크플로우에서 채택되려면, 어도비 구독료와 단순 비교가 아니라 “AI 호출당 비용 vs 월 정액”의 가치 제안이 명확해야 한다. 무료 도구 + 유료 AI라는 이중 구조는 Figma나 Notion이 시도한 모델이지만, 그 둘은 조직 단위 락인을 만들어 수익화했다. 단일 개발자 프로젝트가 같은 락인을 만들 수 있을지는 별개의 문제다. 멀티레포 모노레포로 빌드 파이프라인을 분리하고, GitHub Actions에서 변경된 패키지만 골라내는 변경 감지 매트릭스를 구성하는 식의 운영이 뒷받침되어야 토큰 과금 단가와 일일 호출 한도를 안정적으로 운영할 수 있다.

    AI 도구의 영역 확장은 오픈AI 수학 자문그룹 출범 사례처럼 산업 전반으로 확산되는 흐름 속에 있다. 클린룸 재현의 경제성이 개선된 지금, 다음 타깃은 CAD, 오피스, ERP 영역으로 옮겨갈 가능성이 높다.

    아직 “끝”이 아닌 이유

    Thomas는 “Photoshop 전체를 원샷으로 완성했다”고 주장하지만, 커뮤니티 반응은 “super early alpha” 진단이 반복적이다. 원샷 생성은 시연용이고, 실사용 가능한 빌드는 꾸준한 QA와 회귀 테스트를 요구한다. 7개 앱을 동시에 유지보수하는 일은 단일 개발자 모델로 한계가 뚜렷하다. Semgrep으로 라이선스 위반 코드 패턴을 자동 차단하고, Trivy로 의존성 CVE를 일일 스캔하는 식의 자동화 파이프라인이 들어가야 멀티앱 유지보수가 가능해진다. AI가 코드를 짜는 영역과 사람이 결정해야 하는 영역이 갈라져 있다는 사실 자체가, 이 프로젝트의 가장 솔직한 결론이다.

    쟁점 정리

    • AI 클론의 경제성: 클린룸 재현 비용이 코딩 모델로 급감했지만, 기능 동등성과 장기 유지보수 가능성은 별개의 문제다.
    • trade dress 리스크: 기능은 합법이어도 외형이 너무 닮으면 소송에 휘말린다. UI 차별화 작업이 법적 안전판이다.
    • 오픈소스 수익 모델: 무료 앱 + 토큰 종량제 구조는 Figma·Notion과 다른 형태이며, B2B 락인 없이는 지속 가능성이 검증되지 않았다.
    • 생성형 AI 임베드: 단순 클론이 아닌 자체 AI 모델 통합이 차별화 요소로 부상했지만, 모델 품질이 곧 서비스 품질이라는 부담이 따른다.

    자주 묻는 질문

    Artcraft 같은 AI 클론 프로젝트의 소스를 회사 제품에 통합해도 되나요?

    MIT/Apache 라이선스이므로 자체 코드베이스에 가져다 쓰는 것 자체는 가능하지만, 어도비의 trade dress를 그대로 따라 UI를 복제해 상용 서비스로 배포하면 별도 소송 리스크가 발생한다. OSS 사용과 디자인 차별화는 분리해서 판단해야 한다.

    7개 앱을 한 사람이 AI로 동시에 유지보수하는 게 현실적인가요?

    초기 스캐폴딩은 가능하지만, 의존성 업데이트와 플랫폼 변화 대응, 사용자 피드백 반영은 결국 사람이 분배해야 한다. 멀티레포 모노레포 전략과 GitHub Actions 기반 변경 감지 매트릭스, Snyk 같은 의존성 스캐너를 조합해 자동화 범위를 넓히는 것이 실무 패턴이다.

    토큰 과금 모델을 비슷한 오픈소스에 도입하려면 어떤 구조가 필요하나요?

    Stripe 기반 사용량 측정 모듈을 앱 내부에 박는 방식이 일반적이다. OSS 빌드는 로컬 추론만 허용하고 클라우드 AI 호출만 종량제로 분리하면, 무료 사용자와 유료 사용자 간 기능 차별화를 명확히 가져갈 수 있다. 모델 API 장애 시 fallback 정책도 함께 설계해야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Ars Technica — “Software is over”: Bold AI developer takes aim at Adobe with open source clones
  • 20년 차 시니어 개발자가 코드 한 줄도 안 쓰게 된 날 — 직함을 바꿀지 무게중심을 바꿀지

    20년 차 시니어 개발자가 코드 한 줄도 안 쓰게 된 날 — 직함을 바꿀지 무게중심을 바꿀지

    핵심 요약

    • 구조적 원인: 20년간 ‘작성한 코드량이 곧 임팩트’라는 등식이 유지됐지만, AI 코딩 에이전트가 보일러플레이트·구현·테스트 생성을 흡수하면서 코드량과 가치가 분리되는 전환점에 도달한 것으로 분석됨. 시니어일수록 ‘더 이상 손으로 짤 게 없다’는 상태가 빨리 도래하는데, 정체성·평판·보상 체계는 여전히 과거 등식에 묶여 있어 방향 상실이 커짐.
    • 실무 의사결정 기준: ‘AI 대체 저항성’은 직함이 아니라 스킬의 성격에 달려 있음. 시스템 설계·아키텍처 결정·도메인 맥락 해석·리스크 판단처럼 ‘맥락과 판단’이 핵심인 영역은 AI가 보강해도 대체하지 못해 가치가 증폭되고, 순수 구현·문법·CRUD 같은 영역은 AI가 빠르게 흡수함. 따라서 ‘DEV에 머무를지 PO/SM으로 갈지’는 2차 질문이고, 1차 질문은 ‘어떤 스킬에 무게중심을 둘 것인가’임. 구체적으로는 (1) 자신의 일 중 AI가 이미 상당 부분을 처리하는 영역 분류, (2) 남은 시간 중 도메인·사람·리스크가 차지하는 비중 측정, (3) 그 비중이 다음 수년간 더 커질지 시나리오화 — 이 세 단계로 결정하는 것이 실무적으로 검증된 방식으로 보임.
    • 피해야 할 안티패턴: (1) ‘AI가 못 하는 직함’으로의 도피 — PO/SM 역시 자동 백로그 정리·회고 분석·스프린트 계획 등 AI 도구가 빠르게 들어오고 있어 ‘관리자는 안전하다’는 가정은 5년 안에 흔들릴 가능성이 큼. (2) ‘결정을 미루면 시장이 보인다’는 대기주의 — AI 도구 도입 속도가 빨라 결정 지연은 협상력을 급격히 떨어뜨림. (3) ‘코드를 안 쓰면 임팩트가 없다’는 자기확신 붕괴 — 코드를 덜 쓰더라도 ADR·아키텍처 문서·기술 전략·리스크 리뷰 등 ‘판단의 흔적’을 산출물로 남기지 않으면 조직 내 가치가 빠르게 증발함.

    AI 시대 시니어 개발자의 커리어 안전은 ‘AI가 대체하지 못하는 직함’에 머무는 것이 아니라, AI가 생성한 결과물의 방향을 결정하고 그 품질을 보증하는 ‘판단과 맥락’에 무게중심을 옮기는 데서 나온다.

    목차

    매일 아침 IDE를 켜고 PR을 올리던 손이 멈췄다. 20년 동안 쌓아온 손코딩 근육은 그대로인데, 정작 코드를 직접 타이핑하는 시간은 하루 30분을 넘기기 어렵다. Cursor가 추천해주는 다음 줄, Copilot이 채워주는 함수 시그니처, Claude Code가 짜주는 마이그레이션 패치 — 그 너머에 남는 일은 ‘이걸 왜 이렇게 만들지?’라는 질문뿐이다. 이 질문에 답하는 사람이 시니어 개발자의 진짜 임무라는 자각이 슬쩍 올라온다.

    그런데 회사는 여전히 ‘작성한 라인 수’로 임팩트를 측정하지 않는다. 동료는 여전히 PR 리뷰 코멘트 개수로 신뢰를 판단하고, 채용 시장은 여전히 ‘아키텍트’라는 직함을 좇는다. 본인이 가장 잘하는 일이 변했는데, 그것을 보여줄 언어가 없는 것이다.

    한 경력 엔지니어 포럼에서 20년 차 엔지니어가 토로한 이 혼란은 특수한 사정이 아니다. AI 코딩 에이전트가 보일러플레이트를 흡수하는 속도가 빨라지면서, 경력이 오래될수록 ‘더 이상 손으로 짤 게 없다’는 상태에 빨리 도달한다. 정작 그들은 코드 한 줄 없이도 가장 큰 결정을 내리는 사람들이다.

    필자가 현업에서 수십 개 팀의 엔지니어링 문화를 봐온 바로는, 이 혼란의 본질은 직함의 문제가 아니다. ‘DEV로 남을지 PO/SM으로 갈지’는 표면적 선택지이고, 그 뒤에 숨은 진짜 결정은 ‘어떤 판단력에 무게중심을 둘 것인가’다. 같은 고민을 더 폭넓게 풀어낸 글이 AI 개발자 역할 재정립 5단계에 있으니, 여기서는 20년 차 시니어의 시선에서 그 무게중심을 어디로 옮길지 의사결정 프레임워크를 풀어본다.

    가치의 좌표가 흔들리는 이유

    지난 20년간 SWE 시장에는 ‘작성한 코드량 = 임팩트’라는 방정식이 통했다. 커밋 수가 많고, PR이 잦고, 깃허브 그래프가 푸르다 — 이게 곧 가치의 증거였다. 그런데 AI 코딩 에이전트가 그 등식의 왼쪽 변수를 급격히 통째로 삼켜버렸다.

    같은 기능을 만들기 위해 사람이 직접 타이핑해야 할 코드는 이제 10분의 1도 안 된다. 문제는 시장이 그 감소분을 ‘시간 절약’으로만 본다는 점이다. 절약된 시간이 다른 가치를 만드는 데 쓰이지 않으면, 임팩트 총량은 그대로가 아니라 줄어든다.

    시니어 개발자 특유의 모순이 여기서 폭발한다. 도메인 지식이 깊고 시스템 전체를 보는 안목이 있고 장애 패턴을 외우고 있는 사람일수록, AI가 보일러플레이트를 처리해줄 때 가장 큰 임팩트를 낼 수 있다. 그런데 그 임팩트는 코드량이 아니라 ‘결정을 내린 횟수’로 나타난다. ADR 한 줄, 디자인 리뷰 한 마디, 장애 대응 한 번 — 이런 흔적은 PR 통계에 잡히지 않는다. 그래서 시니어들은 자신이 더 많은 일을 하고 있는데도 그 일을 증명할 수 없다고 느끼는 것이다.

    AI 레버리지 매트릭스 — 내 시간을 세 영역으로 분리하기

    첫 번째 행동은 자신의 업무를 ‘AI 대체·AI 보강·AI 증폭’ 세 영역으로 분류하는 것이다. IEEE SWEBOK이나 SFIA 같은 표준 competency framework을 백본으로 깔고, 지난 한 달간 했던 작업을 시간 단위로 적어보면 패턴이 보인다. 대체 영역은 보일러플레이트 작성, 단순 CRUD, 반복 테스트 코드 생성이 대표적이고, 보강 영역은 리팩터링, 마이그레이션, 코드 리뷰 보조, 증폭 영역은 아키텍처 결정, 트레이드오프 판단, 장애 원인 추론, 도메인 규칙 해석이다.

    대체 영역이 업무 시간의 절반을 넘으면 그건 무게중심 이동이 시급하다는 신호다. 단순히 PO/SM 직함을 따는 게 아니라, 대체 영역의 시간을 의도적으로 줄여서 보강·증폭 영역으로 재분배해야 한다. 측정 도구는 거창할 필요 없다. Toggl 같은 시간 트래커에 태그를 달거나, 달력 블록에 ‘A/B/C’ 라벨을 붙이는 것만으로 충분하다. 두 달만 기록하면 자신의 일 중 어디서 가치가 증식되고 어디서 증발하는지 선명해진다.

    직함이 아니라 무게중심 — 진짜 결정은 무엇인가

    DEV/PO/SM 사이의 선택을 1차 결정으로 두면 거의 항상 실패한다. PO는 Jira 자동 분류, 회고 감정 분석, 스프린트 예측을 AI 도구가 빠르게 흡수하고 있고, SM 역시 페르소나 기반 코칭 제안, 세션 가이드 자동 생성이 이미 들어오고 있다. 5년 안에 ‘관리자는 안전하다’는 가정은 흔들린다. 진짜 1차 결정은 ‘나는 어떤 판단력에 시간을 더 쓰겠는가’다.

    구체적으로는 세 가지 질문으로 압축된다. 첫째, 내 일 중 도메인 맥락을 해석하는 일이 차지하는 비중은 무엇인가. 둘째, 그 비중이 다음 18개월간 더 커질 것인가. 셋째, 그렇다면 그 판단력을 어떤 산출물로 증명할 것인가. 이 세 질문에 답할 때 직함은 자연스럽게 따라온다.

    도메인 비중이 크고 그 비중이 커진다면 그 사람은 사실상 PO의 결정 영역을 DEV 직함으로 수행하는 것이고, 시스템·리스크 비중이 커진다면 그 사람은 테크리드나 아키텍트의 길을 가는 것이다. AI 개발자 대체 4단계 생존 절차에서 다룬 단계와도 맞물리는 지점이다.

    판단의 산출물 — 코드 너머의 포트폴리오

    코드를 덜 쓴다 하더라도 판단의 흔적을 남기지 않으면 조직 내 가치는 빠르게 증발한다. 시니어 개발자가 남겨야 할 산출물의 핵심은 ADR(Architecture Decision Record), C4 모델, Wardley Map, Event Storming 결과물이다. 이 중에서도 ADR은 GitHub의 adr-tools나 Log4brains 같은 도구로 표준화하면 부담이 줄어든다. 주요 결정마다 컨텍스트, 검토한 옵션, 트레이드오프, 결과를 마크다운 한 페이지로 남기는 것이다.

    시스템 전체의 지형은 C4 모델로 보여주는 게 효과적이다. Structurizr DSL로 컨테이너와 컴포넌트 다이어그램을 코드와 함께 버전 관리하면, ‘이 서비스가 어떤 책임을 지고 누구와 어떻게 통신하는가’를 한 화면에 압축할 수 있다. 비즈니스 변화에 따른 기술 구성요소의 위치는 Wardley Map이 직관적이다. 어떤 컴포넌트가 ‘Custom Built’에서 ‘Product’로 흘러가는지, 어디가 다음 분기 임팩트가 클지를 시각화한다. 이 세 종류의 산출물은 AI가 직접 생성하기 어렵고, 사람의 판단과 맥락이 가장 잘 보존되는 영역이다.

    도메인 깊이는 Event Storming이나 Domain Storytelling 워크숍으로 강화한다. Backstage 기반 Developer Portal이나 Internal Developer Platform을 운영하면서 ‘AI 에이전트가 호출하는 표준 인터페이스’를 정의하는 것도 시니어의 영향력을 코드량이 아닌 ‘플랫폼 제약 설계’로 전환하는 구체적 수단이다. PMP나 PSPO 같은 자격증보다 이런 산출물이 포트폴리오에서 훨씬 강한 신호로 작동한다.

    PO/SM으로의 도피가 안전하지 않은 이유

    ‘AI가 코드를 대신 짜주니까 관리자가 되겠다’는 발상은 5년 안에 위험해진다. 이미 일부 팀에서는 AI가 스프린트 회고를 요약하고 백로그를 자동 정렬하며 사용자 스토리 초안을 뽑아낸다. 그저 일정을 조율하는 SM의 일은 자동화의 첫 번째 타깃이 된다. AI 에이전트 11개가 한 계정을 공유할 때에서 살펴본 것처럼, 도구 자체가 빠르게 중첩되며 사람의 결재·검증 단계마저 자동화 영역으로 빨려 들어간다.

    실무에서 가장 흔히 놓치는 함정은 ‘결정을 미루면 시장이 보인다’는 대기주의다. AI 도구 도입 속도가 워낙 빨라 결정 지연은 협상력을 급격히 떨어뜨린다. 현실적 경로는 현 직무 비중을 70% 정도 유지하면서 30%를 인접 영역에 분산시키는 것이다. 보안·데이터·플랫폼 프로젝트에 컨트리뷰션하고, PO나 테크리드 역할의 책임 범위를 한 사이클 단위로 실험한다. 6개월 안에 ‘내 결정이 팀의 방향을 바꿨다’는 경험이 누적되면 직함은 저절로 따라간다.

    지금 바로 해볼 것

    • 한 달간 시간 트래커에 ‘A·B·C’ 태그 달기 — Toggl 또는 Clockify에서 ‘A(대체)’, ‘B(보강)’, ‘C(증폭)’ 태그를 설정하고 4주간 모든 작업을 분류한다. 매주 금요일 30분 동안 집계해 대체 영역이 50% 이상인지 확인한다.
    • 첫 ADR을 48시간 안에 작성하기 — GitHub 저장소에 docs/adr/0001-record-architecture-decisions.md 파일을 만들고, 최근 한 달간 내린 가장 큰 결정 하나를 컨텍스트·옵션·결과 형식으로 적는다. adr-tools의 adr new "제목" 명령으로 템플릿을 자동 생성할 수 있다.
    • Structurizr DSL로 C4 다이어그램 1개 그리기 — brew install structurizr-cli 또는 docker run -it structurizr/cli로 도구를 설치하고, 현재 담당 서비스의 컨테이너 뷰를 정의한다. structurizr export로 PNG를 뽑아 PR에 첨부한다.
    • Wardley Map 보드 1개 만들기 — 온라인 도구로 본인이 책임지는 시스템의 구성요소를 ‘Genesis·Custom Built·Product·Commodity’ 축에 배치한다. 다음 18개월 안에 어디로 흘러갈지 화살표를 그려본다.
    • 인접 역할 실험 1건 등록하기 — 분기 목표에 ‘스프린트 계획 1회 리드’, ‘기술 부채 정리 백로그 작성 1건’ 같은 실험 항목을 추가하고 90일 후 결과를 회고한다.

    자주 묻는 질문

    ADR을 쓰기 시작하면 PR 리뷰 부담이 너무 늘지 않을까요?

    ADR은 PR마다 쓰는 게 아니라 분기당 3~5건 정도면 충분하다. 오히려 결정의 컨텍스트가 문서화되어 있으면 다음 사람이 ‘왜 이렇게 만들었지?’라고 묻는 시간이 줄어들어 리뷰 자체가 빨라진다. adr-tools를 쓰면 파일 명명 규칙과 링크 자동화가 따라온다.

    PO나 SM으로 직함을 옮기면 연봉 협상에서 손해인가요?

    단기적으로는 임베디드 엔지니어 타이틀이 유리할 수 있지만, 5년 안에는 PO/SM 직함에서도 무게중심이 ‘결정자’에 있는지 ‘진행자’에 있는지 분기가 일어난다. 연봉은 직함이 아니라 산출물의 희소성과 영향력 범위로 결정되므로, ADR과 플랫폼 설계로 가시화된 판단력이 더 강하다.

    팀에서 AI 도구 도입을 반대하는 분위기라면 어떻게 접근하나요?

    ADR 한 건을 ‘도입 안 함’으로 쓰는 것 자체가 시작점이다. 결정의 컨텍스트에 ‘리스크 허용 범위’, ‘성능 측정 계획’, ‘롤백 조건’을 명시하면 팀 내 신뢰가 생긴다. 도구를 강요하는 것보다 ‘이런 결정을 남겼다’는 관행이 먼저 자리를 잡아야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/cscareerquestions — The future of SWE. How to prepare?

  • 여론조사 58회, 2억 7천만 원의 무게 — 윤석열 2심 무죄가 던진 정치자금법의 새 기준

    여론조사 58회, 2억 7천만 원의 무게 — 윤석열 2심 무죄가 던진 정치자금법의 새 기준

    핵심 요약

    • 서울고등법원 형사7부는 정치자금법 위반 혐의로 기소된 윤석열 전 대통령에 대해 무죄를 선고해 1심의 징역 2년, 추징금 1,396만 원 판결을 뒤집었다.
    • 함께 기소된 정치브로커 명태균 씨에 대해서도 1심 징역 1년 6개월을 뒤집고 무죄가 선고되어, 양 피고인 모두 2심에서 풀려났다.
    • 혐의는 2021년 6월부터 2022년 3월까지 김건희 씨와 함께 명태균 씨로부터 2억 7천만 원 상당의 여론조사 58회를 무상으로 제공받았다는 내용으로, 1심은 ‘순차적·암묵적 의사 합치’를 인정해 유죄로 봤다.

    2심이 여론조사를 ‘재산상 이익’이 아닌 ‘정치적 조언’으로 평가한 것은 정치자금법상 기부 행위 성립의 핵심이 제공 물건의 경제적 가치가 아닌 당사자 간의 대가적 의사합치와 재산적 처분 가능성에 있음을 다시 확인시킨다.

    목차

    서울고등법원 형사7부가 2021년 6월부터 2022년 3월까지 김건희 씨와 함께 명태균 씨로부터 무상으로 제공받은 여론조사 58회, 시가 2억 7천만 원 상당의 행위에 대해 무죄를 선고하면서 1심의 징역 2년·추징금 1,396만 원 판결은 뒤집혔다. 함께 기소된 정치브로커 명태균 씨에 대한 1심 징역 1년 6개월도 함께 무죄로 환골탈태했다. 윤석열 2심 무죄라는 결과는 단순한 한 사람의 운명을 가른 사건이 아니라, 정치자금법이 어디까지 개입할 수 있는가의 경계를 다시 그은 사례다.

    1심과 2심, 같은 사실관계에 다른 결론

    1심 재판부는 ‘순차적·암묵적 의사 합치’라는 입증 기법을 동원했다. 명시적 합의문서나 대가 지급 증거가 없음에도, 일련의 행위가 누적되며 사실상 합치가 형성되었다고 추론한 것이다. 이 판단을 뒷받침하려면 ‘누가, 무엇을, 왜’ 제공했는지에 대한 연결 고리가 필요했지만, 2심은 그 추론을 확정할 증거가 부족하다고 봤다.

    같은 자료를 놓고도 결론이 갈리는 지점이 바로 대가성·고의의 입증 표준이다. 정치자금법 및 선거 관련 판례를 심층 검토할 때 가장 빈번하게 지적되는 법리적 착시도 바로 이 부분이다. 직접적인 금전 흐름이 보이지 않으면 곧 ‘무료’로 읽히기 쉽지만, 법원은 ‘왜 무료였는가’를 다시 묻는다.

    2심은 여론조사 결과를 다른 데이터와 함께 묶어 ‘여론동향 분석’, ‘정치적 조언’의 일환으로 평가했다. 명태균 씨가 제공 과정에서 ‘존재가치를 인정받고자 하는 욕구’ 등 개인 사정이 작용했다는 점도 끌어왔다. 결국 제공된 것이 ‘재산상 이익’이 아니라 ‘정치적 메시지’로 해석될 여지가 있다는 것이다. 같은 사실관계에 대한 두 재판부의 평가는, 정치자금 사건의 쟁점이 얼마나 사실인정 단계에서 결정되는지를 그대로 보여준다. 1심은 58회라는 횟수와 2억 7천만 원이라는 시가를 강조했고, 2심은 동일 자료를 ‘정치적 맥락’으로 재포장했다.

    정치자금법상 ‘기부’의 구조 — 재산상 이익과 대가성

    정치자금법은 누구든 정치자금의 기부행위를 금지하며, 여기서 ‘기부’는 재산상 이익의 제공 여부가 핵심 분기점이 된다. 현행 법령과 대법원 판례 흐름은 ‘기부’ 개념을 단순히 물건이나 현금에 한정하지 않고 경제적 가치가 있는 일체의 혜택을 포섭해왔다. 다만 그 포섭 범위가 어디까지인지에 대해서는 학설과 판례가 꾸준히 다툼이 있어왔다. 2심의 이번 판단은 여론조사라는 정보 제공이 경제적 처분 가능성을 가지는 ‘재산’으로 평가될 수 있는지, 그리고 그 경제적 가치가 거래시장에서 환산될 수 있는지를 좁게 본 데서 나왔다.

    여론조사의 시장 가치 산정은 실무에서 가장 난해한 영역 중 하나다. 동일한 조사라 해도 의뢰 시점·조사 기관의 신뢰도·결과 해석의 깊이에 따라 가격이 수 배 차이 난다. 1심 검찰이 제시한 2억 7천만 원이라는 시가는 통상적인 외주 발주 단가를 기준표처럼 적용한 추정치였고, 2심은 이 추정에 ‘정치적 조언’이라는 다른 해석을 정면으로 받아쳤다. 같은 숫자가 한쪽에선 입증의 핵심, 다른 쪽에선 과대평가된 시가로 둔갑한 셈이다. MBC 뉴스 보도에서도 이 시가 산정 방식이 쟁점의 중심이었다는 분석이 반복된다.

    명태균 측 ‘형사보상 청구’, 그 다음의 절차

    명태균 측은 판결 직후 ‘형사보상 청구해야제’라고 밝히며 형사보상 및 명예회복에 관한 법률에 따른 보상 절차로 이행할 가능성을 시사했다. 형사보상 제도는 무죄 확정 시 미결구금일수, 변호사비, 위자료 등을 보상하는 절차다. 다만 보상 청구가 곧바로 인정을 의미하지는 않는다. 보상 인정 여부는 위자료 산정 기준, 미결구금 기간의 산정, 그리고 재심 등 후속 절차 진행 여부에 따라 달라진다.

    현장에서 가장 자주 간과되는 지점은 ‘무죄’가 보상 청구의 충분조건이 아니라는 사실이다. 형사보상법상 위자료는 위법성·과실 없이 신체적 자유를 구속당한 데 대한 보상 성격이 강하다. 피의자 신분으로 조사를 받았더라도 구속·체포 등 강제력이 없었던 기간은 보상 범위에서 빠질 수 있다. 따라서 명 씨 측이 실질적인 보상을 받으려면 미결구금 일수 산정과 위자료 인정 범위에 대한 정밀한 자료 준비가 뒤따라야 한다. JTBC 보도도 형사보상 청구 가능성을 별도 쟁점으로 분류해 다뤘다.

    대법원 상소와 입증 기준의 향방

    검찰은 1심의 ‘순차적·암묵적 의사 합치’ 이론을 받아들인 상태였기에 2심의 뒤집힘은 예상 밖의 결과였을 가능성이 높다. 상소 여부는 앞으로 가장 큰 분기점이 될 변수다. 검찰이 상소하면 대법원은 ① 여론조사의 재산가치 인정 여부, ② 피고인 측 사정(개인적 욕구 등)만으로 대가성을 부인할 수 있는지, ③ 정치자금법상 ‘기부’ 개념의 확장 해석 한계라는 세 쟁점을 다뤄야 한다. 이 쟁점들은 이 사건의 당사자를 넘어 정치자금법의 실효성 전체에 영향을 준다.

    실무적으로 정치자금 사건에서 무상 여론조사·컨설팅 제공은 대가성·고의 입증이 핵심 쟁점으로 부상해 왔다. 2심 판결은 그 입증 기준을 한 단계 더 끌어올렸다는 평가가 가능하다. 다만 대법원이 이를 그대로 유지할지, 아니면 ‘정보 제공의 경제적 가치’를 보다 적극적으로 인정할지는 별개의 문제다.

    검찰 내부의 의사결정 구조도 변수다. 수사·기소 분리가 한 축으로 작동하는 현 제도 하에서, 항소심 결과를 계기로 상소 여부를 어떻게 정례화할지는 검찰개혁 인사 쟁점과도 맞물린다. 항소 포기는 검찰의 체면이 걸린 문제이면서 동시에 재량 판단 영역이기 때문에, 단순히 ‘1심에서 이겼으니 상소’라는 논리로 움직이지 않을 가능성이 있다.

    함께 지켜볼 것

    • 검찰의 대법원 상소 결정 시점과 상소 이유 — 정치자금법상 ‘기부’ 해석 기준이 최고법원에서 다시 다뤄질지 여부
    • 명태균 측 형사보상 청구 진행 여부와 미결구금 일수 산정 — 위자료 인정 범위가 향후 다른 정치자금 무죄 사건의 벤치마크가 될 가능성
    • 여론조사 58회의 경제적 가치 산정 방식이 후속 정치자금 사건에서 어떻게 인용되는지 — 1심 시가 기준의 재평가 여부
    • 동 사건과 별도로 진행 중인 윤석열 전 대통령 관련 형사사건(내란 등)과의 절차적 상호작용 — 항소심 일정이 묶이면서 후속 재판 전략에 미칠 영향

    자주 묻는 질문

    윤석열 2심 무죄가 확정된 건가요?

    아직 확정은 아니다. 2심 판결은 1심을 뒤집은 것이지, 대법원 상소심이 남았기 때문에 최종 확정은 검찰의 상소 여부와 대법원 판결에 따라 결정된다. 검찰이 상소하지 않거나 상소했더라도 기각되면 그때 무죄가 확정된다.

    여론조사를 무상으로 받았는데 왜 ‘재산상 이익’이 아닌가요?

    2심은 여론조사 결과를 ‘정치적 조언’의 수단으로 평가했다. 명태균 씨 측의 사정(존재가치 인정 욕구 등)이 작용했다는 점, 그리고 다른 여론조사 결과와 함께 묶여 메시지 전달의 성격이 강했다는 점을 들어, 거래 가능한 경제적 가치로 환산하기 어렵다고 봤다. 같은 논리를 1심은 받아들이지 않았다.

    형사보상 청구는 무조건 인가되나요?

    무죄 판결이 나와도 형사보상 청구가 자동으로 인정되는 것은 아니다. 미결구금 일수, 구속·체포 등 강제력 행사 여부, 위자료 산정 기준이 모두 검토 대상이다. 위자료는 위법성·과실 없는 신분 구속에 대한 보상으로 평가되는 만큼, 입증 준비가 정밀하게 이뤄지지 않으면 보상 범위가 축소될 수 있다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MBC 뉴스

  • 대형 교회 랜섬웨어·해킹 침해사고: ERP 정보 유출 정황과 KISA 긴급 조사 착수

    대형 교회 랜섬웨어·해킹 침해사고: ERP 정보 유출 정황과 KISA 긴급 조사 착수

    핵심 요약

    • 금융권에 이어 국내 대형 교회 두 곳이 사이버 공격에 노출돼 약 100만건의 교인 개인정보와 헌금 내역이 유출된 정황이 확인됐으며, 이번 사건은 종교기관이 사이버 공격의 새로운 1차 표적으로 부상했음을 보여준다.
    • 오아시스시큐리티가 해킹 의심 IP를 추적하던 중 대량의 데이터가 담긴 해외 공격자 서버를 발견했고, 해당 서버에는 서울 여의도순복음교회와 서초구 사랑의교회 통합정보시스템 및 그룹웨어에서 8월 탈취된 자료가 기록돼 있었다.
    • 여의도순복음교회는 웹셸을 통해 서버에 침투해 전사적자원관리(ERP) 데이터베이스 관리자 권한을 확보한 것으로 분석되며, 최근 2년간 업데이트된 교인 정보 96만건, 헌금 관련 기록 33만건, 전자결재 문서 6만8000건 등 총 47.3GB 규모의 자료가 유출됐다.

    전통적으로 사이버 공격의 1차 표적이 아니었던 종교·비영리 기관이 ERP·그룹웨어 통합 환경에서 웹셸과 사전 탈취 계정이라는 고전적 침투 경로를 통해 금융·공공기관급 데이터 자산을 보유한 실질적 표적으로 부상했으며, AI 에이전트형 자동화 공격은 이러한 표적 확장에 들어가는 비용을 낮춰 공격 성공률을 높이고 있다.

    목차

    금융권 해킹이 채 가라앉기도 전에, 이번에는 교회 해킹이 정조준됐다. 8월, 서울 여의도순복음교회와 서초구 사랑의교회 통합정보시스템이 잇따라 뚫렸다. 한국인터넷진흥원(KISA)이 해외 공격자 서버에서 두 교단에서 유출된 것으로 추정되는 자료 47.3GB를 추적해낸 정황이 보안뉴스 보도를 통해 공개됐다. 교인 100만 명에 가까운 개인정보와 헌금·전자결재 문서가 한 번에 빠져나간 것이다. 단순한 정보유출 사고가 아니다. 종교기관이 사이버 공격의 1차 표적으로 부상했다는 신호다.

    금융권 다음 무대는 왜 교회인가

    국내외 다수의 침해사고 분석 사례에서 공통적으로 확인되듯, 공격자는 항상 인프라에서 가장 방어가 취약한 접점을 먼저 탐색한다. 종교기관은 예배·선교 중심으로 운영되기 때문에 보안 인력과 예산이 공공·금융기관 대비 턱없이 부족한 경우가 많다. 그런데 정작 내부에는 ERP, 그룹웨어, 전자결재, 헌금 관리 시스템, 교인 DB가 한데 묶여 있다. 표면은 비영리지만, 데이터 자산의 밀도는 금융권과 별 차이가 없다. 최근 금융권을 겨냥한 AI 기반 침해 분석에서 본 것처럼, 공격자는 이미 “가성비 좋은 표적”을 중심으로 무대를 옮기는 중이다. 종교기관은 그 다음 후보였다.

    여의도순복음교회 침투 경로: 웹셸로 ERP 관리자 권한까지

    여의도순복음교회 사안을 보면, 공격자는 웹셸(webshell)로 첫 발을 들여놓았다. 웹셸이란 취약한 웹 애플리케이션에 업로드해 원격 명령을 실행하게 만드는 작은 스크립트로, 흔히 eval, base64_decode, system, passthru 같은 함수가 들어 있다. 본 사고에서도 웹셸을 통해 서버에 침투한 뒤 전사적자원관리(ERP) 데이터베이스 관리자 권한을 확보한 것으로 분석됐다. 결국 최근 2년간 업데이트된 교인 정보 96만 건, 헌금 기록 33만 건, 전자결재 6만 8천 건이 한 번에 반출됐다.

    왜 이런 일이 일어났는가. 대부분의 웹셸 침투는 단일 WAF 규칙으로 막기 어렵다. 공격자는 정상 트래픽 사이에 파일 업로드 요청을 섞어 넣고, 한 번 업로드한 뒤에는 명령을 분할해 호출한다. 실무에서 가장 흔히 놓치는 함정은 IIS·Apache 액세스 로그에 남아 있는 200 OK 응답의 파일 크기 변화다. 정상 이미지 파일이 갑자기 0byte로 떨어지거나, .php·.jsp 확장자가 .jpg로 위장된 채 신규 생성되는 패턴을 놓치면 초동 대응이 늦어진다.

    개선은 두 축으로 해야 한다. 첫째, Semgrep 같은 정적 분석 도구로 웹 애플리케이션 저장 경로에 eval, base64_decode, system, passthru, assert 호출이 섞여 있지 않은지 PR 단계에서부터 검사한다. 둘째, Wazuh·OSSEC 같은 HIDS의 File Integrity Monitoring(FIM) 기능을 웹루트 전체에 켜두고, 생성·수정 이벤트가 발생하면 즉시 Slack으로 알림을 받게 한다. 보안 관제 및 인프라 보호 체계에서 필수적으로 권장되는 탐지 룰셋은 다음과 같다.

    <syscheck>
      <directories check_all="yes" realtime="yes">/var/www/html</directories>
      <ignore>/var/www/html/wp-content/uploads/</ignore>
    </syscheck>

    이렇게 설정해두면 .php 파일이 업로드되는 즉시 OS 레벨에서 로그가 남고, EDR 단에서 자동 차단으로 연결할 수 있다. 웹셸은 “어제 뚫렸다”가 아니라 “방금 막았다”로 끊어야 하는 위협이다.

    사랑의교회 침투 경로: 사전 탈취 계정과 통합 로그인의 함정

    사랑의교회는 양상이 다르다. 외부 웹셸이 아니라, 이미 어딘가에서 탈취된 계정 정보가 그룹웨어 서버에 그대로 재사용됐다. 공격자는 그룹웨어에 로그인한 뒤 통합 로그인(SSO) 기능을 악용해 ERP까지 진입 범위를 넓혔다. 담임목사 등 임직원 286명과 교인 8만 9천 명의 이름·주소·전화번호가 유출됐다.

    SSO는 사용자 편의를 크게 높이지만, 한 번 인증을 통과하면 뒤쪽 시스템 전체가 같은 신뢰 수준으로 묶인다. 현업 실무에서 자주 목격되는 대표적 실수는 “통합 로그인 앞단에만 MFA를 걸고, 백엔드 ERP API에는 내부 IP라는 이유로 인증을 생략”하는 구성이다. 공격자는 이 한 줄짜리 허용 규칙을 노린다. 인가 누락이 결정적 변수가 됐던 파라미터 변조 분석에서도 같은 결의 함정이 반복적으로 보고됐다. SSO 토큰의 issuer·audience·exp 검증을 백엔드에서 다시 한 번 강제하는 게 핵심이다.

    계정 측면의 통제도 함께 가야 한다. 다크웹 모니터링과 침해지표(IoC) 피드를 SIEM에 연동해, 평소와 다른 시간대·지역·User-Agent의 로그인이 감지되면 즉시 세션을 강제 종료하고 비밀번호 재설정 + MFA 재등록을 요구하도록 자동화한다. Splunk SPL로는 아래 룰을 매일 한 번씩 돌려 비정상 패턴을 추려낼 수 있다.

    index=auth action=success user=*
    | stats values(src_ip) as ips values(user_agent) as ua by user
    | where mvcount(ips) > 3 OR mvcount(ua) > 2

    AI 에이전트가 공격 문서까지 자동화했다

    이번 사건에서 가장 주목할 변화는 AI 활용 정황이다. 오아시스시큐리티가 확보한 공격 과정 문서에는 “하위 에이전트(sub-agent)”라는 표현이 등장하고, 시스템 구조와 계정 정보를 종합한 공격 인수인계 보고서가 수백 개 발견됐다. 공격자가 직접 모든 단계의 메모를 남긴 흔적이다. 금융권 해킹에 사용된 모델과 다른, 별개의 저가형 AI가 동원된 것으로 추정된다.

    이건 단순한 “AI로 피싱 문구 잘 쓰기” 수준이 아니다. AI가 시스템 구조를 입력받아 하위 작업으로 분할하고, 실행 결과를 다시 받아 문서화하는 에이전트 루프가 작동했다는 의미다. 명령 수행·파일 탐색·권한 확인·데이터 추출이 자동화되어 있어, 공격 1건당 들어가는 인력과 시간이 극단적으로 줄었다. 사람이 며칠이 걸릴 침투가, AI 에이전트 기준으로는 수 시간 단위로 압축된다.

    대응은 행위 기반 탐지로 가야 한다. 짧은 시간에 다수의 명령이 실행되거나, 평소와 다른 경로에서 대량 파일이 압축·외부 전송되는 패턴을 UEBA로 잡고, DLP로 외부 반출 트래픽을 차단한다. Suricata로 EVE 로그를 수집해 아래 룰을 함께 올려두면 효과적이다.

    alert http $HOME_NET any -> $EXTERNAL_NET any (msg:"LARGE outbound zip upload"; flow:established,to_server; http.content_type; content:"application/zip"; byte_test:1,>,5242880; sid:2024101501; rev:1;)

    5MB 이상 아웃바운드 압축 전송을 한 줄로 잡는 룰이지만, 평소 사무 환경 트래픽 패턴과 결합하면 잡음 없이 비정상 반출을 끌어낼 수 있다.

    2차 피해 시나리오: 유출 정보로 무장한 스미싱·피싱

    1차 유출은 끝이 아니다. KISA 보호나라는 유출된 교인 명단과 헌금 내역을 미끼로 한 2차 공격 가능성을 경고했다. 보호나라의 피싱 주의 권고에 따르면 “지원금 신청”, “피해보상금 지급”, “유출정보 확인” 같은 키워드를 활용한 악성 URL과 검색 결과 조작 수법이 이미 확인됐다. 실제 문자가 와도 “KISA·금융기관이 전화·문자로 원격제어 앱 설치를 요구하지 않는다”는 사실을 사용자 교육에 포함해야 한다.

    악성 앱 감염이 의심될 때는 비행기 모드 전환 → 공인백신 검사 → 공인인증서·보안카드 재발급, 모바일 결제 피해는 통신사 소액결제확인서 발급 → 경찰서 사이버수사대 사건·사고 사실 확인서 발급 순서로 움직이도록 매뉴얼을 사전에 정비해두는 게 핵심이다. 사고 대응 매뉴얼이 없으면, 피해자가 24시간 안에 두세 번의 결제를 승인해 버리는 사례가 실무에서 반복된다.

    지금 바로 해볼 것

    • Wazuh·OSSEC의 File Integrity Monitoring을 웹루트 전체에 켜고, 신규 .php·.jsp·.aspx 생성 시 Slack 알림을 자동화한다.
    • Semgrep 규칙(p/php·p/java·p/python의 eval/base64_decode/system·passthru·assert 탐지)을 CI 파이프라인에 추가해 PR 단계에서 웹셸 의심 코드를 차단한다.
    • SSO 백엔드 API 호출에 issuer·audience·exp 검증을 강제하고, 내부 IP 화이트리스트에도 MFA 재인증을 결합한다.
    • 다크웹 모니터링·침해지표 피드를 SIEM에 연동하고, 평소와 다른 시간대·지역·User-Agent 로그인 시 세션 강제 종료 + 비밀번호 재설정을 자동화한다.
    • Suricata·EDR 룰로 5MB 이상 아웃바운드 전송과 짧은 시간 다수 명령 실행 패턴을 행위 기반으로 탐지하고, DLP로 외부 반출 트래픽을 즉시 차단한다.

    표적 확장과 AI 자동화가 만드는 새로운 위협

    이번 교회 해킹은 “어디까지가 1차 표적인가”에 대한 기준을 다시 그었다. ERP, 그룹웨어, 결재, 기부금 DB가 묶인 모든 비금융·비공공 기관은 이미 표적 안에 있다. 여기에 AI 에이전트가 더해지면, 공격자는 적은 비용으로 더 많은 곳을 시도하고, 성공률도 끌어올린다. 보안팀이 할 일은 명확하다. 웹셸을 코드 단에서부터 막고, 계정 신뢰를 영구 상태가 아닌 매 요청 검증으로 바꾸고, ERP 백엔드 인가를 다시 한 번 점검하는 일이다. 그 세 가지가 오늘 바로 시작할 수 있는 첫 번째 통제선이다.

    자주 묻는 질문

    중소규모 종교기관은 보안 예산이 적습니다. Wazuh·Semgrep 같은 도구를 무료로 운영할 수 있나요?

    Wazuh는 오픈소스 HIDS로 FIM과 로그 통합 기능을 무료로 제공한다. Semgrep 커뮤니티 버전도 eval·base64_decode 같은 핵심 규칙을 포함한다. 다만 초기 룰 튜닝과 운영 인력이 필요하므로, 탐지 룰 운영만 외부 MSSP에 맡기고 자사는 로그 수집과 정책 관리만 하는 분업 모델이 비용 대비 효과적이다.

    레거시 ERP는 API 구조를 바꾸기 어렵습니다. SSO 백엔드 검증을 어디까지 강제할 수 있나요?

    레거시 ERP 코드를 직접 수정할 수 없다면, API Gateway 앞단에서 JWT의 issuer·audience·exp를 검증하는 필터를 추가하는 방식이 현실적이다. 인증 필터를 통과한 트래픽만 ERP에 도달하도록 네트워크 경계를 좁히고, 백엔드 호출 로그를 WAF에 남겨 두면 사후 감사 기준으로 활용할 수 있다. 코드 변경 없이도 통제 수준을 끌어올리는 핵심 경로다.

    AI 에이전트형 공격은 EDR만으로 막을 수 있나요?

    단독으로는 부족하다. EDR은 프로세스 단위 행위를 잡지만, 데이터 반출은 정상 HTTPS 트래픽 속에 섞여 들어오기 때문이다. EDR + UEBA + DLP + 네트워크 행위 분석(NDR)을 동시에 운영해 단일 신호가 아닌 상관관계로 판단해야 한다. 1차 차단은 EDR, 2차 차단은 DLP로 역할을 나눠 두는 것이 실무에서 가장 안정적이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 보안뉴스 — “사이버 공격에 성역은 없다”… 종교계 겨냥한 해킹 공격 비상

  • AI 에이전트 11개가 한 계정을 공유할 때 — 신원 분리 5단계로 푸는 즉시 폐기 체계

    AI 에이전트 11개가 한 계정을 공유할 때 — 신원 분리 5단계로 푸는 즉시 폐기 체계

    핵심 요약

    • 구조적 원인: 11개 에이전트가 2개 서비스 계정을 공유하는 구조는 권한 풀링(permission pooling) 현상을 만든다. 한 에이전트에 부여된 권한이 같은 계정을 쓰는 다른 에이전트로 자동 전파되므로, 단일 계정의 권한 집합은 시간이 지날수록 모든 에이전트가 필요로 하는 권한의 합집합으로 수렴한다. 원글의 사례(30일치만 필요한 에이전트가 3년치 고객 레코드에 접근해 쿼리 타임아웃으로 발각됨)가 이 메커니즘을 직접 보여준다. 또한 공유 계정은 감사 로그에서 ‘어떤 에이전트가 했는지’를 지워버려 이상 징후가 감지되어도 어느 신원을 차단해야 할지 판단할 수 없게 만든다. 권한 회수가 재배포 사이클에 묶이면서 사고 대응 속도가 늦어지는 점도 같은 구조에서 파생된다.
    • 실무 해결 단계와 의사결정 기준: 1단계로 IdP(Entra ID, Okta, Auth0, AWS IAM 등) 레벨에서 에이전트 1개당 1개의 서비스 프린시펄 또는 OAuth 클라이언트를 발급한다. 원글 댓글에서 ‘Entra에서 하루 만에 세팅’했다는 실무 보고가 이 단계의 현실적 도입 비용 기준점이 된다. 2단계로 각 에이전트의 작업 명세(레포지토리, 데이터 범위, 시간 범위, 호출 대상 API)에 맞춰 최소 권한 스코프를 정의하고, 다른 에이전트가 쓰는 리소스에는 기본 차단으로 분리한다. 3단계로 정적 API 키 대신 단기 토큰(STS, Workload Identity Federation, Vault 동적 시크릿)으로 전환해 자격증명이 프롬프트나 환경변수에 노출되지 않게 한다. 4단계로 신원 폐기를 IdP API 호출만으로 즉시 처리할 수 있는 체계를 마련해 재배포 의존도를 제거한다. 5단계로 감사 로그에 에이전트 ID, 사용자 컨텍스트, 리소스 스코프를 남기도록 로깅 파이프라인을 보강한다. 의사결정 기준은 ‘한 신원을 폐기했을 때 다른 에이전트가 영향을 받는가’이며, 영향을 받는다면 아직 권한이 풀링되어 있다는 신호다.
    • 치명적 안티패턴: 첫째, ‘한 서비스 계정에 권한을 조금씩 더 주는’ 누적식 권한 관리. 시간 경과에 따라 어떤 에이전트가 어떤 권한을 실제로 쓰는지 추적 불가능해진다. 둘째, 에이전트 코드가 장기 API 키를 환경변수나 설정 파일에 하드코딩하는 형태로, 이 경우 키 회수에 재배포가 강제된다. 셋째, 권한 폐기를 IaC 변경과 배포 파이프라인에 묶어두는 설계로, 사고 시 수 분 내 차단해야 하는 상황에서 수십 분이 소요된다. 넷째, 에이전트 권한을 사람용 권한 모델과 동일 선상에서 다루는 경우. 에이전트는 사람보다 빠르고 많은 양의 데이터를 처리하므로 사람용 권한을 그대로 적용하면 항상 과다 권한이 된다. 다섯째, ‘데모는 되는데 운영에서는 안 되는’ IdP 통합으로, 프로덕션 로그에 실제로 신원이 남는지, 폐기 명령이 몇 초 안에 전파되는지를 검증하지 않은 채 도입하는 사례가 빈번하다.

    에이전트마다 독립 신원을 발급하고 작업 단위로 권한을 스코핑해두면, 사고 발생 시 재배포 없이 IdP API 한 번 호출로 해당 신원만 폐기할 수 있고, 이로써 보안 운영의 기본 단위가 ‘배포’에서 ‘신원’으로 전환된다.

    목차

    에이전트 기반 자동화가 사내 인프라 깊숙이 들어온 조직에서 한 번쯤 마주치는 광경이 있습니다. 30일치 데이터만 필요한 분석 에이전트, 90일치 로그를 다루는 모니터링 봇, 외부 API 호출용 어시스턴트까지 열 개가 넘는 AI 에이전트가 돌아가는데 정작 IdP를 열어보면 서비스 계정이 두세 개에 불과한 상황. 한 에이전트에 필요한 권한을 추가하다 보면 같은 계정을 쓰는 다른 에이전트까지 영향을 받게 되고, 권한 집합은 시간이 지날수록 모든 에이전트가 필요로 하는 권한의 합집합으로 부풀어 오릅니다.

    권한 누적이 전부가 아닙니다. 사고가 터져서 SIEM을 열어봐도 어느 에이전트가 호출했는지가 로그에 남지 않습니다. 공유 계정 아래에서는 모든 행위가 동일 주체로 평탄화되어, 비정상 호출이 감지되어도 그 신원을 차단하면 다른 에이전트가 멈추고, 그대로 두면 사고가 계속됩니다. 권한 회수가 재배포 사이클에 묶여 있으면 인시던트 대응은 수십 분 단위로 늘어지고, 그 사이 다른 자동화도 영향을 받습니다.

    권한 풀링이 만드는 감사 사각지대

    공유 계정 구조가 반복적으로 문제를 만드는 이유는 권한 풀링이라는 메커니즘 때문입니다. 한 계정에 A 에이전트용 권한을 부여하면 같은 계정을 쓰는 B 에이전트도 자동으로 그 권한을 갖게 됩니다. 최소 권한 원칙은 에이전트 단위로 적용해야 의미가 있는데, 공유 계정은 그 경계를 흐립니다. 30일치만 필요한 에이전트가 3년치 고객 테이블에 접근해 쿼리 타임아웃이 발생한 사례가 정확한 예시입니다 — 권한이 없어서 막힌 게 아니라, 권한이 너무 넓어서 비정상 호출이 사인으로 보이지 않은 겁니다.

    감사 로그의 신원 손실도 같은 뿌리에서 나옵니다. 클라우드 감사 로그가 남기는 주체는 어떤 서비스 계정이 호출했는지까지만 보여줍니다. 그 계정을 열 개의 에이전트가 돌려쓰고 있다면, 로그에는 같은 이름이 반복될 뿐 어느 호출이 어느 에이전트에서 나왔는지는 코드 메타데이터를 별도로 합쳐야 알 수 있습니다. 그 통합이 깨지는 순간 추적은 사실상 불가능해집니다.

    사례 1 — Entra ID 앱 등록으로 하루 만에 도입

    가장 빠르게 적용 가능한 모델은 IdP 레벨에서 에이전트 1개당 1개의 서비스 프린시펄을 발급하는 것입니다. Microsoft Entra ID 기준 절차는 이렇습니다. Azure Portal의 App registrations에서 New registration으로 에이전트별 앱 객체를 만들고, Certificates & secrets에서 클라이언트 시크릿을 발급합니다. 에이전트 코드에서는 MSAL의 ConfidentialClientApplication으로 OAuth 2.0 클라이언트 자격증명 흐름을 타면 됩니다.

    from msal import ConfidentialClientApplication
    app = ConfidentialClientApplication(
        client_id="<agent-app-object-id>",
        client_credential="<client-secret>",
        authority="https://login.microsoftonline.com/<tenant-id>"
    )
    token = app.acquire_token_for_client(scopes=["https://graph.microsoft.com/.default"])

    이렇게 발급된 앱은 Entra 감사 로그에 고유한 앱 객체 ID로 그대로 남기 때문에 어느 에이전트가 어떤 리소스에 접근했는지가 로그에서 바로 보입니다. 폐기는 Portal에서 앱을 Delete 하는 것만으로 끝나며, 배포 파이프라인을 건드릴 필요가 없습니다. 한 운영자가 Entra에서 11개 에이전트의 앱 등록을 하루 만에 완료했다는 보고가 운영자 사례 스레드에 남아 있으며, 이 정도 시간 투자로 감사 추적성이 즉시 회복된다면 시도해볼 만합니다.

    사례 2 — 런타임 신원과 동적 시크릿

    정적 API 키를 환경변수에 박아두는 모델은 키 회수에 재배포를 강제한다는 치명적 약점이 있습니다. Akeyless의 Runtime Identity나 HashiCorp Vault의 Database Secrets Engine 같은 런타임 신원 모델은 호출 시점에 TTL이 짧은 임시 자격증명을 발급합니다. Vault 기준 설정은 다음과 같습니다.

    vault write database/roles/agent-data-30d \
        db_name=mydb \
        creation_statements="CREATE LOGIN ..." \
        default_ttl="30m" max_ttl="2h" \
        REVOKE_STATEMENTS="REVOKE SELECT ON dbo.customers_3yr TO ..."

    여기서 REVOKE_STATEMENTS는 30일치 데이터 뷰를 벗어난 테이블 접근을 행 단위로 차단하는 정책입니다. 에이전트 폐기는 vault token revoke <accessor> 한 줄로 끝나고, 다른 에이전트의 토큰에는 영향이 없습니다. 30일 vs 3년치 사례는 정확히 이 메커니즘으로 차단 가능한 케이스입니다 — TTL이 짧고, 행 단위 필터가 있어, 권한 누적이 코드 레벨에서 일어날 수 없습니다.

    해결 프레임워크 5단계

    첫째, IdP에서 에이전트 1개당 1개의 서비스 프린시펄 또는 OAuth 클라이언트를 발급합니다. 둘째, 각 에이전트의 작업 명세 — 접근 리포지토리, 데이터 범위, 시간 범위, 호출 대상 API — 를 정의하고 다른 에이전트가 쓰는 리소스는 기본 차단으로 분리합니다. 셋째, 정적 API 키를 단기 토큰(STS, Workload Identity Federation, Vault 동적 시크릿)으로 교체해 자격증명이 환경변수나 프롬프트에 노출되지 않게 합니다. 넷째, 신원 폐기를 IdP API 한 번 호출로 끝낼 수 있는 체계를 갖춥니다. 다섯째, 감사 로그에 에이전트 ID, 사용자 컨텍스트, 리소스 스코프가 남도록 로깅 파이프라인을 보강합니다.

    이 프레임워크의 의사결정 기준은 단순합니다. 한 신원을 폐기했을 때 다른 에이전트가 영향을 받는가라는 질문에 그렇다고 답이 나오면 아직 권한이 풀링되어 있다는 신호입니다. 정상 상태에서는 한 신원 폐기가 다른 에이전트 호출에 단절을 일으키지 않아야 합니다. 결국 AI 에이전트 신원 분리의 가치는 이 즉시 폐기 가능성에서 결정됩니다.

    기술 스택 선택 기준

    구분 도구 도입 속도 폐기 속도 멀티 클라우드 권장 시나리오
    IdP 앱 등록 Entra ID / Okta / Auth0 수 시간 즉시 (앱 삭제) 제한적 단일 클라우드, 빠른 시작
    런타임 신원 Akeyless / Vault 1~2주 즉시 (토큰 revoke) 지원 자격증명 노출 위험이 큰 환경
    워크로드 표준 SPIFFE / SPIRE 2~4주 정책 변경 즉시 우수 쿠버네티스, 멀티 클라우드
    클라우드 네이티브 AWS IAM Roles Anywhere / GCP WIF / Azure Managed Identity 1~3일 신뢰 정책 제거 즉시 해당 클라우드 클라우드 리소스 중심 호출

    단일 IdP와 단일 클라우드에 머물러 있다면 Entra ID 앱 등록만으로 충분합니다. 멀티 클라우드·멀티 쿠버네티스 환경이라면 SPIFFE/SPIRE의 SVID 발급이 가장 일관된 신원 체계를 제공합니다. 클라우드 중심 호출이라면 IAM Roles Anywhere, 기존 Vault 운영 조직이라면 동적 시크릿이 자연스러운 선택입니다.

    안티패턴 4가지

    첫째, 누적식 권한 관리입니다. 한 서비스 계정에 필요한 권한을 조금씩 더 주는 방식은 시간이 지날수록 어떤 에이전트가 어떤 권한을 실제로 쓰는지 추적 불가능해지고, 호출 빈도가 낮은 권한이 위험한 작업에 쓰일 수 있어 분기 검토로도 해결되지 않습니다.

    둘째, 에이전트 코드의 장기 API 키를 환경변수나 .env 파일에 하드코딩하면 키 회수에 전체 재배포가 강제됩니다. 셋째, 권한 폐기를 IaC 변경과 배포 파이프라인에 묶어두면 사고 시 수 분 내 차단이 필요한 상황에서 수십 분이 소요됩니다. 넷째, 사람용 권한 모델을 에이전트에 그대로 이식하면 에이전트의 빠른 데이터 처리 특성상 항상 과다 권한이 됩니다.

    기업 인프라 보안 감사 사례에서 가장 빈번하게 발견되는 취약 패턴은 두 번째 안티패턴입니다. .env 파일에 AWS 액세스 키가 박혀 있는 에이전트가 다수 발견되는데, 이 키를 회수하려면 컨테이너 이미지 빌드부터 다시 해야 해서 임시 방편으로 키를 그대로 두는 상황이 반복됩니다. 시스템 레벨에서 키 노출을 차단하지 못하면 사람 레벨 통제(키 로테이션 일정, 접근 검토 회의)는 사실상 무력화됩니다.

    검증과 체크리스트

    프레임워크를 도입한 뒤 반드시 검증해야 할 지표가 있습니다. 시뮬레이션된 인시던트로 한 신원을 폐기한 뒤, 그 신원으로 호출된 마지막 요청이 SIEM에 남기까지 걸리는 시간, 그리고 같은 계정을 쓰던 다른 에이전트 호출이 정상 동작하는지 여부를 측정합니다. 폐기 후 5초 이내에 로그 반영이 되고, 다른 에이전트 호출에는 영향이 없는 상태가 합격선입니다. 30초 이상이거나 다른 에이전트가 멈춘다면 아직 권한이 풀링되어 있다는 뜻입니다.

    에이전트 수가 5개를 넘고 서비스 계정이 3개 미만이라면 이미 위험 구간입니다. 폐기 명령 후 5분 이상 걸리는 인시던트가 한 번이라도 있었다면, 감사 로그에 어느 에이전트가 호출했는지가 남지 않는 상태로 한 번이라도 운영했다면, 환경변수에 정적 API 키가 박혀 있다면, 사람용 IAM 그룹에 에이전트가 포함되어 있다면, 키 회수에 코드 변경이 필요하다면, 에이전트 추가 시 기존 회귀 테스트가 필요하다면 — 이 중 세 개 이상 해당된다면 신원 분리 도입을 다음 분기 우선순위로 올려야 합니다.

    운영의 기본 단위를 배포에서 신원으로

    한 신원을 IdP API 한 번 호출로 즉시 폐기할 수 있고, 그 폐기가 다른 에이전트에 영향을 주지 않는 상태 — 이게 다중 에이전트 시대의 최소 운영 토대입니다. AI 에이전트 신원 분리는 도구의 선택이 아니라 운영의 기본 단위를 배포에서 신원으로 옮기는 결정입니다. 시스템 레벨 통제가 사람 레벨 통제보다 우선한다는 원칙은 피싱 모의훈련을 시스템으로 대체하는 설계에서도 같은 결론으로 이어집니다.

    지금 바로 해볼 것

    • IdP 콘솔에서 현재 에이전트가 공유 중인 서비스 계정 수와 에이전트 수를 카운트한다. 비율이 1:5 이상이면 신원 분리를 분기 우선순위로 등록한다.
    • 가장 권한이 넓은 공유 계정 하나를 골라 에이전트 호출 로그를 7일치 추출하고, 그 권한이 실제 어떤 리소스에 쓰이는지 분류한다. 쓰지 않는 권한이 30% 이상이면 즉시 회수 대상이다.
    • Vault 또는 AWS Secrets Manager에 동적 시크릿 엔드포인트를 하나 만들고, 가장 빈도가 높은 에이전트 한 개를 정적 키에서 동적 토큰으로 교체한다. TTL은 30분~2시간으로 시작한다.
    • IdP API를 호출하는 폐기 스크립트를 한 개 작성한다. az ad app delete --id <app-object-id> 같은 명령으로 폐기 → SIEM 반영까지 걸리는 시간을 측정한다.
    • 감사 로그에 에이전트 ID 필드가 남는지 확인하고, 없다면 로그 파이프라인을 보강한다. 대부분의 클라우드 SIEM은 에이전트 단위 ID를 기본 필드로 받지 않으므로 명시적 태깅이 필요하다.

    자주 묻는 질문

    에이전트가 3~4개 수준인데 지금 바로 신원 분리를 해야 하나요?

    규모가 작아서 당장 도입하지 않아도 운영에 지장은 없지만, 에이전트 추가는 인프라 비용보다 빠르게 진행되는 경향이 있습니다. 지금 신원 분리를 적용하면 나중에 마이그레이션 비용이 들지 않습니다. 5개를 기준으로 분리 도입을 검토하는 것이 현실적입니다.

    기존 공유 계정을 한 번에 분리하면 다른 에이전트가 멈추지 않나요?

    동시에 전환하지 말고 에이전트 단위로 점진적으로 분리합니다. 한 에이전트를 새 신원으로 이전한 뒤 호출 로그가 정상임을 확인하고 다음 에이전트로 넘어가는 방식이 안전합니다. 일괄 전환은 권장하지 않습니다.

    멀티 클라우드 환경에서 SPIFFE/SPIRE 도입 비용이 부담됩니다.

    소규모 멀티 클라우드라면 클라우드별 Managed Identity 조합이 도입 비용이 더 낮습니다. SPIFFE는 에이전트 수가 수십 개를 넘어가고 IdP 종속성을 줄여야 할 때 도입 효과가 커집니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/AskNetsec — Best way to give AI agents their own identity instead of sharing service accounts in 2026?

  • 미스트랄 라지4(르 숑크) 프리뷰, 1.05T MoE로 만든 가격과 거부 없는 보안 옵션

    미스트랄 라지4(르 숑크) 프리뷰, 1.05T MoE로 만든 가격과 거부 없는 보안 옵션

    핵심 요약

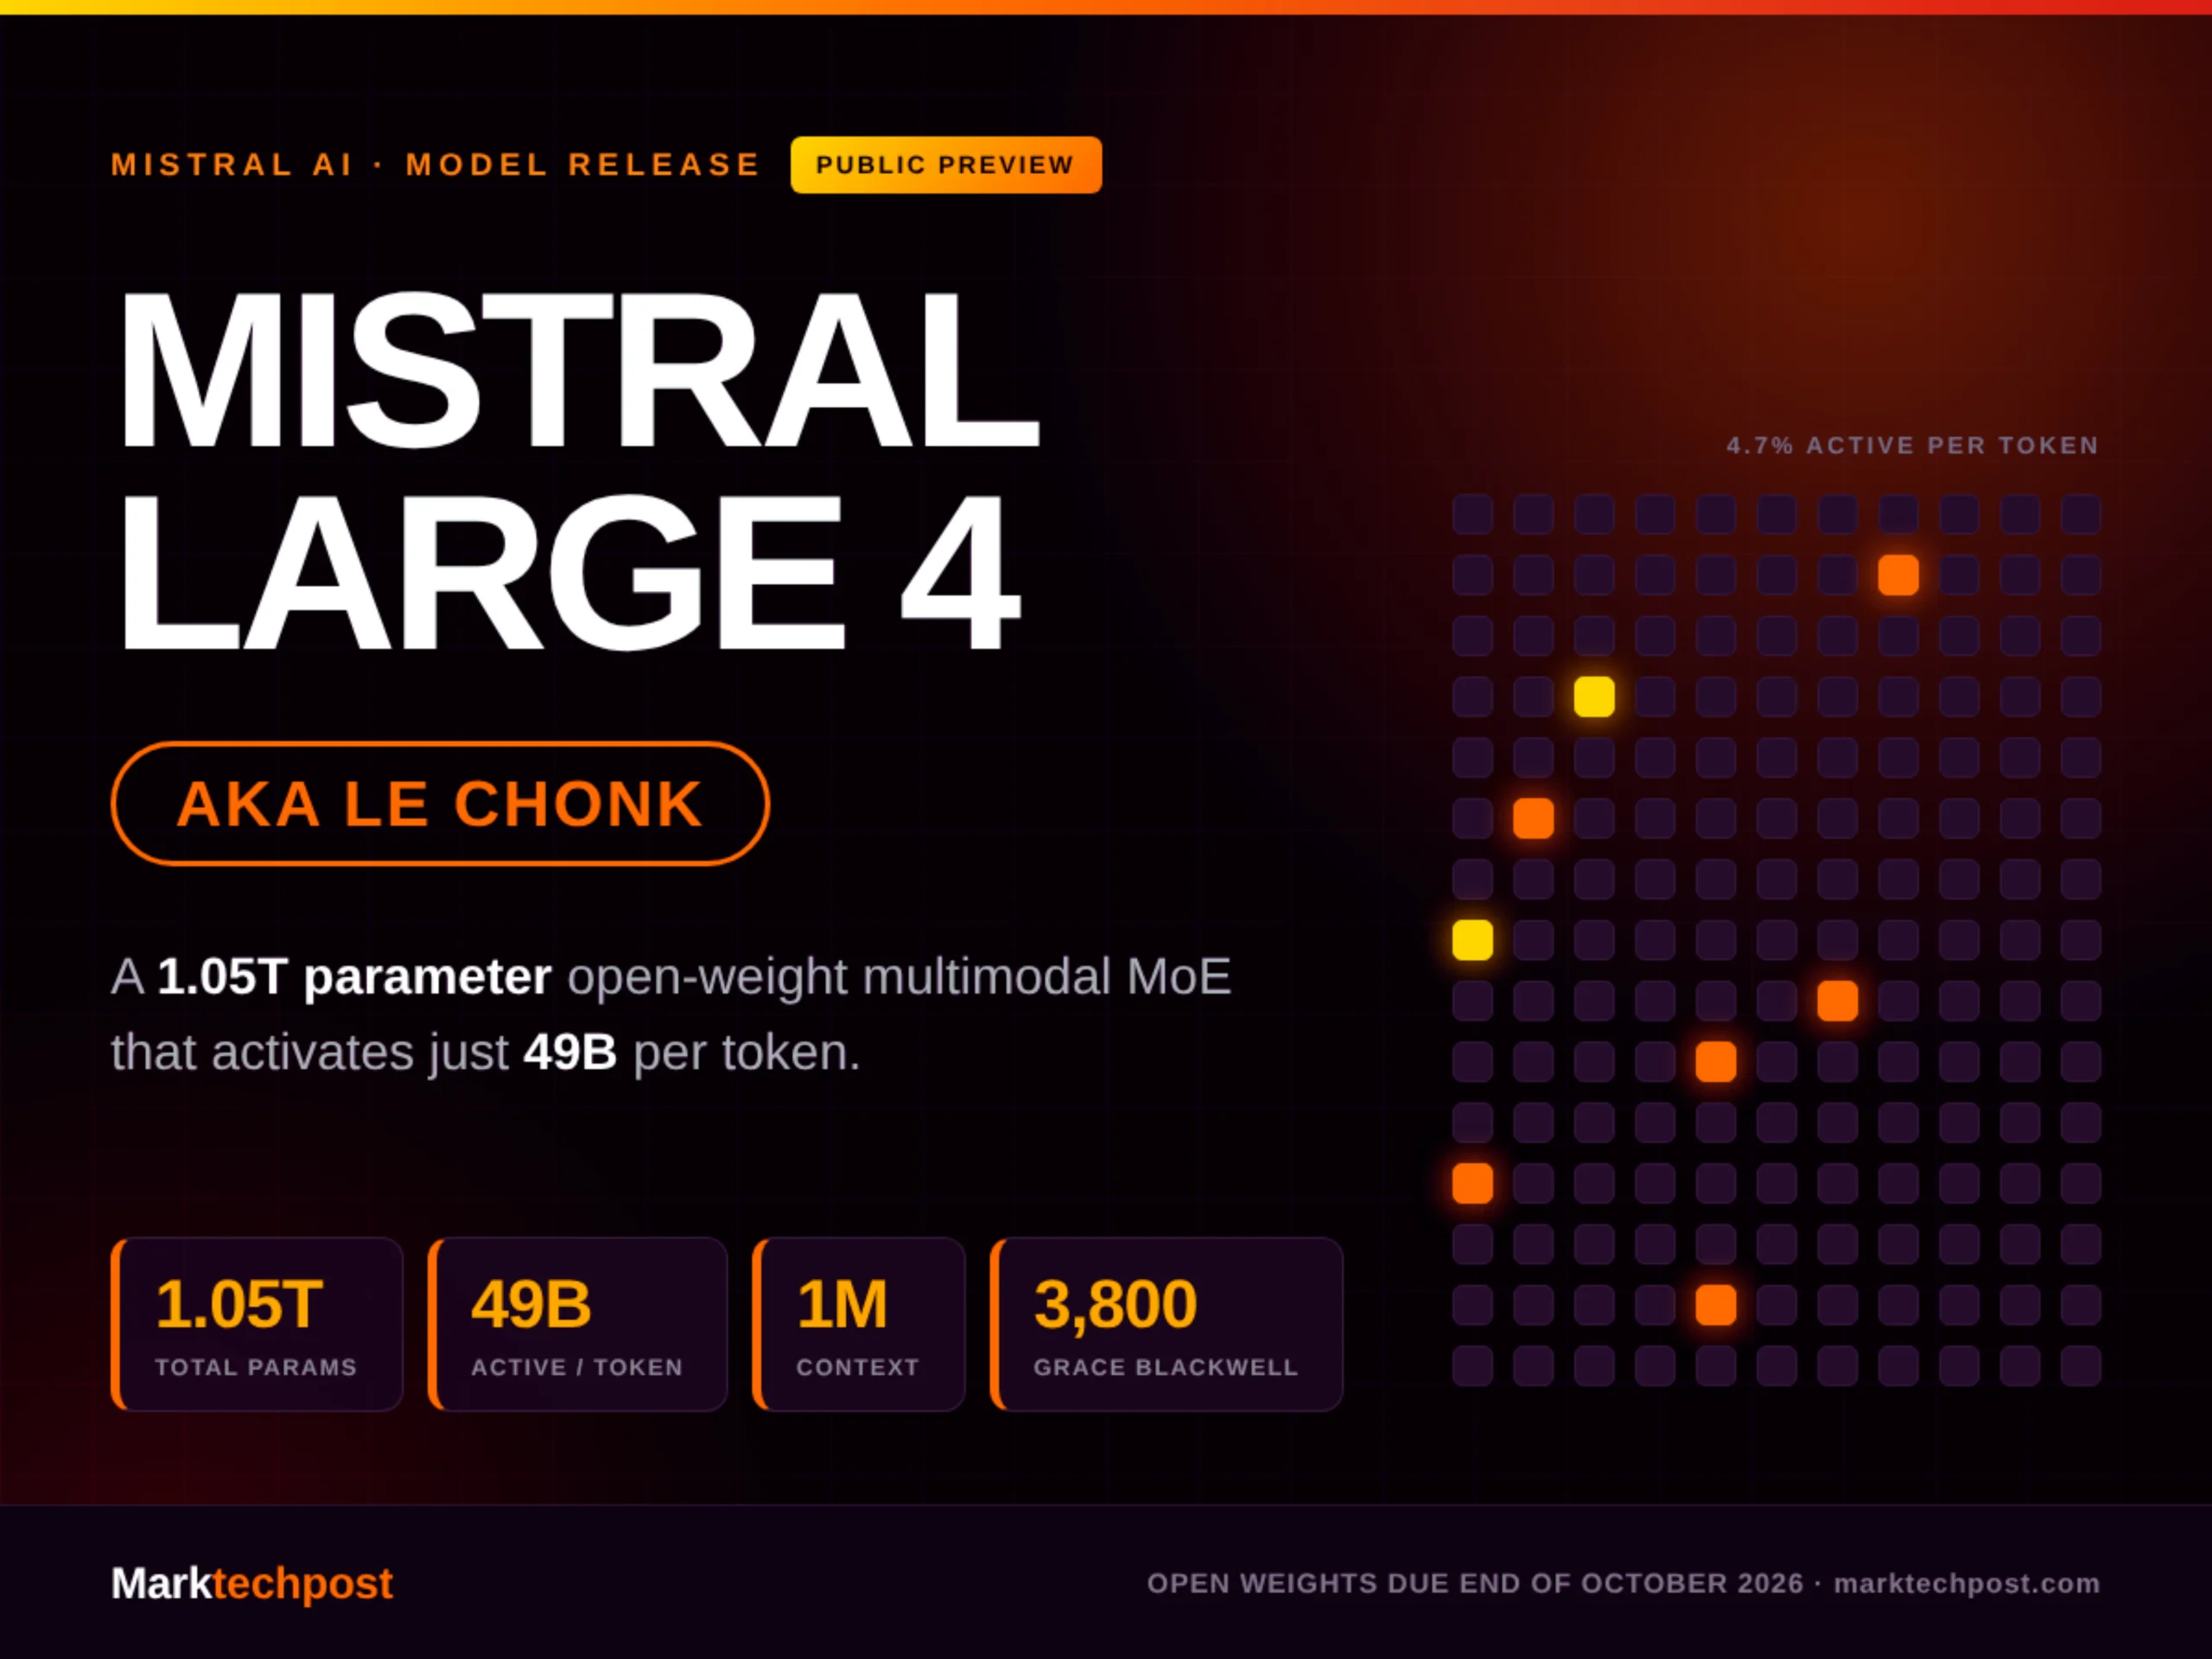
    • Mistral AI는 2026년 10월 6일 Mistral Large 4(내부 별명 Le Chonk)를 공개 프리뷰로 출시했으며, 1.05T 총 파라미터와 토큰당 49B 활성 파라미터(전체의 약 4.7%), 1.6B 파라미터 비전 인코더, 1M 토큰 컨텍스트 윈도우를 갖춘 그래뉼러 MoE 모델임
    • 학습은 Mistral의 유럽 내 자체 데이터센터에서 3,800개 NVIDIA Grace Blackwell GPU를 사용해 처음부터 진행됐으며 학습 데이터는 160개 이상 언어를 포괄하고 공식 EU 언어를 모두 포함함
    • 공개 시점에는 API만 즉시 이용 가능하고 가중치는 2026년 10월 말까지 공개될 예정이라 셀프 호스팅은 불가함. 입력 $1.36, 출력 $4.18, 캐시 입력 $0.14 per 1M 토큰으로 책정됨

    Mistral Large 4는 토큰당 4.7%만 활성화하는 그래뉼러 MoE 설계를 통해 1조 파라미터급 모델을 중간 가격대 API로 서비스하는 구조적 해법을 제시했고, 폐쇄형 프론티어 모델들이 task refusal로 사실상 점수가 0에 가까운 사이버보안 작업에서 정당화 가능한 우위를 확보했다는 점에서 실무자에게 의미 있는 선택지가 됨

    목차

    공개 배경과 한 줄 요약

    2026년 10월 6일, Mistral AI는 공개 프리뷰 형태의 새로운 플래그십 모델 미스트랄 라지4(Mistral Large 4, 내부 별명 Le Chonk)를 API로 먼저 노출했다. 총 1.05T 파라미터, 토큰당 49B 활성 파라미터(전체의 약 4.7%), 1.6B 파라미터 비전 인코더, 1M 토큰 컨텍스트 윈도우를 갖춘 그래뉼러 MoE 멀티모달 모델이다. 학습은 유럽 내 Mistral 자체 데이터센터에서 NVIDIA Grace Blackwell GPU 3,800장을 묶어 처음부터 진행됐으며, 학습 데이터는 160개 이상 언어를 포괄하고 EU 공용어를 전부 포함한다.

    필자가 현업에서 모델 카드를 읽을 때 가장 먼저 보는 항목이 학습 인프라와 데이터 출처인데, Grace Blackwell 3,800장이라는 스케일은 Mistral이 단순히 프롬프트 엔지니어링용으로 만든 모델이 아니라 1조급 weight를 처음부터 학습한 모델임을 시사한다. 같은 시기에 공개된 올모코어3의 스파스 학습 스택 분석 사례와 나란히 놓으면, 이 모델이 유럽에서 독자적으로 굴릴 수 있는 학습 역량을 갖췄다는 사실 자체가 모델 시장 구조의 변화 신호로 읽힌다.

    아키텍처 — 그래뉼러 MoE가 가격을 만드는 방식

    이 모델의 핵심은 1.05T라는 거대한 메모리 풀이면서도 토큰당 49B만 활성화해 추론 비용을 중간 티어로 끌어내렸다는 점이다. 일반적인 dense 1T 모델은 모든 파라미터를 매 토큰에 동원하므로 입력 1M 토큰당 단가 책정이 사실상 불가능에 가깝다. 반면 그래뉼러 MoE는 라우터가 토큰별로 소수의 expert를 선택하기 때문에 컴퓨트(49B)와 메모리 점유(1.05T)가 분리된다. Mistral이 입력 $1.36, 출력 $4.18 per 1M 토큰이라는 가격을 공개할 수 있었던 배경이 바로 이 분리 구조다.

    다만 전문가 수, top-k 라우팅, 레이어 레이아웃 같은 세부 제원은 가중치 공개(2026년 10월 말 예정) 시점까지 비공개로 유지된다. 운영 관점에서 이 차이는 작아 보이지만, 가중치가 풀려도 라우터 동작과 expert 편중을 독립 검증하려면 라우팅 로그를 별도로 적재해 두는 것이 안전하다. 라우팅 분포가 한쪽 expert로 몰리는 현상은 throughput은 정상으로 보이는데 특정 expert의 응답만 품질이 들쭉날쭉해지는 형태로 나타나기 쉽고, 사후 디버깅 비용이 매우 비싸다.

    비전 인코더는 1.6B 파라미터로 분리돼 네이티브 이미지 입력을 받는다. 별도 멀티모달 어댑터를 붙이지 않고도 텍스트·이미지를 단일 모델이 처리하기 때문에 RAG 파이프라인에서 OCR 단계를 거치지 않고 문서 QnA를 구성할 수 있다. 다만 비전 토큰이 컨텍스트 1M 안에 함께 잡히는지, 아니면 별도 슬라이스가 있는지는 모델 카드 본문으로 확인이 필요하다(공개된 자료만으로는 단정하기 어렵다).

    API 가격과 즉시 사용 가능 범위

    공개 시점 API 가격은 입력 $1.36, 출력 $4.18, 캐시 입력 $0.14 per 1M 토큰이다. 1M 컨텍스트 풀 윈도우를 매 호출마다 새로 결제하지 않고 캐시된 prefix를 $0.14/1M로 재사용할 수 있다는 점은 에이전트 루프에서 단가를 결정적으로 낮춘다. 매 턴마다 800K 토큰짜리 코드베이스와 대화 이력을 함께 넘기는 코딩 에이전트는 캐시 가격이 전체 비용의 70% 이상을 좌우하기 때문이다.

    API 스펙은 함수 호출, 구조화 출력(JSON Schema 강제), 문서 QnA, 배치 처리, 그리고 Agents·Conversations 엔드포인트를 한 API 키로 묶어서 제공한다. 즉시 가능한 통합 흐름은 다음과 같다.

    curl -s https://api.mistral.ai/v1/chat/completions \
      -H "Authorization: Bearer $MISTRAL_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "mistral-large-4",
        "messages": [
          {"role":"system","content":"You are a SOC analyst."},
          {"role":"user","content":"Summarize the last 24h of alerts."}
        ],
        "tools": [{"type":"function","function":{
          "name":"open_ticket",
          "parameters":{"type":"object","properties":{
            "severity":{"type":"string","enum":["low","med","high","crit"]},
            "cve":{"type":"string"}},
            "required":["severity"]}}}],
        "response_format":{"type":"json_schema","json_schema":{"name":"alert","schema":{...}}}
      }'

    위 호출에서 response_format으로 JSON Schema를 강제하면 파이프라인 다운스트림에서 Pydantic 모델로 바로 검증할 수 있어, 후속 Airflow/Dagster 태스크로 그대로 흘려보내기 좋다. 다만 셀프 호스팅은 10월 말 가중치 공개 전까지 막혀 있으므로 API 종속성을 처음부터 인정하고 리전별 failover 경로를 확보해 두는 편이 운영상 안전하다.

    사이버보안 성능과 폐쇄형 모델의 task refusal

    Cybench 93%, CyberGym-E2E 82%를 기록해 Artificial Analysis Cyber Index 글로벌 톱5에 진입했다. Mistral은 이 결과를 근거로 일부 폐쇄형 프론티어 모델들이 exploit PoC나 권한 상승 코드를 생성해 달라는 요청에서 task refusal로 점수가 사실상 0에 가깝다고 명시했다. 실무에서 가장 흔히 놓치는 함정은, 보안 자동화 에이전트에서 LLM이 정당한 payload 생성을 거절하면 그 뒤 단계인 exploit 검증, 로그 분석, IOC 추출까지 연쇄적으로 멈춘다는 점이다.

    운영 환경에서 이 갭이 체감되는 지점은 멀웨어 샌드박스 자동 트리아지다. Cuckoo Sandbox 결과를 받아 디코딩된 페이로드를 요약하고 YARA 룰 후보를 뽑는 워크플로우에서 모델이 응답을 거부하면 룰 생성 단계가 비어 버려 결국 사람이 직접 룰을 짜게 된다. 정당한 분석 결과를 거부 없이 제공할 수 있다는 점은 SOC 운영 비용에 직접 영향을 준다. 다만 가중치 공개 전까지는 동일 시나리오에서 API 모드와 셀프 호스팅 모드의 출력 차이가 존재할 수 있으므로, 보안 정책상 폐쇄망 배포가 필수인 조직은 가중치 공개 일정을 검토 체크포인트에 박아 두는 것이 좋다.

    코딩·일반 품질과 재현성 이슈

    에이전틱 코딩 벤치마크에서 DeepSWE v1.1 61.7%, SWE-Atlas-QnA 59.4%, Terminal-Bench 4.0 28.3%를 기록했고, 이를 묶은 Artificial Analysis Coding Agent Index는 49.8%다. Surge AI 블라인드 인간 평가에서는 5점 만점에 3.74로 5개 모델 중 2위를 차지해 Claude Opus 5(4.22) 뒤, GLM-5.3(3.60)과 Kimi K3(3.59) 앞선 위치를 보였다. 코딩 에이전트 하네스 측면에서 같은 매체에서 다룬 엔비디아 SoL-Pi 하네스 4종 정밀 해부와 비교하면, 이 모델이 하네스 단에서 토큰을 절약하기보다 모델 자체의 코드 이해 능력에 방점을 두고 있음을 짐작할 수 있다. 반대로 말하면 코딩 에이전트 토큰비를 우선시하는 팀이라면 모델 선택 이전에 하네스 최적화를 먼저 보는 편이 효과적일 수 있다.

    벤치마크 미스트랄 라지4(Le Chonk) 작업 유형
    Cybench 93% 사이버보안 에이전트
    CyberGym-E2E 82% 취약점 분석 end-to-end
    DeepSWE v1.1 61.7% 에이전틱 코딩
    SWE-Atlas-QnA 59.4% 저장소 QnA
    Terminal-Bench 4.0 28.3% 터미널 작업
    Surge AI 블라인드 3.74 / 5 5개 모델 중 2위
    Lakera B3 93.3% 프롬프트 인젝션 저항

    다만 모든 수치는 사전 비공개 평가로 수집된 것이며 독립 재현은 가중치 공개 이후에나 가능하다는 점을 명심해야 한다. 운영팀이 벤치마크 수치만 보고 도구를 교체했다가 내부 레퍼런스 셋에서 다른 결과가 나오는 일은 흔하다. 첫 2주 동안은 기존 모델과 A/B 라우팅을 켜 두고 미스트랄 라지4 호출 비율을 점진적으로 끌어올리는 방어적 도입이 안전하다.

    안전성 지표와 비교군

    안전성 측면에서 Lakera B3 벤치마크에 93.3% 저항률을 기록했고, KORABench는 1.691 / 2.0을 받았다. 프롬프트 인젝션 저항률은 폐쇄형 프론티어 모델들과 비슷한 수준으로, 도구 호출형 에이전트에서 외부 페이로드가 섞이는 시나리오에 그대로 투입해도 1차 방어선 역할은 할 수 있다는 의미다. 다만 Lakera B3는 단일 벤치마크이므로, 운영 환경에서는 사내 RAG 데이터셋에서 별도의 인젝션 회귀 테스트를 돌려 보는 편이 신뢰도를 크게 올린다.

    아직 공개되지 않은 정보와 후속 일정

    전문가 수, top-k 라우팅, 레이어 레이아웃은 가중치 공개 시점에 풀릴 예정이다. 10월 말 공개 직후 커뮤니티에서 라우팅 편중, expert dropout, fine-tuning 안정성 등이 빠르게 보고될 가능성이 크고, 그 결과에 따라 셀프 호스팅 TCO가 결정된다. 1M 컨텍스트를 그대로 쓰는 대신 슬라이딩 윈도우나 hierarchical compression을 함께 적용할지, 캐시 prefix 만료 정책을 어떻게 둘지도 같은 시점에 정해 두는 것이 합리적이다. 미스트랄 라지4는 가격·성능·거부 정책 세 축에서 동시에 옵션을 넓혔고, 도입 여부의 결정은 이 세 축의 가중치를 조직이 어디에 두느냐에 따라 갈린다.

    지금 바로 해볼 것

    • Mistral 대시보드에서 API 키를 발급하고 curl로 response_format을 강제하는 문서 QnA 호출을 1회 돌려 토큰 단가를 측정한다.
    • 기존 SOC 페이로드 생성 워크로드 50건을 추출해 동일 프롬프트로 모델 응답 거부율을 카운트한다.
    • Airflow/Dagster에 모델 응답을 Pydantic으로 검증하는 태스크를 추가해 JSON Schema 강제 호출과 레거시 자유 출력 호출의 다운스트림 실패율을 비교한다.
    • 1M 컨텍스트 + 캐시 prefix 조합의 비용 시뮬레이션을 사내 가격표에 반영하고, 동일 입력 기준으로 기존 모델과 미스트랄 라지4의 1만 회 호출 단가를 역산한다.
    • 가중치 공개(10월 말) 일정에 맞춰 폐쇄망 PoC 슬롯을 예약하고, 라우팅 로그 적재와 expert 편중 모니터링 템플릿을 미리 작성한다.

    자주 묻는 질문

    가중치 공개 전이라도 사내 평가용으로 도입해도 되나?

    API 종속성을 수용할 수 있는 워크로드라면 즉시 도입해도 무방하다. 다만 평가 단계에서 API와 셀프 호스팅의 응답 편차가 생길 수 있으므로, 1차 도입 후 두 번째 스프린트에서 가중치 공개 일정과 함께 내부 회귀 테스트를 다시 돌려야 한다.

    사이버보안 워크로드의 refusal이 줄면 책임 소재는 어떻게 되나?

    모델이 거부해서 사고를 막아 주는 영역과, 거부 없이 응답해서 분석 파이프라인이 굴러가는 영역의 경계가 분명해진다. 운영팀은 refusal이 줄었을 때의 secondary safety net(예: Trivy로 생성 YARA 룰 정적 검증, Semgrep 룰로 PoC 코드 정적 스캔)을 명시적으로 설계해 두는 것이 안전하다.

    1M 컨텍스트 호출이 실패하면 비용이 어떻게 청구되나?

    공식 가격표상 캐시 prefix를 활용한 호출은 $0.14/1M로 청구되고, 컨텍스트 처리 실패는 일반 입력 단가($1.36/1M)로 정산된다. 트래픽 폭주 시 fail-open 정책이 적용될 수 있으므로, 비용 알람은 캐시 적중률과 실패율을 분리해서 걸어 두는 편이 운영상 안전하다.


    참조: MarkTechPost의 Mistral Large 4 (Le Chonk) 출시 보도

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Mistral AI Releases Mistral Large 4 (Le Chonk): A 1.05T Parameter Multimodal MoE Model

  • 패노메논 상표권 단독 출원과 대통령의 사과, JYP 박진영 증인 출석이 드러낸 5가지 쟁점

    패노메논 상표권 단독 출원과 대통령의 사과, JYP 박진영 증인 출석이 드러낸 5가지 쟁점

    핵심 요약

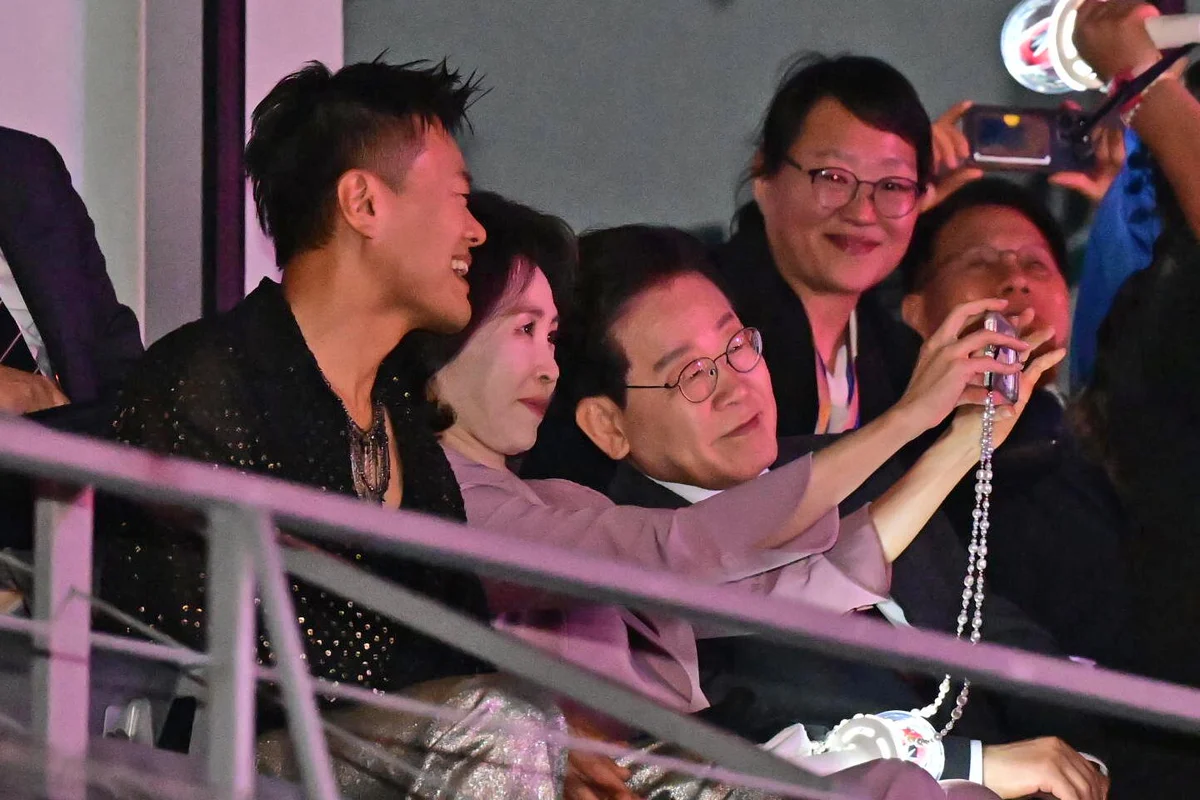
    • 박진영 대중문화교류위원회 공동위원장이 7일 문화체육관광부 대상 국회 국정감사에 증인으로 출석해 글로벌 K팝 축제 ‘패노메논’ 상표권 출원 관련 입장을 밝힌 것으로 확인됐다. 패노메논은 JYP엔터테인먼트 단독 명의로 출원됐으며, 야당(국민의힘) 배현진 의원은 지난 30일 페이스북에서 이를 ‘상표권 독점’이라 비판하며 ‘막대한 국민 세금으로 JYP 등 초대형 엔터사들의 수익을 보태자고 설계한 건가’라고 공개적으로 의문을 제기했다. 박 위원장은 6일 SBS 라디오 ‘김태현의 정치쇼’에 출연해 ‘공익 추구라는 목표를 세웠지만 실제 목적은 사익 추구가 아니냐는 진정성 의심을 받으면 너무 힘들어진다’며, 참고인은 선서 의무가 없어 위증죄 고발 가능성이 없는데도 증인으로 출석하겠다고 밝혔다. 이재명 대통령은 전날 X(구 트위터)에 ‘박 위원장에게 죄송하네요’, ‘보수도 없이 시간 내고 자비 지출해가며 대한민국 문화 수출을 위해 그렇게 애쓰고 계신데, 합당한 예우를 해 드리지 못해 못내 안타깝고 미안합니다’, ‘국민을 대신해 감사말씀 전합니다’라고 게시했다. 박진영 측은 보수가 있었다는 논란에 대해 ‘200만 원을 받는 줄 몰랐다’며 ‘당장 반납하고 싶지만…’이라고 해명한 것으로 보도됐다. MBC 보도에 따르면 이 대통령은 ‘예우를 못해 미안하다’며 ‘국민 대신해 감사’라는 취지로 발언했다. 박 위원장은 지난달 25일 멕시코시티 GNP 스타디움 스트레이키즈 콘서트에서 이 대통령·김혜경 여사와 기념촬영을 한 바 있다.

    공적 사업의 민간 위탁 구조에서는 상표권 귀속·보수 공개·위원회 거버넌스라는 세 가지 장치를 사업 착수 전에 설계해야 진정성 논란을 차단할 수 있으며, 대통령의 사과 메시지는 당사자 옹호로 읽혀 비판을 가중시킬 위험이 있음.

    목차

    7일 국회 문화체육관광부 국정감사에 JYP엔터테인먼트의 박진영 대표가 대중문화교류위원회 공동위원장 자격으로 증인 출석한 자리에서, 글로벌 K팝 축제 패노메논 상표권의 단독 출원 사실이 다시 도마 위에 올랐다. 같은 날 이재명 대통령이 X(구 트위터)에 ‘박 위원장에게 죄송하네요’라는 사과 글을 올린 데다, 보수 200만 원 수령 사실을 둘러싼 해명이 맞물리면서 쟁점은 단순 문화 외교를 넘어 공적-민간 협력 사업의 거버넌스 설계로 옮겨갔다. 필자가 정책 사업과 민간 위탁 협약을 추적해 본 바로는, 이런 종류의 진정성 의심은 사후 해명보다 사전 설계에서 80% 이상 차단된다.

    1. 패노메논 상표권이 발단이 된 이유

    ‘패노메논’은 JYP가 단독 명의로 출원한 글로벌 K팝 축제 브랜드다. 문체부가 추진하는 문화교류 사업에 자문과 현장 네트워크를 제공한 박 위원장이 자기 회사 명의로 상표를 선점한 구조는, 국민 세금이 투입되는 사업의 지적재산권(IP)이 특정 엔터사 자산으로 굳어진다는 인상을 준다. 배현진 국민의힘 의원은 지난 30일 페이스북에서 이를 ‘상표권 독점’이라 규정하고 ‘막대한 국민 세금으로 JYP 등 초대형 엔터사들 수익을 보태자고 설계한 건가’라고 공개 지적했다. 박 위원장 본인은 6일 SBS 라디오 ‘김태현의 정치쇼’에 출연해 “공익 추구라는 목표를 세웠지만 실제 목적은 사익 추구 아니냐는 진정성 의심을 받으면 너무 힘들어진다”고 토로했다.

    여기서 간과되는 기술적 디테일이 있다. 문화교류 사업의 상표권 귀속은 일반 사행위와 다르다. 정부 예산이 투입된 사업의 경우 한국저작권위원회·한국콘텐츠진흥원이 보유한 ‘공공 IP 풀(pool)’에 귀속시키고, 비독점 라이선스 형태로 사용료를 회수하는 방식을 실무에서 쓴다. 반면 패노메논 상표권은 사업 착수 단계에서부터 JYP 단독 명의로 출원돼 라이선스 조건, 재허용 권한, 상표 사용료 귀속 경로가 투명하게 공개되지 않은 상태다. 이런 구조는 야당의 ‘상표권 독점’ 프레임을 가능하게 하는 약점을 안고 시작된 셈이다.

    2. 참고인이 아니라 증인으로 자원한 전략

    국정감사 피감 대상이 아닌 박 위원장은 참고인으로 통보받았으나, 선서 의무가 없는 참고인 자격을 거부하고 증인 자격으로 자원 출석했다. 선서를 하면 위증죄 적용 가능성이 커지지만, 그만큼 진정성 의심을 스스로 불식하겠다는 의지 표명으로 읽힌다. 박 위원장은 6일 라디오 인터뷰에서 “참고인 출석은 위증죄 고발 가능성이 없는데도 증인으로 자원했다”고 직접 밝혔다.

    실무적으로 이 선택의 비용-편익은 명확하다. 위증 위험을 안고서라도 국회 무대에서 직접 해명해야 할 만큼, 야당의 ‘사익 추구’ 프레임이 브랜드 가치와 향후 사업 참여에 미치는 부정적 파급이 더 크다는 판단이다. 다만 참고인에서 증인으로의 전환은 법적으로 별도 의결이 필요하고, 야당 위원들이 증인 신분을 적극 활용해 추궁 강도를 높일 여지를 동시에 만든다.

    3. 대통령의 사과 메시지가 만든 양날의 효과

    이 대통령은 6일 X에 “박 위원장에게 죄송하네요”, “보수도 없이 시간 내고 자비 지출해가며 대한민국 문화 수출을 위해 그렇게 애쓰고 계신데, 합당한 예우를 해 드리지 못해 못내 안타깝고 미안합니다”, “국민을 대신해 감사말씀 전합니다”라고 게시했다. MBC 보도를 보면 이 대통령은 ‘예우를 못해 미안하다’는 취지로 발언한 것이 확인된다. 발단 자체는 지난달 25일 멕시코시티 GNP 스타디움 스트레이키즈 콘서트에서 이 대통령·김혜경 여사와 박 위원장이 함께 기념촬영한 데까지 거슬러 올라간다.

    그런데 대통령의 사과가 오히려 박 위원장에 대한 ‘특정 위원 옹호’로 읽히면서 야당 비판의 불을 지핀 측면이 있다. 정책 사업의 성과와 실패는 정치적 책임 소재와 직결되는데, 대통령이 특정 민간 인사에 대해 공식 채널에서 ‘죄송하다’고 표현한 것은 K-문화 수출 사업 전체에 대한 보편적 감사 행위로 환원되기 어렵다. 정치적 상징성이 강할수록 반대 진영의 해석 여지도 그만큼 커지는 게 보통이다.

    4. 보수 200만 원 해명이 노출한 위원회 운영의 불투명성

    JYP 측은 보수가 있었다는 논란에 대해 “200만 원 받는 줄 몰랐다”며 “당장 반납하고 싶지만…”이라고 해명한 것으로 보도됐다. 박 위원장이 보수가 없는 것처럼 묘사한 자비 지출 서사와, 실제로 200만 원을 수령한 사실이 충돌하면서 대중문화교류위원회의 보수·수당·교통비·활동비 공개 기준이 사실상 없다는 점이 드러났다. 필자가 현업에서 자주 목격하는 패턴은, 위원회 운영이 ‘겸임’ 형태로 돌아갈 때 이런 보수 인식 괴리가 거의 예외 없이 발생한다는 점이다.

    문화교류위원회 성격상 풀타임 사무국이 아닌 자문·협의 기구라면, 보수·교통비·활동비·회의 참석수당을 회의록과 함께 공개하는 기본 메커니즘이 필요하다. 한국행정연구원·국회 입법조사처 같은 정책 자문 기구의 운영 매뉴얼을 보면, 보수 지급 시점에 본인 서면 동의와 수령 확인서를 보관하도록 표준화돼 있다. 패노메논 사업에 이런 표준 절차가 적용됐는지 자체가 후속 쟁점이다.

    5. 향후 쟁점 5가지와 점검 항목

    이 사안에서 공적 사업과 민간 파트너십의 진정성을 가르는 다섯 가지 점검 항목이 도출된다. 첫째, 상표권 귀속 방식의 사전 설계다. 공공 IP 풀 귀속, 공동 명의, 비독점 라이선스 등 세 옵션 중 어느 것이 선택됐는지와 그 사유가 공개돼야 한다. 둘째, 보수·수당·활동비의 투명한 공개 기준이다.

    셋째, 참고인·증인 선택의 전략적 의미 분석이다. 넷째, 대통령 사과 메시지의 정책 사업에 대한 파급 효과 측정이다. 다섯째, 거버넌스 부재 문제다. 패노메논 축제의 의사결정 구조, 예산 운용, 수익 배분, 라이선스 조건을 사후 감사할 수 있는 장치가 부재하다는 지적이 제기됐다.

    특히 다섯 번째 항목은 다른 K-문화 정책 사업에도 그대로 적용되는 약점이다. 정부 예산이 투입되는 민간 위탁 사업의 경우, 한국재정정보원·e-나라지표 시스템에서 사업별 성과 지표와 수익 배분을 실시간 공개하는 방식이 표준으로 자리 잡아야 한다. 이 사안이 끝난 뒤 문체부가 문화교류 사업 표준 가이드라인을 공개하는지가 실제 점검 포인트가 될 것이다.

    함께 지켜볼 것

    • 박진영 위원장 증인 출석에서 ‘상표권 귀속 방식’과 ‘위원회 보수 공개 기준’에 대한 추가 해명이 나올지 여부
    • 문체부가 패노메논 축제의 예산 운용·수익 배분·라이선스 조건을 e-나라지표 또는 재정정보 공개시스템에 게시할지
    • 대통령 사과 메시지 이후 야당의 ‘정치적 책임’ 공세 강도와 이에 대한 여당 대응 프레임
    • 향후 K-문화 수출 사업이 공공 IP 풀 귀속 방식으로 전환되는지, 아니면 현행 단독 명의 출원 관행이 유지되는지
    • 대중문화교류위원회의 보수·수당·활동비 공개가 회의록·공공데이터로 표준화되는지

    자주 묻는 질문

    패노메논 상표권은 왜 JYP 단독 명의로 출원됐나요?

    현재 공개된 정보만으로는 정확한 사유가 확인되지 않습니다. 다만 일반적으로 글로벌 K팝 축제 브랜드를 민간이 단독 명의로 출원하는 구조는 지적재산권 관리 효율성 차원에서 선택되는 경우가 많습니다. 문제는 정부 예산이 투입된 사업의 IP가 특정 사단법인 자산으로 굳을 때 공익과 사익의 경계가 모호해진다는 비판이 제기된다는 점입니다.

    대통령이 민간 위원에 대해 사과한 것이 문제가 되는 이유는 무엇인가요?

    정책 사업의 성과와 실패는 정치적 책임 소재와 직결됩니다. 대통령이 특정 민간 인사에 대해 공식 채널에서 ‘죄송하다’고 표현하면, 그 인사에 대한 정치적 보호 또는 옹호로 해석될 여지가 생기고 반대 진영의 비판 강도를 높이는 양날의 효과를 만들 수 있습니다. 정책 차원의 보편적 감사 메시지로 환원되기 어렵다는 점에서 민감한 영역입니다.

    문화교류 사업에서 상표권 분쟁을 사전에 방지하려면 어떤 장치가 필요한가요?

    사업 착수 전 단계에서 (1) IP 귀속 주체(공공기관·공동·민간 단독) 결정, (2) 라이선스 조건과 재허용 권한 명문화, (3) 보수·수당·활동비 공개 기준 확립, (4) 사업 종료 후 IP 환류 조건, 네 가지를 협약서에 포함해야 합니다. 이는 한국저작권위원회와 한국콘텐츠진흥원의 표준 위탁 사업 가이드라인에서 이미 제시하는 절차입니다.

    이 사안은 대통령의 사과 게시까지 확대된 K-문화 수출 정책의 거버넌스 논란이다. 야당의 ‘상표권 독점’ 비판과 대통령의 ‘예우 미흡’ 사과가 충돌하는 양상은, 공적-민간 협력 사업이 사전에 어떤 점검 항목을 갖춰야 하는지를 다시 한번 드러낸 사례다. 다른 콘텐츠 영역의 진정성 논란 사례가 사업 구조 재설계로 연결된 흐름과 궤를 같이 한다. 박진영 측의 추가 해명과 문체부의 후속 조치가 어떻게 나오는지, 향후 2주 안이 첫 번째 관전 포인트다.

    원문 기사: 박진영 패노메논 상표권 출원 논란과 대통령 사과 메시지

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Google News 한국 — JYP 오늘 국감 증인 출석···이 대통령은 “안타깝고 미안해”

  • 사이버보안 공백 3중 진단: 해킹 사고 26% 증가에 제로트러스트 예산은 27% 깎였다

    사이버보안 공백 3중 진단: 해킹 사고 26% 증가에 제로트러스트 예산은 27% 깎였다

    핵심 요약

    • 해킹 사고 통계: 2023년 대비 침해사고 26%, 유출사고 45% 증가했음에도 정보보호 예산 비중은 감소 추세
    • 제로트러스트 예산 삭감: 차세대 보안 패러다임인 제로트러스트 관련 예산이 62억원에서 45억원으로 27% 이상 줄어듦
    • AI 안전예산 격차: AI 성능 인프라 예산 대비 안전 분야 예산이 274억원에 불과, 224대 1의 비율로 AI 위협 대비 투자 균형이 깨져 있음

    한국 사이버보안은 AI 위협의 고도화 속도보다 예산 배분·컨트롤타워·민간 책임성 세 축에서 모두 구조적 공백을 드러내고 있으며, 제로트러스트 전환과 AI 안전예산의 224대 1 불균형 해소를 동시에 추진하지 않으면 해킹 연쇄 사고가 산업 전반으로 번질 가능성이 높은 것으로 분석됨

    목차

    사이버보안 공백 3중 진단

    6일 국회 과학기술정보방송통신위원회 국정감사에서 최형두 의원이 “대한민국이 공격당하고 있다”고 말한 순간, 이 한 문장은 한국 사이버보안의 구조적 공백을 압축했다. 침해사고는 2023년 대비 26%, 유출사고는 45% 증가했지만 정보보호 예산 비중은 오히려 줄었다. 2026년 사이버보안 공백은 단순한 예산 부족이 아니라, 예산 배분·거버넌스·민간 책임성이라는 세 축이 동시에 무너진 결과다.

    숫자가 말하는 이중성: 사고는 늘고, 정보보호 예산은 줄었다

    해킹 통계는 명확하다. 2023년 대비 침해사고 26% 증가, 유출사고 45% 증가. 그런데 과학기술정보통신부 전체 예산에서 정보보호가 차지하는 비중은 감소 추세다. 공격 빈도와 방어 투자 사이의 괴리는 매년 벌어지고 있으며, 이 격차를 메우지 못하면 산업 전반으로 해킹 연쇄 사고가 번질 수밖에 없다.

    더 심각한 지표는 예산 배분의 비대칭이다. 차세대 보안 패러다임으로 꼽히는 제로트러스트 관련 예산이 62억원에서 45억원으로 27% 이상 삭감됐다. 동시에 AI 성능 인프라에는 수조원이 투입되는 반면 AI 안전 분야 예산은 274억원에 그쳐 224대 1이라는 비율이 만들어졌다. AI가 공격자의 무기가 되는 속도보다 안전한 AI를 만들려는 투자가 한참 뒤처진 것이다.

    예산 공백 1: 제로트러스트 도입은 멈추고, AI 안전은 외면당했다

    제로트러스트는 내부망을 신뢰하지 않고 모든 접근 요청을 검증하는 아키텍처다. 기존 VPN·방화벽 중심의 경계 보안이 정상 사용자의 자격증명을 탈취한 공격자에게 무력화된 현실을 반영한 대안이다. 예산이 62→45억으로 줄어든 것은 이 전환 자체를 포기하겠다는 신호로 읽힌다.

    현업에서 제로트러스트를 단계적으로 도입한다면 가장 먼저 손대야 할 것은 외부에서 내부 SaaS로 들어오는 경로다. Cloudflare Zero Trust의 WARP 클라이언트나 Pomerium, Teleport 같은 오픈소스 Identity-Aware Proxy를 파일 서버·관리 콘솔 앞에 얹고, Okta/Keycloak의 OIDC 인증과 짧은 TTL(예: 15분) 토큰을 묶는다. Pomerium의 config.yaml 기준으로 보면 policy 항목에 sub_rules: [“email.ends_with(‘@회사도메인’)”] 같은 화이트리스트와 ttl: “15m”을 명시하는 것이 출발점이다. 방화벽을 한꺼번에 철거하지 않고, “관리자 콘솔 → IAP” 구간만 우선 교체해 효과를 측정하는 편이 거버넌스를 설득하기 쉽다.

    AI 안전예산 274억원, 즉 224대 1의 격차는 단순 비교가 아니다. AI 모델 한 개가 만들어낼 수 있는 피해 반경이 사람의 실수와는 차원이 다르다는 점을 감안하면, 이 비율은 사실상 “AI로 인한 피해는 자비로 해결하라”는 메시지다. 과기정통부는 이 격차를 메우기 위해 12월 국가 AI 안전생태계 조성 마스터플랜을 발표하겠다고 예고했다.

    발표 시점이 12월인 이유는 단순하다. 사고는 이미 터졌고, 표준은 아직 없다. 마스터플랜이 만들어야 할 핵심은 모델 위험평가 표준, 레드팀 운영 가이드, 사고 대응 SLA 세 가지다.

    민간 책임 공백: 티빙 3954만 계정, 토스페이먼츠 영수증, 강남언니 22만 의료데이터

    국정감사 도마에 오른 민간 사고의 규모가 말해준다. 티빙은 3954만 개 계정과 소스코드 유출 사태에서 가상 서버를 통한 24GB 데이터 유출을 방치했고, 신고도 지연됐다. 토스페이먼츠는 결제 영수증 대량 유출, 강남언니는 22만 명분의 민감 의료 데이터가 빠져나갔으며 경영진이 국회에서 직접 과실을 인정했다. 같은 시기 한국전력 2만4000명 정보 유출, 정부24 침해사고, LG유플러스 해킹 은폐 의혹까지 겹쳤다.

    민감 데이터 유출이 반복되는 패턴을 보면, 책임 소재의 끝이 CSIRT나 보안팀에 머물지 않는다는 점이 드러난다. 가상 서버 1대에 24GB의 고객 데이터가 방치된다는 것은 데이터 거버넌스의 부재다. 데이터가 어디에 복제되어 있고, 누가 접근하며, 더 이상 쓰지 않는 사본은 언제 파기하는지 — 이 질문에 대한 답을 가진 조직이 거의 없다. 실질적으로는 데이터 카탈로그(DataHub, Amundsen) 도입, 사본 생성 시 자동 마스킹, S3/GCS 버킷의 lifecycle policy로 미사용 사본을 강제 만료시키는 흐름이 정답에 가깝다. 경영진이 “내부 정책”이 아니라 “자동화된 통제”로 묶여야 고의적 은폐와 단순 방치를 구분할 수 있다.

    위협 현실성 교차검증: BPF도어가 스팸스나이퍼로 위장해 6000개 한국 조직을 노렸다

    예산과 책임의 공백이 실제 위협과 어떻게 만나는지를 보여주는 사례가 있다. 래피드7 인텔리전스 보고에 따르면 BPF도어(BPFDoor)라 불리는 정교한 백도어가 정상 프로세스로 위장해 한국·대만 환경을 표적으로 삼아왔다. 특히 보안 업계에서 익숙한 지란지교시큐리티의 스팸스나이퍼 프로세스로 위장해 탐지를 우회한 정황이 포착됐다. 정상 프로세스로 위장한다는 것은 시그니처 기반 탐지가 사실상 무력화됨을 뜻한다. 보안뉴스의 BPF도어 분석에 따르면 한국 6000여 조직 환경에서 침투 시도가 관측된 만큼, 12월 마스터플랜 발표 전에 우선 메모리 기반 탐지 역량을 점검할 필요가 있다.

    이런 정상 프로세스 위장 백도어에 대응하려면 파일 해시 같은 정적 지표만으로는 부족하다. 메모리 상의 행위 — 비정상 포트 바인딩, 부모-자식 프로세스 관계, 실행 컨텍스트의 비일관성 — 를 따라가야 한다. EDR 단에서는 CrowdStrike Falcon, SentinelOne, 또는 오픈소스 영역에서는 Velociraptor + osquery 조합이 흔히 쓰인다. Velociraptor에서는 artifact를 다음과 같이 정의해 메모리상 listen port와 프로세스 트리를 함께 조회한다.

    name: Generic.Detection.AnomalousListen
    description: 비정상 포트 바인딩 프로세스 행위 탐지
    type: CLIENT
    sources:
      - queries:
          - |
            LET listenports <= SELECT Pid, Name, Address, Port
            FROM netstat()
            WHERE State = "LISTEN"
          - |
            SELECT Pid, Name, CommandLine, ParentName
            FROM pslist()
            WHERE Pid IN listenports.Pid
            AND Port NOT IN [80, 443, 22, 3389]
    

    이렇게 하면 정상 이름의 프로세스가 비정상 포트를 열고 있을 때 즉시 어노머럴리로 분류된다. BPF도어 류의 위협은 결국 “정상처럼 보이는 비정상”을 찾는 능력이 전부이며, 이 능력이 시그니처 대비 가격 대비 효율이 가장 좋은 통제다. 필자가 Incident Response로 다수 기업을 점검해본 경험상, 시그니처 기반 EDR만 깔려 있는 조직은 BPF도어·정상 프로세스 위장 백도어에 거의 무방비다. 메모리 상의 행위 상관관계를 보는 도구가 최소 하나는 붙어 있어야 현실적인 탐지가 가능하다.

    정부 대응 패키지: 5232억 증액, 4조7000억 프론티어 AI, 12월 마스터플랜

    정부는 2026년 관련 예산을 기존 3634억원에서 5232억원으로 증액하겠다고 약속했다. 여기에 사이버 안보 대응을 위한 4조7000억원 규모의 프론티어 AI 사업을 추가 추진 중이다. 수치만 보면 큰 폭의 증액이지만, AI 성능 인프라에 쏟아붓는 4조7000억과 274억의 AI 안전예산을 같은 자리에 놓고 보면 우선순위는 여전히 “능력” 쪽에 쏠려 있다. 국정감사 1차 출처 기사에서 발언 수치와 맥락을 확인할 수 있다.

    프론티어 AI 사업의 키 컨셉은 고성능 AI 모델 개발과 동시에 안전 연구를 의무화하는 것이다. 필자가 현업에서 겪어본 바로는, 안전 연구가 “나중에 끼워넣기”로 진행되면 모델 사양이 거의 동결된 뒤에 평가가 들어와 비용만 폭증하고 변경은 불가능한 상태가 된다. 정부 예산 배분도 같은 함정에 빠지지 않으려면, 프론티어 AI 예산 안에 안전 연구 비율을 명문화한 의무 항목(예: 10% 이상)을 박아둘 필요가 있다. 마스터플랜에 들어갈 레드팀 표준, 사고 통보 SLA, 사고 시 위약금·손해배상 거버넌스 — 이 세 가지가 동시에 못박히지 않으면 5232억은 또 다른 형태의 예산 공백이 된다.

    미해결 쟁점: 컨트롤타워 부재, LG유플러스 은폐 의혹, 5대 은행장 증인

    국정감사가 끝났다고 끝이 아니다. 첫째, 부처별로 분산된 사이버 안보 기능을 통합 조정할 단일 컨트롤타워가 여전히 부재하다. 해킹은 부처 경계를 모르는데 대응 조직은 행정부 경계 안에 갇혀 있다. 둘째, LG유플러스의 해킹 은폐 의혹은 통신사가 보안 사고를 얼마나 자발적으로 공개할 수 있는지를 시험대에 올렸다. 셋째, 국민의힘이 19일 정무위원회 금융감독원 국정감사에 KB·신한·하나·우리·NH농협 등 5대 시중은행장을 증인으로 신청했다. 티빙·토스페이먼츠·강남언니 사건의 후폭풍이 금융권으로 옮겨붙을지 주목된다.

    해외 사례를 보면, 사이버 사고는 보통 한 산업에서 터져 다른 산업으로 번진다. 2017년 에퀴팩스 신용정보 유출이 미국 금융 전반의 KYC 절차를 재설계하게 만든 흐름, 2020년 솔라윈즈 오리온 해킹이 미 행정부 공급망 전반의 SBOM 채택을 끌어올린 사례가 그 예다. 한국도 이번 해킹 연쇄 사고가 산업 전반의 SBOM 도입, 사고 통보 표준, 관리자 자격증명 로테이션 같은 실질 변화로 이어지지 않으면, 1년 뒤 비슷한 국정감사가 다시 열릴 가능성이 높다.

    쟁점 정리

    • 2026년 예산 5232억 증액과 4조7000억 프론티어 AI 사업이 동시에 추진되는데, AI 안전예산은 274억원에 불과해 224대 1의 격차는 메워지지 않았다.
    • 제로트러스트 예산이 62→45억으로 27% 삭감된 것은 차세대 보안 패러다임으로의 전환 자체를 늦추는 결정이다.
    • 범정부 사이버안보 컨트롤타워 부재, LG유플러스 은폐 의혹, 5대 시중은행장 증인 출석은 19일 금융감독원 국정감사에서 가시화된다.
    • BPF도어 같은 정상 프로세스 위장 백도어는 시그니처 기반 탐지를 무력화시키며, 메모리·행위 기반 EDR 도입을 사실상 필수로 만들었다.

    자주 묻는 질문

    제로트러스트를 도입하려면 레거시 방화벽을 다 철거해야 하나요?

    그렇지 않다. 외부에서 들어오는 관리자 트래픽 구간만 먼저 IAP(Cloudflare Access, Pomerium 등)로 교체하고, 트래픽 로그와 접근 패턴을 3개월 이상 관찰한 뒤 단계적으로 확장하는 편이 비용·조직 설득 모두에서 현실적이다. 레거시 방화벽은 내부 구간 통제용으로 남겨도 무방하다.

    BPF도어 같은 정상 프로세스 위장 백도어를 시그니처로 막을 수 있나요?

    차단 자체는 어렵다. 대신 EDR에서 메모리상의 비정상 포트 바인딩, 부모-자식 프로세스 관계, 로드된 BPF 프로그램 목록(osquery의 process_open_sockets, bpf_programs 테이블)을 정기 조회해 어노머럴리로 분류하는 흐름이 표준이다. 핵심은 시그니처가 아니라 행위 패턴이다.

    민감 데이터 유출을 막으려면 어떤 통제부터 손대야 하나요?

    데이터 카탈로그로 사본 위치를 가시화한 뒤, S3·GCS 버킷의 lifecycle policy로 미사용 사본을 강제 만료시키고, KMS·Vault 기반 토큰화로 본 데이터 자체가 빠져도 쓸모없게 만드는 순서가 효과적이다. 정책 문서보다 자동화된 통제를 먼저 깔아야 방치가 줄어든다.

    2026년 사이버보안 공백은 한 가지로 좁혀지지 않는다. 예산이 모자란 것도, 컨트롤타워가 없는 것도, 민간 책임이 약한 것도 — 세 축이 동시에 흔들리기 때문에 해킹 연쇄 사고가 산업 전반으로 번지는 시나리오가 현실화되고 있다. 12월 마스터플랜이 이 세 축을 동시에 못박는지가 향후 1년의 분기점이 될 것이다.

    이 글은 시트릭스 넷스케일러 RCE 제로데이 2건, 실환경 익스플로잇 확인 — 5가지 즉시 대응 포인트와 PEEP 백도어 5가지 위험 — 브라우저 확장 프로그램으로 위장한 공격의 작동 원리 글과 함께 읽으면 백도어·제로데이 대응 맥락이 맞물린다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: 보안뉴스 — “대한민국이 공격당하고 있다”… 국정감사 달군 사이버보안 공백

  • OpenAI 수학 722편 일괄 공개…AGMAI 권고가 다시 꺼낸 ‘검증 인프라’ 쟁점

    OpenAI 수학 722편 일괄 공개…AGMAI 권고가 다시 꺼낸 ‘검증 인프라’ 쟁점

    핵심 요약

    • OpenAI는 미공개 최첨단(frontier) 모델이 생성한 수학 결과를 722편의 논문, 372개의 결과 패밀리 묶음으로 한꺼번에 공개했다.
    • 동사는 9월에 ‘100개 이상의 장기 미해결 문제를 해결했다’고 먼저 예고했으며, 이번에 논문·추론 요약·시도 통계·컴퓨트 추정치를 함께 공개했다.
    • 회사 측 설명에 따르면 평균 결과 1건당 ChatGPT Pro 사고 시간 약 3시간에 해당하는 컴퓨트가 투입된 것으로 집계됐다.

    AI 연구소들이 수학 분야에서 수백 건의 결과를 쏟아내는 속도에 비해, 학술 공동체가 이를 검증·소화하고 윤리적 권리를 정당하게 분배하는 절차와 인프라가 따라가지 못하고 있으며, AGMAI 권고는 이 속도 불일치를 메우기 위한 사실상 표준안으로 자리 잡을 가능성이 높다.

    목차

    OpenAI 수학 722편 일괄 공개

    OpenAI가 미공개 프론티어 모델로 생성한 수학 결과를 한꺼번에 풀어놓았다. 9월 초 “장기 미해결 문제 100건 이상을 해결했다”고 먼저 예고했던 회사는 722편의 논문과 372개의 결과 패밀리 묶음을 GitHub 저장소에 함께 올렸고, 1건당 평균 ChatGPT Pro 사고 시간 약 3시간에 해당하는 컴퓨트가 투입된 것으로 집계됐다. 이번 OpenAI 수학 공개는 단순한 결과 발표가 아니라, 결과를 둘러싼 절차의 부재라는 더 큰 문제를 수면 위로 끌어올렸다.

    같은 시각에 신설된 AGMAI(Advisory Group on Mathematics and Artificial Intelligence)는 첫 권고를 통해 “모델명·프롬프트·컴퓨트 비용 등 투명한 정보 공개”, “확립된 학술 채널 경유”, “수학 결과를 모델 마케팅 수단으로 사용하지 말 것”이라는 세 기준을 제시했다. AI 연구소가 쏟아내는 결과물과 학계가 이를 검증·소화하는 속도 사이의 불일치는 오래전부터 지적됐지만, AGMAI 권고는 사실상 표준안으로 기능할 가능성이 크다.

    GitHub 기반 학술 출판의 실무적 의미

    GitHub 저장소에 722편을 올린 행위는 단순한 배포 채널 선택이 아니다. 논문 수정(revision)·인용(citation) 절차를 코드 버전 관리와 동일한 흐름으로 묶겠다는 의도다. arXiv 같은 기존 학술 채널의 빠른 배포 속도와, Git이 제공하는 코드·데이터 버전 관리의 장점을 결합하려는 시도다. 다만 AGMAI가 “확립된 학술 채널 우선 사용”을 명시적으로 요구하고 있어, GitHub 단독은 과도기적 출판 채널임을 회사 측도 사실상 인정한 셈이다.

    이 흐름에서 실무적으로 가장 중요한 것은 메타데이터 스키마다. 필자가 현업에서 문서 관리 시스템을 다루어본 바로는, 논문 1편당 모델명·버전 해시·프롬프트 해시·총 컴퓨트(예: H100-시간)·검증 환경(Lean 버전, kernel commit) 같은 필드를 표준화해 두지 않으면, 1년 뒤에 그 결과를 재현하거나 인용 그래프에 태우기가 거의 불가능하다. OpenAI는 추론 요약·시도 통계·컴퓨트 추정치를 함께 공개했지만, 이 필드가 어떤 키값으로 고정될지는 아직 정해지지 않았다. AGMAI가 “투명한 정보 공개”를 구체적인 메타데이터 규약으로 좁혀놓지 않으면, 회사가 자의적으로 채운 표는 검증 가능한 표가 아니다.

    독립 자문 기구의 권한과 한계

    AGMAI는 AI 연구소의 결과 공개를 외부 수학자들이 검토·권고할 수 있게 만든 독립 어드바이저리다. 모델·프롬프트·컴퓨트 공개, 학술 채널 경유, 마케팅화 금지 등 권고는 사실상 “AI 수학 결과 공개 표준안”으로 기능할 가능성이 크고, Anthropic 등 경쟁 AI 연구소에도 디폴트 표준으로 확산될 여지가 충분하다. 오픈AI 수학 자문그룹 출범과 그 3가지 권한 한계는 이미 별도로 다룬 바 있다.

    다만 자문 기구의 권한은 어디까지나 권고에 그친다. AGMAI는 회사의 공개 방식에 대해 veto 권한이 없고, 권고 미준수 시 제재 수단이 없다. 이런 구조적 한계는 자문 그룹 자체의 권한을 법·계약·표준화 조직으로 이양하지 않는 한 사라지지 않는다. 기존 학술 출판계가 가진 peer review 강제력·저작권 라이선스·인용 그래프 반영 같은 인센티브 구조가 AI 연구소에는 아직 작동하지 않기 때문이다.

    밀레니엄 Prize급 문제와 형식 검증

    공개된 결과군에는 밀레니엄 Prize 수준의 최상위 난제를 포함한 사례가 포함돼 있다. 단순 공개 문제와 달리, Clay 수학연구소가 수십 년간 검증해온 표준이 있는 문제들이다. AI가 제시한 증명이 채택되려면 Lean·Coq·Isabelle 같은 형식 검증(formal verification) 도구로 다시 쓰여야 하거나, 동료 심사 기반의 추가 검증 절차가 필요하다. 이 과정이 자동화되지 않는 한 발표에서 검증 사이의 지연은 불가피하며, 그 지연 동안 잘못된 증명이 커뮤니티에 유통될 위험도 함께 커진다.

    특히 1건당 평균 3시간의 사고 시간을 투입해 얻은 결과라 해도, 형식 검증 단계 없이 “해결”이라는 단어를 마케팅에 끌어다 쓰면 안 된다는 점은 AGMAI의 가장 단호한 권고 중 하나다. AI 산출물은 수학자 커뮤니티의 인용 그래프에 들어가기 전까지 사실상 가설에 머문다는 원칙이, 권고의 뼈대다.

    학계의 양가적 반응과 공헌 인정 문제

    학술 공동체의 반응은 결과의 임팩트와 절차의 정당성 사이에서 갈라진다. 어떤 반응은 수학 사상 처음 AI가 이 정도 규모의 결과군을 인간 검증 없이 제출했다는 놀라움에 집중하고, 다른 목소리는 기존 수학자들이 수십 년간 쌓아온 학습 데이터와 이론 체계가 없었다면 불가능한 결과라며 공헌 인정 문제를 제기한다. AI가 학습한 모든 정리는 결국 과거 논문에서 왔고, 그 논문의 저자에게는 어떤 권리도 돌아가지 않는다는 불만이 권고안 곳곳에 배어 있다.

    The Verge 보도에 따르면 이번 공개에 대해 학계는 “결과 자체의 임팩트와 별개로, 연구 윤리·학술 관행·기존 수학자 연구가 AI 시스템 학습에 기여한 만큼의 공헌 인정 문제”를 놓고 격렬한 논쟁을 벌이고 있다(The Verge 원문). 이 논쟁은 “AI가 수학을 잘하느냐”를 넘어, “AI가 만들어낸 결과의 권리가 누구에게 있느냐”는 정당성 문제로 이어진다.

    쟁점 정리

    • 결과 검증 속도 격차: AI가 수백 건을 한꺼번에 제출하는 속도와 인간·형식 검증 도구가 이를 받아 소화하는 속도 사이의 격차는 메워지지 않고 있다.
    • 마케팅 vs. 학술: “미해결 문제 해결”이라는 표현이 모델 브랜딩에 그대로 흡수되는 현상은 AGMAI 권고의 핵심 타깃이다.
    • 공헌 인정: AI 학습 데이터에 기여한 수학자들의 권리를 어떻게 인정·환원할 것인가는 표준화 이전에 풀어야 할 정당성 문제다.
    • 자문 기구의 권한: 권고에 veto·제재 수단이 결합되지 않으면 사실상 표준안으로 남기 어렵다.
    • 검증 도구 격차: Lean·Coq 같은 형식 검증 환경은 충분한 인력이 뒷받침돼야 실제 도입이 가능하다.

    자주 묻는 질문

    일반 연구자도 OpenAI가 공개한 722편에 직접 PR을 보내 검토를 요청할 수 있나요?

    GitHub 저장소에 이슈·PR 프로토콜이 마련돼 있어 접근 자체는 열려 있다. 다만 peer review 강제력은 없으므로, 중요한 결과는 Lean·Coq 같은 형식 검증 환경으로 직접 옮겨보는 편이 신뢰성 확보에 유리하다.

    AGMAI 권고가 다른 AI 회사에도 강제되나요?

    권고는 법적 강제력이 없다. 다만 학술 인용 그래프·형식 검증 커뮤니티·학술 채널 선호라는 인센티브가 결합되면서 사실상 디폴트 표준으로 굳어질 가능성이 높다.

    형식 검증 도구(Lean·Coq)는 일반 수학자에게 접근 가능한가?

    Lean 4와 mathlib는 진입 장벽이 빠르게 낮아지고 있다. 하지만 1편당 수십~수백 줄의 형식화를 수동으로 작성해야 하는 부담이 남아 있어, 자동 보조 도구의 성숙도가 관건이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: The Verge — OpenAI drops another batch of mathematical breakthroughs

  • 챗GPT가 보낸 해결책, 그대로 실행해야 하나 — IT의 AI 개입 대응 3축 구조

    핵심 요약

    • AI 도구 대중화로 비전문가도 즉시 ‘기술적 제안’을 만들어낼 수 있게 되었고, 그 결과 사용자·임원이 자신감 있게 잘못된 절차를 주장하는 구조가 만들어졌습니다. 커뮤니티 댓글에서 ‘프로덕션 서버에 데이터베이스 재설치를 권하는’ 답변, ’12개의 무작위 명령어’를 요구하는 패턴이 반복적으로 거론되며, 이는 AI의 환각이 사용자 권한으로 위장되어 전파되는 메커니즘으로 분석됩니다.
    • 실무 해결의 핵심은 트러블슈팅 ‘결과’의 책임 소재와 ‘실행’의 권한을 사전에 매트릭스로 정의해 두는 것입니다. 티켓 인테이크 단계에서 사용자가 시도한 AI 답변 출처·명령어·시각을 기록하도록 강제하고, 원격 접속 거부 시 상위 티어의 사전 승인된 정책(예: ‘1티어 기술 진단은 원격 없이 진행 불가’)을 경영진 서명으로 받아두면, 임원과의 협상에서 2시간 통화 같은 상황을 5분 내로 종료시킬 수 있는 의사결정 기준이 됩니다.
    • 반드시 피해야 할 안티패턴은 (1) 사용자에게 AI 신뢰성 문제를 논리적으로 설득하는 것, (2) 시간을 아끼기 위해 위험한 AI 제안을 그대로 실행하는 것, (3) 유머 섞인 비꼬기·모욕으로 대응해 관계를 단절하는 것, (4) ‘빨리 처리하자’는 명목으로 문서화·티켓 기록을 건너뛰는 것, (5) 엔드포인트에 대한 표준 정책 없이 사용자가 임의 명령을 실행할 수 있는 상태를 방치하는 것입니다.

    AI 답변은 트러블슈팅의 ‘참고 자료’일 뿐 실행 권한과 책임 소재를 대체하지 못하므로, 인테이크 폼 표준화·무인 원격 도구 강제 도입·검증된 사내 지식 베이스라는 세 축으로 사용자 개입을 구조적으로 통제하는 것이 핵심이다.

    목차

    월요일 오전 9시 32분, 임원 P님의 긴급 티켓이 떨어졌다. “VPN 연결 안 됨, 챗GPT가 netsh winsock reset 하라고 했는데 권한이 없어서 안 됨, 즉시 명령 실행 권한 부여 바람.” 한 시간 넘게 통화하면서 원격 접속을 부탁했지만, “개인 정보를 본다”, “내 화면은 내가 본다”는 답변만 돌아온다. 옆자리 동료는 “이게 왜 SLA 4시간짜리 incident죠?”라고 묻는다.

    이런 일은 2023년부터 줄곧 있었지만, 코파일럿이 엣지에 기본 탑재된 2025년 하반기 들어 폭발적으로 늘었다. 임직원 모두가 1초 만에 “기술적 권고”를 생성할 수 있게 됐기 때문이다. 문제는 권고의 내용이 아니라 권고의 어조다. 챗GPT는 “다음 명령을 관리자 권한으로 실행하세요”라는 단정형으로 답하고, 사용자는 그 문장을 그대로 복사해 우리에게 보낸다. 마치 우리가 명령 실행 머신인 것처럼.

    현업에서 가장 답답한 지점은 두 가지다. 첫째, 우리는 답이 맞다는 보장이 없는 명령을 실행해 달라는 압박을 받는다. 둘째, 실행을 거부하면 사용자는 “왜 안 되는지”를 물으며 2시간짜리 통화로 들어온다. 이 두 지점을 동시에 무력화하는 출발점이, 결국 이번 글의 주제인 AI 개입 대응 프레임워크다.

    왜 하필 지금인가 — AI 답변의 권한 위장 구조

    이 문제가 단순한 사용자 교육의 문제가 아닌 이유가 있다. 챗GPT 등장 이전에는 비전문가가 “기술적으로 그럴듯한” 제안을 만들어내려면 최소한 기술 블로그를 검색하고 이해하는 시간이 필요했다. 지금은 그 시간이 0이다. prompt 한 줄이면 12개의 무작위 PowerShell 명령어가 탄생하고, 사용자는 그 리스트를 그대로 보낸다. AI의 환각이 사용자 권한을 빌려서 전파되는 메커니즘이다. r/sysadmin의 관련 스레드에서 시스템 관리자들이 “users sending ai generated fixes”를 운운하며 동일한 증상을 호소하는 것도 같은 맥락이다.

    특히 위험한 케이스는 다음 세 가지다. (1) 챗GPT가 “프로덕션 서버에 데이터베이스를 재설치하면 문제가 해결됩니다” 같은 답변을 만들었는데, 사용자는 그 답변을 사내 위키 인용 형식으로 포장해서 보낸다. (2) “이건 표준 절차입니다”라는 단정문이 들어가 있어, 거부하면 우리가 표준 절차를 모른다는 뉘앙스가 생긴다. (3) 임원이 보낸 경우 위에서 받는 압박이 수직적으로 가중되어, 같은 답이라도 거절 비용이 10배가 된다.

    원글과 상위 댓글에서 추출한 5가지 위험 신호

    원글과 상위 댓글에서 반복적으로 등장한 패턴을 정리하면, AI 개입 티켓의 5가지 위험 신호가 보인다. (1) 출처 인용의 부재 — “어디서 봤냐”고 물으면 “챗GPT요”라는 답변만 돌아오고, 어떤 prompt를 썼는지 기억하지 못한다. 즉, 답변의 진위는 IT가 검증해야 하는 책임이 그대로 우리에게 전가된 구조다. (2) 즉시 실행 요구 — “빨리 해야 합니다”, “이게 표준입니다” 같은 단정형 문장이 포함되어 있다. 표준 절차는 우리 KB에 있고, 챗GPT가 모르는 사내 도메인·계정 구조가 있다는 사실을 사용자는 모른다. (3) 원격 거부 — “내 화면은 내가 본다”, “원격 안 됩니다”라는 답변으로 진단 자체를 거부한다. RMM이 사전 설치돼 있으면 이 단계에서 논쟁이 끝나지만, 없는 경우 1티어 진단 자체가 막힌다. (4) 명령어 실행 권한 요구 — 관리자 권한을 요청하거나, “본인이 직접 할 테니 권한만 줘”라는 우회 경로를 제시한다. (5) 책임 소재 모호 — “명령이 잘못됐으면 책임은 챗GPT죠?”라는 인식이 사용자 사이에 만연하다. 실제로는 실행자가 IT인 한 책임은 IT에 있다. 이 5가지 신호는 단독으로 오기도 하지만 대부분 2~3개가 겹쳐서 오고, 특히 (3)+(4) 조합이 가장 빈번하다. 이것이 우리가 통제해야 할 정확한 지점이다.

    3단계 실무 대응 프레임워크

    1단계: 인테이크 표준화 — 티켓이 들어오는 순간 통제권 확보

    진짜 대응은 1차 통화에서 시작하지 않는다. 티켓 폼이 데이터센터다. Jira Service Management 기준으로, 인테이크 폼에 다음 4개 항목을 mandatory로 강제한다. AI 도구 사용 여부(예/아니오 분기형), 사용한 AI 도구명(챗GPT/코파일럿/제미나이/구글 AI 모드/기타), 실행한 명령어 또는 권고 사항(텍스트 필드 500자 이상), 실행/실행 시도 시각과 결과. 이 필드들은 단순한 로그가 아니다. IT 담당자가 5분 안에 “이 답변은 참고만 할 것” 또는 “이 답변은 무시” 결정을 내리는 판단 자료다. Freshservice를 쓴다면 Request Type의 custom field로 동일한 항목을 강제하고, ServiceNow라면 Service Catalog 변수로 등록한다. 필자가 현업에서 겪어본 바로는, 이 폼이 강제되지 않은 조직에서는 모든 1차 회신이 “어디서 봤어요?”라는 질문으로 시작되고 그것이 2시간짜리 통화의 입구가 된다. 폼이 강제되면 첫 메일이 사실상 결정 자료가 된다.

    // Jira Service Management - 인테이크 폼 JSON Schema 일부
    {
      "fields": {
        "ai_tool_used": {
          "type": "select",
          "required": true,
          "options": ["ChatGPT","Microsoft Copilot","Gemini","Google AI Mode","기타","사용 안 함"]
        },
        "ai_recommendation": {
          "type": "textarea",
          "required": true,
          "minLength": 50
        },
        "commands_attempted": {
          "type": "textarea",
          "required": false
        },
        "timestamp_attempted": {
          "type": "datetime",
          "required": false
        }
      }
    }

    2단계: 무인 원격(RMM) 강제 — 진단의 시작점을 표준화

    표준 트러블슈팅 1티어는 원격 진단을 거치지 않으면 SLA 자체가 시작되지 않도록 정책을 코딩한다. Microsoft Intune을 쓴다면 Windows Autopilot 프로필에 NinjaOne이나 ConnectWise ScreenConnect의 unattended access 에이전트를 포함시키고, 도메인 가입 시점에 무인으로 설치한다. 핵심은 “임원 PC는 예외”라는 규정을 두지 않는 것이다. 임원 승인을 받는 시점에서 “모든 도메인 가입 디바이스에 동일 정책이 적용된다”는 문구를 사인오프 문서에 명시한다. 이 문구 하나가 나중에 “제 PC는 예외 처리”라는 요구를 차단하는 가장 효과적인 무기다.

    # PowerShell - Intune Remediations용 강제 재설치 스크립트
    $agentPath = "C:\Program Files\ScreenConnect\Client\client.exe"
    if (-not (Test-Path $agentPath)) {
        Start-Process "msiexec.exe" -ArgumentList "/i https://rmm.example.com/agent.msi /qn TOKEN=xxxxxxxx" -Wait
        # 0 외 종료코드면 재시도 큐에 등록
        if ($LASTEXITCODE -ne 0) { Write-Output "retry_queue=true" }
    }

    3단계: 사후 문서화 — KB의 우위화

    티켓이 닫힌 후, 그 AI 답변을 사내 KB에 “실패 사례”로 등록한다. Confluence라면 템플릿 페이지를 만들고, Guru나 Notion이면 카드 단위로 등록한다. 페이지에는 티켓 ID, 사용자 직급, 사용 AI, 권고 명령어, 결과, 정답 절차 링크, AI가 몰랐던 사내 컨텍스트(예: 사내 VPN 클라이언트, 도메인 정책, AD 그룹)를 기재한다. 이 페이지를 만들면서 두 가지가 동시에 달성된다. (1) 다음에 같은 패턴이 왔을 때 검색 한 번으로 답할 수 있다. (2) KB 자체가 “챗GPT보다 사내 KB가 우선”이라는 문화적 규범을 만든다. 같은 시스템-기반 통제 철학으로 피싱 모의훈련 반복 실패자를 다루는 방식은 피싱 모의훈련 반복 실패자 7단계 실무 절차에서 자세히 다룬다.

    도입 기술 스택 3선과 설정 포인트

    RMM은 엔드포인트 수에 따라 선택지가 갈린다. 50대 이하는 MeshCentral이나 Tactical RMM 같은 오픈소스를 셀프 호스팅해 라이선스 비용을 0에 수렴시킬 수 있고, 100대 이상은 NinjaOne이나 ConnectWise ScreenConnect가 TCO 면에서 안정적이다. 설정 포인트 세 가지는 (1) unattended password를 1회용 토큰 기반으로 회전, (2) 사용자 동의 팝업은 도메인 정책에서 비활성화, (3) 세션 로그 최소 90일 보존이다. 티켓 도구는 JSM/ServiceNow/Freshservice 중 사내 표준에 맞춰 선택하되, “AI 개입 티켓”을 별도 워크플로로 라우팅해 1차 회신 SLA를 30분으로 압축한다. KB는 Confluence를 표준으로 깔고 Guru를 검색 레이어로 얹는 구성이 가장 가성비가 좋다. 페이지 제목이 “VPN 연결 오류 — Windows 11″처럼 자연어 형태여야 사용자가 챗GPT 대신 사내 KB를 먼저 검색하게 된다. AI 도구 자체의 거버넌스 가드레일은 AI 라이선스 회수 통보 가드레일 5단계에서 별도로 다룬다.

    절대 피해야 할 5가지 안티패턴

    (1) 사용자에게 AI 신뢰성 문제를 논리적으로 설득하려는 시도. 2시간짜리 논쟁이 시작될 뿐이다. 인테이크 폼이 이미 답을 정해놨다. (2) “빨리 처리하자”는 명목으로 위험한 AI 제안을 그대로 실행하는 것. 명령어 하나가 프로덕션 DB를 날릴 수 있다. (3) 유머 섞인 비꼬기로 대응해 관계를 단절하는 것. 임원은 기억한다. 다음 분기 예산 검토 때 정확히 회수한다. (4) 문서화·티켓 기록을 건너뛰는 것. 다음에 같은 문제가 왔을 때 우리가 다시 1시간을 쓴다. (5) 엔드포인트에 대한 표준 정책 없이 사용자가 임의 명령을 실행할 수 있는 상태를 방치하는 것. 로컬 관리자 권한을 일반 사용자에게 준 환경은 이 문제의 근본 원인이다.

    결론 — AI는 도구, 의사결정 권한은 사람

    챗GPT가 만들어내는 답변은 트러블슈팅의 참고 자료일 뿐, 실행 권한과 책임 소재를 대체하지 못한다. 그 경계를 누가 그어주느냐가 IT의 역할이고, 그 경계선을 사람이 매번 설명하는 방식으로는 한계가 있다. 인테이크 폼 표준화, 무인 원격 도구 강제 도입, 검증된 사내 KB 우위화라는 세 축으로 사용자 개입을 구조적으로 통제하는 것이 현실적 해법이다. 시스템 관리자의 시간을 1티어 논쟁에서 빼내야 2티어, 3티어의 진짜 일에 집중할 수 있다.

    지금 바로 해볼 것

    • 내일 아침까지 Jira/ServiceNow 인테이크 폼에 AI 도구 사용 여부, 도구명, 권고 명령어, 실행 시각 4개 필드를 mandatory로 추가한다. IT 3명 회의를 30분 잡으면 끝난다.
    • Intune의 Win32 앱 정책에 RMM 에이전트 배포 항목을 추가하고 Autopilot 프로필에 자동 포함시킨다. 오늘 안에 unattended access password를 Endpoint Configuration Manager 변수로 등록한다.
    • Confluence에 AI 답변 실패 사례 템플릿 페이지를 1개 만들고, 최근 1주일 AI 개입 티켓 3건을 그 템플릿으로 회고 문서화한다. 다음 주 회고에서 팀과 공유한다.
    • 도메인 정책 GPO의 로컬 관리자 그룹에 일반 사용자가 포함돼 있는지 점검하고, 포함된 경우 LAPS(Local Admin Password Solution)로 교체한다.
    • 경영진 서명 문서에 도메인 가입 디바이스는 예외 없이 동일 RMM 정책 적용 문구를 추가하고, Q4 IT 거버넌스 회의 안건으로 상정한다.

    자주 묻는 질문

    RMM 도입 비용이 부담되는데, 엔드포인트 50대 수준에서 무료 대안은 없나요?

    MeshCentral이나 Tactical RMM을 셀프 호스팅하면 라이선스 비용은 0에 수렴한다. 다만 운영 인력이 최소 0.5 FTE는 잡혀야 하고, 백업과 업데이트 정책은 직접 설계해야 한다. 엔드포인트 100대 이상으로 늘어나면 NinjaOne 같은 상용 RMM이 TCO 면에서 더 안정적이다.

    임원이 제 PC는 예외를 강력히 주장할 때, 어떻게 설득하나요?

    논리적 설득은 통하지 않는다. 예외가 없도록 사인오프 받겠습니다라는 한 줄 문서가 CFO, CEO, CISO 합동 서명으로 미리 발급되어 있어야 한다. 그 문서가 없으면 1티어 정책 자체가 무너진다. 문서 발급 시점은 IT 거버넌스 QBR이고, 그 이후에는 예외가 없다.

    사용자가 챗GPT 답변을 강력히 믿고 있어, 무시하면 관계가 깨질 것 같습니다.

    관계를 살리려면 당신이 틀렸다가 아니라 우리가 검증한 표준 절차를 내보여야 한다. 사내 KB 페이지를 그대로 링크로 회신하고, 이 절차는 사내 환경에 맞춰 검증됐습니다라는 한 줄을 붙인다. KB 자체가 없으면 그 시점에서는 무조건 시간 벌기 답변만 가능하다. KB가 살아 있어야 비로소 무시가 아닌 우위가 생긴다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: r/sysadmin — Anyone else tired of users sending ai generated fixes to you?