[태그:] 구글 AI

  • 제미나이아르곤 공개 5가지 — 사이버보안 특화 모델로 구글이 다시 한복판에 섰다

    제미나이아르곤 공개 5가지 — 사이버보안 특화 모델로 구글이 다시 한복판에 섰다

    핵심 요약

    • 구글 모회사 알파벳이 ‘제미나이 4 아르곤(Gemini 4 Argon)’을 공개하며 자사 최고 성능 모델임을 강조
    • 아르곤은 코딩, 리서치, 글쓰기 등 다양한 작업을 소화하도록 설계되었으며, 그중에서도 사이버보안 방어 업무에 특히 강점이 있다고 구글이 소개
    • 보안 영역에서는 ‘중요한 소프트웨어 취약점을 자율적으로 탐지·검증·패치’할 수 있는 능력으로 마케팅되며, 방어 목적에 특화해 학습됐다는 점이 강조됨

    구글이 사이버보안과 코딩이라는 실무형 영역에 방점을 찍으며 신모델 ‘아르곤’을 전면에 내세운 배경과, 이를 OpenAI·앤스로픽 등과의 벤치마크 경쟁 프레임으로 포장한 전략을 분석하는 기사

    목차

    제미나이아르곤은 9월 30일 구글 모회사 알파벳이 공개한 신형 프론티어 모델이다. 구글이 “자사 최고 성능”이라고 표현한 이 모델은 사이버보안 방어와 코딩에 무게를 싣고 나왔다(TechCrunch 보도). 같은 시기 OpenAI의 아스트라, 앤스로픽의 페이블·오퍼스가 잇따라 베일을 벗은 터라, 제미나이아르곤은 단순한 신모델 발표를 넘어 “구글이 다시 한복판에 섰다”는 메시지처럼 읽힌다.

    제미나이아르곤의 사이버보안 방어 — “취약점 자율 패치” 주장의 무게

    구글은 제미나이아르곤을 “중요한 소프트웨어 취약점을 자율적으로 탐지·검증·패치”할 수 있다고 소개했다. 공격용이 아니라 방어 학습에 특화했다는 점을 강조한 부분이다. 실무자 입장에서 눈에 띄는 건 ‘검증’이라는 단어다. 취약점 후보를 찾아내는 LLM은 이미 여럿 있다. 그 후보가 진짜 위협인지 검증하고, 패치까지 작성·적용하는 루프를 하나의 모델이 도는 순간, 보안팀의 1차 triage 비용 구조 자체가 흔들릴 수 있다.

    다만 초기 배포는 ‘페어윈드 프로그램(Fairwind Program)’이라는 보안 이니셔티브를 통해 선정된 사이버 파트너사에만 단계적으로 풀린다. 일반 사용자가 바로 API를 두드릴 수 있는 구조가 아니라는 뜻이다. 구글 측이 “신뢰와 안전을 우선한다”는 프레임을 앞세우는 동시에, 사실상 첫 사용자 풀을 통제하겠다는 전략적 선택으로 읽힌다.

    제미나이아르곤의 코딩·엔지니어링과 “장기 추론” 어필

    제미나이아르곤은 코딩·리서치·글쓰기를 폭넓게 소화하도록 설계됐고, 그중에서도 장기 워크플로우에 걸친 깊은 추론을 지속하는 능력을 차별점으로 내세운다. 공개 블로그에는 “복잡하고 장기적인 워크플로우에 걸친 깊은 추론을 지속하도록 설계”됐다는 표현이 그대로 들어가 있다. 실례로 구글 자체 직원들이 디버깅과 코드베이스 마이그레이션에 이미 사용 중이라고 회사 측이 밝혔다. 디버깅 한 줄이 아니라 마이그레이션처럼 수일~수주 단위로 이어지는 작업에서 컨텍스트가 끊기지 않는다는 건, 모델 평가의 척도가 “정답률”에서 “프로젝트 완수율”로 이동하고 있음을 시사한다.

    멀티모달 측면에서는 장시간 영상 분석과 차트 파싱 능력도 함께 내세웠다. 텍스트+이미지에 그치지 않고 시간축이 긴 영상을 다룬다는 점에서, 운영 모니터링이나 사고 대응 로그 검토 같은 보안 업무와의 접점이 자연스럽게 생긴다.

    벤치마크의 정치학 — Vals라는 이름

    구글은 제미나이아르곤이 OpenAI의 GPT-6 아스트라, 앤스로픽의 페이블·오퍼스보다 다양한 벤치마크에서 더 높은 점수를 기록했다고 주장했다. 다만 인용된 출처가 흥미롭다. ‘발스(Vals)’라는 AI 벤치마크 스타트업의 모델 인덱스다. Vals는 최근 업계에서 활용도가 높아지는 벤치마크 제공자이지만, 기존 LMSYS나 학술 벤치마크와 달리 평가 세트 선택과 가중치 적용에 모델사 협조가 일부 들어가는 구조다. 제미나이아르곤을 도입 검토하는 팀은 점수표만 보지 말고 평가 세트 구성과 적용 조건을 같이 봐야 한다.

    항목 제미나이아르곤 OpenAI GPT-6 아스트라 앤스로픽 페이블·오퍼스
    핵심 강점 사이버보안 방어, 장기 추론 범용 추론, 자사 최고 성능 안전성, 추론 특화
    배포 방식 페어윈드 프로그램(통제된 단계) 자사 채널 공개 자사 채널 공개
    벤치마크 인용 Vals 모델 인덱스 자사 발표 기반 자사 발표 기반
    멀티모달 강조점 장시간 영상, 차트 파싱 자사 발표 기반 자사 발표 기반

    10억 사용자 위의 재진입 서사

    구글은 한때 AI 레이스에서 ‘뒤처졌다’는 평가를 들었다. 그러나 8월 기준 제미나이 앱의 월간 사용자 수 10억 명 돌파를 전제로, 아르곤을 자사 회복세 위에 올려놓는 전략을 취하고 있다. 이 수치는 단순한 MAU가 아니라 “소비자 접점 + 최상위 모델”을 동시에 보유한 플레이어가 다시 한 명 늘었다는 의미다. 같은 9월, OpenAI의 아스트라와 앤스로픽의 페이블이 잇따라 베일을 벗었다. GPT-6 아스트라 3가지 의문에서 살펴봤듯, 9월 AI 신모델 경쟁은 이미 ‘속도전’ 구도에 들어섰다.

    필자는 이 지점이 가장 의미 있다고 본다. 모델 카드를 비교하는 일은 어렵지 않다. 어려운 건 그 모델을 어떤 배포 채널로, 어떤 안전 프레임으로, 어떤 가격에 풀 것인가를 정하는 일이다. 제미나이아르곤은 그 어려운 질문에 대한 구글식 답을 보여줬다 — 통제된 배포, 방어 특화, 장기 추론. 그리고 같은 9월, 그 답이 단독으로 존재하지 않는다.

    지금 바로 해볼 것

    • 사내 보안팀이 LLM 도입을 평가 중이라면, 제미나이아르곤 페어윈드 프로그램의 파트너사 자격 요건을 확인한 뒤 참여 가능 여부를 1주일 안에 검토한다.
    • 코딩 워크플로우에 디버깅·마이그레이션용 LLM 후보를 비교 중이라면, 제미나이아르곤을 ‘장기 컨텍스트 유지’ 기준으로 평가 항목에 추가한다.
    • 벤치마크 자료를 팀에 공유할 때 점수표뿐 아니라 Vals의 평가 세트 구성과 가중치 정보를 함께 첨부한다.
    • 멀티모달 PoC를 설계 중이라면 장시간 영상 입력의 컨텍스트 유지 시간을 별도 측정 항목으로 넣는다.
    • OpenAI·앤스로픽·구글 모델을 한 표로 정리해 라이선스, 배포 채널, 안전 정책, 가격 단위를 비교하는 문서를 사내 위키에 만든다.

    실무 적용 포인트

    • 방어 특화 학습 모델은 공격 시나리오에 대한 가드레일이 내장돼 있다는 의미이지, 오용 가능성이 0이라는 뜻은 아니다. SOC 운영 시 사람이 최종 검토하는 단계를 없애지 말 것.
    • 장기 추론은 단순한 컨텍스트 윈도우 크기와 다르다. 토큰 수가 아니라 도구 호출·파일 참조·세션 재개가 가능한지를 PoC 단계에서 반드시 확인한다.
    • 벤치마크 점수는 ‘스냅샷’이다. 동일 모델이라도 시스템 프롬프트·온도·체이닝 방식에 따라 실무 결과가 크게 달라진다.
    • 통제된 배포 모델을 평가할 때는 “언제 일반 채널로 풀리는가”를 질문 목록에 포함해 단기·중기·장기 도입 시나리오를 나눌 것.

    자주 묻는 질문

    제미나이아르곤은 일반 개발자도 바로 사용할 수 있나요?

    초기에는 페어윈드 프로그램에 선정된 사이버 파트너사에만 단계적으로 배포됩니다. 일반 사용자는 정식 채널 오픈 일정을 별도로 확인해야 합니다.

    보안 방어용이라고 했는데, 공격에도 쓸 수 있나요?

    구글은 방어 중심으로 학습했다고 강조했습니다. 다만 LLM 특성상 활용 방식에 따라 윤리·법적 문제가 달라지므로, 도입 시 이용 약관과 가용성 정책을 반드시 확인해야 합니다.

    기존 제미나이 모델과 무엇이 다른가요?

    제미나이아르곤은 자사 최고 성능 모델로 포지셔닝됐고, 장기 워크플로우 추론과 멀티모달 처리에서 차별점을 들고 있습니다. 세부 스펙은 공식 모델 카드로 확인하는 편이 정확합니다.

    Vals 벤치마크는 신뢰할 수 있나요?

    Vals는 업계 활용도가 높아지고 있지만 평가 세트 선택에 대한 표준 합의가 충분치 않습니다. 점수 단독 비교보다 평가 항목 구성과 적용 조건을 함께 봐야 합니다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Google releases Gemini 4 Argon, called its most powerful model yet
  • TimesFM-3, 3.3억 파라미터로 다변량 시계열을 정조준한 구글의 다음 수

    TimesFM-3, 3.3억 파라미터로 다변량 시계열을 정조준한 구글의 다음 수

    TimesFM-3
    구글 AI의 시계열 파운데이션 모델 'TimesFM-3' 공개와 다변량 예측 전환

    핵심 요약

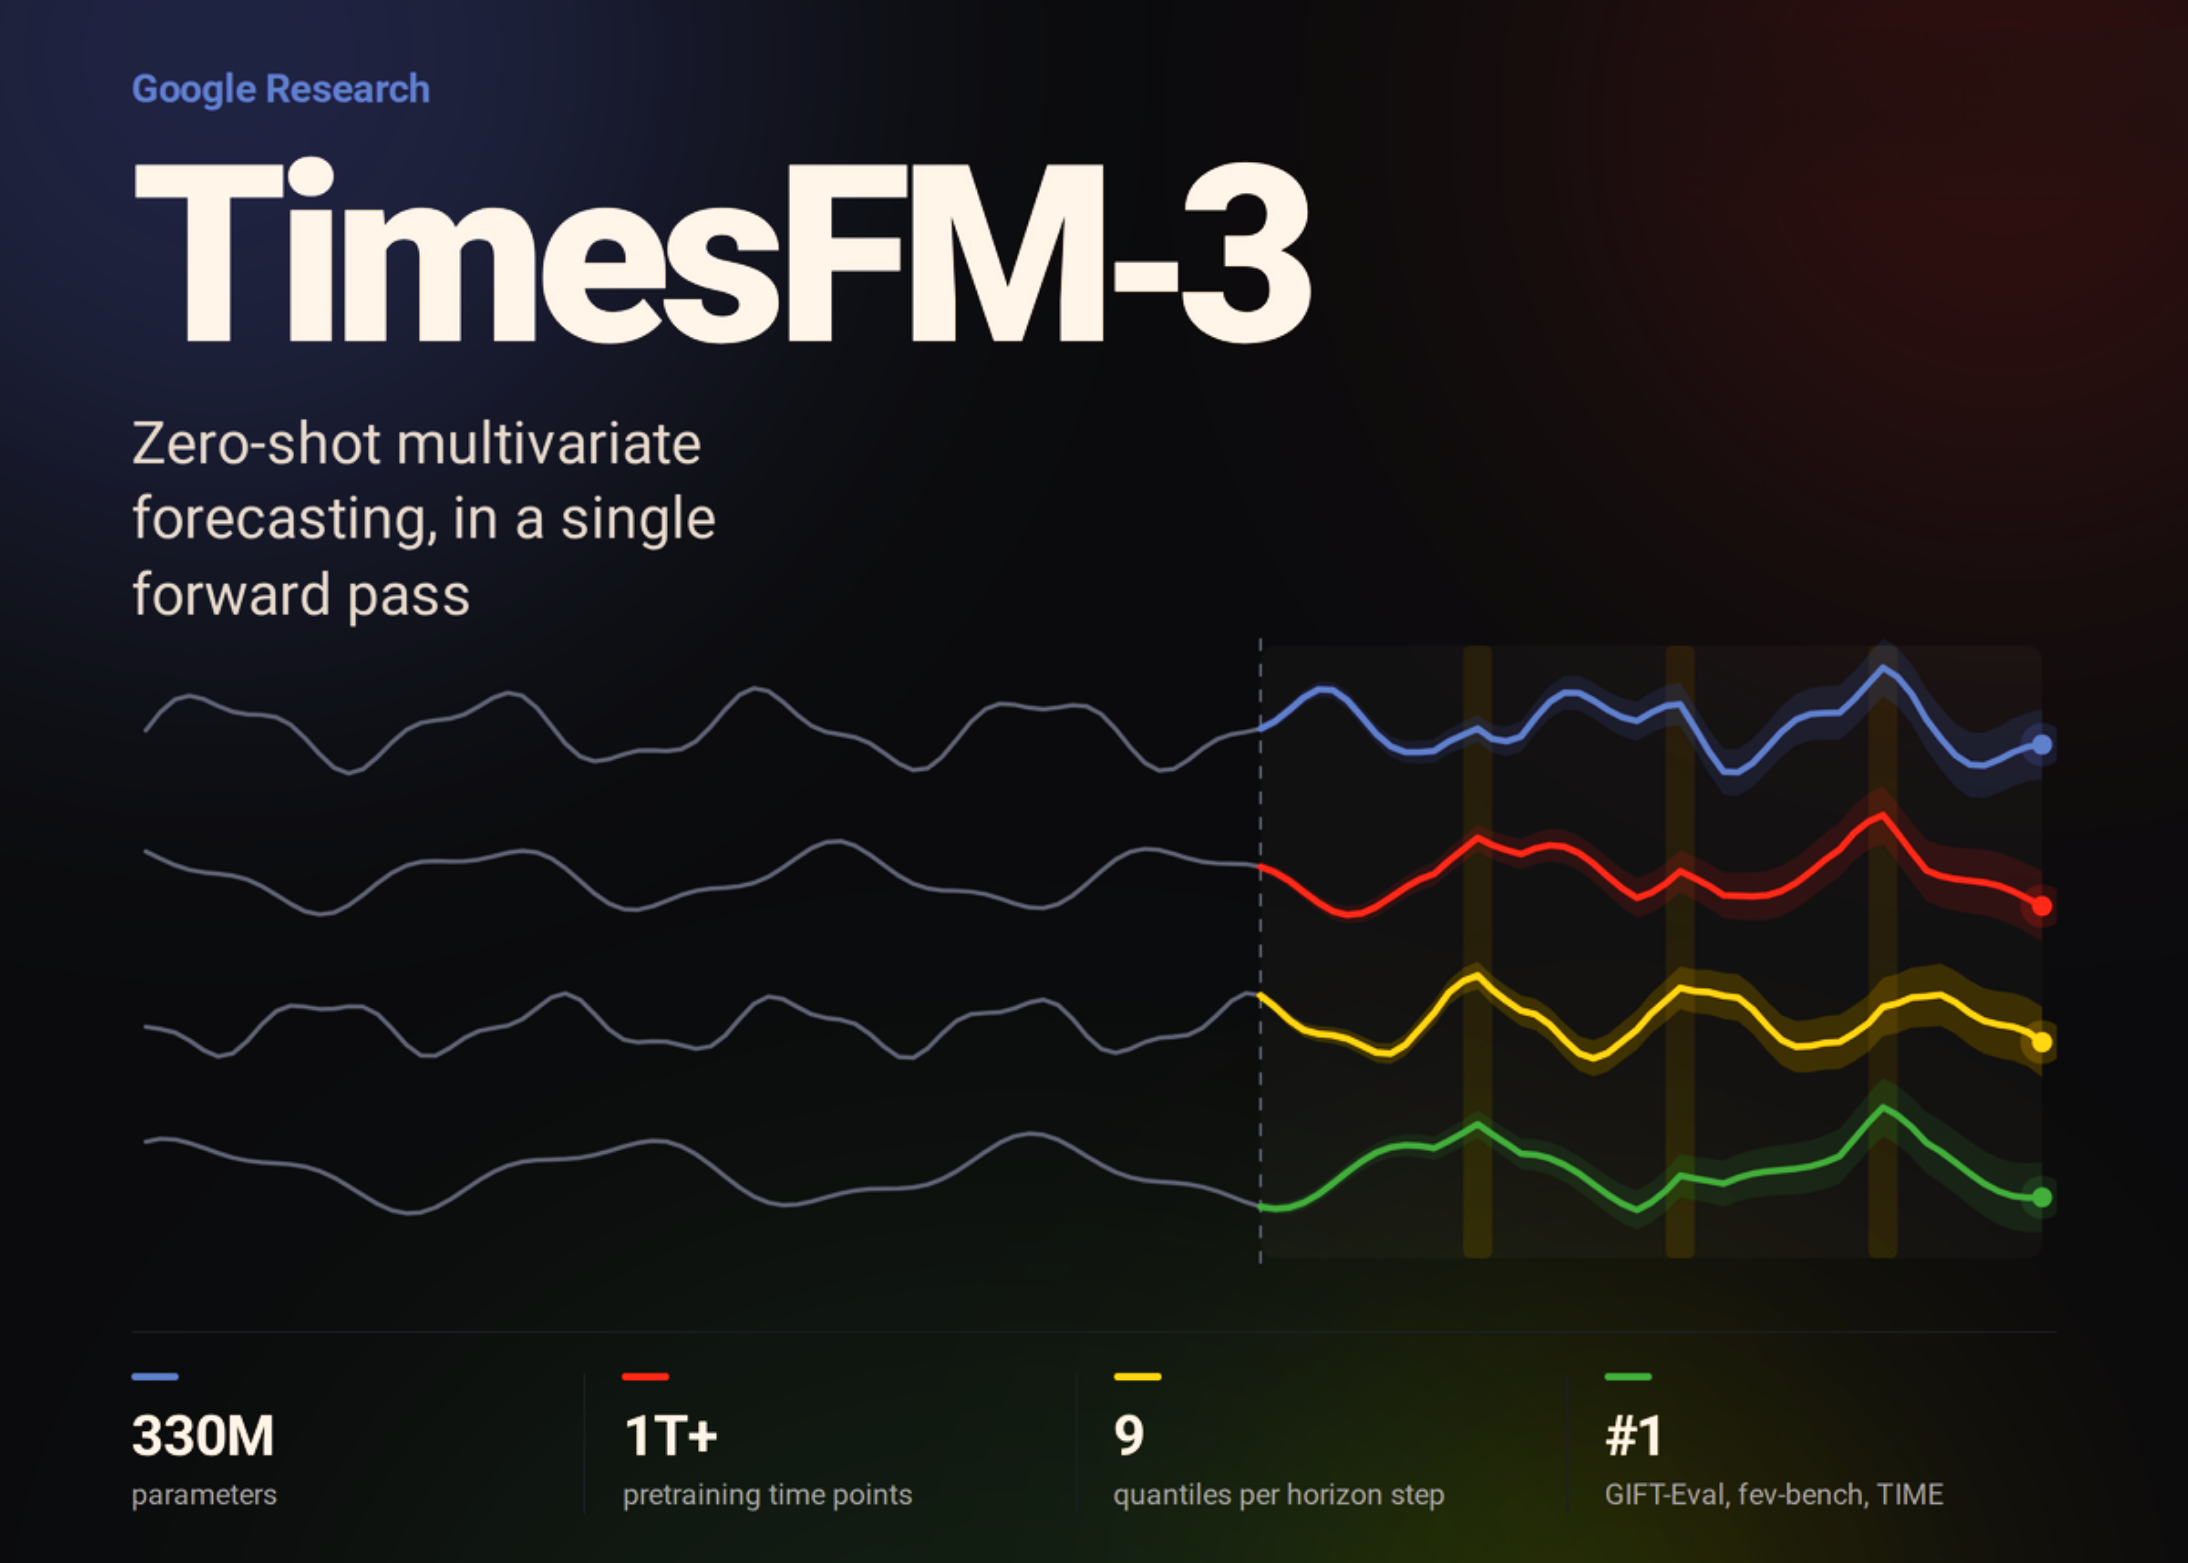
    • TimesFM-3는 3억 3천만 파라미터 규모의 시계열 파운데이션 모델로, 단일 forward pass로 여러 관련 시계열을 동시에 예측한다.
    • 2.5까지의 모든 TimesFM 체크포인트는 단변량(univariate) 전용이었으나, TimesFM-3는 처음부터 다변량(multivariate) 예측을 위해 사전학습되었다.
    • 1조 개 이상의 시점에서 실제 및 합성 시계열 데이터로 사전학습되었으며, 다중 타깃, 과거 공변량(past covariates), 과거-미래 공변량(past-future covariates)을 작업별 미세조정 없이 zero-shot으로 입력받는다.

    분석

    목차

    TimesFM-3가 선언한 다변량 시대

    TimesFM-3를 한 문장으로 정의하면 이렇다. 3.3억 파라미터로 다변량 시계열을 zero-shot으로 받는 구글의 새 파운데이션 모델이다. 한 forward pass로 여러 관련 시계열을 동시에 예측한다. 여기서 필자가 가장 의미 있다고 본 지점은, 2.5까지의 모든 TimesFM 체크포인트가 단변량 전용이었다는 사실이다. 기존 모델은 “온도 하나”나 “매출 하나”를 독립적으로 예측하느라, 변수 간 상관관계를 매번 손으로 모델에 알려줘야 했다. TimesFM-3는 처음부터 다변량 native로 설계된 첫 번째 버전이라는 점에서 갈라선다.

    TimesFM-3의 핵심 변화: 1조 시점 학습과 공변량 zero-shot

    핵심 수치를 먼저 보자. 3.3억 파라미터, 1조 개 이상의 시점에서 실제·합성 데이터로 사전학습, 디코더 전용 트랜스포머 유지. 모델 크기 자체는 기존 대비 큰 변화는 아니지만, 학습 데이터 규모와 입력 설계가 본질적으로 다르다. 가장 눈에 띄는 건 공변량 처리다. 다중 타깃, 과거 공변량, 과거-미래 공변량을 별도 미세조정 없이 zero-shot으로 입력받는다. 다시 말해, “내일 비가 온다”는 일기예보 정보처럼 미래에 미리 알려진 변수를 모델이 인지한 채로 예측을 수행한다.

    아키텍처 핵심 3가지

    필자가 아키텍처를 들여다보면서 실무자 입장에서 주목한 부분은 세 가지다.

    • 32스텝 패치 토크나이저: 연속된 시점을 32스텝 단위 패치로 묶어 트랜스포머 입력 길이를 줄인다. 시계열별로 정규화하기 때문에 스케일 차이(매출은 백만 단위, 전환율은 0~1 사이)가 서로 잡음을 주지 않는다.
    • 2D 그리드 어텐션: 입력 토큰이 2D 그리드(시계열 축 × 시간축)를 통과하며 두 가지 교대 어텐션 메커니즘으로 처리된다. 변수 간 의존성과 시간적 패턴을 분리해 학습한다.
    • Lookahead 방식 공변량 인코딩: 과거-미래 공변량 토큰이 현재 패치와 미래 패치를 결합해 입력된다. 예정된 이벤트를 모델이 사전에 인지하도록 설계된 부분이다.

    이 구조는 AI 칩 아키텍처 6가지에서 다룬 데이터 흐름 분리 사고방식과 닮아 있다. 시계열의 “데이터”를 어떻게 잘게 쪼개고 어디서 다시 합치느냐가 성능을 가른다.

    벤치마크: 세 곳 모두 1위

    평가는 세 곳에서 진행됐다. GIFT-Eval, fev-bench, TIME 리더보드. 세 벤치마크 모두 사전학습된 파운데이션 모델 중 point metric과 probabilistic metric 양쪽에서 최고 평균 순위를 기록했다. 흥미로운 건 probabilistic metric에서도 1위라는 점이다. 기존 파운데이션 모델들은 point prediction은 잘하지만, 불확실성 분포 추정에 약한 경우가 많았다. TimesFM-3는 다변량 입력을 처음부터 받기 때문에 공분산 구조를 더 자연스럽게 학습할 수 있었던 것으로 보인다.

    TimesFM 시리즈 비교

    항목 TimesFM-2.5 TimesFM-3
    파라미터 2억 대 3.3억
    입력 설계 단변량 다변량 native
    공변량 미지원 과거·미래 공변량 zero-shot
    벤치마크 단일 리더보드 GIFT-Eval·fev-bench·TIME 1위
    가중치 라이선스 연구용 timesfm-non-commercial-v1.0

    TimesFM-3 라이선스의 비대칭

    저장소 코드는 Apache-2.0다. 즉, 코드는 자유롭게 보고 수정할 수 있다. 문제는 가중치다. TimesFM 3.0 가중치는 timesfm-non-commercial-license-v1.0으로 배포된다. MarkTechPost 보도가 상세히 전한 내용에 따르면, 벤치마크 평가는 가능하지만 운영용 예측 API에 탑재해 서비스하는 것은 라이선스상 허용되지 않는다.

    이는 LLM 분야에서 Meta의 Llama가 취한 전략과 유사하다. 연구는 열어주되 상업적 우위는 자사가 가져가는 구조. 데이터 사이언스 팀이 “TimesFM-3를 도입하자”고 보고서를 올려도, 가중치를 그대로 서비스에 올리면 라이선스 위반이라는 점을 법무팀이 먼저 거를 가능성이 높다. 이 비대칭이 향후 한국 기업들의 도입 경로를 결정짓는 가장 큰 변수가 될 것이다.

    실무에 던지는 질문

    다변량 시계열 파운데이션 모델이 실무에서 의미 있으려면 결국 두 가지를 보여줘야 한다. 첫째, 기존 통계 모델(ARIMA, Prophet)이나 경량 ML(LightGBM) 대비 운영 비용 대비 우위가 있어야 한다. 둘째, 입력 변수 추가·삭제 시 재학습 없이도 품질이 유지돼야 한다. TimesFM-3는 두 번째 질문에 zero-shot 설계 자체가 답하려 한 것이고, 첫 번째는 “공변량을 넣어주니 정확도가 올랐다”는 사례가 쌓여야 답할 수 있다.

    다만 가중치가 닫혀 있으니, 한국 기업 입장에서 직접 fine-tuning해 내부 모델을 만들 길이 막혀 있다. 합성 데이터 추가 학습이나 distillation 같은 우회 경로가 화두가 될 가능성이 크다. 이 흐름은 가드브레이커 분석 글에서 다룬 LLM 우회 전략과 맞닿아 있다. 모델의 가중치가 닫히면, 결국 입력 설계와 데이터 가공에서 차별화가 발생한다.

    실무 적용 포인트

    • TimesFM-3 도입 검토 전, 자사 예측 파이프라인에서 “단일 변수만으로 충분한가”를 먼저 자문한다. 다변량 의존성이 실제로 존재하는지 검증 없이는 비용 대비 효과가 없다.
    • 공변량으로 쓸 수 있는 내부 데이터를 사전에 정리한다. 프로모션 일정, 가격 변경, 휴일 여부 같은 과거·미래 공변량 후보 목록을 작성해 두는 것이 향후 어떤 모델을 선택하든 도움이 된다.
    • 가중치 라이선스가 비상업용이라는 점에 유의한다. 운영 환경 적용은 Google Cloud의 TimesFM API 경로를 확인하고, 자체 호스팅이 필요하면 별도 라이선스 협상 가능성을 열어 둔다.
    • 벤치마크 점수보다 자기 데이터셋에서의 backtest 결과를 우선시한다. GIFT-Eval 1위라도 도매·소매·제조 같은 도메인별 패턴이 다르면 우위가 사라질 수 있다.

    지금 바로 해볼 것

    • GitHub 저장소에서 TimesFM 코드를 clone해 Apache-2.0 범위 내에서 아키텍처와 입력 인터페이스를 확인한다.
    • 자사가 가진 시계열 5~10개로 다변량 입력 형태(다중 타깃 + 공변량)를 구성해 본다.
    • 기존 단변량 모델과 동일 기간 backtest를 돌려 MAPE·CRPS를 비교 표로 만든다.
    • Google Cloud Vertex AI에서 TimesFM API가 노출돼 있는지 가격·SLA·쿼터와 함께 확인한다.
    • 법무팀에 “비상업용 가중치로 내부 PoC 진행해도 되는지”를 사전에 문의한다.

    자주 묻는 질문

    TimesFM-3는 기존 TimesFM-2.5와 무엇이 다른가요?

    가장 큰 차이는 입력 설계다. 2.5까지는 단변량만 받았지만, TimesFM-3는 다변량을 처음부터 받는다. 다중 타깃과 과거·미래 공변량을 zero-shot으로 처리한다.

    가중치를 다운로드해 상업 서비스에 써도 되나요?

    아니다. 가중치는 timesfm-non-commercial-license-v1.0으로 배포되어 상업적·프로덕션 사용이 제한된다. 코드만 Apache-2.0이다.

    벤치마크 1위는 어느 평가에서인가요?

    GIFT-Eval, fev-bench, TIME 리더보드 세 곳 모두에서 사전학습된 파운데이션 모델 중 point metric과 probabilistic metric 양쪽 1위다.

    한국 기업도 바로 쓸 수 있나요?

    가중치 직접 호스팅은 라이선스 제한이 있다. 코드와 인터페이스는 공개돼 있어 PoC와 연구 목적으로는 활용 가능하고, 상업 운영은 Google Cloud API 경로를 확인해야 한다.