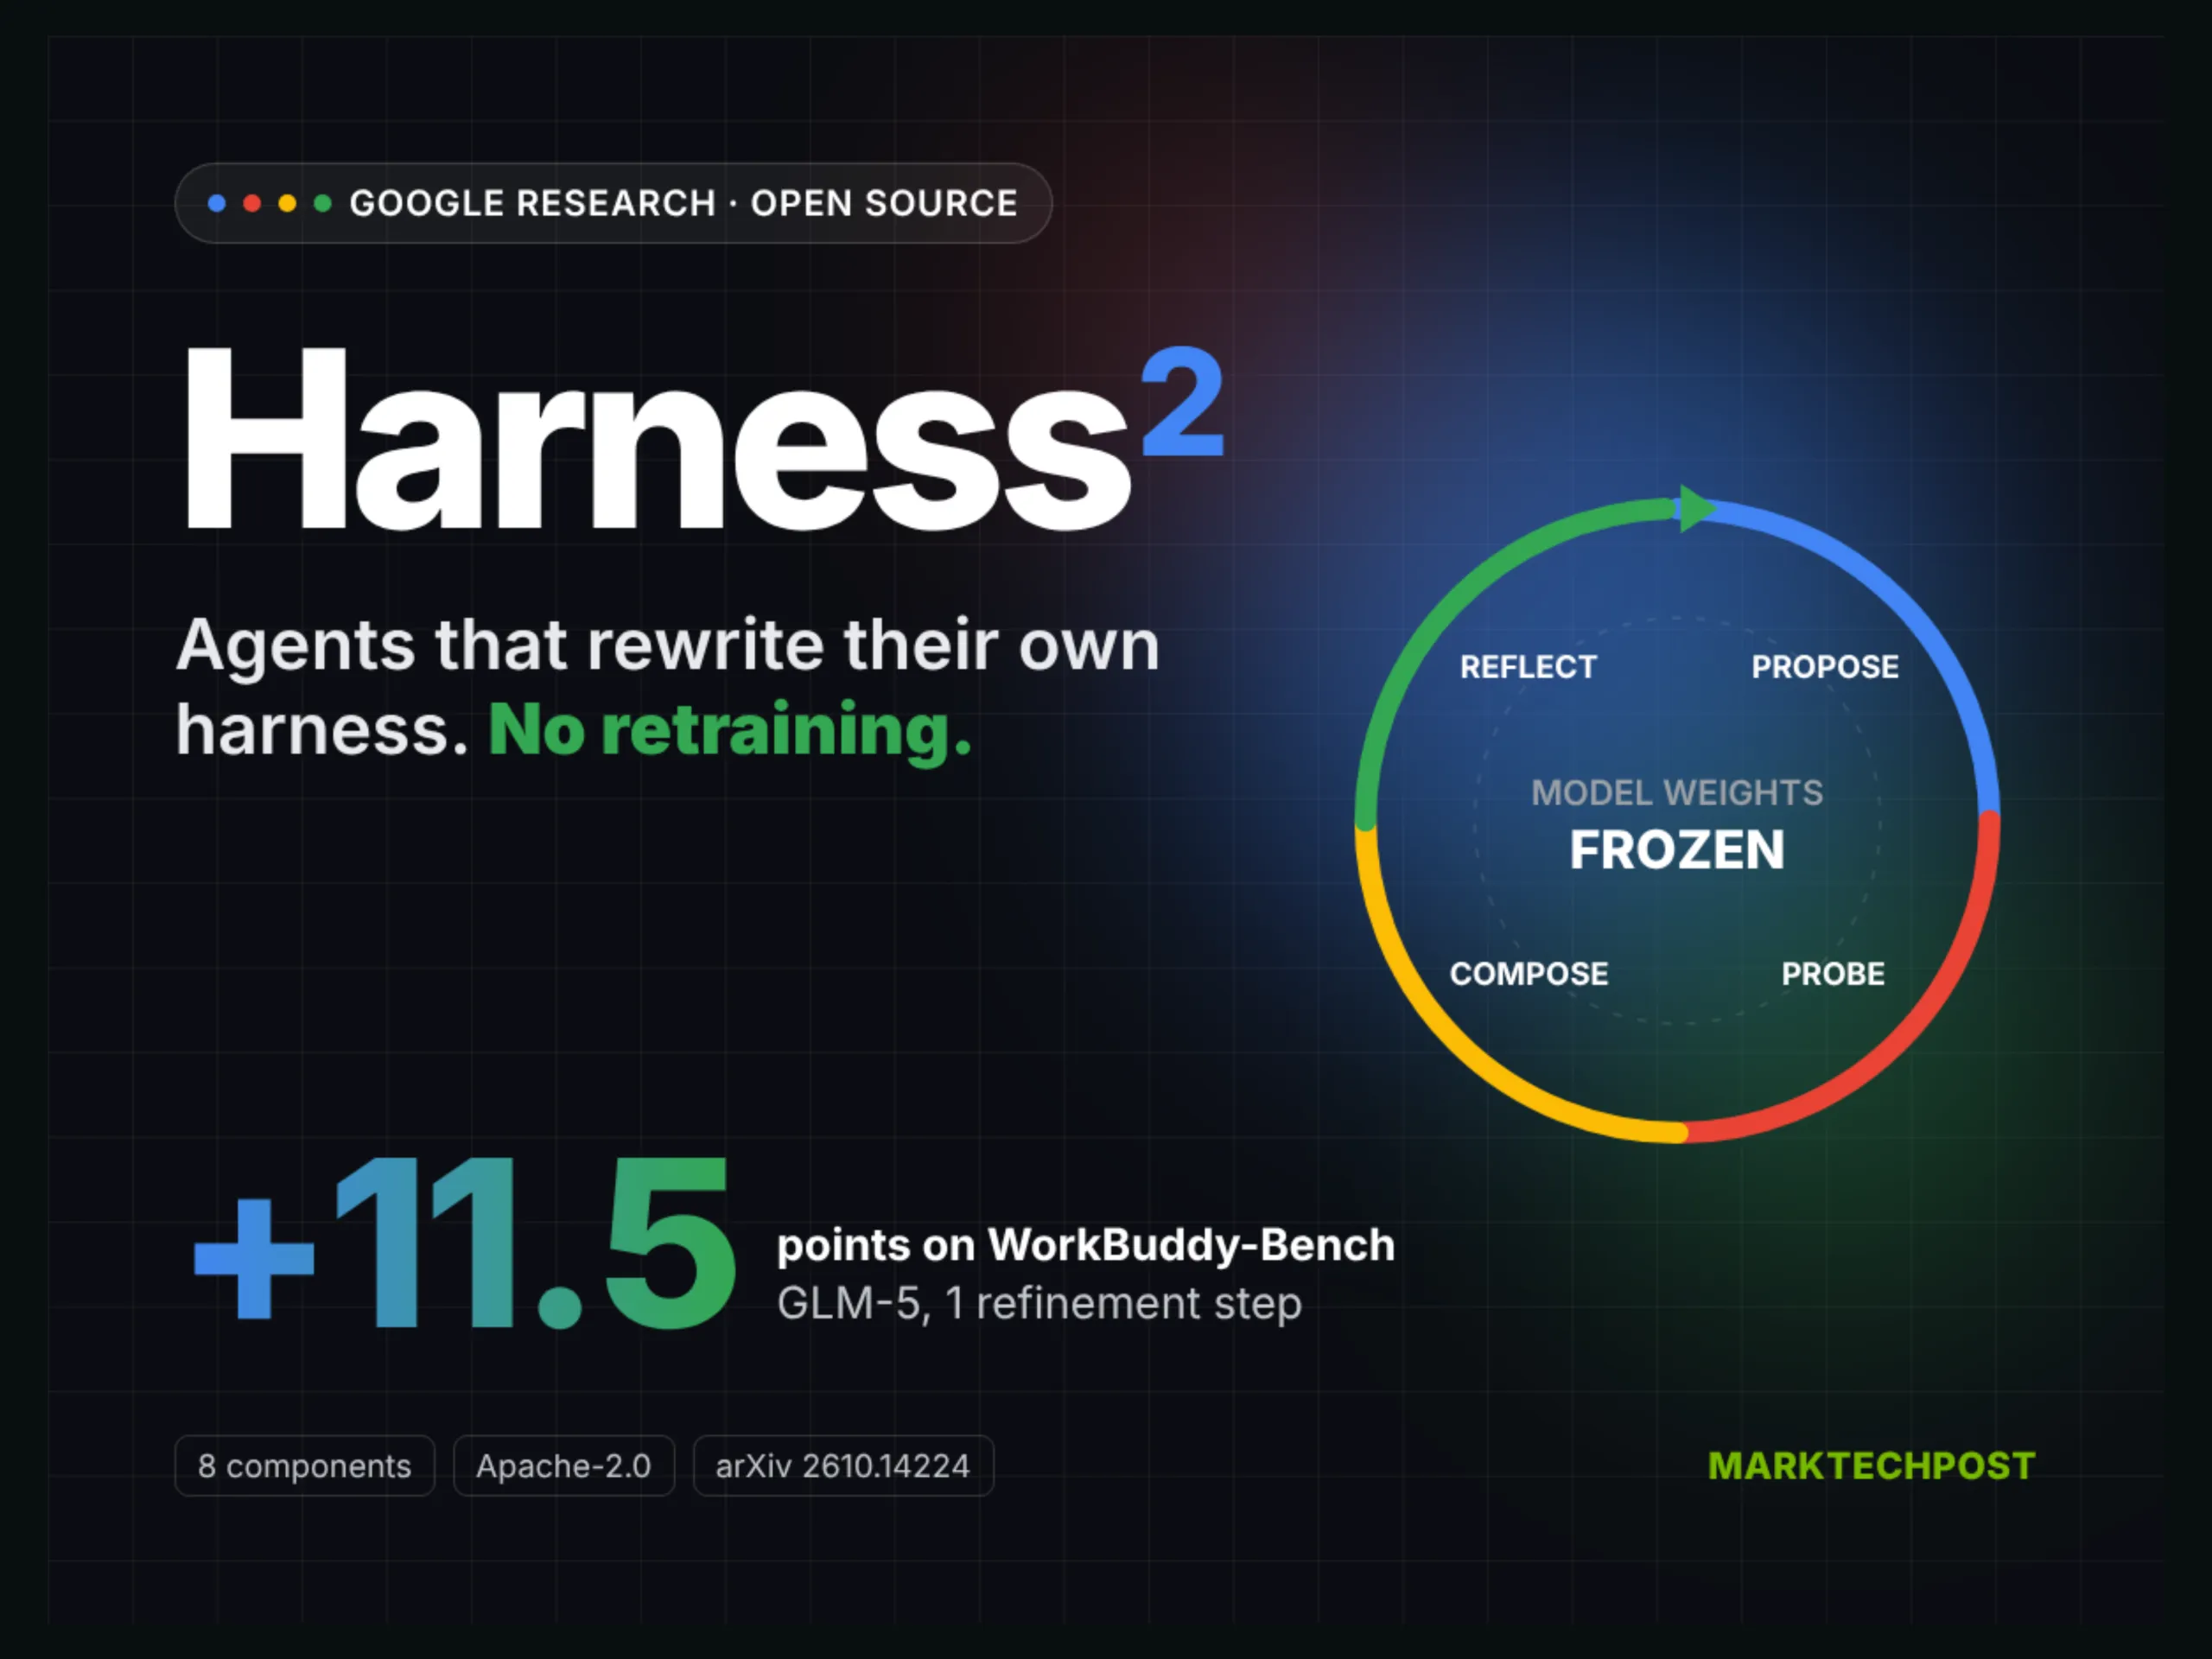
Google Cloud AI Research가 에이전트의 모델을 대체하지 않고도 실행 환경을 개선할 수 있는 재귀적 프레임워크 Harness²를 공개했다. 이 프레임워크는 동결된 모델 주변의 코드와 파일을 다듬어, 더 좋은 모델을 사용하지 않고도 에이전트 성능을 높이려는 접근을 취한다. 공개된 버전은 0.1.0이며, 학습된 파라미터는 없고 파일 형태로 편집 가능한 하네스 구성 요소는 8개다.
모델이 아니라 에이전트를 둘러싼 환경을 바꾼다
Harness²에서 하네스는 모델 그 자체보다 광범위한 개념이다. 프롬프트, 도구, 메모리, 스킬과 오케스트레이션이 모두 모델 주변의 시스템에 포함되며, 이 환경을 최적화하는 과정이 하네싱에 해당한다. 모델 가중치는 변경되지 않으며, 프레임워크는 실제 배치 단계에서 에이전트의 하네스를 개선하도록 설계됐다.
하네스의 편집 대상은 각각 파일로 마운트되는 8개 구성 요소다. 이 구성 요소는 문맥 구성, 도구 인터페이스, 위임과 도구 루프 내부의 행동을 포괄한다. 즉, Harness²의 접근은 정답이 주어지는 폐쇄형 환경보다 정답을 알려 주는 검증자가 없는 개방형 환경에 맞춰져 있다. 프레임워크는 라벨이나 테스트 케이스를 전제로 하는 많은 자기 개선 방식과 달리, 그러한 지표 없이도 작동하도록 설계됐다.
Propose·Probe·Compose로 실패를 behavioural 차이로 검증한다
Harness²의 핵심은 작업 수준 재귀와 하네스 수준 재귀라는 두 연결된 단계다. 작업 수준 재귀는 기준 하네스로 작업을 실행한 뒤 편집자가 후보를 제안하고, 같은 작업에서 후보를 비교한 다음 관찰된 행동으로 뒷받침되는 편집만 남기는 대비형 Propose·Probe·Compose 절차를 사용한다.
편집자가 제안하는 후보에는 일반적인 에이전트 실패를 겨냥하는 invariant 후보와 현재 도메인의 지식과 절차를 다루는 domain 후보가 포함된다. composer는 기준 실행과 두 후보의 궤적을 비교하며, 단순히 후보가 더 잘 풀어 보였다는 이유가 아니라 실제 행동 차이가 있는 편집만 채택한다. 이 방식은 정답 레이블을 대체하는 직접적인 증거로, 후보가 만든 행동의 차이에 초점을 둔다.
작업 처리가 끝나면 반사는 채택한 하네스와 교훈 문서인 EXPERIENCE.md를 저장한다. 이 경험 라이브러리는 이후 제안에 활용되지만, 새 작업은 다시 기본 하네스에서 시작한다. 병렬 모드는 invariant 후보 k개와 domain 후보 k개를 탐색한 뒤 k번 조합하며, 순차 모드는 k개의 개선 단계를 이어 붙인다. 탐색 폭이 커질수록 작업당 추가 모델 실행과 비용도 늘어난다.
세 벤치마크에서 나타난 성능과 실행 비용
구현 환경은 Linux, Python 3.12 또는 3.13과 uv를 대상으로 하며, 모델 실행에는 Vertex AI를 사용한다. GPU 요구 사항은 공개되지 않았다. 모델 기반 실행에는 Node.js 20 이상, Google Cloud CLI와 Vertex AI 프로젝트가 필요하며, LAB에는 Pandoc과 Poppler, WorkBuddy-Bench에는 Docker가 요구된다. 실행기는 기본적으로 OpenCode이며 Codex는 별도 옵션으로 지정한다.
평가에는 WorkBuddy-Bench, JobBench, Harvey’s LAB 등 3개 전문 벤치마크가 사용됐다. 실행 모델은 Gemini 3.5 Flash와 GLM-5, 실행 환경은 OpenCode와 Codex였고, 기본 편집기는 Claude Opus 4.8이었다. 결과는 3회 실행의 평균으로 제시됐다. 한 번의 개선 단계가 4개 모델·하네스 조합과 3개 벤치마크 모두에서 성능을 높였지만, 개선 폭은 환경에 따라 달랐다.
WorkBuddy-Bench에서 OpenCode를 사용한 GLM-5는 64.2점에서 75.7점으로 11.5점 상승했다. 병렬 재귀의 k를 5로 설정한 Gemini과 OpenCode 조합은 같은 벤치마크에서 80.8점을 기록했다. 작업당 단계도 감소했는데, WorkBuddy-Bench의 4개 조합 가운데 3개에서 필요한 단계 수가 줄었고 Gemini과 OpenCode 조합은 25.4단계에서 21.9단계로 감소했다. 반면 JobBench에서 Codex를 사용한 GLM-5의 가장 작은 개선은 23.6점에서 24.8점으로 1.2점 상승에 그쳤다.
하네스 최적화의 실무 조건과 검증 과제
Harness²의 가치는 모델 학습 없이 테스트 시점에 하네스를 다시 작성하는 데 있다. 다만 추가 실행이 발생하므로 비용 예측과 실행 격리가 함께 필요하다. 외부 명령이 도구 인터페이스를 통해 작동하는 만큼 샌드박싱도 직접 구성해야 한다. 원문을 인용한 Harness² 공개 보도는 성능 수치를 소개했지만, 정확한 세부 구성과 재현 조건은 논문과 저장소를 함께 확인해야 한다.
이 프레임워크가 제시하는 변화는 더 큰 모델을 즉시 도입하는 대신, 이미 배치된 에이전트의 계획과 도구 사용을 실행 과정에서 보정하는 쪽이다. Propose·Probe·Compose는 후보의 우열을 정답표가 아니라 행동 차이로 판단하고, EXPERIENCE.md는 채택된 교훈을 다음 작업의 제안으로 연결한다. 하네스 최적화가 성능 개선만의 문제가 아니라 모델 호출 수, 격리 환경, 재현 가능한 평가 설계가 함께 요구되는 실행 전략으로 자리 잡는다는 점이 핵심이다.
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Google Open-Sources Harness2, a Recursive Agent Harnessing Framework