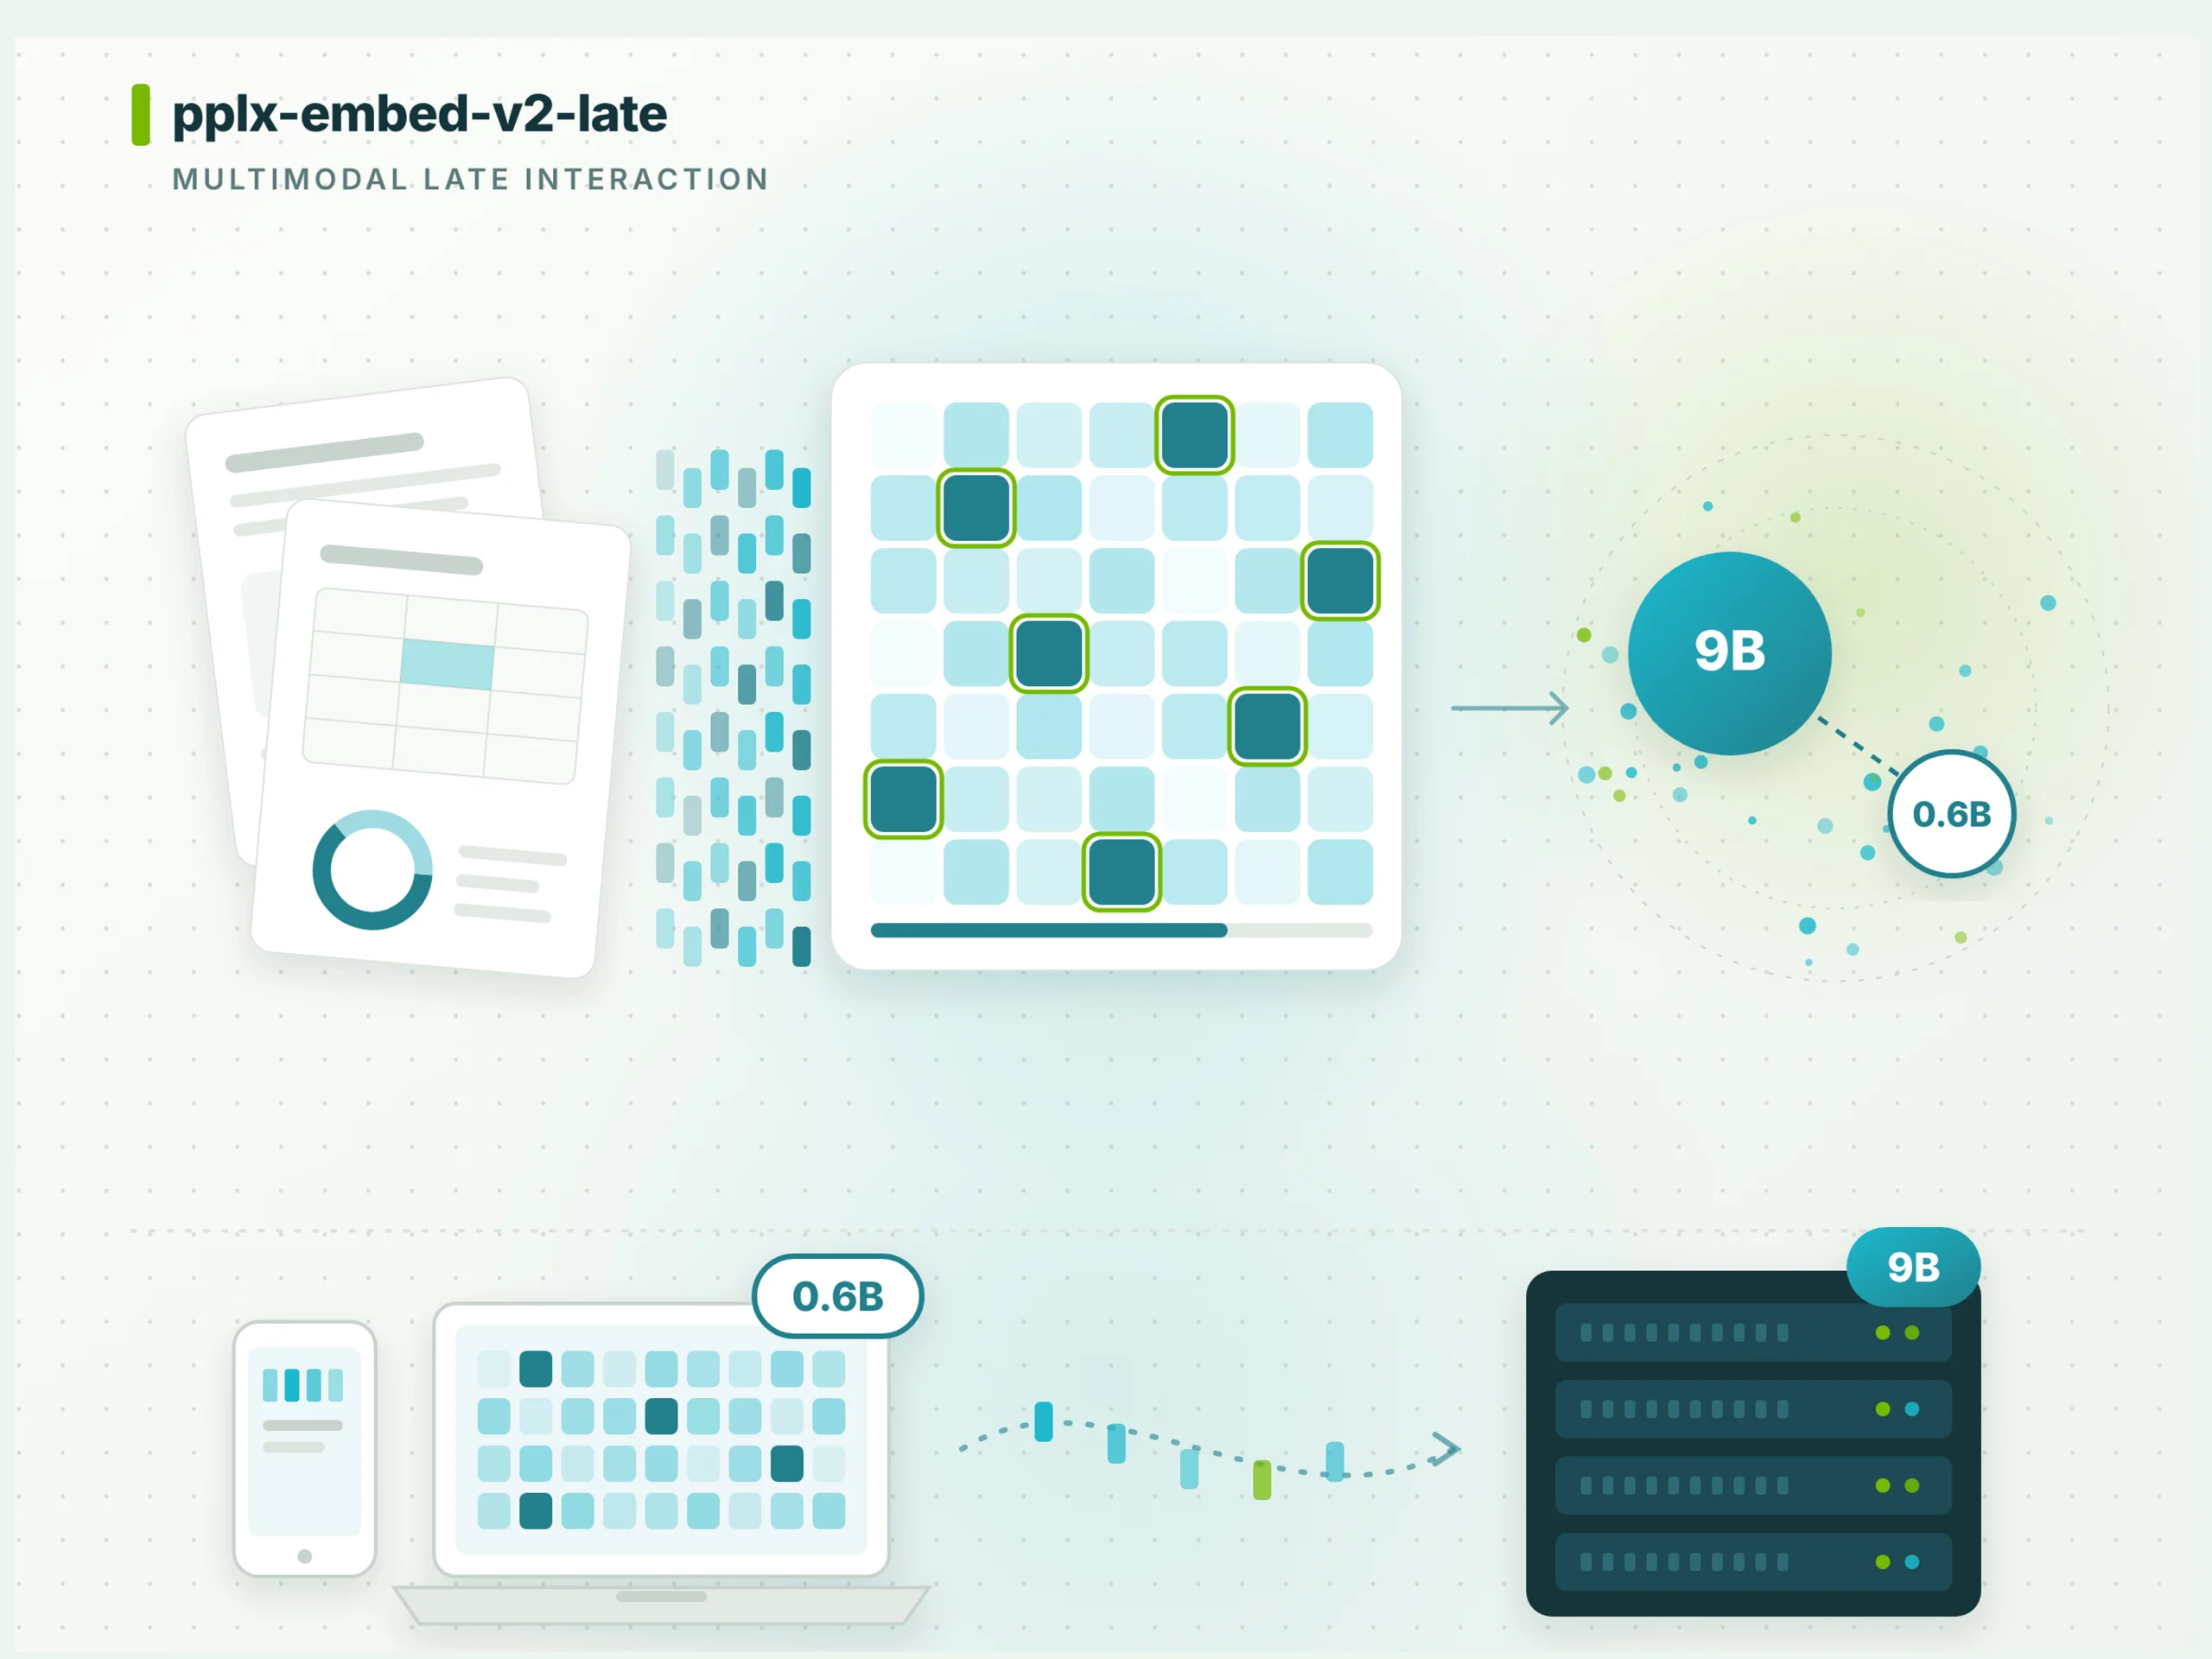
Perplexity가 2026년 10월 공개한 pplx-embed-v2-late는 ColBERT 스타일 late interaction을 텍스트·이미지·렌더링된 PDF 페이지에 단일 임베딩 공간으로 통합한 멀티모달 모델이다. 9B 모델은 에이전틱 PDF QA 벤치마크 MADQA에서 92.4%를 기록했고, 0.6B 모델은 ViDoRe v3 Markdown에서 61.2%로 최저선을 그렸다. 두 모델은 18B 티처로부터 LEAF 증류로 같은 임베딩 공간을 공유하기 때문에 9B 인덱스 위에 0.6B 쿼리 인코더를 얹는 혼합 운용이 가능하다.
목차
한 줄 요약
pplx-embed-v2-late는 dense 임베딩이 놓치는 토큰 단위 매칭을 MaxSim으로 회복하면서도, 토큰당 벡터 차원을 128로 줄여 저장 비용을 통제한다. MIT 라이선스로 Hugging Face에서 자체 호스팅할 수 있지만 호스팅 API는 아직 제공되지 않으므로, 도입 결정은 인프라 팀의 운용 역량과 직결된다.
왜 ColBERT 임베딩 late interaction이 다시 부상하는가
dense 임베딩 모델은 문서 전체를 1개의 2,048~4,096차원 벡터로 압축한다. 이 방식은 코사인 유사도 한 번으로 후보를 추리는 1단계 검색에는 최적화돼 있지만, “A 규제 면제 조항이 B 조항을 어떻게 수정하는가”처럼 두 문서 구간 사이의 미세한 정합을 묻는 질문에서는 정밀도가 급격히 떨어진다. ColBERT 계열 late interaction은 이 문제를 MaxSim으로 해결한다. 쿼리의 모든 토큰이 문서의 모든 토큰과 독립적으로 점수를 매기고, 그 최댓값을 합산하기 때문이다.
pplx-embed-v2-late는 같은 철학 위에서 두 가지를 과감하게 축소했다. 첫째, 토큰당 벡터 차원을 128로 줄였다. 경쟁 모델이 2,048~4,096차원을 쓰는 것과 비교하면 16~32배 가깝다. 둘째, 텍스트·이미지·PDF 페이지를 같은 인코더에 통과시켜 멀티모달 검색을 단일 파이프라인으로 묶었다. OCR 단계 없이 PDF를 그대로 이미지 인코딩하기 때문에 스캔본과 슬라이드까지 동일한 인덱스에 흡수된다.
필자가 현업에서 RAG 파이프라인을 붙여본 바로는, dense 모델로 1차 후보를 걸러낸 뒤 ColBERT 스타일 리랭커로 정밀도를 다지는 2단 구조가 실무 표준이 되어가고 있다. 이런 흐름에서 128차원 late interaction은 “1단계부터 정밀도”를 노리는 선택지로 읽힌다.
두 모델의 역할 분담: 0.6B는 쿼리, 9B는 인덱스
Perplexity는 0.6B와 9B를 동시에 출시했지만 권장 운용 방식은 비대칭이다. 문서 인덱스는 9B로 구축해 검색 품질을 확보하고, 실시간 쿼리는 0.6B로 처리해 지연과 비용을 낮추는 것이다. 두 모델이 같은 임베딩 공간을 공유하기 때문에 이런 혼합 운용이 수학적으로 성립한다.
하드웨어 가이드도 분리된다. 0.6B 모델은 bf16 기준 약 1.2GB로 RTX 3090/4090 한 장에서 충분히 돌아가고, 9B 모델은 약 18GB를 차지해 A100 40GB 또는 H100급이 필요하다. 0.6B 모델은 이미지 입력 시 약 340M 파라미터를 활성화하는데, 이는 일부 8B dense 멀티모달 모델과 근접한 성능을 단일 GPU에서 뽑아낸다는 의미다.
현장에서 가장 흔한 실수는 두 모델을 “크기만 다른 옵션”으로 이해하고 동일한 워크로드에 동일 모델을 적용하는 것이다. 인덱스 품질은 빌드 시점에만 중요하지만 쿼리 모델은 매 요청마다 호출되므로, 비용-품질 곡선은 비대칭이라는 점을 설계 단계에서 명확히 분리해야 한다.
벤치마크 디섹션: 92.4%와 61.2% 사이
pplx-embed-v2-late가 공개한 점수는 도메인별로 큰 편차를 보인다. 가장 두드러진 건 MADQA 92.4%로, PDF 문서 기반 에이전틱 QA에서 9B 모델이 최고점을 찍었다. 반면 같은 모델이 도메인 특화 텍스트 검색에서는 9B도 최고 수준에 못 미치고, ViDoRe v3 Markdown에서 0.6B 모델은 61.2%로 최저선을 그렸다.
| 평가 항목 | 0.6B | 9B | 비고 |
|---|---|---|---|
| MADQA (에이전틱 PDF QA) | 89.1% | 92.4% | 9B 최고점 |
| ViDoRe v3 이미지 검색 | 62.3% | 63.5% | 9B+0.6B 혼합 63.5% |
| ViDoRe v3 Markdown (nDCG@10) | 61.2% | 64.0% | 0.6B 최저점 |
| BrowseComp+ (텍스트 검색) | 73.0% | 76.5% | 9B 우세 |
표에서 드러나듯, 이미지와 PDF에서는 두 모델의 격차가 좁은 반면 텍스트 도메인과 Markdown 구조화 문서에서는 9B가 명확한 우위를 보인다. EVIE·Mixedbread·Gemini Embedding 2와 비교했을 때 pplx-embed-v2-late는 멀티모달 영역에서 선두권에 들어와 있지만, 순수 텍스트 검색에서는 전용 텍스트 임베딩 모델을 완전히 대체하지는 못한다.
혼합 크기 인덱싱의 실무 효과
ViDoRe v3 이미지 검색에서 9B 인덱스 + 0.6B 쿼리 조합은 63.5%를 기록했다. 0.6B+0.6B(62.3%)보다 1.2포인트 높고, 9B+9B(63.5%)와 동등하다. 텍스트 도메인에서는 9B 품질 격차의 약 절반을 0.6B 쿼리 비용으로 회복할 수 있다는 게 Perplexity 측 주장이다.
현업에서 이 패턴이 특히 유효한 시나리오는 두 가지다. 첫째, 의료·법률처럼 PDF·슬라이드 비중이 높은 코퍼스. 둘째, 엣지 디바이스나 온프레미스 환경에서 사용자 쿼리를 처리해야 하는 SaaS. 인덱스는 한 번만 빌드하므로 무거운 모델을 묶어두고, 사용자 요청 경로만 가볍게 유지하는 구도가 자연스럽게 맞아떨어진다.
다만 토큰당 벡터를 저장하는 late interaction의 본질적 특성 때문에, 인덱스 크기는 문서 길이에 선형으로 증가한다. PLAID·ColBERTv2 같은 토큰 인덱서로 압축하지 않으면 10만 페이지 코퍼스에서 디스크 사용량이 dense 임베딩 대비 수십 배까지 부풀어 오를 수 있다. Qdrant·Milvus 같은 벡터 DB를 쓸 때도 토큰 ID를 별도 키로 관리하는 스키마 설계가 필요하다.
배포 시 알아야 할 제약
pplx-embed-v2-late를 실제 인프라에 올리기 전에 확인해야 할 제약이 여럿 있다.
- 체크포인트 포맷: F32로 배포돼 bf16 대비 다운로드 크기가 2배다. 9B 모델은 약 36GB, 0.6B은 약 2.4GB를 받게 되므로 컨테이너 이미지 빌드 시 캐시 전략을 미리 설계해야 한다.
- 단일 입력 제약: 한 번의 인코딩 호출에 텍스트와 이미지를 섞을 수 없다. PDF 페이지는 이미지 경로로만 처리되며, 페이지별 텍스트 추출을 함께 쓰려면 후처리 파이프라인을 별도로 구성해야 한다.
- 라이브러리 버전: sentence-transformers 6.0.0 이상, transformers 5.4.0 이상을 요구한다. 기존 5.x 코드베이스와 호환되지 않으므로 의존성 업데이트 범위를 먼저 점검해야 한다.
- 자체 보고 벤치마크: 모든 점수는 Perplexity의 자체 측정이며 기술 보고서는 아직 미발행 상태다. 도입 전에는 사내 코퍼스에서 A/B 리그레션 테스트를 돌려 실제 성능을 확인하는 게 안전하다.
- API 미제공: 호스팅 엔드포인트가 없으므로 모든 운영 부담이 자체 팀으로 귀속된다.
에이전틱 워크플로우 전반의 도구 통합 설계를 다시 점검하는 흐름은 MCP 비판 3가지 — 에이전트 도구 통합, 다시 설계해야 하는 시점에서 다룬 적 있는데, 임베딩 단계도 동일한 맥락에서 도구 계약을 새로 그려야 할 시점에 와 있다.
지금 바로 해볼 것
pip install "sentence-transformers>=6.0.0" "transformers>=5.4.0"로 의존성을 올린 뒤model = SentenceTransformer("perplexity-ai/pplx-embed-v2-late-0.6B")로 0.6B 모델을 로드해 GPU 메모리 피크와 첫 토큰 지연을 측정한다.- 사내 PDF 100건으로 9B 인덱스와 0.6B 인덱스를 각각 빌드한 뒤 동일 쿼리셋으로 nDCG@10을 비교한다. 이때 pplx-embed-v2-late 출시 공지의 벤치마크가 사내 코퍼스에서 그대로 재현되는지 확인한다.
- 9B 인덱스를 PLAID 또는 ColBERTv2 토큰 인덱서로 압축해 디스크 점유율과 검색 지연을 함께 측정한다.
indexer.encode_for_index(docs, max_document_length=512)형태로 토큰 길이를 제한해 인덱스 폭발을 방지한다. - 쿼리 경로에는 0.6B 모델을 얹고 응답 지연 p95가 SLA를 만족하는지 부하 테스트를 돌린다. 이미지 입력 시 활성 파라미터가 340M으로 늘어나는 점을 감안해 동시 요청 수를 산정한다.
- Hugging Face 모델 카드에서 MIT 라이선스 고지를 확인하고 사내 법무팀에 상업적 사용 범위를 공유한다. 호스팅 API 부재 사실을 운영 위키에 명시해 후속 팀이 같은 질문을 반복하지 않도록 한다.
자주 묻는 질문
기존 dense 임베딩으로 구축한 인덱스를 갈아엎어야 하나요?
필수는 아니다. dense 모델로 1차 후보를 걸러낸 뒤 pplx-embed-v2-late로 리랭킹하는 2단 구조가 현실적인 마이그레이션 경로다. 인덱스 전체를 재구축하기 전, 리랭킹 단계에서 비용 대비 정확도 향상을 먼저 측정해 의사결정 근거를 만들면 팀 내 설득이 수월해진다.
0.6B 모델로도 멀티모달 검색이 충분한가요?
이미지·PDF 검색에서는 9B와의 격차가 1~2포인트 수준으로 좁다. 하지만 텍스트 도메인과 Markdown 문서에서는 9B가 명확한 우위를 보이므로 코퍼스 구성에 따라 모델 선택이 갈린다. 의료 PDF 위주라면 0.6B, 법률 계약서·기술 문서 혼합이라면 9B 인덱스가 안전하다.
토큰당 벡터 저장으로 인한 비용을 어떻게 예측하나요?
공식은 (평균 토큰 수 × 128 × 4바이트) × 문서 수다. 100토큰짜리 문서 10만 건이면 약 5GB, 512토큰으로 늘면 약 25GB다. PLAID 압축을 적용하면 5~10배 수준으로 줄어들지만, 압축 라이브러리 호환성과 검색 품질 트레이드오프를 사전 검증해야 한다.
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Perplexity AI Releases pplx-embed-v2-late: A 0.6B Edge Model and a 9B Model Scoring 92.4% on MADQA