핵심 요약
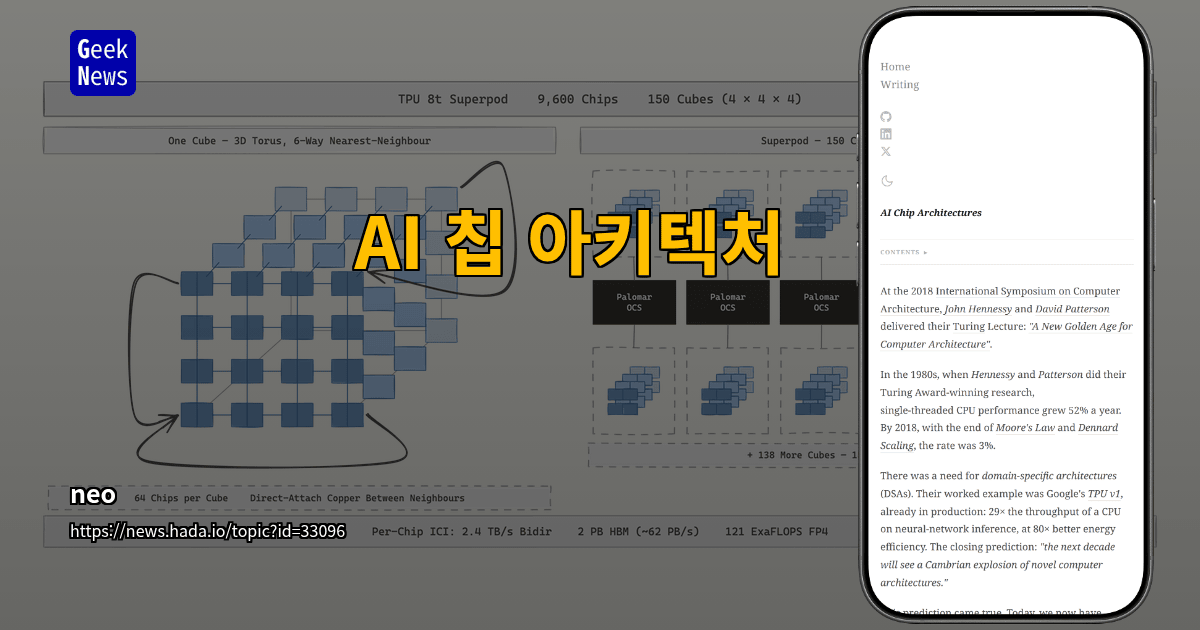
- 1980년대에는 단일 스레드 CPU 성능이 연 52%씩 증가했으나, 2018년에는 증가율이 3%까지 하락해 범용 CPU만으로 AI 연산 수요를 감당하기 어려운 구조로 전환됨
- AI 연산은 도메인 특화 아키텍처(Domain-Specific Architecture) 경쟁의 중심에 자리 잡았으며, NVIDIA GPU, Google TPU, AMD Instinct, Cerebras WSE, AWS Trainium, Groq LPU 등 다양한 벤더가 각자의 설계 철학으로 시장에 진입함
- 각 칩은 서로 다른 데이터 이동 방식을 채택하고 있어, 단순한 연산 성능(FLOPs) 비교만으로는 실제 워크로드 효율을 판단하기 어려운 상황임
분석
AI 칩 아키텍처는 이미 한 가지 정답으로 수렴하지 않았다. 1980년대에는 단일 스레드 CPU 성능이 매년 52%씩 끌어올려졌지만, 2018년에는 증가율이 3%까지 떨어졌다. Moore의 법칙이 무료 점심에 가까웠던 시대가 끝나자, AI 연산 수요는 그 빈자리를 채울 별도의 설계 언어를 요구하기 시작했다.
필자가 이 지점에서 가장 의미 있다고 보는 건, “칩을 어떻게 만드느냐”보다 “데이터를 어떻게 움직이느냐”가 AI 칩 아키텍처 경쟁의 중심축이 되었다는 점이다. 같은 FLOPs를 내걸어도 실제 워크로드 효율은 벤더마다 다르다. 그 차이가 곧 각 사의 설계 철학이다.
AI 칩 아키텍처가 갈라진 배경
2018년 3%까지 떨어진 성능 증가율은 트랜스포머 학습 같은 대규모 행렬 연산에 그대로 적용되지 않는다. NVIDIA는 GPU 기반 AI 칩 아키텍처로 먼저 시장을 열었고, Google은 TPU로 자체 워크로드에 맞춘 설계를 내놓았다. AMD Instinct, Cerebras WSE, AWS Trainium, Groq LPU까지 합류하면서 도메인 특화 아키텍처(DSA) 경쟁이 본격화됐다.
Cerebras WSE는 웨이퍼 전체를 단일 다이처럼 쓰는 극단적 접근을 택했다. Groq LPU는 컴파일 타임에 데이터 흐름을 미리 고정해 메모리 대역폭 병목을 회피한다. AWS Trainium은 가격 대비 성능을, Google TPU는 텐서 코어와 고대역폭 메모리(HBM)를 묶어 행렬 연산을 가속한다. 같은 AI 칩 아키텍처 범주에 묶이지만 작동 원리는 서로 다르다.
데이터 이동 방식이 AI 칩 아키텍처의 효율을 가른다
실무자 입장에서 눈에 띄는 건 FLOPs 스펙시트가 워크로드 성능과 직결되지 않는다는 사실이다. 메모리 계층과 상호연결 설계가 같은 연산량 대비 효율을 좌우한다. NVIDIA GPU는 HBM과 NVLink, NVSwitch로 대역폭과 확장성을 동시에 잡았고, TPU는 팟(pod) 단위 토폴로지로 데이터센터급 확장에 집중했다.
Groq LPU의 결정적 차이는 어디에 데이터를 두느냐가 아니라 언제 보내느냐에 있다. 결정론적 실행(deterministic execution)을 채택해 메모리 지연 변동을 제거한다. Cerebras WSE는 온다이 SRAM을 극대화해 외부 메모리 왕복 자체를 줄였다. 같은 AI 칩 아키텍처 안에서 데이터 이동의 답이 갈라진 셈이다.
트랜스포머 학습 구간이 미치는 영향
트랜스포머의 학습과 prefill 단계는 행렬-행렬 곱셈 비중이 높다. 이 구간은 메모리 대역폭보다 연산 처리량에 무게가 실린다는 뜻이다. H100, MI300, TPU v5p 같은 칩은 텐서 코어와 HBM을 묶어 처리량을 끌어올렸다. GeekNews의 AI 칩 아키텍처 토픽에 따르면 이 구도가 도메인 특화 칩 경쟁의 중심축으로 자리 잡았다.
반면 decode 단계처럼 토큰 단위 생성이 반복되는 구간은 메모리 대역폭이 병목이 된다. 같은 AI 칩 아키텍처가 양쪽을 모두 커버하기 어렵기 때문에, 실무에서는 워크로드 비율에 따라 칩을 혼합 배치하는 구도가 흔해졌다. a16z의 AI 밸류체인 종주 전략에서도 살펴봤듯, 칩 선정은 단순 스펙 비교에서 워크로드 단위 의사결정으로 이동하고 있다.
쟁점 정리
AI 칩 아키텍처 경쟁은 세 갈래로 수렴한다. 첫째, GPU는 범용성과 생태계 우위를 무기로 한다. 둘째, TPU·Trainium은 자체 워크로드 최적화로 비용 효율을 노린다. 셋째, Cerebras·Groq LPU는 메모리 병목을 회피하는 대체 경로를 제시한다. 어느 쪽이 정답인지는 워크로드 특성에 따라 갈린다.
AI 칩 아키텍처 선정 시 반드시 확인할 지표
단일 스레드 CPU 성능 증가율 52%→3%라는 수치는 단순 회고가 아니라 현재 의사결정의 출발점이다. 칩을 비교할 때 FLOPs만 보면 같은 함정에 빠진다. 메모리 대역폭(GB/s), HBM 용량, 상호연결 토폴로지(NVLink·ICI·이더넷), 그리고 워크로드 단계별 처리량까지 함께 봐야 실제 효율이 나온다.
필자가 현장에서 자주 보는 실수는 “벤치마크 점수가 좋다”만으로 칩을 고르는 경우다. 실제 학습·추론 파이프라인에서는 데이터 전처리와 통신 오버헤드가 전체 시간의 30~50%를 잡아먹는다. 이 구간을 AI 칩 아키텍처의 메모리 계층과 함께 따져야 한다.
지금 바로 해볼 것
- 현재 학습·추론 파이프라인의 단계별 시간 비율을 프로파일링한다(전처리, 학습, 통신, decode).
- 대상 칩의 HBM 용량과 메모리 대역폭을 GB/s 단위로 정리해 배치 크기와 매칭한다.
- decode 비중이 높은 워크로드는 LPU, 학습·prefill 비중이 높은 워크로드는 GPU/TPU로 구분해 혼합 배치 시나리오를 검토한다.
- 상호연결(NVLink, ICI, 이더넷) 토폴로지가 다중 노드 확장에서 병목이 되는지 시뮬레이션한다.
- 분기마다 칩 벤더의 새 릴리즈 노트를 추적해 메모리 계층과 데이터 이동 방식 개선점을 기록한다.
자주 묻는 질문
AI 칩 아키텍처에서 가장 중요한 지표는 무엇인가요?
FLOPs만으로는 부족합니다. 메모리 대역폭, HBM 용량, 상호연결 토폴로지, 그리고 워크로드 단계별 시간 비율을 함께 봐야 실제 효율이 나옵니다.
Groq LPU는 GPU와 무엇이 다릅니까?
Groq LPU는 결정론적 실행으로 메모리 지연 변동을 제거합니다. 외부 메모리 왕복을 줄여 decode 단계처럼 토큰 단위 생성에 강점을 보입니다.
TPU와 Trainium 중 어떤 칩을 선택해야 하나요?
자체 워크로드가 Google Cloud 안에 머문다면 TPU가 유리하고, AWS 환경에 종속적이며 가격 대비 성능을 우선한다면 Trainium이 후보입니다. 둘 다 도메인 특화 칩이지만 생태계 의존도가 다릅니다.
Cerebras WSE는 어떤 환경에 적합한가요?
단일 모델이 HBM 한계를 넘는 매개변수 크기를 다뤄야 할 때 검토할 만합니다. 일반적인 학습·추론 파이프라인에서는 비용 대비 ROI를 확보하기 어렵습니다.