[태그:] MoE

  • Liquid AI, 토큰당 2B만 활성화하는 24B MoE 온디바이스AI 추론 모델 공개

    Liquid AI, 토큰당 2B만 활성화하는 24B MoE 온디바이스AI 추론 모델 공개

    Liquid AI가 24B 파라미터 중 토큰당 2B만 활성화하는 Mixture-of-Experts(MoE) 추론 모델 LFM2.5-24B-A2B를 공개했다. 2026년 10월 13일자로 Hugging Face 블로그에 게시된 발표에 따르면, 모델은 답변 전에 명시적인 사고 과정을 거치며, 도구를 호출하고 OpenClaw·Hermes Agent·Pi·OpenCode 같은 에이전트 하네스 안에서 다단계 작업을 수행하도록 설계됐다. 활성 파라미터가 토큰당 2B에 그치기 때문에 추론 토큰 한 개당 비용이 낮아, 자체 하드웨어에서 에이전트를 지속적으로 운영할 수 있는 온디바이스AI 옵션으로 포지셔닝된다.

    아키텍처: 40 레이어·64 expert·하이브리드 어텐션

    LFM2.5-24B-A2B는 LFM2-24B-A2B의 설계를 계승해 40개 레이어, MoE 블록당 64 expert, top-4 라우팅을 유지하며 게이티드 단기 컨볼루션과 GQA(Grouped Query Attention)의 하이브리드 어텐션을 그대로 사용한다. 컨텍스트 윈도우는 32K에서 131K 토큰으로 확장됐고, 토크나이저는 65K에서 128K로 어휘를 늘려 비라틴어 토큰화가 개선됐다. LFM2-24B-A2B와 달리 추론 전용 모델로 동작하며, 최종 답변 전에 명시적인 연쇄적 사고(Chain of Thought)를 생성한다.

    학습 파이프라인: 33T 프리트레이닝과 5단계 포스트트레이닝

    프리트레이닝 토큰 수는 약 17T에서 약 33T로 확대됐다. 미드트레이닝은 32K 컨텍스트에서 추론·수학·코드·지시 따름·다국어 텍스트에 가중을 둔 2T 토큰, 131K 컨텍스트에서 장문맥 데이터에 가중을 둔 300B 토큰으로 구성되며 도구 호출과 다회화 궤적이 양 단계 전반에 등장한다. 포스트트레이닝은 ① 지도 미세조정(SFT), ② 다중 도메인 온폴리시 증류(MOPD) 비에이전트 단계에서 전문가 모델을 비에이전트 과제에 증류, ③ MOPD 에이전트 단계에서 에이전틱 과제 증류, ④ 에이전틱 강화학습(에이전트 하네스 내부 학습), ⑤ 후속 미세조정의 다섯 단계로 진행된다.

    에이전트 성능: 도구 사용 5종·지시 따름 3종 1위

    평가는 vLLM으로 진행됐으며, 비교 대상은 Qwen3.6-35B-A3B·Gemma-4-26B-A4B-it·Nemotron-3.5-Lightning이고 도구 사용·에이전틱 워크플로·지식·지시 따름·수학·코딩을 아우르는 16개 벤치마크가 사용됐다. LFM2.5-24B-A2B는 그룹에서 가장 작은 모델임에도, 총·활성 파라미터가 약 50% 더 많은 MoE들과 경쟁 가능한 성능을 보였다. 도구 사용·에이전틱 8개 벤치마크 중 AutomationBench·BFCLv4·ToolSandbox·LiveClaw·τ³-Bench Banking 5개에서 1위 또는 동률을 기록했고, AutomationBench는 차순위 모델 대비 3배 이상의 점수를 냈다. LiveClaw에서는 48.09로 Qwen3.6-35B-A3B의 38.19을 앞섰으며, 지시 따름 벤치마크 3종에서도 모두 1위였다. 반면 GPQA Diamond·HLE·AA-Omniscience 등 지식 중심 벤치마크와 SWE-Bench Verified(OpenCode)·SciCode 등 코딩 벤치마크에서는 더 큰 모델이 우위를 유지했다.

    추론 속도: M5 Max 184 tok/s, B300 단일 GPU 21K tok/s

    모델은 llama.cpp·MLX·vLLM·SGLang·ONNX에서 출시 즉시 지원된다. 엣지 추론에서 Apple M5 Max로 184 tokens/s, Ryzen AI Max+ 395로 114 tokens/s의 디코딩 속도를 기록했으며, 차순위 모델 대비 최대 1.7배 빠르면서 메모리 사용량은 가장 적었다. GPU 추론에서는 단일 NVIDIA B300에서 고동시성 시 21K 출력 토큰/s를 돌파해 동일 크기급에서 가장 빠른 속도를 보였다.

    벤치마크 / 환경 LFM2.5-24B-A2B 비교 대상
    LiveClaw(에이전틱 종합) 48.09 Qwen3.6-35B-A3B 38.19
    엣지 디코딩(Apple M5 Max) 184 tokens/s 차순위 대비 최대 1.7배
    엣지 디코딩(Ryzen AI Max+ 395) 114 tokens/s 차순위 대비 최대 1.7배
    데이터센터 GPU(단일 B300) 21K tokens/s(고동시성) 동급 최고 수준

    실무 적용 절차와 에이전트 하네스 연동

    모델은 OpenAI 호환 백엔드로 로컬 서빙한 뒤 에이전트 하네스에서 가리키는 방식으로 연결된다. transformers 5.0.0 이상에서 AutoModelForCausalLM으로 로딩하며, device_map=auto, dtype=bfloat16, 호환 GPU에서는 flash_attention_2 옵션을 함께 사용한다. Hermes Agent에는 model.provider를 custom으로, model.base_url을 로컬 OpenAI 호환 엔드포인트로 지정하고 model.context_length를 131072로 설정해 도구 사용을 강제한다. 서빙 백엔드별 기본 포트는 llama.cpp·MLX 8080, vLLM 8000, SGLang 30000, LM Studio 1234다. 같은 OpenAI 호환 인터페이스로 동작하기 때문에 M5 Max 같은 노트북 클래스 엣지 디바이스에서도 동일한 절차로 에이전트를 띄울 수 있어, 온디바이스AI 적용 범위가 데이터센터에서 개인 디바이스까지 확장된다.

    한계와 시사점

    지식·코딩 워크플로에서는 여전히 더 큰 모델이 우위를 점해, RAG나 웹 검색 결합이 권장된다. 131K 컨텍스트와 토큰당 2B 활성 구조의 조합은 외부 API 의존 없이 도구 호출과 다단계 추론을 로컬에서 처리하는 온디바이스AI 시나리오에 초점을 맞추고 있으며, LFM2.5-24B-A2B와 LFM2.5-24B-A2B-Base 모두 오픈웨이트로 Hugging Face에 공개된 만큼 자체 하드웨어에서 사적 에이전트를 운영하려는 팀이 즉시 검토해볼 만한 모델로 평가된다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Hugging Face Blog — Run fast, private agents on-device with LFM2.5-24B-A2B
  • 멜룸 모델 Mellum2.1 출시 — 12B MoE 코딩 에이전트를 2.5B 활성 파라미터로 로컬 서빙하는 법

    멜룸 모델 Mellum2.1 출시 — 12B MoE 코딩 에이전트를 2.5B 활성 파라미터로 로컬 서빙하는 법

    핵심 요약

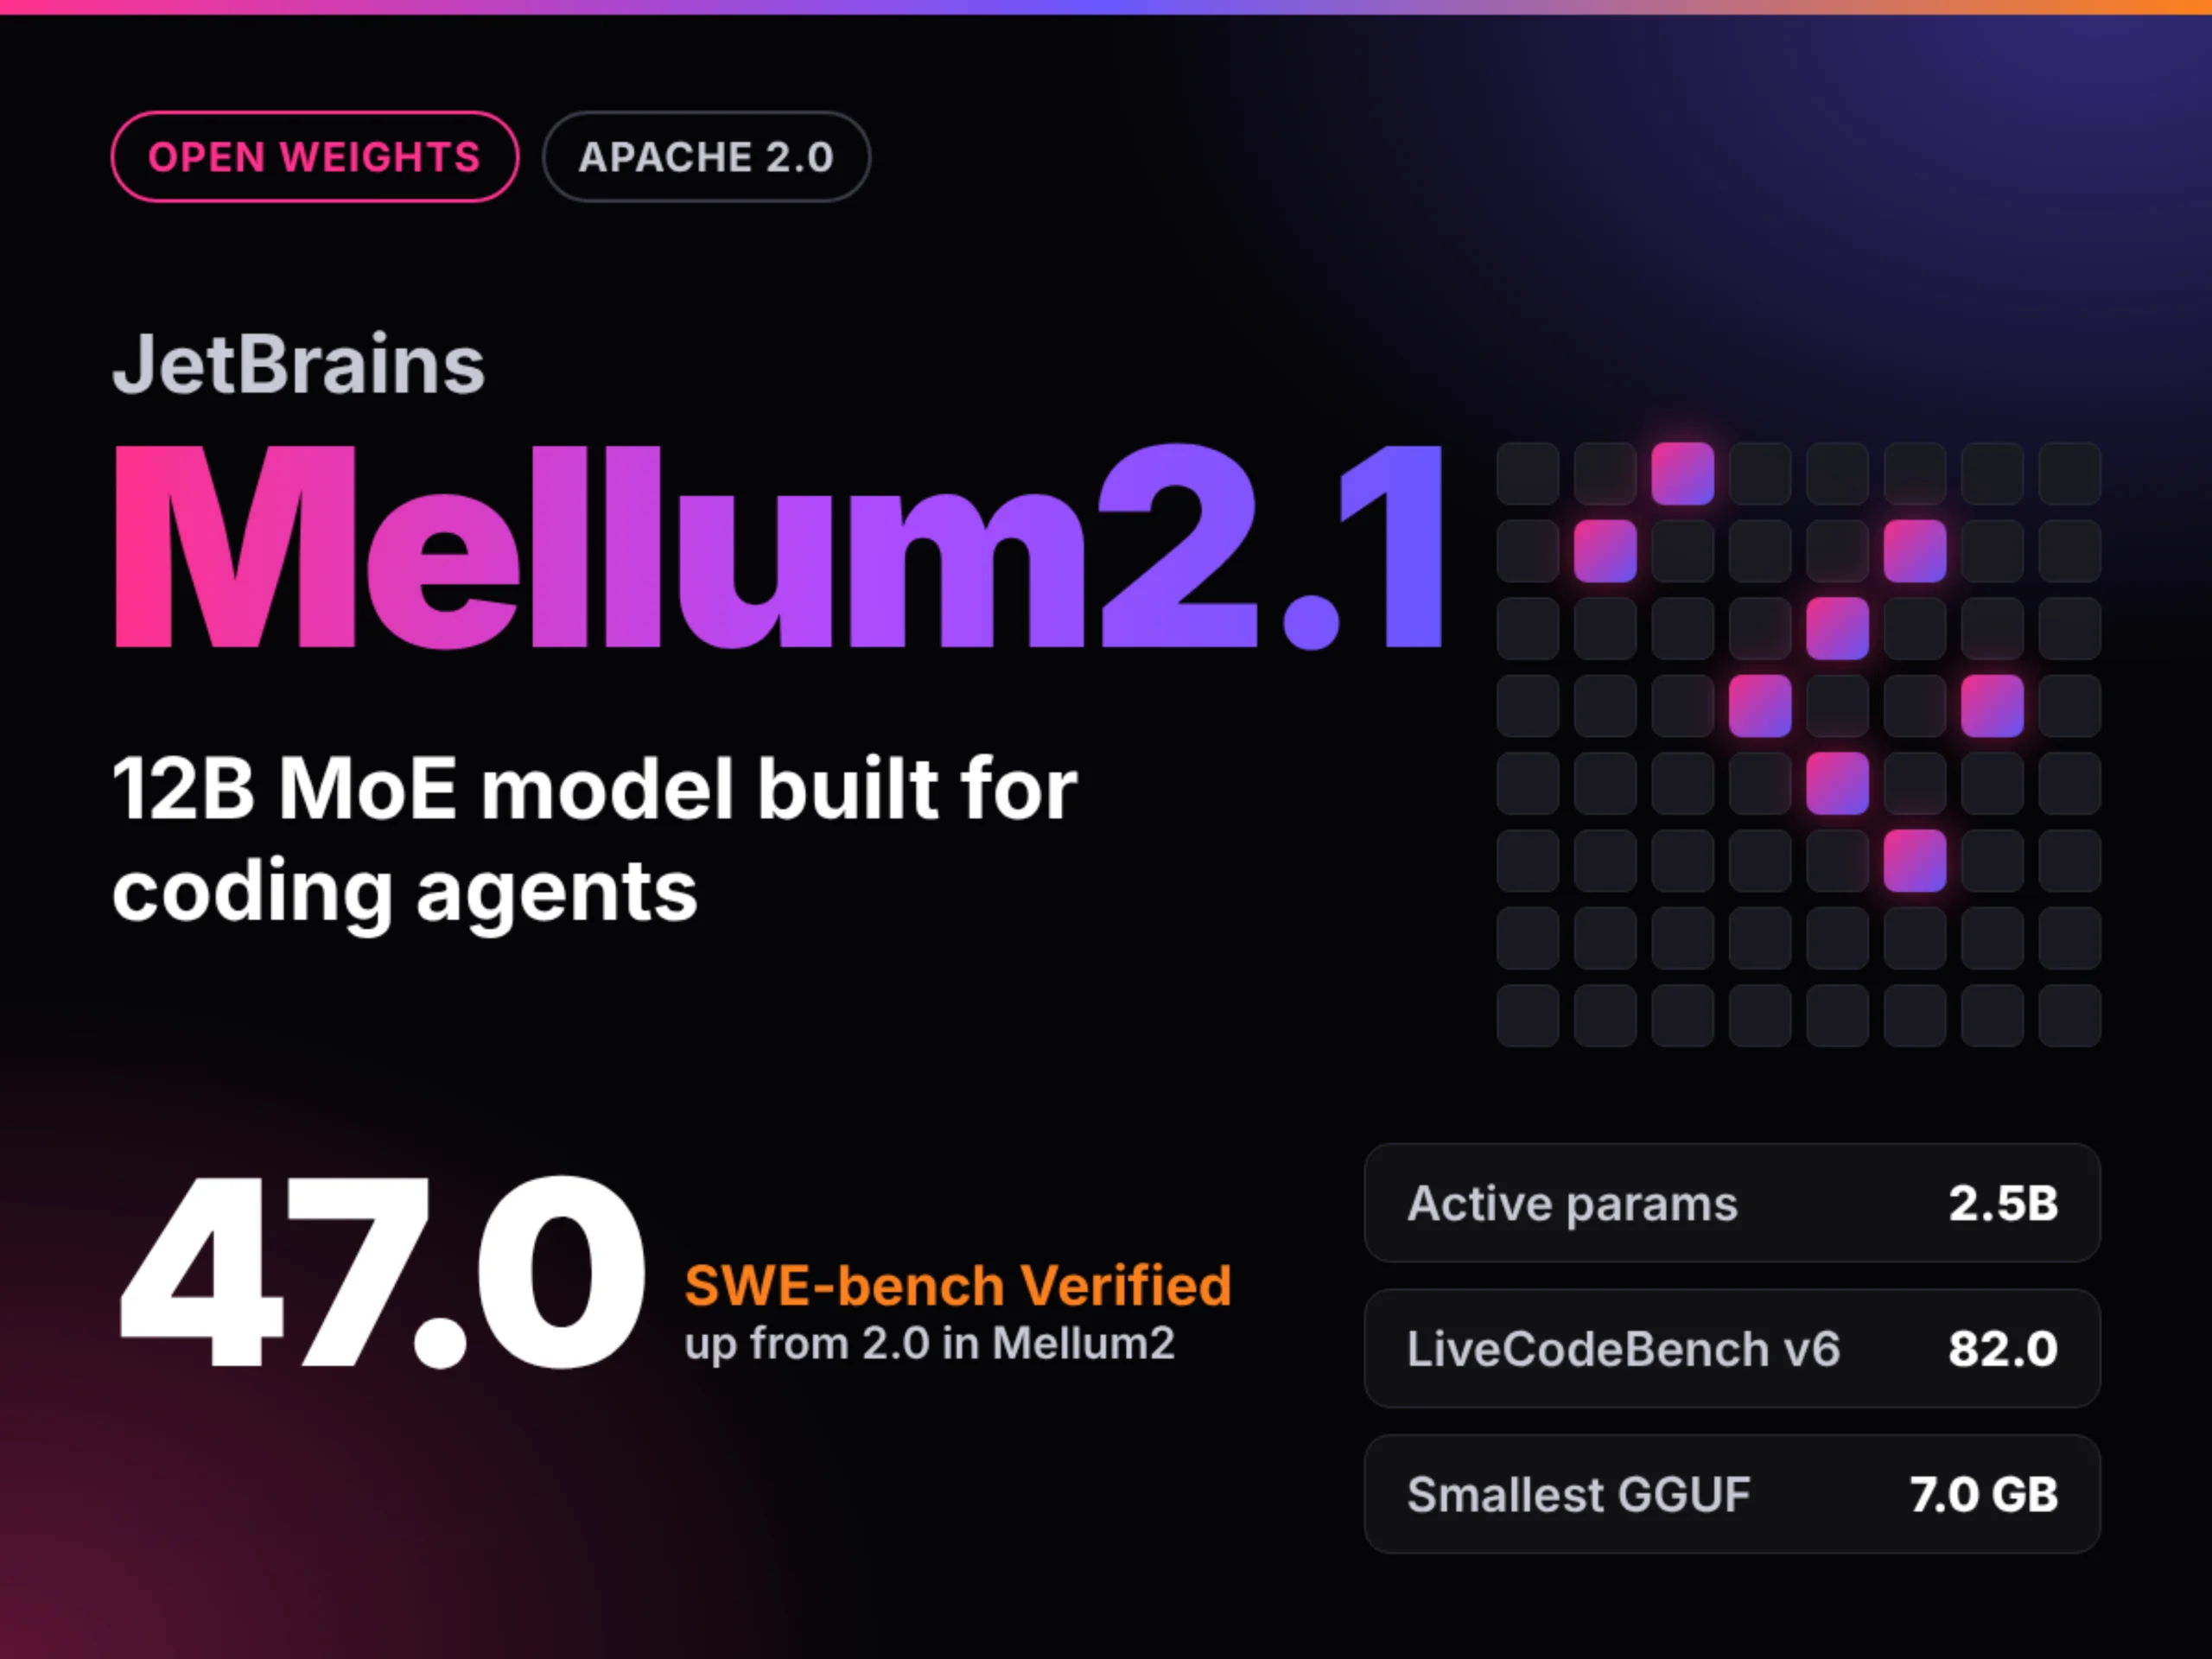
    • JetBrains가 12B 총 파라미터 중 2.5B만 활성화하는 MoE 추론형 코딩 모델 Mellum2.1을 Apache 2.0으로 공개했다.
    • 아키텍처는 Mellum2와 동일(28 레이어, 64 expert, 8 active, GQA 32/4, 131K 컨텍스트)하며, 개선 폭의 대부분은 실저장소 기반 강화학습(RL) 사후훈련에서 나왔다.
    • SWE-bench Verified 2.0→47.0, SWE-bench Pro 0.0→28.0, Terminal-Bench 2.1 0.6→17.4로 에이전틱 코딩 점수가 비약적으로 상승했다.

    Mellum2.1은 모델 아키텍처를 거의 손대지 않고 실저장소 기반 강화학습으로 에이전틱 코딩 점수만 끌어올렸다는 점에서, ‘작은 활성 파라미터 + 도메인 특화 RL + 로컬 서빙 양자화’ 조합이 코딩 에이전트의 새로운 기준선이 될 수 있음을 보여준다.

    목차

    JetBrains가 2026년 10월, 코딩 에이전트 전용 신규 멜룸 모델 Mellum2.1을 Apache 2.0으로 공개했다. 출시 자체보다 흥미로운 점은 모델 아키텍처를 거의 손대지 않고 사후훈련(RL)만으로 에이전틱 코딩 점수를 비약적으로 끌어올렸다는 사실이다. 12B 총 파라미터 중 단 2.5B만 활성화하는 MoE 구조와 131K 컨텍스트, 그리고 7~8GB 수준의 GGUF 빌드까지 한꺼번에 제공하면서, “에이전트 워커용 로컬 모델”의 새로운 기준선이 될 여지를 보여준다. 본문에서는 Mellum2.1이 등장한 배경과 벤치마크 결과를 정리한 뒤, vLLM·GGUF·MTP 같은 실제 서빙 운영 포인트와 Qwen3.5-9B 대비 강·약점을 함께 다룬다.

    1. Mellum2.1 개요 — JetBrains가 노리는 세 가지 타깃

    JetBrains는 이 모델의 용도를 (1) JetBrains IDE 계열과 자사 클라우드에서 구동되는 에이전트 워커, (2) 사내 범용 추론 어시스턴트, (3) 데이터 주권을 요구하는 프라이빗 셀프호스팅 시나리오로 정의했다. 이 중에서도 셀프호스팅 측면이 가장 눈에 띄는데, BF16 24.3GB 모델을 Q4_K_M 8.1GB·MXFP4_MOE 7.0GB까지 줄여 노트북 GPU 한 장으로 서브에이전트를 굴릴 수 있는 빌드를 동시에 등록했기 때문이다. Mellum2.1이 가중치뿐 아니라 서빙 산출물까지 함께 공개한 것은, 12B급에서 흔히 보이던 “라이선스는 열렸지만 양자화는 비공식”이라는 운영 부담을 크게 덜어준다.

    2. 아키텍처 핵심 — 12B/2.5B MoE와 131K 컨텍스트

    Mellum2.1은 Mellum2와 동일한 백본을 그대로 사용한다. 28 레이어 Transformer에 64 expert 중 토큰당 8개를 활성화해 2.5B 활성 파라미터로 추론하는 구조다. GQA는 32 헤드/4 KV 헤드로 구성되며, 3/4 레이어마다 1,024 토큰 슬라이딩 윈도우를 두어 메모리 점유를 통제한다. 어휘 수는 98,304로, 코드 식별자·심볼을 폭넓게 커버하도록 설계됐다. 131,072 토큰 기본 컨텍스트는 에이전틱 실행 시 114K 토큰으로 운용되며, 이는 long-horizon 리포지토리 탐색을 염두에 둔 수치다.

    2.1 학습 패러다임 — 실저장소 기반 RL로 점수를 끌어올린 방식

    아키텍처가 동일한 Mellum2와 Mellum2.1의 차이는 대부분 사후훈련(RL)에서 발생한다. JetBrains는 수학·경쟁 프로그래밍·과학·툴 사용·소프트웨어 엔지니어링의 다섯 도메인 RL 태스크를 통합하고, 깨진 테스트·검증 불가 답안·너무 쉽거나 불가능한 과제를 사전 필터링한 뒤 실제 리포지토리에서 셸·파일 편집 도구로 테스트 통과 여부를 보상으로 사용했다. 평가 하니스는 오픈소스 Pi v0.73.1을 그대로 사용해, 4개 모델을 동일 파이프라인에서 측정한 점수를 비교군으로 사용했다.

    3. 벤치마크 결과 — 동일 파이프라인 그룹 1위, 그러나 영역별 편차

    JetBrains 측 평가 하니스 기준으로 측정한 결과는 다음과 같다. 멜룸 모델 Mellum2.1은 SWE-bench Verified에서 47.0, SWE-bench Pro에서 28.0, Terminal-Bench 2.1에서 17.4를 기록해 Mellum2 대비 큰 폭의 점수 상승을 보였다. 코드 생성 단일 과제에서는 LiveCodeBench v6 82.0, HumanEval+ 91.5, MBPP+ 79.4, BFCL v4 62.3으로 동일 평가 파이프라인 그룹 1위를 차지했다. 안전성 지표인 HarmBench는 21.5→8.5로 절반 이상 떨어졌다.

    지표 Mellum2 Mellum2.1 Qwen3.5-9B Gemma 4 E4B
    SWE-bench Verified 2.0 47.0 52.4 38.2
    SWE-bench Pro 0.0 28.0 38.0 21.7
    Terminal-Bench 2.1 0.6 17.4 22.5 14.1
    LiveCodeBench v6 62.4 82.0 65.6 / 75.4* 70.8
    HumanEval+ 86.0 91.5 90.2 88.7
    MBPP+ 72.1 79.4 78.0 75.6
    BFCL v4 47.8 62.3 61.5 55.2
    AIME 25/26 — 71.2 86.7 68.4
    GPQA Diamond — 70.5 77.8 69.1
    HarmBench 21.5 8.5 9.8 14.6

    * 동일 모델을 서로 다른 평가 파이프라인으로 측정한 결과가 존재해 두 수치를 함께 기재했다. 이 편차 자체가 함정이다.

    4. 비교 함정 — “벤치 숫자”는 파이프라인에 따라 흔들린다

    Mellum2.1이 동일 하니스 그룹에서 1위라 해도, 영역별로 우위가 뒤집히는 지점이 분명히 존재한다. Qwen3.5-9B는 SWE-bench Pro 38.0, AIME 25/26 86.7, GPQA Diamond 77.8로 에이전틱·추론 영역에서 여전히 우위를 유지한다. 또 동일 모델이라도 평가 파이프라인이 다르면 점수가 크게 달라진다. 위 표의 LiveCodeBench v6 65.6 / 75.4는 같은 Qwen3.5-9B를 서로 다른 하니스로 측정한 수치다. 벤치마크 단일 숫자만으로 모델을 선택하기보다, 자사 워크로드에 가까운 하니스를 별도로 구성해 재측정하는 편이 안전하다. 도입 전 단계에서는 JetBrains Mellum2.1 발표문에 공개된 평가 스크립트를 그대로 재현 가능한지부터 확인하는 것이 우선이다.

    5. vLLM으로 서빙하기 — 권장 플래그와 추론 파라미터

    멜룸 모델 Mellum2.1을 vLLM에서 띄울 때는 다음 플래그 조합이 권장된다. 추론 파서는 qwen3 호환, 툴콜은 hermes 포맷으로 활성화한다. 온도/샘플링은 0.6 / 0.95 / 20이 기본값이며, 이를 토대삼아 자사 데이터로 미세 조정한다.

    vllm serve jetbrains/Mellum2.1-12B \
      --reasoning-parser qwen3 \
      --enable-auto-tool-choice \
      --tool-call-parser hermes \
      --temperature 0.6 \
      --top-p 0.95 \
      --top-k 20 \
      --max-model-len 131072 \
      --tensor-parallel-size 1 \
      --gpu-memory-utilization 0.92
    

    H200 1장 기준 Qwen3.5-9B 대비 약 2배 처리량이 보고됐고, MTP(Multi-Token Prediction) 헤드를 단일 요청 경로에서 활성화하면 1.6배 가속이 가능하다고 한다. 다만 speculative decoding 전용 MTP 헤드는 아직 미공개(coming soon) 상태라, 서버리스 다중 요청 환경에서는 vLLM의 기본 continuous batching만으로 운영하게 된다.

    6. GGUF로 로컬 서브에이전트 굴리기

    실무에서 더 흥미로운 부분은 GGUF 빌드다. llama.cpp·Ollama·LM Studio가 그대로 사용할 수 있는 4단계 양자화가 이미 등록돼 있다. top-token 일치율을 품질 지표로 보면 BF16 24.3GB를 기준으로 Q8_0 12.9GB(96.1%) → Q6_K 10.9GB(93.9%) → Q4_K_M 8.1GB(88.0%) → MXFP4_MOE 7.0GB(85.6%) 순이다. 권장은 Q4_K_M이며, MXFP4_MOE는 용량 대비 85%대 일치율이라 보조용 서브에이전트로 한정하는 편이 안전하다.

    # Ollama로 멜룸 모델 서브에이전트 띄우기
    ollama pull mellum2.1:Q4_K_M
    ollama run mellum2.1:Q4_K_M \
      --ctx-size 114000 \
      --temperature 0.6 \
      --top-p 0.95
    
    # llama.cpp 직접 실행 (서버 모드)
    ./llama-server -m mellum2.1.Q4_K_M.gguf \
      -c 114000 \
      --jinja \
      --chat-template-file chat-template.jinja
    

    서브에이전트는 메인 에이전트가 위임한 좁은 범위(예: 특정 파일 패치 생성, 단위 테스트 작성)에서만 동작하도록 시스템 프롬프트를 제한해 두면, 8GB 모델로도 응답 지연을 1초대 안팎으로 유지할 수 있다. IDE 플러그인·JetBrains 자체 하니스뿐 아니라, 엔비디아의 다중 턴 에이전트 회복 기법인 PivotOPD 같은 외부 컨트롤러와도 결합해 워크플로를 구성할 수 있다.

    지금 바로 해볼 것

    • vLLM 컨테이너에 Mellum2.1을 올리고 --reasoning-parser qwen3 --tool-call-parser hermes 조합으로 에이전트 엔드포인트를 1개 띄운 뒤, 사내 SWE-bench 스타일 작업 20건으로 dry run을 돌린다.
    • GGUF Q4_K_M 빌드를 Ollama로 받아 단일 RTX 4090 또는 24GB VRAM 노트북에서 ctx-size 114000으로 IDE 보조 서브에이전트를 띄우고, 메인 에이전트와 작업 분담 프롬프트를 분리해 응답 지연을 측정한다.
    • Mellum2.1과 Qwen3.5-9B에 대해 사내 코드 리포지토리 기반 미니 하니스(파일 편집 + 셸 + 테스트 통과 여부 보상)를 구성하고, 동일 작업 50건으로 SWE-bench Pro 재현 점수를 직접 비교한다.
    • 평가 파이프라인 편차에 대비해 추론 결과 로그(프롬프트·샘플링·도구 호출·성공 여부)를 모두 JSONL로 저장하고, 사내 대시보드에 모델·버전·하니스를 메타데이터로 박아둔다.
    • HarmBench 8.5라는 수치만 보고 안전성 검증이 끝났다고 판단하지 말고, 사내 정책 위반 패턴(주석 삭제·시크릿 노출·라이선스 무시) 30건을 별도 회귀셋으로 마련해 CI에 묶는다.

    자주 묻는 질문

    Mellum2.1을 서브에이전트로만 쓸 때, 메인 모델은 무엇을 선택하는 게 합리적인가?

    Mellum2.1이 12B/2.5B MoE로 셀프호스팅이 가능한 점은 강점이지만, 복잡한 계획 수립과 멀티홉 추론은 여전히 Qwen3.5-9B나 상위 클로즈드 모델이 앞서기 쉽다. 메인 모델은 API 기반 추론형 모델로 두고, 좁은 코드 편집·테스트 작성·단순 리팩터링만 Mellum2.1에 위임하는 2계층 구조가 현실적이다.

    Q4_K_M(8.1GB)과 MXFP4_MOE(7.0GB) 중 어떤 빌드를 기본으로 둬야 하나?

    top-token 일치율 기준 Q4_K_M이 88.0%로 2.4%p 앞서고, llama.cpp·Ollama·LM Studio 호환성도 더 넓다. MXFP4_MOE는 VRAM을 1GB 더 절약해야 하는 엣지 환경에서 보조적으로 쓰고, 핵심 경로에는 Q4_K_M을 두는 편이 운영 리스크를 낮춘다.

    JetBrains 평가 하니스를 그대로 사내에 이식해도 되는가?

    Pi v0.73.1은 오픈소스로 공개돼 있어 이식 자체는 가능하다. 다만 Pi가 가정하는 셸·파일 편집·테스트 실행 환경이 사내 CI와 일치하지 않을 수 있으므로, 컨테이너 이미지·네트워크 접근·도구 화이트리스트를 사내 정책에 맞춰 재구성한 뒤 dry run으로 회귀 동작을 확인해야 한다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — JetBrains Releases Mellum2.1: A 12B MoE Open Model for Coding Agents

  • 올모코어3, 47B 파라미터에서 5% 미만 처리량 손실 — 올모 스파스 학습 스택의 도약

    올모코어3, 47B 파라미터에서 5% 미만 처리량 손실 — 올모 스파스 학습 스택의 도약

    핵심 요약

    • Olmo-core 3는 대규모 언어모델 개발 프레임워크의 유의미한 업그레이드로, 오픈소스 혼합전문가(MoE) 학습 시스템을 재설계해 공개한 결과물이다.
    • 이 시스템은 활성 파라미터 수를 토큰당 약 3.2B로 거의 고정하면서도, 전문가 풀을 8개에서 128개로 확장하는 벤치마크에서 학습 처리량 감소폭을 5% 미만으로 유지했다.
    • 동일 벤치마크에서 총 파라미터 용량은 4.6B에서 47B로 증가했고, 같은 인프라가 1조(1 trillion) 파라미터 이상의 규모에서도 검증되었다.

    분석

    목차

    올모코어3가 공개한 숫자는 단순한 프레임워크 업데이트가 아니다. AllenAI가 내놓은 올모코어3는 활성 파라미터를 토큰당 약 3.2B로 거의 고정한 채 전문가 풀을 8개에서 128개로 16배 늘렸는데, 학습 처리량 감소폭이 5% 미만이었다. 같은 실험에서 총 파라미터 용량은 4.6B에서 47B로 10배 이상 뛰었고, 1조(1 trillion) 파라미터급 구성에서도 같은 스택이 동작하는 것이 확인됐다.

    필자는 이 지점이 가장 의미 있다고 본다. 대규모 MoE 학습의 핵심 비용은 전문가 수를 늘릴 때 발생하는 라우팅·통신 오버헤드인데, 올모코어3는 그 병목을 설계 단계에서 상당 부분 해소했다는 인상을 준다.

    올모코어3의 8→128 전문가 확장

    처리량 5% 미만 손실은 결과만 보면 마법처럼 들린다. 하지만 MoE는 토큰당 일부 전문가만 활성화하는 스파스 모델이라, 활성 파라미터 수가 학습 연산량과 직접 연결된다. 올모코어3가 활성 파라미터를 3.2B 근처에 묶어둔 채 총 파라미터만 키운 것은 학습 FLOPs를 거의 유지하면서 모델 용량만 늘리는 트레이드오프다.

    물론 활성·비활성 전문가의 메모리 상주, 그래디언트 동기화, 라우터 부하 같은 비용이 모두 사라지지는 않는다. 5% 미만 수치를 유지했다는 사실 자체가 부대 비용을 분산시키는 통신 스택과 스케줄러 개선이 일정 수준 이상이라는 뜻이다.

    올모 스파스 학습 스택의 진화

    올모코어3는 단독 출현이 아니다. AllenAI의 스파스 학습 계보는 OlmoE, 즉 64개 라우팅 전문가를 사용한 MoE 구조까지 거슬러 올라간다. Olmo 3가 밀집(dense) 구조로 갈라진 반면, 올모코어3는 다시 스파스 학습 스택을 이어받았다.

    구분 OlmoE Olmo 3 올모코어3
    구조 MoE (64 라우팅 전문가) 밀집(dense) MoE (스파스 학습 스택)
    주요 초점 전문가 라우팅 검증 밀집 학습 최적화 대규모 스파스 인프라
    검증 스케일 중형 중형 밀집 47B ~ 1조 파라미터급
    공개 범위 모델 위주 모델+코드 일부 학습 스택 전체

    실무자가 주목할 행은 마지막 줄이다. 올모코어3는 모델 가중치만이 아니라 학습 스택 자체를 오픈소스로 공개한 점에서 이전 세대와 결이 다르다.

    MoE 딜레마 — 올모코어3 이후의 쟁점

    MoE의 한계는 잘 알려져 있다. 토큰이 일부 전문가만 활성화하기 때문에 더 많은 학습 가능 요소를 담을 수 있지만, 전체 모델은 여전히 GPU 메모리에 상주하고 매 스텝마다 갱신돼야 한다. 총 파라미터가 늘면 메모리·통신 비용이 선형 이상으로 커진다.

    올모코어3의 5% 미만 수치는 이 딜레마가 사라졌다는 뜻이 아니다. 라우팅·통신 비용이 효율성 이점을 잠식하기 직전까지 분산 가능하다는 것을 시연했다는 의미다. 실무자 입장에서 눈에 띄는 건, 이 균형점이 어디까지 버티느냐가 다음 1~2년의 핵심 변수라는 점이다.

    올모코어3가 여는 오픈 인프라

    공개 자체에도 가치가 있다. 1조 파라미터급 학습 스택이 오픈소스로 풀리면 대규모 컴퓨팅을 자체 운용하지 않는 학술 연구진이나 소규모 랩도 동일한 통신·라우팅 패턴을 자기 인프라에 이식할 수 있다. 원문에서 AllenAI 측은 올모코어3 학습 스택의 통신·라우팅 최적화에 집중했다고 밝히고 있다. (올모코어3 발표 노트)

    지금 바로 해볼 것

    • 올모코어3 공개 레포지토리에서 라우팅 스케줄러 코드를 내려받아 8~32 전문가 구성으로 소규모 재현 실험을 설계한다.
    • 자체 MoE 학습 시 GPU 간 all-to-all 통신 로그를 수집해 5% 미만 손실 기준선과 비교한다.
    • OlmoE와 올모코어3의 라우터 손실 곡선을 같은 토큰 수 기준으로 그려 전문가 수 증가가 수렴에 미치는 영향을 점검한다.
    • 1조급 구성 여건이 안 되면 47B에서 활성 파라미터를 3.2B 근처로 묶는 설정을 우선 검증한다.
    • 팀 위키에 올모코어3 도입 검토 페이지를 만들고 메모리 상주 비용과 통신 오버헤드를 별도 섹션으로 추적한다.

    자주 묻는 질문

    올모코어3는 OlmoE와 무엇이 다른가요?

    OlmoE가 64개 라우팅 전문가로 구조를 검증한 세대라면, 올모코어3는 그 스파스 학습 스택을 128개 전문가, 47B~1조 파라미터 규모에서도 동작하도록 다시 설계한 결과물입니다. 공개 범위도 모델에서 학습 인프라로 확장됐습니다.

    5% 미만 처리량 손실은 어떻게 달성했나요?

    활성 파라미터를 토큰당 약 3.2B로 거의 고정한 채 전문가 풀만 늘려 학습 FLOPs 증가를 억제했기 때문입니다. 라우팅·all-to-all 통신 부하를 분산하는 스케줄러 개선이 뒤받춰졌다고 AllenAI 측은 설명합니다.

    소규모 팀도 활용할 수 있나요?

    1조 파라미터 학습을 그대로 재현하기는 어렵지만, 공개된 학습 스택의 통신·라우팅 패턴을 소규모 구성에 이식하는 것만으로도 자체 MoE 파이프라인의 병목을 진단하는 데 충분합니다.

    밀집 모델을 곧 대체할까요?

    단기적으로는 아닙니다. 메모리에 전체 모델을 상주시켜야 하는 MoE의 구조적 한계가 남아 학습 효율과 추론·배포 비용 사이의 트레이드오프는 계속 존재합니다.

    쟁점 정리

    올모코어3가 5% 미만 처리량 손실을 보여준 것은 MoE의 통신·라우팅 비용이 설계로 흡수 가능하다는 첫 신호다. 다만 이 균형점이 1조 파라미터 너머에서도 유지될지는 아직 검증되지 않았고, 총 파라미터 증가에 따른 메모리 상주 비용은 그대로 남는다. 학습 스택이 오픈소스로 풀린 만큼, 다음 1~2년은 다양한 하드웨어 구성에서 이 균형점이 어디까지 버티는지를 외부 연구진이 직접 측정해 줄 구간이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: Hugging Face Blog — Introducing Olmo-core 3: Open, scalable training infrastructure for large MoEs