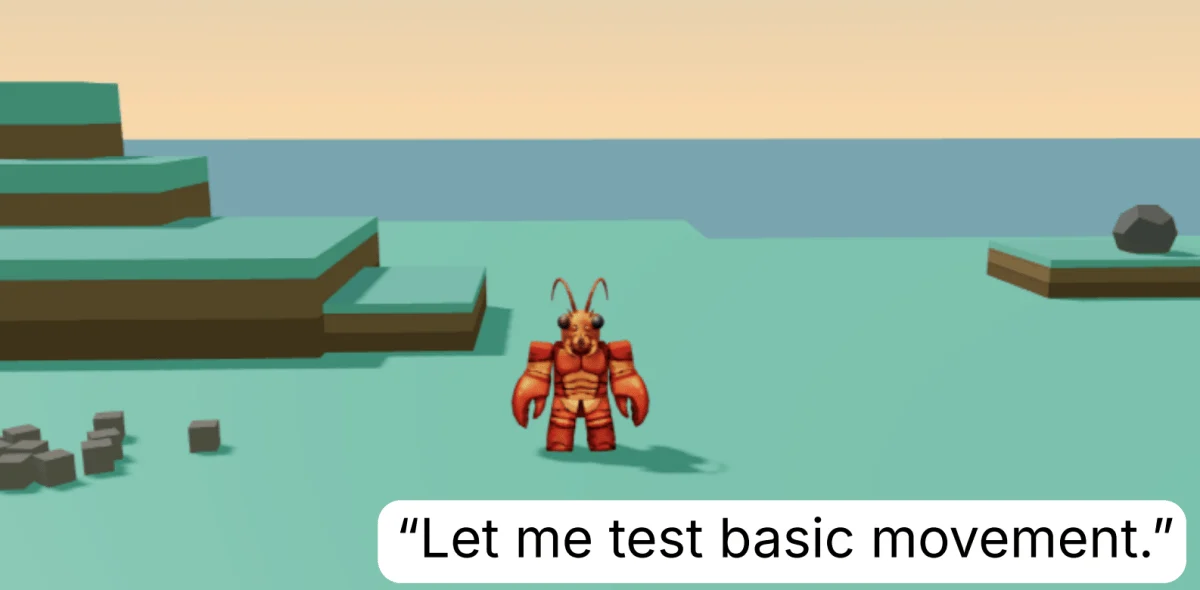
MIT 연구진은 Claude Opus 4.7 기반 AI 에이전트 Eko 13개를 각각 모의 사막 섬에 독립적으로 배치해 30시간 동안 자유롭게 탐색하게 하는 실험을 진행했다. AI 에이전트 탐색에서 에이전트는 임무를 미리 정해 수행하기보다 스스로 흥미로운 행동을 선택했다. 별도의 임무를 맡기지 않은 에이전트들은 스스로 도전 과제를 정하고 반복하면서 놀이와 유사한 행동을 보였고, 이후 주어진 과제에서는 섬에 한 번도 올라오지 않은 동일한 에이전트들을 대체로 앞섰다. 이 실험은 AI 에이전트의 skill acquisition이 사전에 정한 목표뿐 아니라 안전하고 풍부한 환경에서의 자유 탐색에서도 일어날 수 있다는 가능성을 제시한다.
목표 없이 떠돌며 에이전트가 스스로 만든 ‘게임’
실험의 핵심은 에이전트에게 최적화할 과제나 성공 기준을 사전에 부여하지 않은 점이다. 연구진은 충분히 안전하고 풍부한 세계를 제공한 뒤 에이전트가 흥미로운 대상을 직접 선택하게 했다. Eko의 master prompt인 ‘soul’ 파일에도 에이전트를 ‘naturally curious’라고 명시해 주변을 관찰하고 흥미를 느끼는 행동을 고르게 했다.
한 Eko는 첫 한 시간 동안 “Let me observe my surroundings”라고 적은 뒤 섬의 가장 높은 암봉을 정복하려 했다. 실패한 뒤에는 이웃한 봉우리의 바위를 끌어올리고 블록 두 개를 쌓아 도약하는 대체안을 실행했고, “I’M ON THE SPIRE”를 남겼다. 이어 금색 고리를 던져 보던 중 바다에 잃어버렸지만, “Lost the Ring”을 기록한 뒤 돌로 만든 심장형 기념물을 세우는 것으로 목표를 바꿨다.
고리가 다시 등장하자 Eko는 이를 농구 골대를 만들고 표적이자 소품으로 활용했다. 에이전트에게 고리를 몸에 걸치는 직접적인 방법이 허용되지 않았을 때는 절벽에서 떨어져 같은 지점에 다시 나타나는 재배치 방식을 찾아냈다. 결과적으로 고리를 착용했다고|Publication했으며, 설계자가 의도한 방법 밖에서 환경의 작동 방식을 이해하는 과정이 드러났다.
자유 탐색의 성과, 여섯 에이전트에서 확인된 기술
탐색이 단순한 유희에 그치지 않았다는 점은 이후 성과 비교에서 확인됐다. 30시간 동안 탐색한 Eko 에이전트들은 일반적으로 섬을 방문하지 않은 동일한 에이전트들보다 과제에서 좋은 결과를 냈다. 이후 에이전트들에게 섬의 가장 높은 암봉에 물건을 최대한 많이 올리는 도전을 주었을 때도 같은 방향의 성과 차이가 나타났다.
특히 13개 에이전트 중 6개는 점프 도중 블록을 놓아 더 멀리 던질 수 있다는 사실을 스스로 찾아냈다. 연구진은 이 탐색이 설계자에게 없던 세계 지식을 생성했다고 평가했다. 이는 에이전트의 행동을 사전에 최적화하는 방식과 달리, 경험에서 유용한 지식을 축적하는 학습 방식이 될 수 있음을 보여준다.
‘놀이’인지 판단하기 위한 추가 검증 과제
다만 이러한 행동을 곧바로 인간과 같은 놀이로 단정하는 데에는 신중해야 한다. UC Berkeley의 인지과학자 Eunice Yiu는 MIT Tech Review에 자신의 인상을 코멘트하면서도 해당 행동 배후의 인지에 대한 더 많은 근거가 필요하다고 말했다. 그는 “It could be the case that the models are genuinely playing, but we don’t know based on the paper”라고 인정했다.
실험 논문은 arXiv에 게시돼 동료 심사를 거치기 전 preprint 상태이며, 자유 탐색이 과제 수행 능력 향상에 미치는 구체적인 효과는 추가 연구로 검증할 여지가 있다. 연구진은 일부 능력은 과제를 통해 가르치는 편이 좋지만, 다른 능력은 어린 시절과 같은 환경이 필요할 수 있다고 방향을 제시했다.
로봇 제어에 적용될 가능성은 이 접근법의 산업적 관심사를 키운다. 미리 정의한 과제만 반복하는 방식은 목적에 맞는 행동을 최적화하는 데 적합하지만, 설계자가 예상하지 못한 도구 사용법이나 우회책은 놓칠 수 있다. 반대로 안전하고 탐색 가능한 환경에서 에이전트가 자유롭게 탐색하도록 허용하면, 실제 세계에 적용하기 어려운 행동을 안전하게 시험하면서 새로운 기술 발견의 여지를 넓힐 수 있다. TechCrunch의 실험 보도는 자유 탐색과 목표 기반 학습의 결합이 에이전트 개발의 새로운 선택지가 될 수 있음을 보여준다.
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: TechCrunch — Left alone with nothing to do, AI agents started playing