핵심 요약
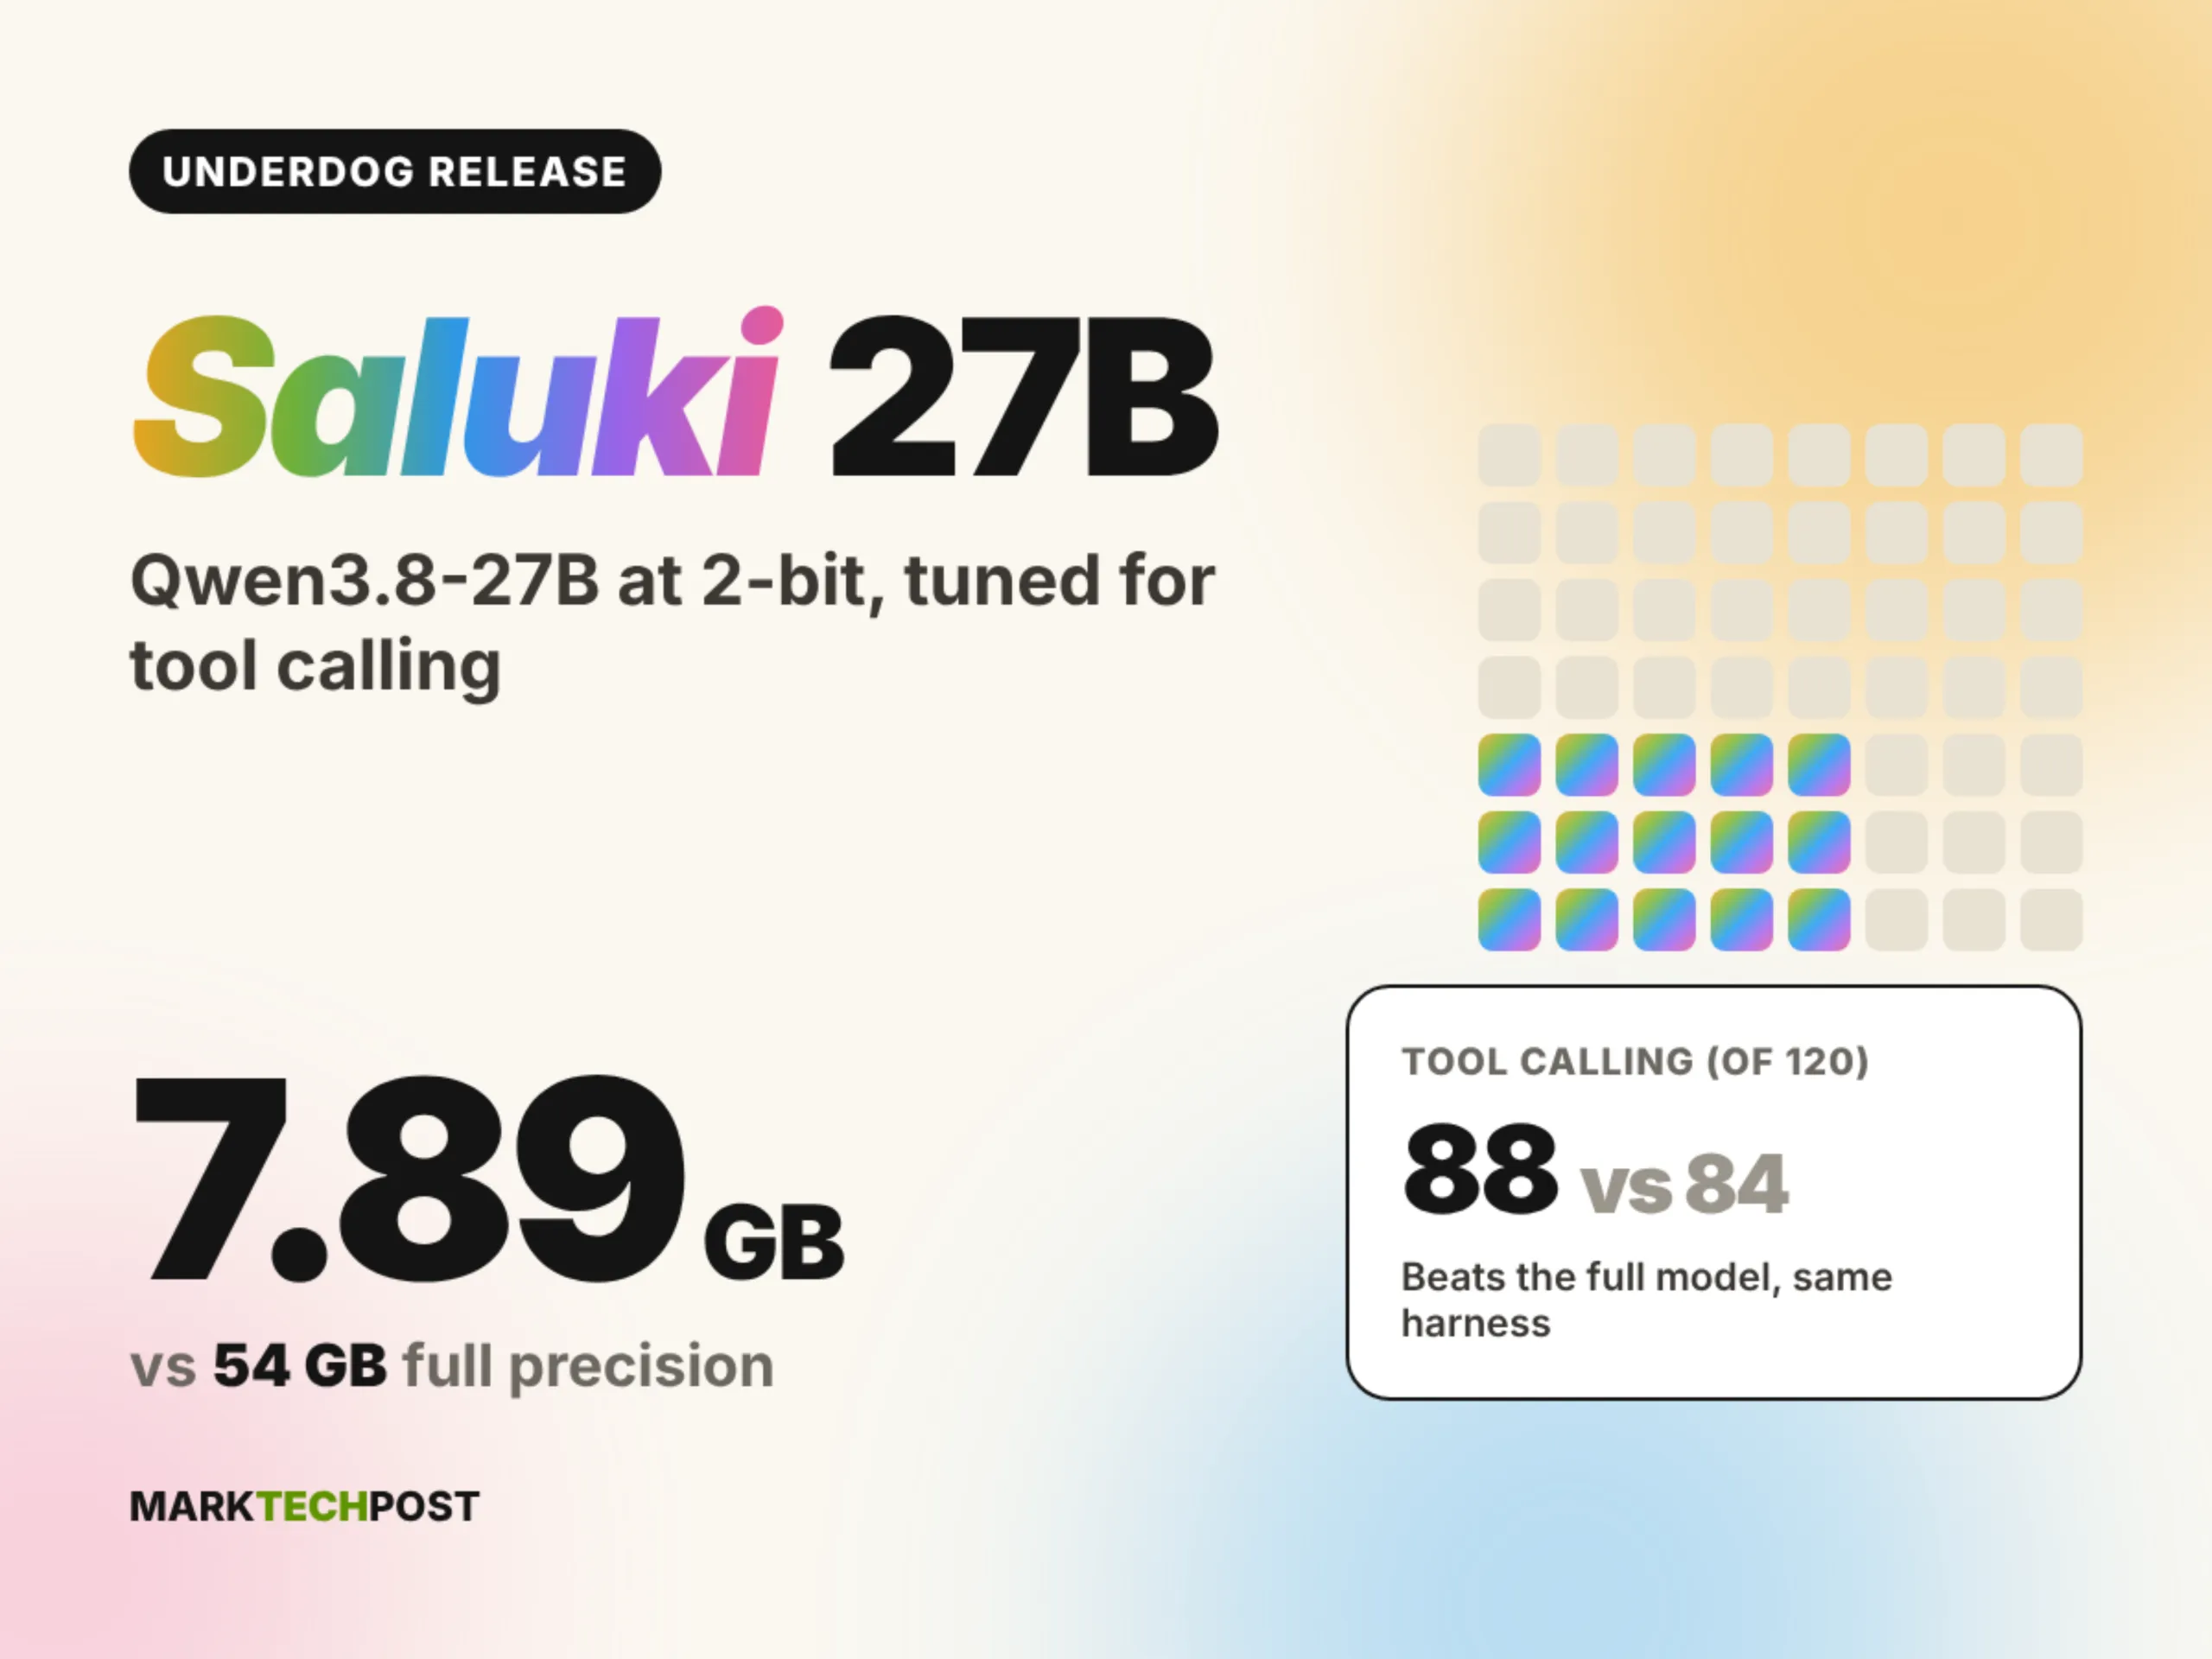
- Saluki 27B는 Conway Research의 Underdog 팀이 공개한 Apache 2.0 라이선스의 2-bit GGUF 양자화 모델로, Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16 원본의 54GB를 7.89GB로 축소했다. 동일 하네스에서 측정한 Underdog Bench 120개 태스크에서 Saluki 27B는 88점, 풀 모델은 84점을 기록해 원본을 추월했다. BFCL v4 병렬 도구 호출 100개 태스크에서는 Saluki 27B가 42, 풀 모델이 35점으로 120% retention을 달성했다. 반면 SWE-bench Verified 50개 이슈에서는 Saluki 27B가 30건, 풀 모델이 33건을 해결해 소폭 열세를 보였다. 9개 벤치마크 평균 retention은 96%이며, 가장 큰 손실은 AIME 2025의 79.2 대 96.7로 수학·경쟁형 추론 영역에 집중된다. 모델은 64 레이어 구조에 Gated DeltaNet linear attention과 gated attention을 혼합했고, 네이티브 컨텍스트는 262,144 토큰이다. 양자화 스택은 ISTA-DASLab의 Qwen3.8-27B [벤더 자체 명명/개조 표기]-GSQ-RCO-GGUF(IQ2_XS, 8.4GB, 약 2.34 bpw)를 베이스로 Underdog의 자체 패스(IQ2-mix, imatrix 태그)를 덧씌운 3층 구조다. 옵션으로 629MB 또는 928MB의 비전 어댑터가 제공된다. 동일 클래스 대안인 PrismML Bonsai 2는 14개 사고 모드 벤치마크에서 98.2% retention과 AIME25 95.00을 기록해 수학 성능은 우위이나, 자체 llama.cpp 포크가 필요해 stock llama.cpp에서는 동작하지 않는다. Saluki 27B는 stock llama.cpp, Ollama, LM Studio에서 풀 GPU 오프로드로 작동한다.
27B 클래스 LLM이 8GB 미만 파일로 압축되어 일반 노트북에서도 동작 가능한 수준에 도달했으며, 양자화 손실은 작업 영역별로 비대칭적으로 나타나 도구 호출과 병렬 함수 호출에서는 원본을 이기지만 경쟁형 수학·다단계 추론에서는 12~18점 하락이 발생하므로, 온디바이스 에이전트 구축 시에는 양자화 친화적 워크로드(함수 호출, 포맷 엄수, 짧은 추론)와 양자화 비친화적 워크로드(장문 다단계 수학, 복잡한 체인 오브 소트)를 분리해 라우팅하는 전략이 필요하다.
목차
도입: 에이전트 시대의 온디바이스 압박
2026년 들어 로컬 LLM 에이전트 수요가 폭증하면서, 27B 클래스 모델을 일반 노트북 VRAM 8GB에 올리려는 시도가 본격화됐다. 살루키 27B(Saluki 27B)는 이런 흐름을 가장 적나라하게 보여주는 사례다. 원본 Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16 54GB를 2비트 양자화 스택을 통해 7.89GB 파일 한 개로 축소한 결과물이다. 단일 RTX 4060 Laptop(VRAM 8GB)에서도 풀 GPU 오프로드로 27B 추론이 가능해진 시점에서, 2비트 양자화의 트레이드오프를 정확히 파악하는 것이 온디바이스 에이전트 설계의 출발점이 됐다.
살루키 27B는 Conway Research의 Underdog 팀이 Apache 2.0 라이선스로 공개한 모델로, llama.cpp, Ollama, LM Studio 같은 stock 런타임에서 추가 포크 없이 동작한다. 별도 추론 엔진을 요구하는 동급 모델들과 분명한 차이다. Underdog 런칭 페이지에 공개된 산출물 구성과 imatrix 로그가 같은 파이프라인의 재현을 가능하게 한다.
살루키 27B 핵심 스펙
살루키 27B의 골격은 Qwen3.8-27B [벤더 자체 명명/개조 표기]와 동일하다. 64 레이어 하이브리드 어텐션이 중심이다. Gated DeltaNet linear attention과 일반 gated attention을 레이어 단위로 섞어, 선형 어텐션의 메모리 효율과 표준 어텐션의 정확도를 동시에 취한다. 네이티브 컨텍스트는 262,144 토큰에 달해 장문 코드베이스나 다중 문서 RAG도 무리 없이 수용한다.
양자화 산출물은 단일 GGUF 파일 7.89GB다. 가중치당 비트로 환산하면 약 약 2.34 bpw 수준으로, 극단적 압축 영역의 최하위 클래스인 IQ2_XS 계열에 속한다. 옵션으로 629MB 또는 928MB 비전 어댑터가 함께 배포돼 멀티모달 워크로드로 확장할 수 있다. Apache 2.0은 상용 파인튜닝과 재배포를 모두 허용하므로 에이전트 백엔드로 채택할 때 법적 마찰이 적다.
3층 양자화 스택 해부
살루키 27B의 7.89GB 산출물은 단일 알고리즘의 결과가 아니다. 베이스 → GSQ-RCO → IQ2-mix의 3층 파이프라인을 거친다. 각 층의 역할이 명확히 분리돼 있어, 자체 파인튜닝 모델에 같은 파이프라인을 재적용하는 것도 가능하다.
1층은 ISTA-DASLab의 Qwen3.8-27B [벤더 자체 명명/개조 표기]-GSQ-RCO-GGUF다. GSQ(Grid Scalar Quantization)는 텐서별 저비트 스칼라 그리드를 학습해 가중치 분포에 맞는 비균일 코드를 구성하고, RCO(Rate-Constrained Optimization)는 모델 전체 크기 예산이 고정한 상태에서 텐서별 비트 배분을 결정한다. 베이스 산출물은 IQ2_XS 8.4GB, 2.50 bpw다.
2층은 Underdog의 자체 IQ2-mix 패스다. importance matrix(imatrix) 태그를 계산해 손실에 민감한 텐서는 더 높은 비트를, 둔감한 텐서는 더 공격적으로 압축하는 혼합 정밀도 전략을 취한다. 동일 2.50 bpw 예산을 유지하면서도 텐서별 비트 배분을 재조정해 평균 손실을 끌어내렸고, 결과 파일이 7.89GB로 베이스 대비 0.5GB 더 줄어들었다.
3층은 양자화 친화적 워크로드(함수 호출, 포맷 준수)와 양자화 비친화적 워크로드(장문 다단계 추론, 수학 경시대회)의 비대칭을 벤치마크로 측정해 사용자에게 라우팅 가이드를 제공하는 단계다. 기술적 양자화 자체는 아니지만 Underdog Bench 120 태스크 자체가 3층 메타데이터 역할을 한다.
벤치마크 교차 분석: 비대칭 손실의 지도
살루키 27B의 가장 흥미로운 특성은 손실이 작업 영역별로 비대칭적으로 나타난다는 점이다. 동일 하네스에서 측정한 9개 벤치마크 평균 retention은 96%지만, 영역별 편차가 크다. 도구 호출과 함수 호출 영역에서 살루키 27B는 원본을 앞선다.
Underdog Bench 120개 태스크에서 살루키 27B는 88점, 풀 모델은 84점을 기록했다. BFCL v4 병렬 도구 호출 100개 태스크에서는 살루키 27B가 42점, 풀 모델이 35점으로 retention 120%를 달성했다. 함수 호출과 포맷 준수는 양자화에 강건한 작업 유형으로, 학습 단계에서 이미 패턴화한 출력을 재현하는 데 그치기 때문이다.
반면 수학·경쟁형 추론 영역은 명확한 열세를 보인다. AIME 2025에서 살루키 27B는 79.2점, 풀 모델은 96.7점으로 17.5점 차이가 발생했다. SWE-bench Verified 50개 이슈에서는 살루키 27B가 30건, 풀 모델이 33건을 해결해 소폭 뒤처졌다. 9개 벤치마크 중 가장 큰 손실이 수학·다단계 추론에 집중되는 패턴은, 극단적 압축 시 가중치 정밀도 손실이 누적 오차에 민감한 체인 오브 소트 작업에 그대로 전파된다는 가설과 일치한다.
| 벤치마크 [벤더 자체 보고 / 미검증] | 작업 유형 | Saluki 27B | Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16 | Retention |
|---|---|---|---|---|
| Underdog Bench (120) | 에이전트 일반 | 88 | 84 | 104.8% |
| BFCL v4 (100) | 병렬 도구 호출 | 42 | 35 | 120.0% |
| SWE-bench Verified (50) | 코딩 에이전트 | 30 | 33 | 90.9% |
| AIME 2025 | 수학 경시 | 79.2 | 96.7 | 81.9% |
| 9개 평균 | 종합 | – | – | 96.0% |
Bonsai 2와의 비교: retention 우위 vs 런타임 종속성
동일 IQ2 계열의 대안으로 PrismML Bonsai 2가 자주 언급된다. Bonsai 2는 14개 사고 모드 벤치마크에서 98.2% retention을 달성했고, AIME25에서 95.00점을 기록해 수학 영역 retention은 살루키 27B보다 우위다. 그러나 Bonsai 2는 자체 llama.cpp 포크가 필요해 stock llama.cpp에서는 동작하지 않는다. 실전 도입 시 런타임 종속성이라는 새로운 변수가 발생한다.
살루키 27B는 stock llama.cpp, Ollama, LM Studio에서 별도 변환 없이 풀 GPU 오프로드로 작동한다. llama.cpp의 GGUF 로더가 IQ2 계열을 네이티브 지원하기 때문이다. 8GB VRAM 카드에서도 27B 구동이 가능한 점, 표준 런타임 호환성, Apache 2.0 라이선스가 결합된 결과, 온디바이스 에이전트 백엔드 후보군에서 살루키 27B는 진입장벽이 가장 낮다. retention·수학 성능 자체만 보면 Bonsai 2가 앞서지만, 실무 통합 비용까지 합산하면 결이 달라진다.
실무 구동 절차: llama.cpp와 Ollama
살루키 27B를 로컬에서 띄우는 가장 빠른 경로는 두 가지다. 첫째, stock llama.cpp 직접 구동. 둘째, Ollama의 원스톱 서빙. 두 절차 모두 추가 빌드나 포크 없이 끝난다. 다음 명령으로 7.89GB 파일을 받아 8GB VRAM 카드에 풀 오프로드한다.
# llama.cpp 빌드 (CUDA 백엔드 예시)
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp && cmake -B build -DGGML_CUDA=ON && cmake --build build --config Release -j

# 모델 다운로드 (Hugging Face)
huggingface-cli download ConwayResearch/Underdog-Saluki-27B-1.0 \
  --include "Underdog-Saluki-27B-1.0-IQ2-mix.gguf" --local-dir ./models

# 8GB VRAM 풀 오프로드 (-ngl 999: 모든 레이어 GPU 적재)
./build/bin/llama-cli -m ./models/Underdog-Saluki-27B-1.0-IQ2-mix.gguf \
  -c 8192 -ngl 999 --temp 0.7 --top-p 0.9 -n 512 \
  -p "You are a tool-calling agent. Use the following tools: ..."
Ollama 경로는 더 짧다. Modelfile을 작성해 GGUF 파일을 등록한 뒤 서빙한다. 함수 호출 스키마를 SYSTEM 메시지에 명시하면 BFCL v4 스키마 호환 에이전트로 즉시 활용할 수 있다. 동일 llama.cpp 백엔드를 그대로 쓰기 때문에 IQ2-mix 인식에 별도 플래그가 필요 없다.
# Ollama Modelfile 예시
FROM ./models/Underdog-Saluki-27B-1.0-IQ2-mix.gguf
PARAMETER num_ctx 8192
PARAMETER num_gpu 999
PARAMETER temperature 0.7
SYSTEM """You are a function-calling agent. When the user requests an action, output a JSON object with 'name', 'arguments' fields following the BFCL v4 schema. Do not include explanations outside the JSON block when calling a tool."""
[하드웨어 현실성 점검] 8GB 단일 VRAM(예: RTX 4060 Laptop) 환경에서는 모델 가중치(7.89GB)만으로 VRAM이 거의 포화됩니다. 8K 컨텍스트 구동 시 KV 캐시 메모리 초과(OOM)를 방지하려면 --cache-type-k q8_0 --cache-type-v q8_0 같은 KV 캐시 양자화를 적용하거나 초기 레이어 일부를 CPU로 분할 오프로드해야 합니다. 완전한 GPU 풀 오프로드로 8K~32K 컨텍스트를 안정 서빙하려면 최소 12GB~16GB VRAM(또는 Apple Silicon 16GB+ 통합 메모리)이 권장됩니다.
라우팅 패턴: 양자화 친화 vs 비친화 워크로드 분리
살루키 27B를 단일 백엔드로 모든 작업에 투입하는 것은 권장되지 않는다. 비대칭 손실 패턴이 명확하므로, 작업 특성에 따라 모델을 분기하는 라우터가 필요하다. 다수 엔터프라이즈 에이전트 프레임워크가 이미 채택한 패턴이다.
양자화 친화 워크로드(살루키 27B 우선)는 ① 함수 호출·도구 스키마 준수 ② 짧은 추론 ③ 포맷 엄수 ④ 분류·라벨링 ⑤ 코드 자동완성(중단 길이) 등이 해당한다. 양자화 비친화 워크로드(풀 BF16 또는 고비트 양자화 라우팅)는 ① AIME·올림피아드 스타일 수학 ② 다단계 체인 오브 소트 ③ SWE-bench Verified 수준의 에이전트 코딩 ④ 장문 다중 문서 추론이 포함된다.
살루키 27B는 라우터의 저비용·고처리량 슬롯에 배치하고, 수학·복잡 추론 트리거는 Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16이나 다른 고비트 모델로 폴백시키는 구성이 비용 대비 성능 최적점이다. 이미 로컬 LLM 서빙 파이프라인에 진입한 팀이라면, 온디바이스 AI 도입 5단계 가이드와 결합해 살루키 27B를 디폴트 슬롯으로 검토할 만하다.
2비트 시대의 LLM 에이전트 설계 원칙
살루키 27B가 제시한 시사점은 단순하다. 27B 클래스가 8GB 파일로 들어오는 시대에, 에이전트 설계는 하나의 만능 모델에서 워크로드별 분기 라우터로 무게중심이 이동한다. 2비트 양자화는 모든 영역에서 손실이 균일하지 않으며, 도구 호출과 포맷 준수에서 풀 모델을 이길 수 있다는 사실은 양자화 연구의 새로운 방향을 시사한다.
동시에 stock llama.cpp 호환성과 Apache 2.0 라이선스는 온디바이스 배포의 현실적 진입장벽을 크게 낮췄다. 살루키 27B 모델 카드에 imatrix 계산 로그와 양자화 파라미터가 모두 공개돼 있어, 자체 파인튜닝 후 재양자화도 같은 파이프라인으로 재현할 수 있다. 일반 노트북 한 대로 27B 에이전트를 굴리는 시대, 2비트 양자화의 비대칭을 이해하는 것이 곧 설계 경쟁력이다.
지금 바로 해볼 것
- RTX 4060 Laptop(8GB) 또는 M2 Pro Unified Memory 16GB 이상 장비를 확보한 뒤, stock llama.cpp를 CUDA 또는 Metal 백엔드로 빌드한다.
- Hugging Face에서
ConwayResearch/Underdog-Saluki-27B-1.0의Underdog-Saluki-27B-1.0-IQ2-mix.gguf파일(7.89GB)을 내려받아-ngl 999 -c 8192옵션으로 풀 GPU 오프로드 구동을 검증한다. - Ollama Modelfile에 BFCL v4 함수 호출 스키마를 SYSTEM 프롬프트로 명시한 뒤, 10개 이상의 도구 호출 시나리오로 정확도를 측정한다.
- 같은 프롬프트를 살루키 27B와 Qwen3.8-27B [벤더 자체 명명/개조 표기] BF16에 동시 투입해 AIME 2025 스타일 수학 문제 5개로 손실 폭을 직접 측정, 라우팅 트리거 기준선을 정한다.
- 기존 에이전트 프레임워크의 라우터에 양자화 친화/비친화 분기 로직을 추가해, 함수 호출은 살루키 27B, 다단계 수학은 BF16 모델로 폴백하도록 구성한다.
자주 묻는 질문
Q. 살루키 27B가 2.50 bpw인데 IQ2_XS 베이스 대비 0.5GB 더 작은 이유는 무엇인가?
Underdog의 IQ2-mix 패스가 imatrix를 활용해 손실 둔감 텐서를 더 공격적으로 압축하고, 민감 텐서만 약간 더 높은 비트를 배정하는 혼합 정밀도 전략을 취했기 때문이다. 평균 bpw는 2.50으로 동일하지만 텐서별 분포가 재조정돼 결과 파일이 0.5GB 줄어들었다.
Q. Apple Silicon 맥북에서 살루키 27B를 돌릴 때 Unified Memory 권장 용량은?
8K 컨텍스트 기준으로 16GB Unified Memory면 안정적이다. 컨텍스트를 32K 이상으로 올리면 KV 캐시 점유로 24GB 이상이 권장된다. M2 Pro 16GB 모델에서도 -ngl 999 -c 8192 조합으로 동작 확인 사례가 있다.
Q. AIME 2025 손실 17.5점은 실전 에이전트에서 얼마나 체감되는가?
일반 코딩 보조, 문서 요약, API 호출 에이전트 수준에서는 체감되지 않는다. 다만 수학 올림피아드 스타일 문제나 다단계 증명 체인을 정확히 풀어야 하는 워크로드에서는 명백한 정확도 저하가 발생하므로, 이런 작업은 BF16 폴백 라우팅이 필수다.
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Meet the Underdog Saluki 27B: A 2-bit Qwen3.8-27B [벤더 자체 명명/개조 표기] That Beats the Original at Tool Calling