[태그:] 하네스 최적화

  • Harness² 공개…모델 대신 하네스 최적화로 AI 에이전트 성능 개선

    Harness² 공개…모델 대신 하네스 최적화로 AI 에이전트 성능 개선

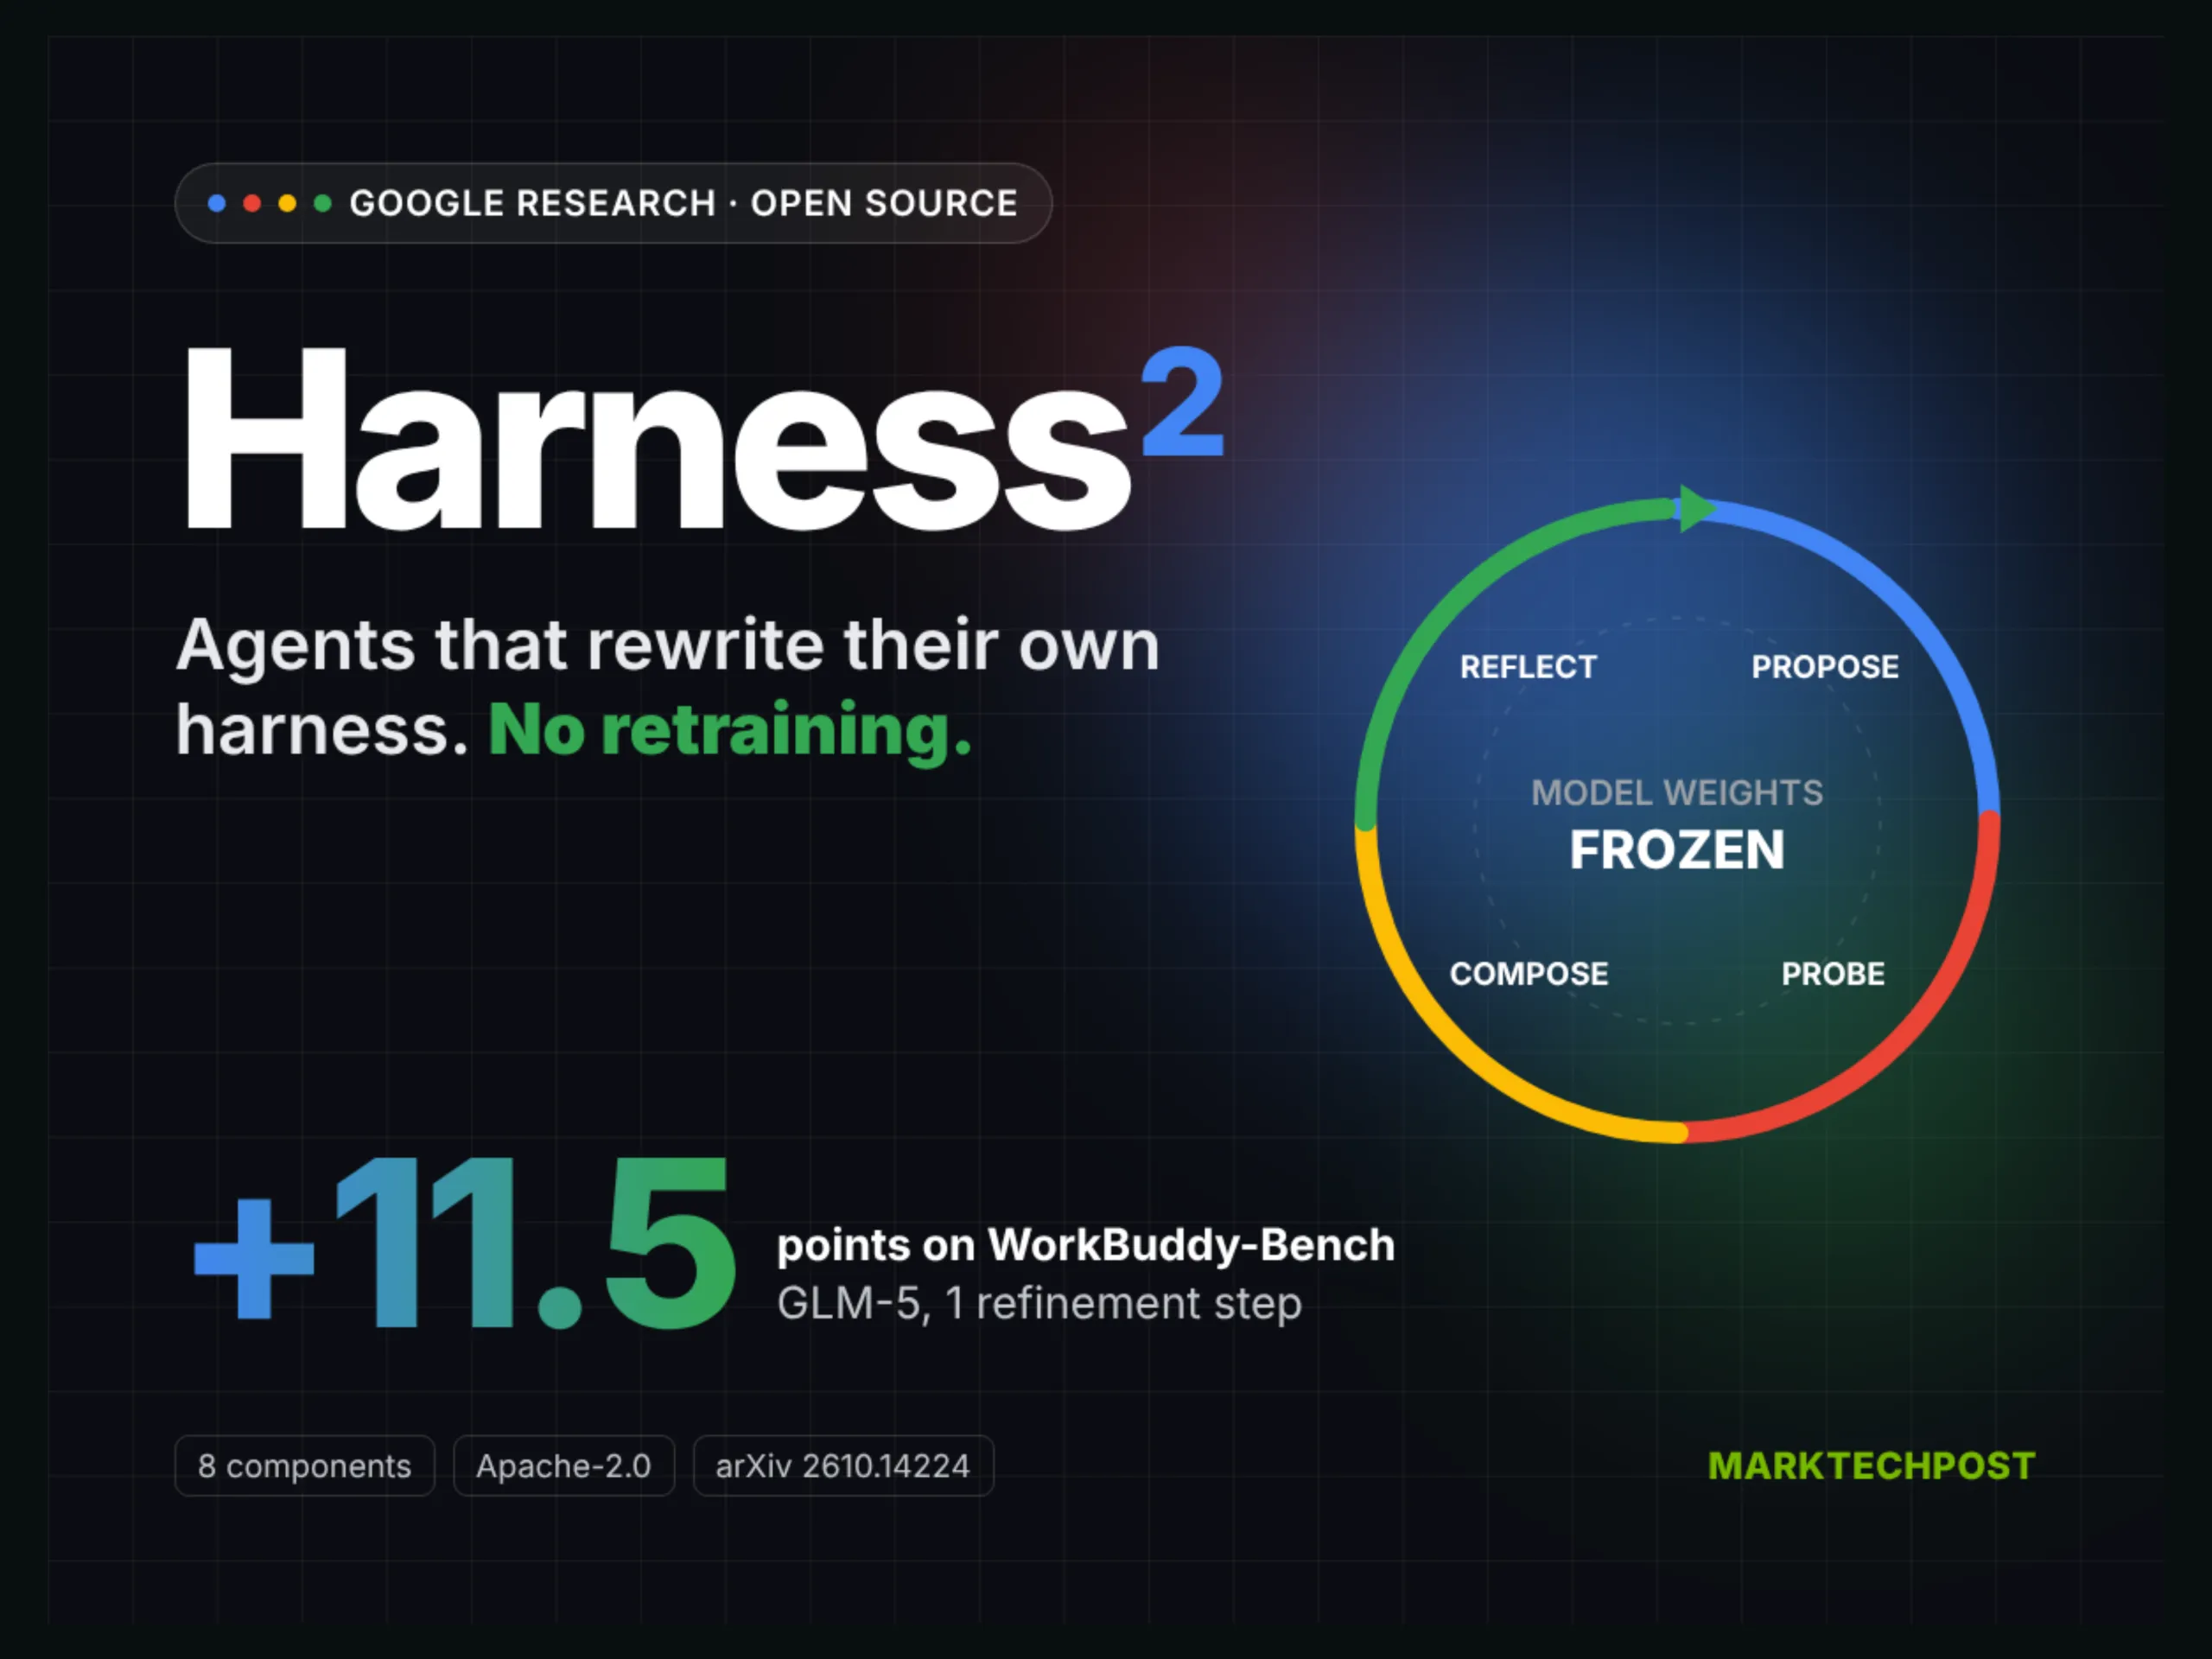
    Google Cloud AI Research가 에이전트의 모델을 대체하지 않고도 실행 환경을 개선할 수 있는 재귀적 프레임워크 Harness²를 공개했다. 이 프레임워크는 동결된 모델 주변의 코드와 파일을 다듬어, 더 좋은 모델을 사용하지 않고도 에이전트 성능을 높이려는 접근을 취한다. 공개된 버전은 0.1.0이며, 학습된 파라미터는 없고 파일 형태로 편집 가능한 하네스 구성 요소는 8개다.

    모델이 아니라 에이전트를 둘러싼 환경을 바꾼다

    Harness²에서 하네스는 모델 그 자체보다 광범위한 개념이다. 프롬프트, 도구, 메모리, 스킬과 오케스트레이션이 모두 모델 주변의 시스템에 포함되며, 이 환경을 최적화하는 과정이 하네싱에 해당한다. 모델 가중치는 변경되지 않으며, 프레임워크는 실제 배치 단계에서 에이전트의 하네스를 개선하도록 설계됐다.

    하네스의 편집 대상은 각각 파일로 마운트되는 8개 구성 요소다. 이 구성 요소는 문맥 구성, 도구 인터페이스, 위임과 도구 루프 내부의 행동을 포괄한다. 즉, Harness²의 접근은 정답이 주어지는 폐쇄형 환경보다 정답을 알려 주는 검증자가 없는 개방형 환경에 맞춰져 있다. 프레임워크는 라벨이나 테스트 케이스를 전제로 하는 많은 자기 개선 방식과 달리, 그러한 지표 없이도 작동하도록 설계됐다.

    Propose·Probe·Compose로 실패를 behavioural 차이로 검증한다

    Harness²의 핵심은 작업 수준 재귀와 하네스 수준 재귀라는 두 연결된 단계다. 작업 수준 재귀는 기준 하네스로 작업을 실행한 뒤 편집자가 후보를 제안하고, 같은 작업에서 후보를 비교한 다음 관찰된 행동으로 뒷받침되는 편집만 남기는 대비형 Propose·Probe·Compose 절차를 사용한다.

    편집자가 제안하는 후보에는 일반적인 에이전트 실패를 겨냥하는 invariant 후보와 현재 도메인의 지식과 절차를 다루는 domain 후보가 포함된다. composer는 기준 실행과 두 후보의 궤적을 비교하며, 단순히 후보가 더 잘 풀어 보였다는 이유가 아니라 실제 행동 차이가 있는 편집만 채택한다. 이 방식은 정답 레이블을 대체하는 직접적인 증거로, 후보가 만든 행동의 차이에 초점을 둔다.

    작업 처리가 끝나면 반사는 채택한 하네스와 교훈 문서인 EXPERIENCE.md를 저장한다. 이 경험 라이브러리는 이후 제안에 활용되지만, 새 작업은 다시 기본 하네스에서 시작한다. 병렬 모드는 invariant 후보 k개와 domain 후보 k개를 탐색한 뒤 k번 조합하며, 순차 모드는 k개의 개선 단계를 이어 붙인다. 탐색 폭이 커질수록 작업당 추가 모델 실행과 비용도 늘어난다.

    세 벤치마크에서 나타난 성능과 실행 비용

    구현 환경은 Linux, Python 3.12 또는 3.13과 uv를 대상으로 하며, 모델 실행에는 Vertex AI를 사용한다. GPU 요구 사항은 공개되지 않았다. 모델 기반 실행에는 Node.js 20 이상, Google Cloud CLI와 Vertex AI 프로젝트가 필요하며, LAB에는 Pandoc과 Poppler, WorkBuddy-Bench에는 Docker가 요구된다. 실행기는 기본적으로 OpenCode이며 Codex는 별도 옵션으로 지정한다.

    평가에는 WorkBuddy-Bench, JobBench, Harvey’s LAB 등 3개 전문 벤치마크가 사용됐다. 실행 모델은 Gemini 3.5 Flash와 GLM-5, 실행 환경은 OpenCode와 Codex였고, 기본 편집기는 Claude Opus 4.8이었다. 결과는 3회 실행의 평균으로 제시됐다. 한 번의 개선 단계가 4개 모델·하네스 조합과 3개 벤치마크 모두에서 성능을 높였지만, 개선 폭은 환경에 따라 달랐다.

    WorkBuddy-Bench에서 OpenCode를 사용한 GLM-5는 64.2점에서 75.7점으로 11.5점 상승했다. 병렬 재귀의 k를 5로 설정한 Gemini과 OpenCode 조합은 같은 벤치마크에서 80.8점을 기록했다. 작업당 단계도 감소했는데, WorkBuddy-Bench의 4개 조합 가운데 3개에서 필요한 단계 수가 줄었고 Gemini과 OpenCode 조합은 25.4단계에서 21.9단계로 감소했다. 반면 JobBench에서 Codex를 사용한 GLM-5의 가장 작은 개선은 23.6점에서 24.8점으로 1.2점 상승에 그쳤다.

    하네스 최적화의 실무 조건과 검증 과제

    Harness²의 가치는 모델 학습 없이 테스트 시점에 하네스를 다시 작성하는 데 있다. 다만 추가 실행이 발생하므로 비용 예측과 실행 격리가 함께 필요하다. 외부 명령이 도구 인터페이스를 통해 작동하는 만큼 샌드박싱도 직접 구성해야 한다. 원문을 인용한 Harness² 공개 보도는 성능 수치를 소개했지만, 정확한 세부 구성과 재현 조건은 논문과 저장소를 함께 확인해야 한다.

    이 프레임워크가 제시하는 변화는 더 큰 모델을 즉시 도입하는 대신, 이미 배치된 에이전트의 계획과 도구 사용을 실행 과정에서 보정하는 쪽이다. Propose·Probe·Compose는 후보의 우열을 정답표가 아니라 행동 차이로 판단하고, EXPERIENCE.md는 채택된 교훈을 다음 작업의 제안으로 연결한다. 하네스 최적화가 성능 개선만의 문제가 아니라 모델 호출 수, 격리 환경, 재현 가능한 평가 설계가 함께 요구되는 실행 전략으로 자리 잡는다는 점이 핵심이다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Google Open-Sources Harness2, a Recursive Agent Harnessing Framework
  • 엔비디아 SoL-Pi, 토큰 49% 절감 — AI가 만든 코딩 에이전트 하네스 4종 정밀 해부

    엔비디아 SoL-Pi, 토큰 49% 절감 — AI가 만든 코딩 에이전트 하네스 4종 정밀 해부

    핵심 요약

    • NVIDIA·NTU·MIT 공동 연구팀이 오픈소스 Pi 코딩 에이전트용 효율화 레이어 ‘SoL-Pi’를 공개했으며, MIT 라이선스로 GitHub NVlabs에 배포됨
    • SoL-Pi는 4개의 하네스 메커니즘으로 구성되고, 별도 학습된 AI가 535개 환경에서 auto-research 루프를 돌려 이를 발견
    • EdgeBench 51개 태스크 평가에서 Pi 대비 기록된 토큰 트래픽을 44.7~49.0% 절감, API 비용은 약 33% 감소

    SoL-Pi의 모든 수치는 EdgeBench 51개 태스크 중 hold-out 40개 태스크의 결과이므로 과적합 위험이 통제된 비교 가능한 지표로 해석할 수 있음, 다만 해당 평가는 4개 메커니즘이 동시에 적용된 결과이므로 개별 메커니즘의 기여도는 별도 분석이 필요

    목차

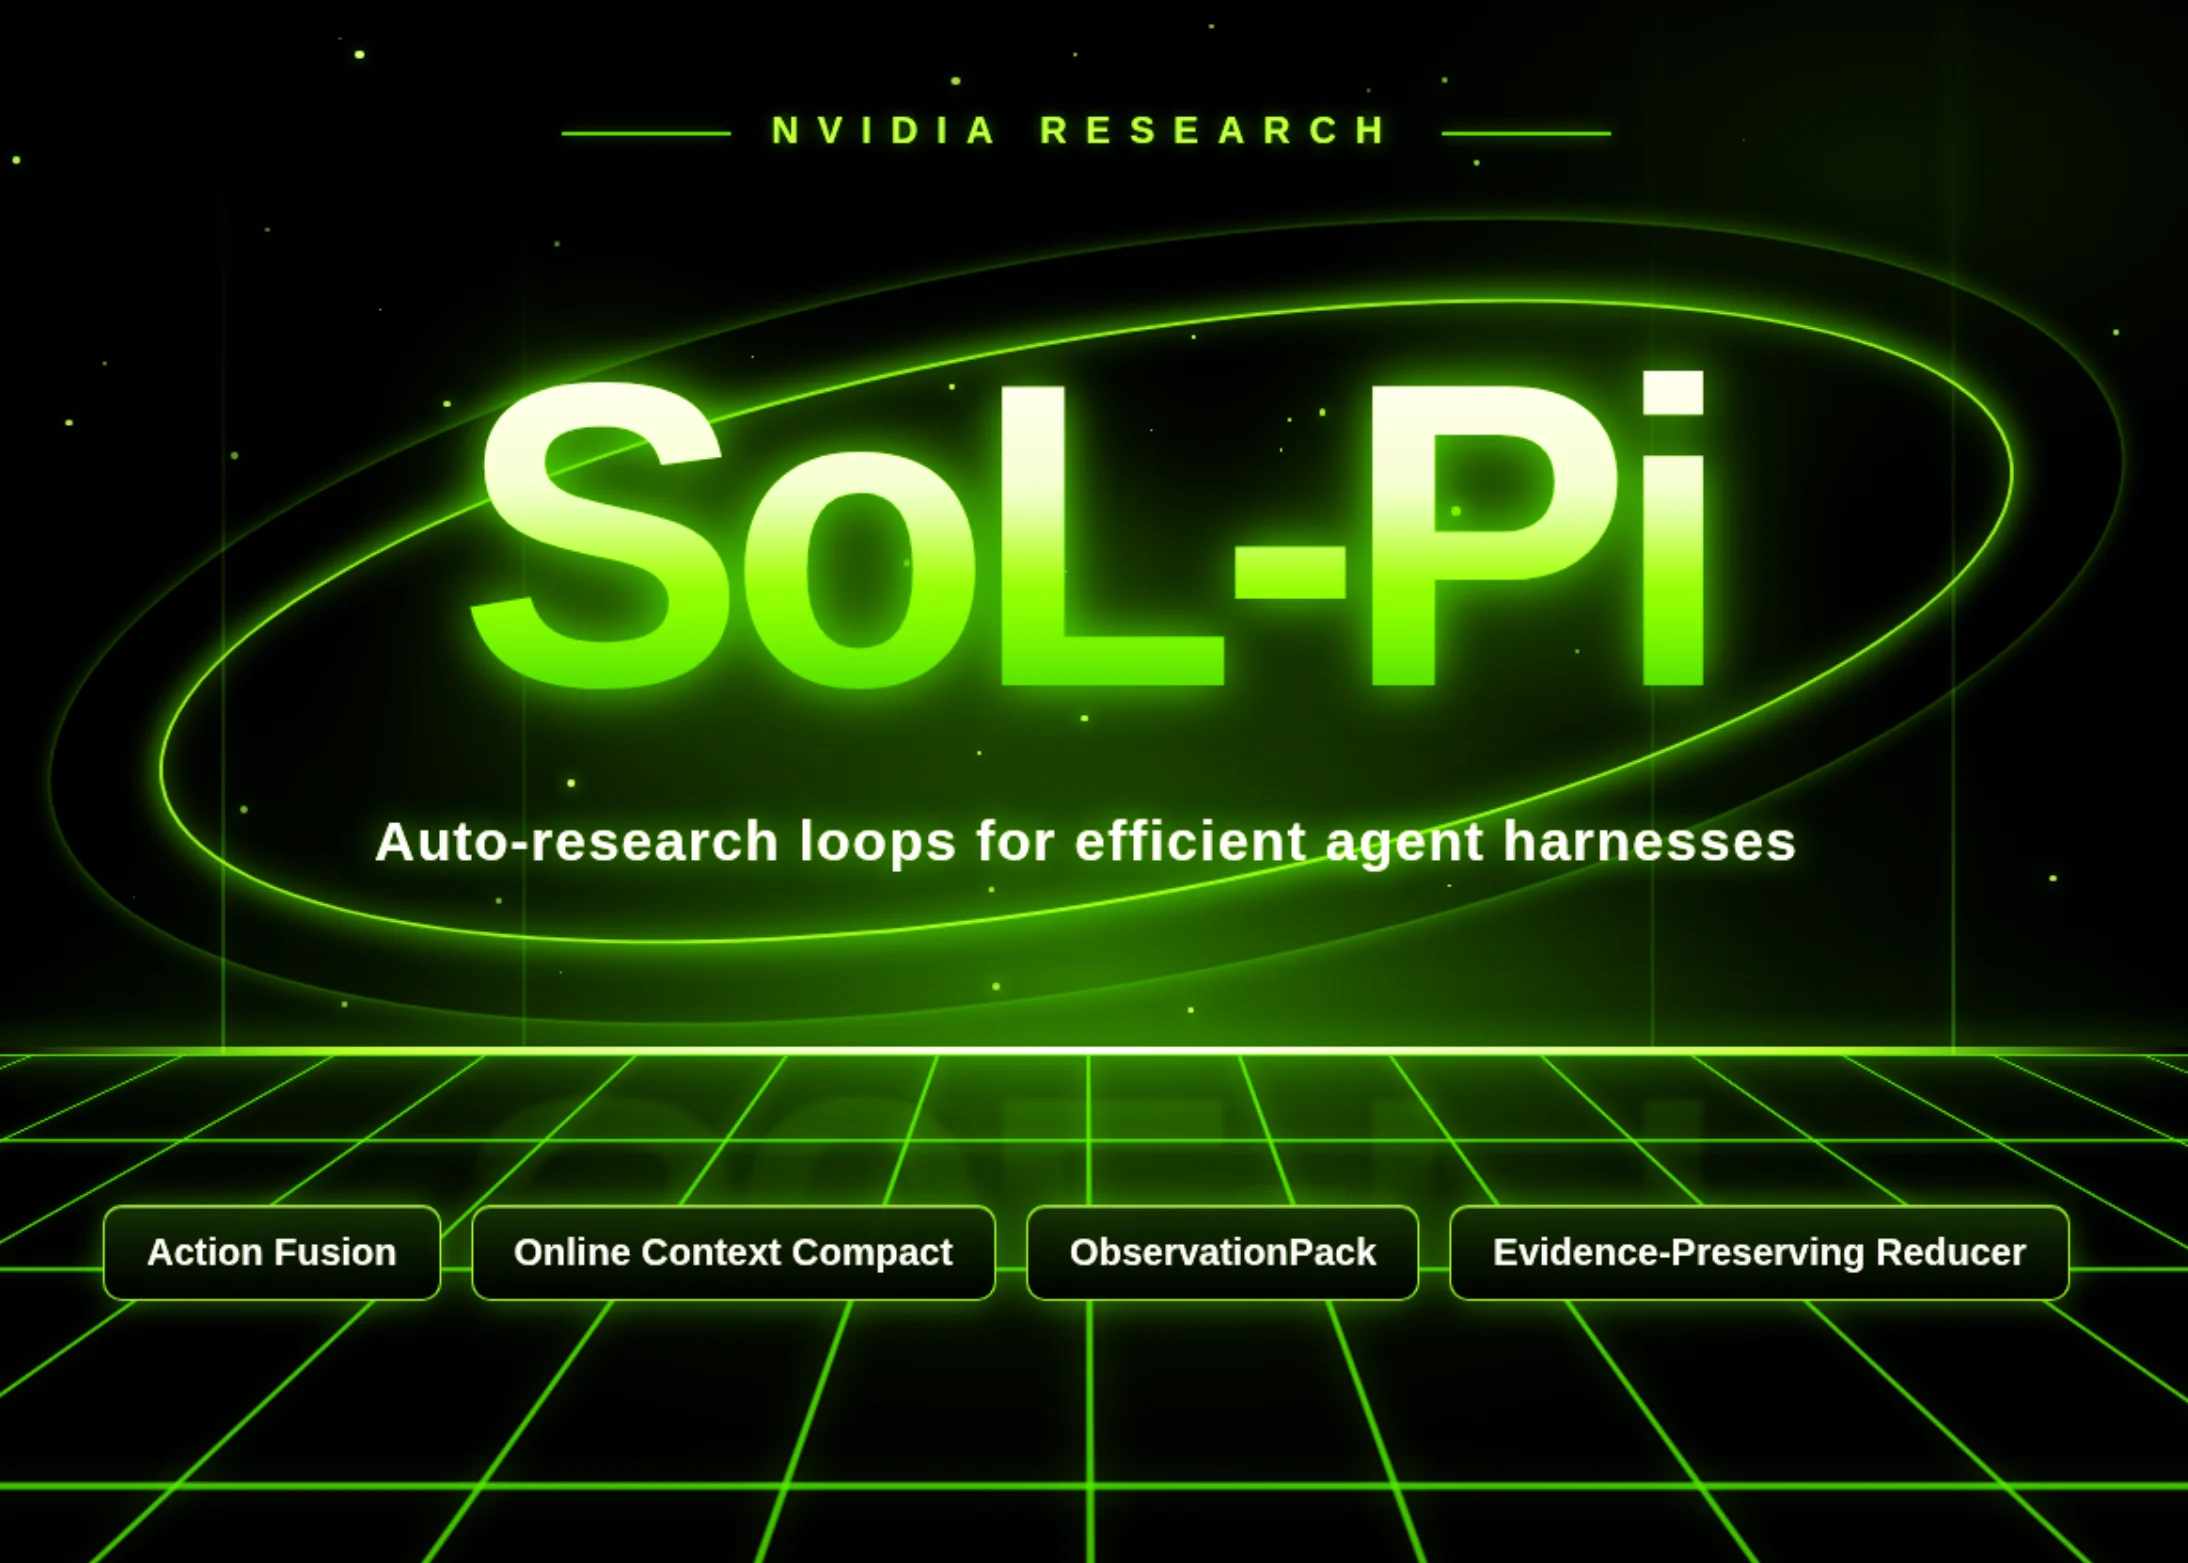
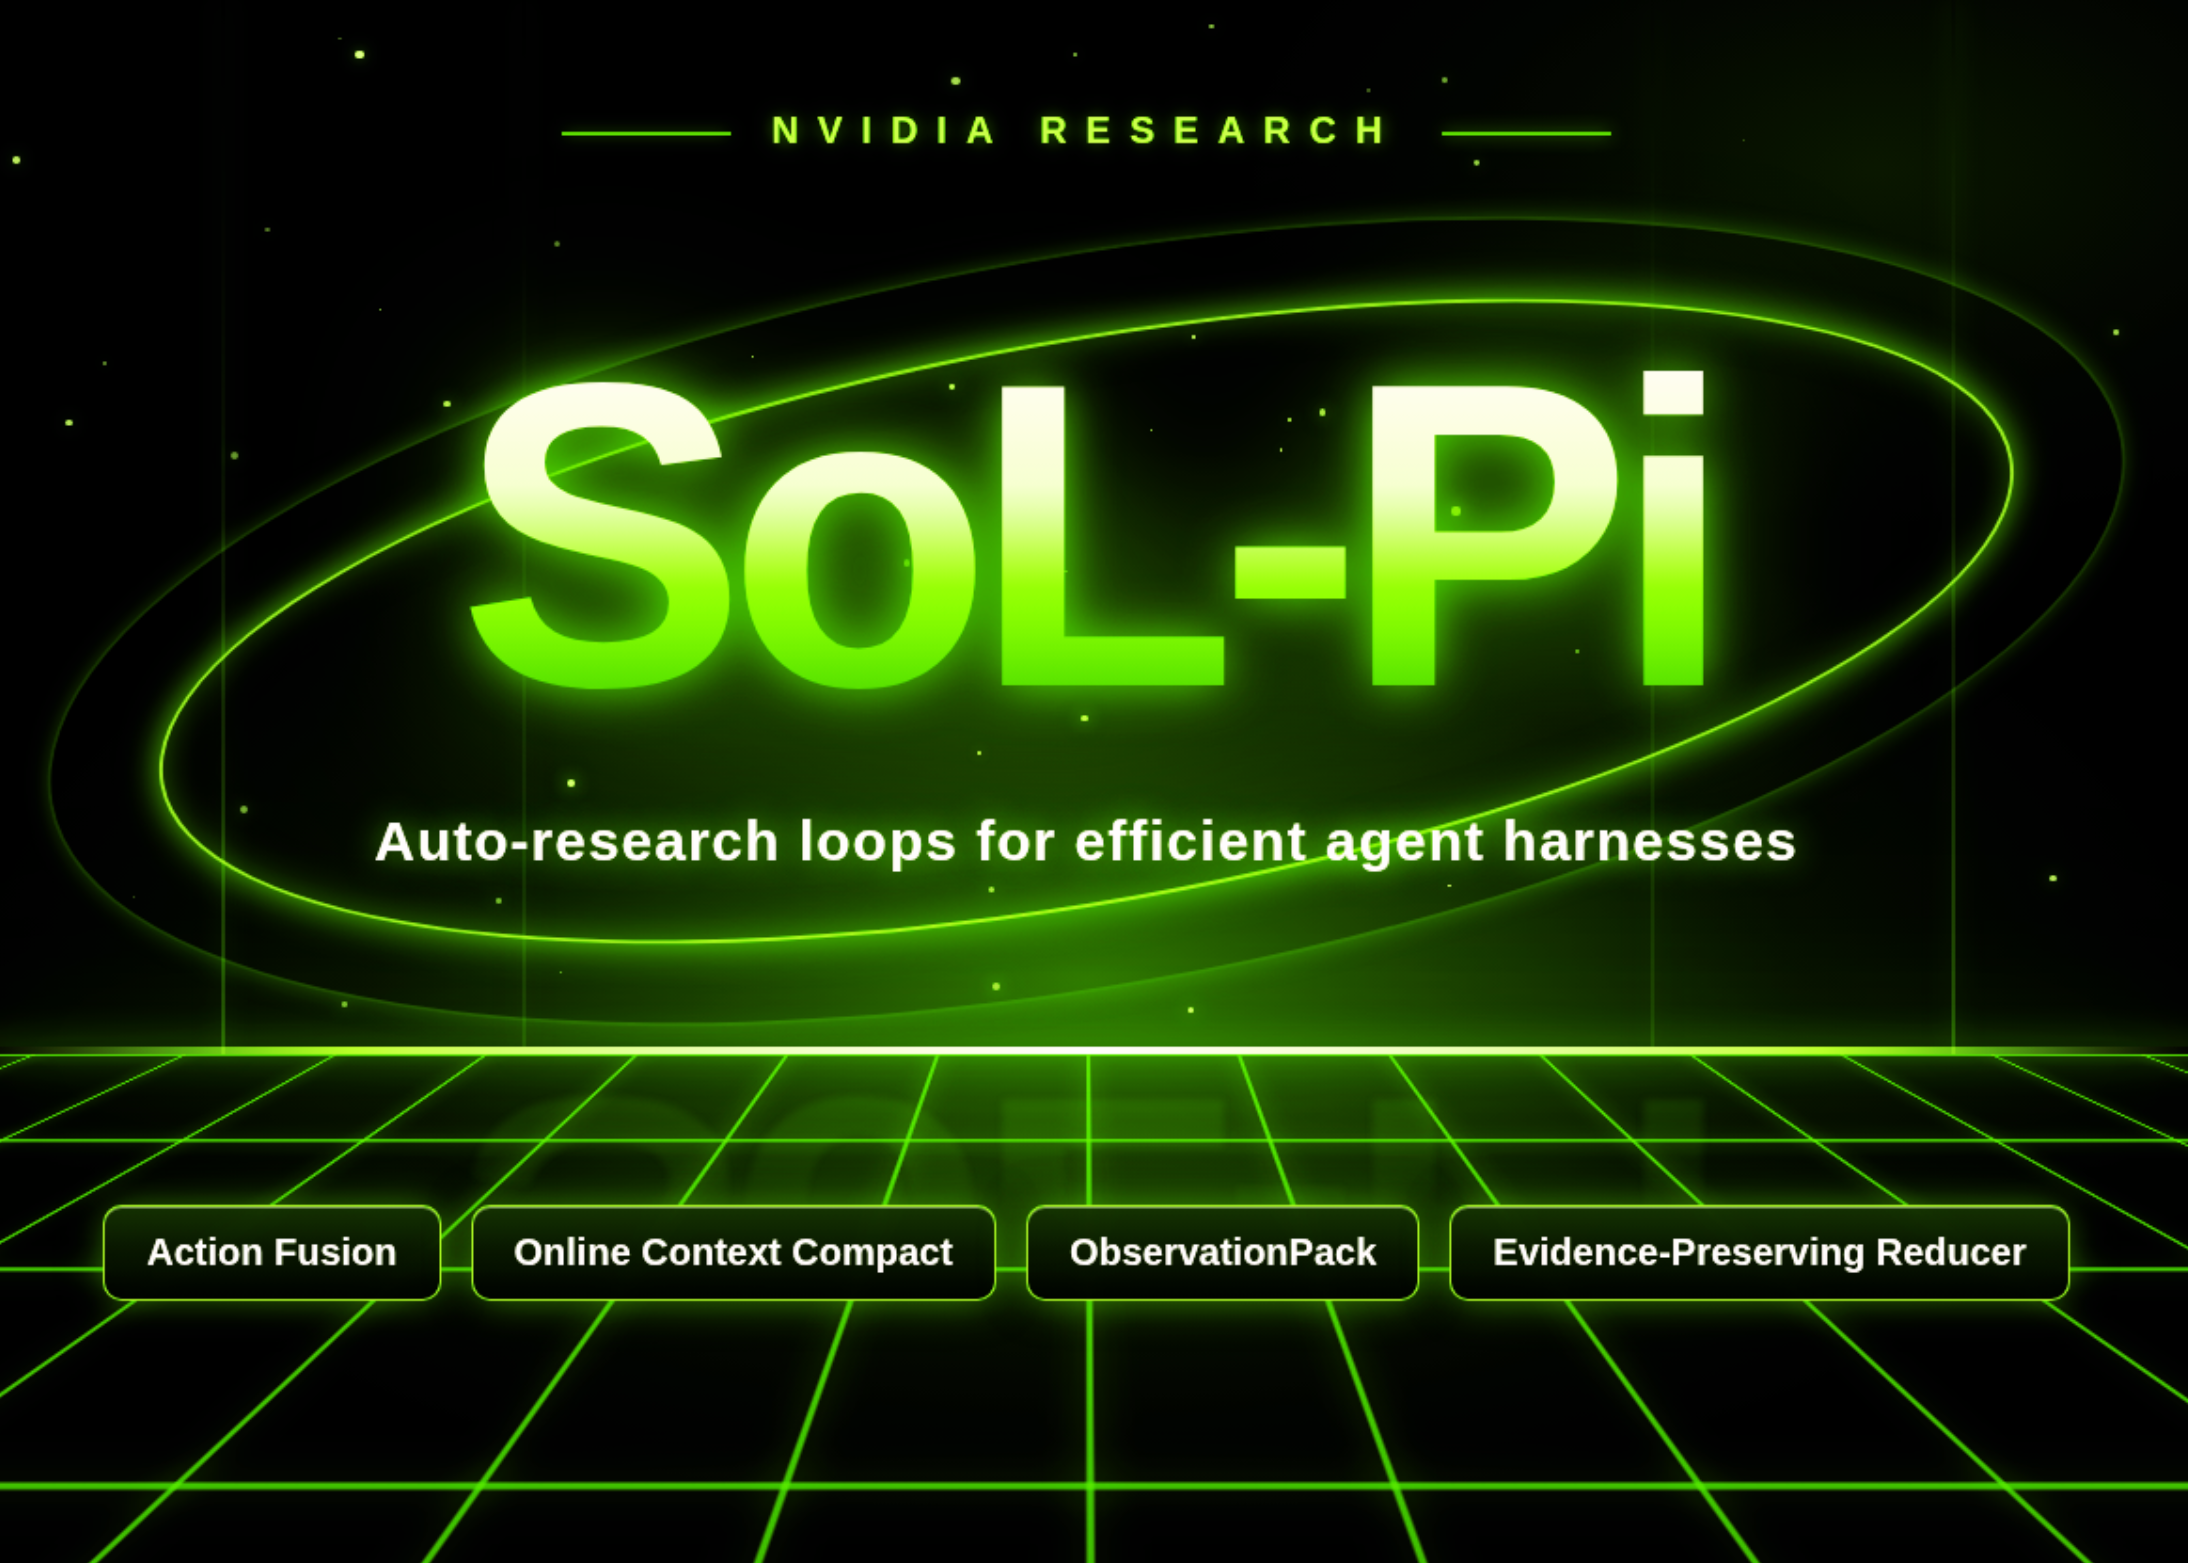
    엔비디아 SoL-Pi가 EdgeBench 51개 태스크에서 토큰 트래픽을 44.7~49.0% 줄였다는 숫자가 먼저 눈에 들어온다. NVIDIA·NTU·MIT 공동 연구팀이 9월 21일 공개한 이 레이어는, 모델을 다시 학습시킨 게 아니다. 별도 학습된 AI가 535개 환경에서 auto-research 루프를 돌며 발견한 4개 하네스 메커니즘을 Pi 코딩 에이전트 위에 얹은 결과다.

    엔비디아 SoL-Pi 4개 하네스 메커니즘 구조도

    핵심은 ‘토큰당 가격’이 아니라 ‘태스크당 토큰 수’를 줄였다는 점이다. 필자는 이 지점이 가장 의미 있다고 본다. 같은 모델로 같은 태스크를 처리하면서 시스템 프롬프트와 도구 호출, 컨텍스트 압축을 다시 짠 것뿐이다. 점수는 GPT-5.6 Sol과 Opus 5에서 Pi의 약 94%를 유지했고, API 비용은 약 33% 감소했다.

    EdgeBench 51개 태스크, 49% 절감은 어떻게 입증됐나

    평가 구조부터 짚어야 한다. 51개 태스크 중 11개는 frozen candidate의 1-way acceptance, 40개는 held-out이다. 검색 단계에서 옵티마이저는 11개 frozen 태스크의 수용 규칙을 절대 변경하지 못한다. 그리고 40개 held-out 결과는 검색 루프에 다시 반영되지 않는다.

    즉, ‘evolved harness가 검색 태스크에 과적합될 수 있다’는 비판을 직접 설계로 차단한 셈이다. 이 분리 덕분에 49% 절감 수치는 비교 가능한 지표로 받아들일 수 있다. 검색·평가 데이터 분리라는 검증 패턴은 AI 연구 자동화 9월 마일스톤에서 반복적으로 등장한 흐름과 결을 같이한다.

    엔비디아 SoL-Pi의 하네스 4종은 어떻게 동작하나

    엔비디아 SoL-Pi의 4개 메커니즘은 도구 호출, 컨텍스트, 관찰값 처리에 집중돼 있다. 공개 자료 기준으로 명칭이 확정된 것은 아니지만, 동작 패턴은 (1) 도구 호출 단계의 분기 압축, (2) 시스템 프롬프트의 동적 슬림화, (3) 관찰값 중복 제거, (4) 실패 루프 조기 종료 — 이 네 축으로 요약된다. 개별 메커니즘의 기여도는 분리 분석이 아직 공개되지 않았다.

    535개 환경 auto-research 루프의 구조

    루프는 관찰 → 제안 → 평가의 3단계다. 535개 환경에서 베이스라인 Pi의 트래픽을 측정하고, 변형 하네스를 제안해 동일 환경에서 다시 측정한다. 이 사이클을 Ralph Loop 구현으로 반복한다. 독립 리뷰어가 검색 단계 결과와 held-out 결과를 따로 점수화하기 때문에, 4개 메커니즘의 평균 절감률은 검색과 평가 양쪽에서 동일하게 집계된다.

    배포 요건과 호환성

    엔비디아 SoL-Pi는 Pi 0.85.1, Node.js 22.19 이상에서 수정 없는 Pi 릴리스 그대로 동작한다. MIT 라이선스로 GitHub NVlabs 저장소에 배포됐다. 기존 Pi 사용자가 가져다 얹는 형태라 마이그레이션 비용이 거의 없다. MarkTechPost 원문에서 저장소 링크와 릴리스 노트를 확인할 수 있다.

    리스크와 한계

    평가는 GPT-5.6 Sol과 Opus 5 두 모델에 한정된다. 코딩 에이전트 외 도메인에서는 검증되지 않았다. 4개 메커니즘을 동시에 적용한 결과이므로, ‘도구 호출 압축만 떼어내면 몇 %인가’를 알려면 별도 ablation이 필요하다. frozen 11개 태스크의 1-way acceptance 규칙이 코딩 외 영역에서도 유지될지는 미지수다.

    엔비디아 SoL-Pi vs AWS Strands harness

    비교 대상으로 자주 거론되는 AWS Strands harness는 범용 에이전트를 대상으로 ALFWorld·ContextBench·GAIA·WebShop·τ²-bench·Terminal-Bench 2.1에서 동일 모델 기준 약 28% 낮은 비용을 보고했다. 엔비디아 SoL-Pi는 코딩 에이전트 한정으로 약 33% 비용을 낮췄다. Strands harness 원문에 따르면 도메인 차이 외에 평가셋 구조도 다르다.

    구분 엔비디아 SoL-Pi AWS Strands harness Pi 베이스라인
    대상 도메인 코딩 에이전트 범용 에이전트 코딩 에이전트
    평가셋 EdgeBench 51태스크 ALFWorld·GAIA 등 6종 EdgeBench 51태스크
    API 비용 감소 약 33% 약 28% 기준점
    정확도 유지 약 94% (vs Pi) 동일 모델 baseline 비교 100% (기준점)
    라이선스 MIT 오픈소스 (정책 확인 필요) 원본 Pi 정책

    엔비디아 SoL-Pi는 도메인 특화, Strands는 범용이라는 차이가 크다. 어느 쪽이 더 낫냐보다 에이전트의 주용도에 따라 갈리는 문제다. 에이전트 전반의 비용 효율화 흐름은 에이전트 기반 개발이 PR 70% 처리한다는 보고에서도 다른 조직 사례와 함께 읽힌다.

    지금 바로 해볼 것

    • 기존 Pi 0.85.1 환경에 SoL-Pi를 clone하고 unmodified Pi 그대로 얹어 5개 태스크를 돌려본다.
    • Node.js 버전을 22.19 이상으로 맞추고 토큰 카운트 차이를 사전 측정한다.
    • 엔비디아 SoL-Pi 적용 전후의 평균 토큰/태스크, API 비용/태스크, 통과율을 표로 기록한다.
    • 코딩 외 에이전트 위주라면 AWS Strands harness의 호환성과 라이선스를 별도 확인한다.
    • 4개 메커니즘 중 도구 호출 분기 압축을 우선 검토해 절감 폭을 가늠한다.

    실무 적용 포인트

    기존 Pi 사용자라면 엔비디아 SoL-Pi를 우선 도입 대상에 올려라. unmodified 호환성 때문에 마이그레이션 비용이 거의 없다. 단, 정확도 6% 손실이 허용 가능한 워크로드인지 먼저 가른 뒤 적용 범위를 정해야 한다. 코딩 외 도메인을 주로 다룬다면 Strands harness와 oh-my-pi 등 후보를 함께 평가하고, 라이선스와 벤치마크 재현 가능성을 체크리스트에 넣어라. 평가 모델을 단일 벤더에 묶지 않는 것도 위험 분산의 기본이다.

    자주 묻는 질문

    엔비디아 SoL-Pi는 모델을 다시 학습시킨 건가?

    아니다. 기존 Pi 릴리스 위에 얹는 하네스 레이어다. 별도 학습된 AI가 535개 환경에서 발견한 4개 메커니즘으로 토큰 사용량을 줄였을 뿐, 모델 가중치 자체는 변하지 않는다.

    정확도 6% 손실은 어떤 의미인가?

    GPT-5.6 Sol과 Opus 5에서 Pi의 약 94% 점수를 유지했다는 뜻이다. 코딩 태스크의 통과율 기준이며 40개 held-out 평균이다. 업무 허용 임계값에 따라 도입 판단이 갈린다.

    코딩 에이전트가 아닌 일반 에이전트에도 쓸 수 있나?

    공개된 평가는 EdgeBench 코딩 태스크 한정이다. 범용 에이전트에는 AWS Strands harness나 다른 효율화 레이어를 별도로 평가해야 한다.

    엔비디아 SoL-Pi 도입 시 가장 먼저 확인할 환경 변수는?

    Pi 버전이 0.85.1 이상이고 Node.js가 22.19 이상인지 확인한다. 그 다음 5개 이내 태스크로 토큰 카운트와 통과율을 사전 측정해 회귀 여부를 본다.

    참고 원문

    이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — NVIDIA Introduces SoL-Pi: Auto-Research Loops That Cut Coding Agent Token Traffic by Up to 49%