핵심 요약
- 구글 클라우드는 미국 샌프란시스코에서 ‘제미나이 앳 워크’ 행사를 열고 기업용 ‘제미나이 에이전트’를 공개했으며, 8일부터 일부 고객을 대상으로 비공개 미리보기(Private Preview) 형태로 제공된다.
- 순다르 피차이 구글 CEO는 제미나이의 월간 활성 사용자(MAU)가 10억 명 이상이라고 밝히고, 포춘 100대 기업 중 거의 90%가 업무용으로 제미나이 엔터프라이즈를 사용 중이라고 언급했다.
- 토마스 쿠리안 구글 클라우드 CEO는 에이전트가 ‘단순한 지시사항이 아닌 목표를 부여할 수 있다’고 설명하며, 작업에 적합한 모델 자동 선택과 내장된 비용 제어 기능, 보안·관리·거버넌스 기능을 강조했다.
기업용 AI 경쟁은 더 이상 단일 모델의 성능 경쟁이 아니라, 자사·타사 모델을 자유롭게 섞어 라우팅하고 기업 시스템·보안·비용 통제까지 통합한 ‘멀티모델 에이전트 플랫폼’의 생태계 주도권 싸움으로 이동했다.
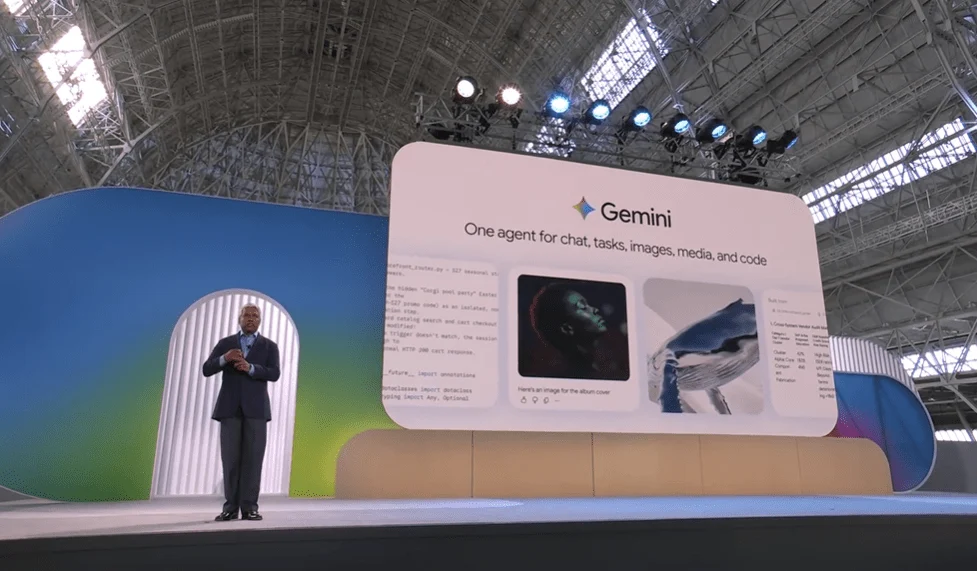
2025년 11월, 구글 클라우드가 샌프란시스코에서 ‘제미나이 앳 워크’ 행사를 열고 기업용 제미나이 에이전트를 공식 공개했다. 8일부터 일부 고객을 대상으로 비공개 미리보기 형태로 제공되며, 기존 제미나이 엔터프라이즈 및 워크스페이스 비즈니스 구독 고객에게는 추가 비용 없이 에이전트 기능이 제공된다.
순다르 피차이 구글 CEO는 “제미나이의 월간 활성 사용자가 10억 명 이상이며, 포춘 100대 기업 중 거의 90%가 업무용으로 제미나이 엔터프라이즈를 사용 중”이라고 강조했고, 토마스 쿠리안 구글 클라우드 CEO는 에이전트를 ‘단순한 지시사항이 아닌 목표를 부여할 수 있는’ 존재로 정의했다. 최대 주목점은 ‘멀티모델’ 전략이다. 자체 모델 ‘제미나이 4 아르곤’과 ‘제미나이 플래시 3.8’에 더해, 경쟁사인 앤트로픽의 ‘클로드 오퍼스 5’와 ‘클로드 소네트 5.5’를 동일 플랫폼 안에서 자유롭게 호출할 수 있도록 개방했다. 지난 30일 제한 출시된 아르곤이 상용 제품에 처음 탑재된 사례이기도 하다.
1장. 영구적 디지털 동료 — @agents.company.com과 에이전트 단위 감사 추적
에이전트의 첫 번째 차별점은 ‘에이전트를 직원처럼 대우한다’는 운영 모델이다. 일반 사용자 계정과 동일한 형태로 에이전트에 전용 이메일(@agents.company.com), 지메일, 구글 캘린더, 드라이브 스토리지를 독립적으로 부여한다.
가장 중요한 변화는 감사 추적 방식이다. 에이전트가 수행한 모든 작업의 로그 주체가 담당자가 아닌 ‘에이전트 이름’으로 남는다. 이는 컴플라이언스·감사 환경에서 책임 소재를 명확히 하고, 에이전트 단위 권한 통제와 사용량 분석을 가능하게 한다. 기업 환경에서 흔히 발생하는 ‘누가 이 결정을 내렸는가’에 대한 책임을 자동화된 행위 주체까지 확장한 셈이다.
2장. 4종 메모리 아키텍처 — 세션·의미·절차·에피소드
전통적인 LLM 기반 챗봇은 매 세션마다 동일한 맥락을 반복 설명해야 하는 한계가 있다. 제미나이 에이전트는 이를 4가지 메모리 체계로 분리했다.
# Gemini Agent - 4-Type Memory Configuration
memory:
  session:
    ttl: "24h"
    scope: "current_task"
  semantic:
    storage: "vertex_ai_vector_search"
    embedding: "text-embedding-005"
    use: "축적된 도메인 지식"
  procedural:
    format: "workflow_yaml"
    source: "사용자 승인 기반 학습"
    use: "학습된 워크플로"
  episodic:
    retention: "90d"
    indexed_by: ["agent_id", "timestamp", "task_type"]
    use: "과거 작업 이력"
세션 메모리는 진행 중인 작업의 단기 컨텍스트를, 의미 메모리는 벡터 검색 기반으로 축적된 도메인 지식을, 절차 메모리는 사용자가 학습시킨 워크플로를, 에피소드 메모리는 과거 작업 이력을 보관한다. 실무에서 ‘프로젝트 컨텍스트를 매번 설명해야 한다’는 엔지니어링 마찰이 사라지는 구조다.
3장. 서브에이전트 팀과 상시 자율 운영
이 에이전트는 클라우드에 상주하며 PC가 꺼져도 며칠에 걸친 작업을 자율적으로 수행한다. 복잡한 임무가 주어지면 단일 에이전트가 임시 ‘서브에이전트(Sub-agent) 팀’을 동적으로 생성해 작업을 분담하고, 종료 후 자원을 회수한다.
{
  "smart_routing": {
    "rules": [
      {"condition": "task.complexity >= 0.8", "model": "gemini-4-argon"},
      {"condition": "task.complexity < 0.4", "model": "gemini-flash-3.8"},
      {"condition": "task.requires_chain_of_thought", "model": "claude-opus-5"}
    ],
    "fallback": "claude-sonnet-5.5",
    "cost_optimization": true
  }
}
이는 에이전트 오케스트레이션의 핵심 패턴인 '동적 멀티에이전트 시스템'이다. 단순한 'AI 비서' 개념을 넘어, 자체적으로 팀을 편성하고 작업을 조율하는 '디지털 조직 단위'로 진화한 모습이다.
4장. 멀티모델 + 스마트 라우팅 전략
구글이 경쟁사 모델을 자사 플랫폼에 들여온 행보는 기업용 AI 시장의 판이 '모델 성능'에서 '오케스트레이션과 거버넌스'로 이동했음을 시사한다. '스마트 라우팅(Smart Routing)'은 작업 난이도에 따라 상위 모델(아르곤·클로드 오퍼스)과 경량 모델(플래시 3.8·클로드 소네트)을 자동 매칭해 성능과 비용을 동시에 최적화한다.
엔지니어링 관점에서 이 접근의 함정은 '모델 호출 추적의 복잡성'이다. 한 프로젝트 안에서 4개 모델이 혼용될 경우, 비용 분석·성능 벤치마크·재현성 확보가 모두 어려워진다. 구글은 이를 '프로젝트 단위 스펜드 캡(Spend Cap)'과 에이전트 게이트웨이 정책 로그로 해결하려 한다.
5장. 보안·비용·운영 통제 — 3계층 방어와 스펜드 캡
자율 에이전트가 기업 데이터에 접근한다는 사실은 곧 새로운 공격 표면을 의미한다. 제미나이 에이전트는 3계층 보안 구조를 적용했다. '에이전트 게이트웨이(Agent Gateway)'는 외부 시스템 호출과 데이터 접근 시점에 조직 정책을 실시간으로 강제하고, '에이전트 샌드박스(Agent Sandbox)'는 격리된 실행 환경에서 동작하도록 경계를 설정한다. '암호화 기반 개별 신원 증명'은 에이전트 단위 신원을 암호화 방식으로 증명해 감사 추적과 권한 통제를 담당자가 아닌 에이전트 단위로 가능하게 한다.
비용 통제 측면에서는 '스펜드 캡'이 자율 에이전트의 예기치 못한 API 호출 폭주로 인한 예산 초과를 차단한다. 데이터 통합 측면에서는 세일즈포스, 스노우플레이크, 빅쿼리 같은 코어 시스템과 모델 컨텍스트 프로토콜(MCP) 서버 연동을 지원하며, 비구조화 데이터는 원본 위치에서 직접 처리하는 '스마트 스토리지'도 제공한다.
6장. 라이선스와 채널 — 무상 제공과 크로스 워크스페이스 호출
기존 제미나이 엔터프라이즈 및 워크스페이스 비즈니스 구독 고객에게는 추가 비용 없이 에이전트 기능이 제공된다. 웹·모바일·데스크톱은 물론 구글 워크스페이스, 마이크로소프트 365, 슬랙, 서비스나우에서 즉시 호출 가능하다. 경쟁사 협업 도구에서도 별도 설정 없이 임베디드 호출이 가능한 멀티테넌트 전략이다.
이는 마이크로소프트가 '코파일럿+오토파일럿'으로 워크스페이스 깊숙이 침투하는 것과 정반대 방향이다. 구글은 '에이전트 호출 지점'을 최대한 넓혀 플랫폼 자체의 선택 가치를 높이려 한다.
7장. 경쟁 구도 분석
현재 업무용 에이전트 플랫폼 시장은 4개 빅테크가 각자의 전략으로 격돌하는 양상이다.
| 플랫폼 |
모델 전략 |
핵심 차별점 |
거버넌스 |
| 구글 제미나이 에이전트 |
멀티모델(아르곤+클로드) |
상시 자율, 4종 메모리, 서브에이전트 |
에이전트 게이트웨이, 스펜드 캡 |
| MS 코파일럿+오토파일럿 |
단일 모델(OpenAI) |
M365 깊숙한 통합 |
Entra ID 기반 정책 |
| OpenAI 닷츠·챗GPT 스페이스 |
자체 모델 |
스페이스 기반 협업 |
관리 콘솔, 사용량 한도 |
| xAI 그록 봇·팀 봇 |
그록 모델 |
X(트위터) 데이터 연동 |
초기 단계, 검증 부족 |
앤트로픽은 '클로드'를 자사 워크스페이스 편집 연동 강화 방향으로, OpenAI는 '챗GPT 스페이스'로 협업 영역을, xAI는 '그록 봇'과 '팀 봇'으로 소셜 데이터 기반 차별화를 시도하고 있다. 그중에서도 '멀티모델 + 상시 자율 + 에이전트 단위 감사'라는 세 축을 동시에 갖춘 플레이어는 현재 구글 뿐이라는 평가가 나온다.
결론 — '모델 대결'에서 '플랫폼 오케스트레이션'으로
기업용 AI 경쟁이 '어떤 모델이 더 똑똑한가'에서 '어떤 플랫폼이 더 유연하게 모델과 시스템을 편성하는가'로 이동했다. 제미나이 에이전트는 자사 '아르곤'과 경쟁사 '클로드'를 같은 화면에서 호출하는 첫 번째 사례다. AI타임스 보도에 따르면, 이는 단순한 모델 입수 전략이 아니라 '오케스트레이션·거버넌스' 중심 시장으로의 전환을 가속하는 신호탄이다. 향후 1년의 관전 포인트는 '멀티모델 라우팅이 실제 비용·성능 양쪽에서 단일 모델 운용보다 우위를 보이는가'와 '에이전트 단위 감사 체계가 컴플라이언스 요건을 충족하는가' 두 가지로 압축된다.
함께 지켜볼 것
- 아르곤·클로드 동시 탑재 이후, '모델 호출 로그 기반의 비용 정산 체계'가 어떤 형태로 공개되는지
- 에이전트 단위 신원 증명과 스펜드 캡이 SOX·ISO 27001 같은 글로벌 컴플라이언스 인증으로 이어지는지
- MS가 '코파일럿+오토파일럿' 라인업에서 멀티모델 옵션을 도입해 시장 판을 다시 흔드는지
- OpenAI의 '챗GPT 스페이스'가 워크스페이스 침투율을 얼마나 끌어올리는지
- xAI '팀 봇'이 X(트위터) 외부 데이터 소스까지 확장하며 '소셜-내장형 에이전트' 시장을 여는지
자주 묻는 질문
제미나이 에이전트는 기존 제미나이 엔터프라이즈와 어떻게 다른가?
기존 제미나이 엔터프라이즈가 단발성 질의응답 중심이었다면, 이 에이전트는 4종 메모리·상시 자율 운영·멀티에이전트 팀 생성 기능을 갖춘 '지속적 작업 주체'다. 동일한 구독에서 추가 비용 없이 제공된다는 점이 가장 큰 차이다.
경쟁사 모델 '클로드'를 구글 플랫폼 안에서 호출할 때 데이터는 안전한가?
에이전트 게이트웨이와 샌드박스, 암호화 기반 신원 증명 계층이 호출 시점에 정책을 강제한다. 다만 실제 데이터 처리 위치와 로그 보관 정책은 추후 공개될 엔터프라이즈 약관을 통해 확인해야 한다.
멀티모델 라우팅이 비용 면에서 정말 이점이 있는가?
상위 모델 호출이 필요한 임무는 전체의 10~30%에 불과하다는 업계 분석이 다수 존재한다. 스마트 라우팅으로 경량 모델이 나머지 작업을 커버하면, 동일 성능 기준 단일 상위 모델 운용 대비 상당 수준의 비용 절감이 가능하다는 내부 시뮬레이션이 구글 측에서 공개됐다.