핵심 요약
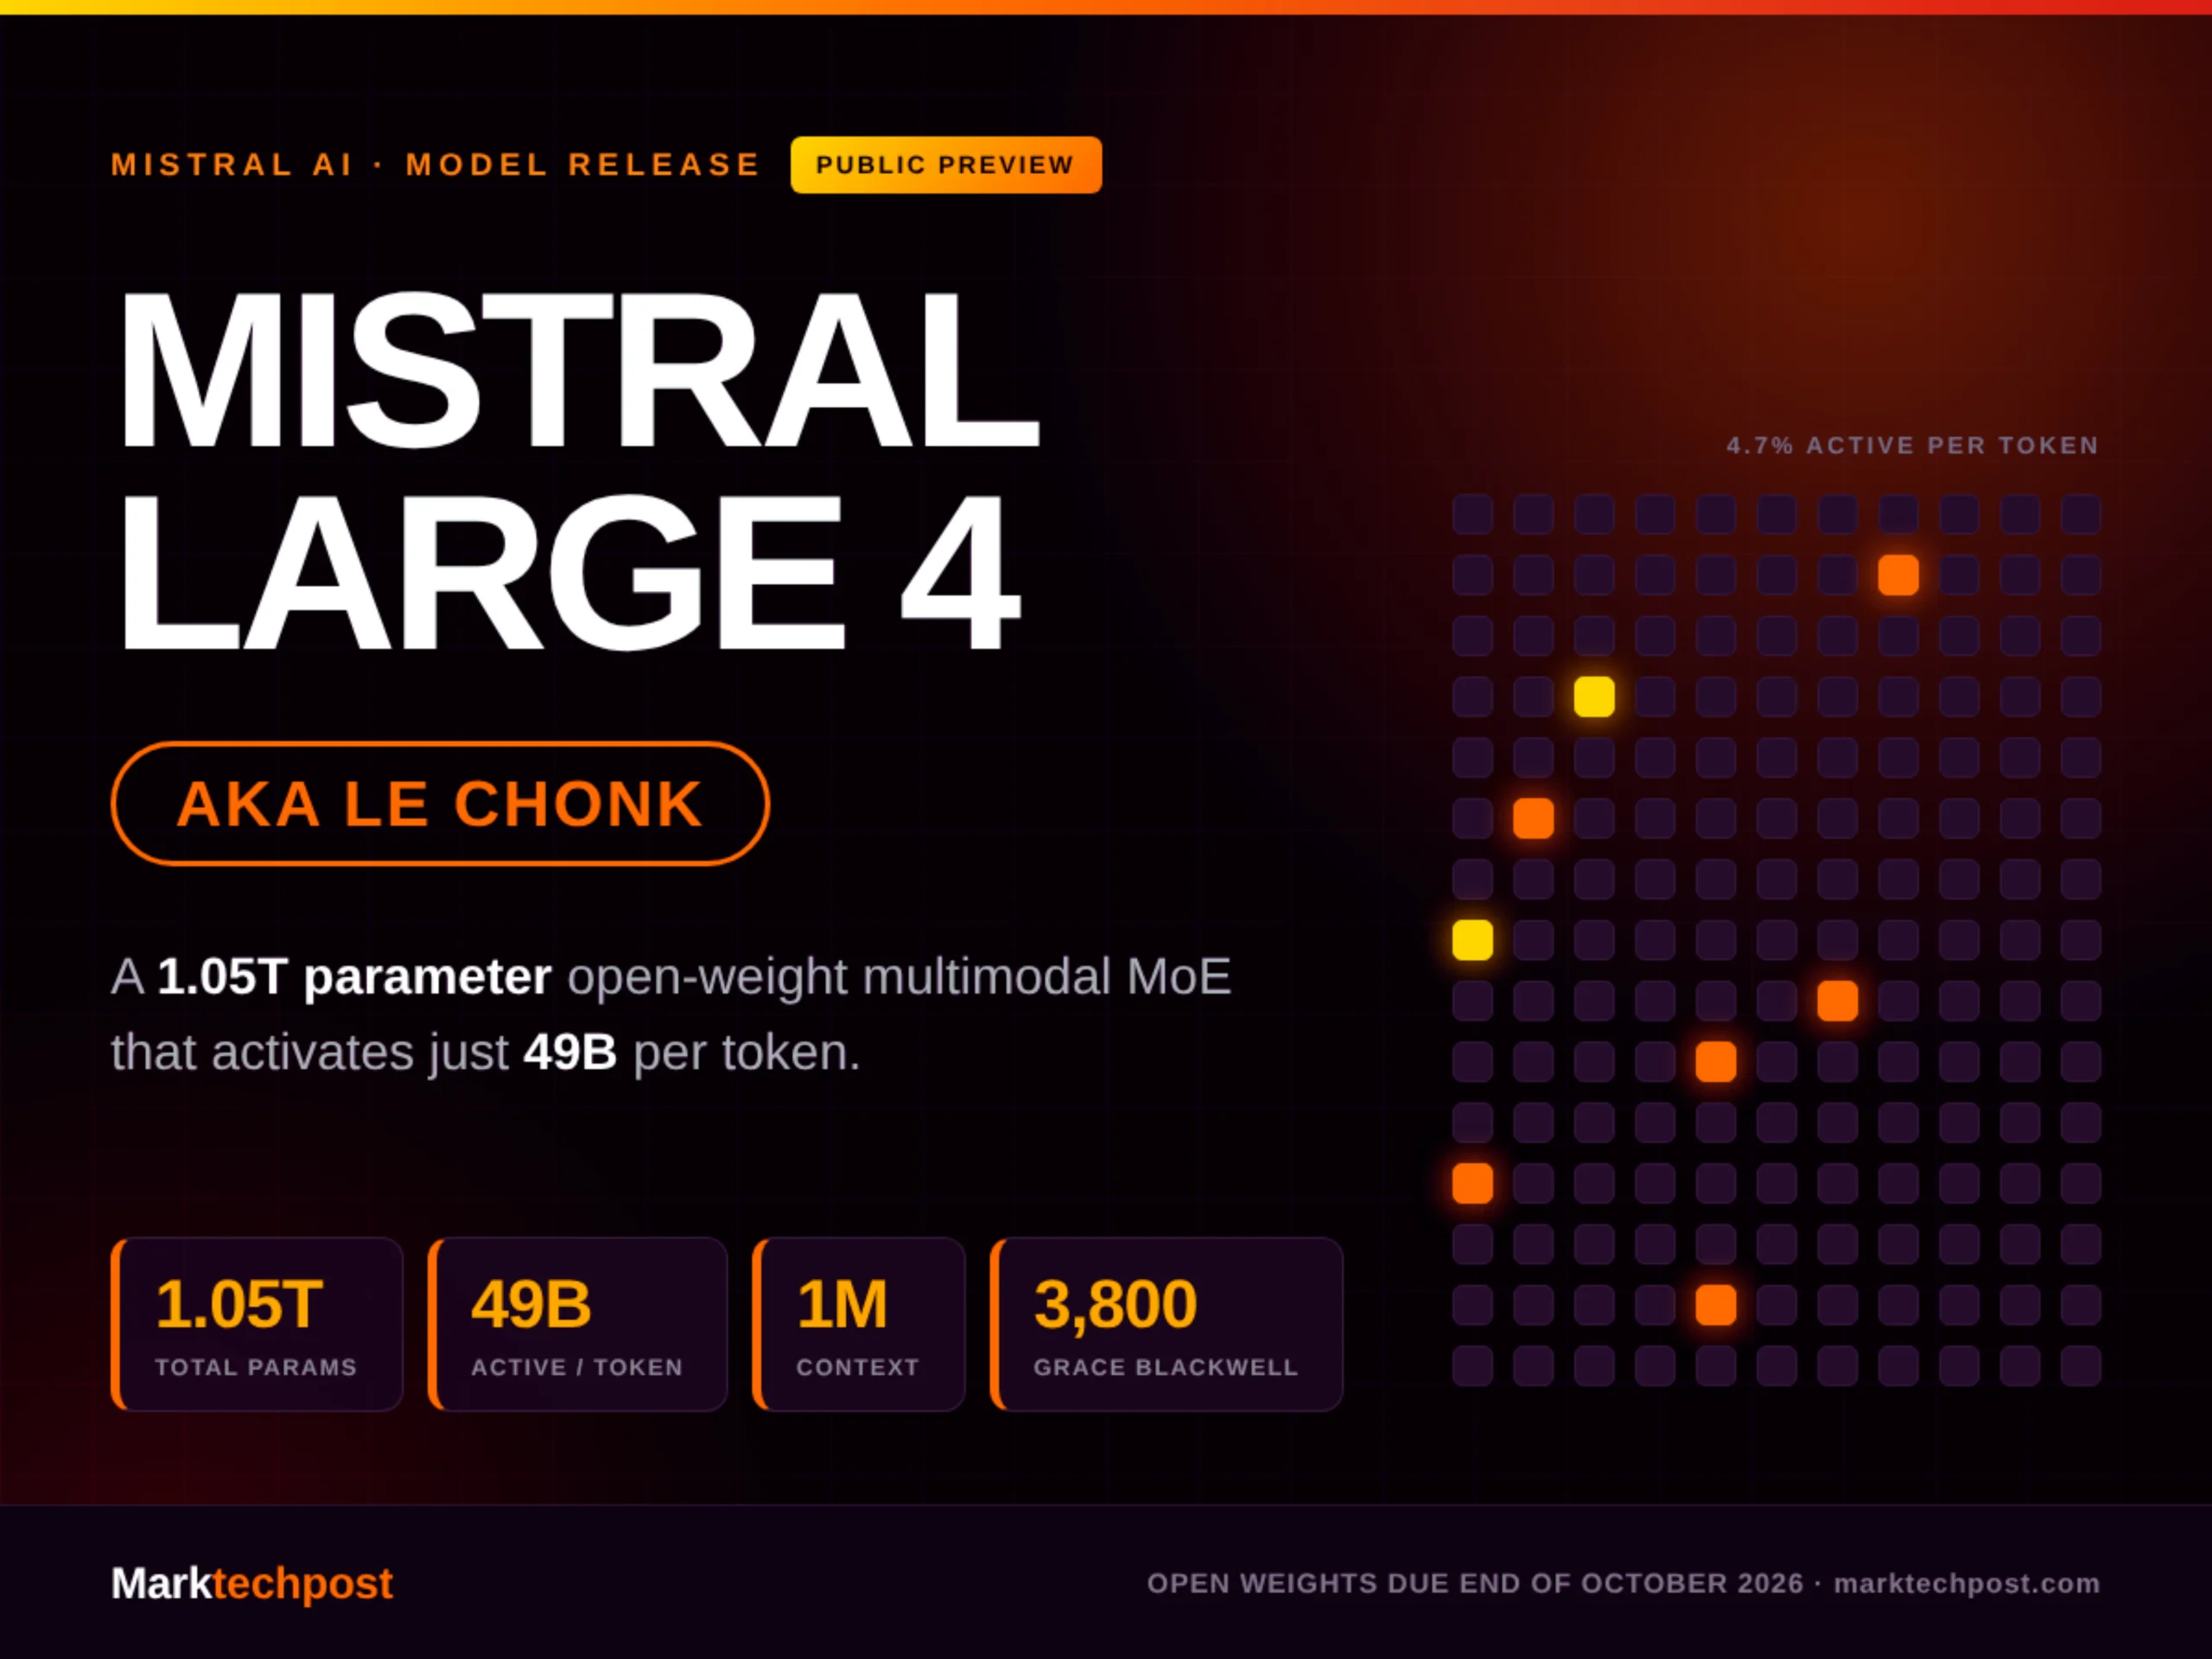
- Mistral AI는 2026년 10월 6일 Mistral Large 4(내부 별명 Le Chonk)를 공개 프리뷰로 출시했으며, 1.05T 총 파라미터와 토큰당 49B 활성 파라미터(전체의 약 4.7%), 1.6B 파라미터 비전 인코더, 1M 토큰 컨텍스트 윈도우를 갖춘 그래뉼러 MoE 모델임
- 학습은 Mistral의 유럽 내 자체 데이터센터에서 3,800개 NVIDIA Grace Blackwell GPU를 사용해 처음부터 진행됐으며 학습 데이터는 160개 이상 언어를 포괄하고 공식 EU 언어를 모두 포함함
- 공개 시점에는 API만 즉시 이용 가능하고 가중치는 2026년 10월 말까지 공개될 예정이라 셀프 호스팅은 불가함. 입력 $1.36, 출력 $4.18, 캐시 입력 $0.14 per 1M 토큰으로 책정됨
Mistral Large 4는 토큰당 4.7%만 활성화하는 그래뉼러 MoE 설계를 통해 1조 파라미터급 모델을 중간 가격대 API로 서비스하는 구조적 해법을 제시했고, 폐쇄형 프론티어 모델들이 task refusal로 사실상 점수가 0에 가까운 사이버보안 작업에서 정당화 가능한 우위를 확보했다는 점에서 실무자에게 의미 있는 선택지가 됨
목차
공개 배경과 한 줄 요약
2026년 10월 6일, Mistral AI는 공개 프리뷰 형태의 새로운 플래그십 모델 미스트랄 라지4(Mistral Large 4, 내부 별명 Le Chonk)를 API로 먼저 노출했다. 총 1.05T 파라미터, 토큰당 49B 활성 파라미터(전체의 약 4.7%), 1.6B 파라미터 비전 인코더, 1M 토큰 컨텍스트 윈도우를 갖춘 그래뉼러 MoE 멀티모달 모델이다. 학습은 유럽 내 Mistral 자체 데이터센터에서 NVIDIA Grace Blackwell GPU 3,800장을 묶어 처음부터 진행됐으며, 학습 데이터는 160개 이상 언어를 포괄하고 EU 공용어를 전부 포함한다.
필자가 현업에서 모델 카드를 읽을 때 가장 먼저 보는 항목이 학습 인프라와 데이터 출처인데, Grace Blackwell 3,800장이라는 스케일은 Mistral이 단순히 프롬프트 엔지니어링용으로 만든 모델이 아니라 1조급 weight를 처음부터 학습한 모델임을 시사한다. 같은 시기에 공개된 올모코어3의 스파스 학습 스택 분석 사례와 나란히 놓으면, 이 모델이 유럽에서 독자적으로 굴릴 수 있는 학습 역량을 갖췄다는 사실 자체가 모델 시장 구조의 변화 신호로 읽힌다.
아키텍처 — 그래뉼러 MoE가 가격을 만드는 방식
이 모델의 핵심은 1.05T라는 거대한 메모리 풀이면서도 토큰당 49B만 활성화해 추론 비용을 중간 티어로 끌어내렸다는 점이다. 일반적인 dense 1T 모델은 모든 파라미터를 매 토큰에 동원하므로 입력 1M 토큰당 단가 책정이 사실상 불가능에 가깝다. 반면 그래뉼러 MoE는 라우터가 토큰별로 소수의 expert를 선택하기 때문에 컴퓨트(49B)와 메모리 점유(1.05T)가 분리된다. Mistral이 입력 $1.36, 출력 $4.18 per 1M 토큰이라는 가격을 공개할 수 있었던 배경이 바로 이 분리 구조다.
다만 전문가 수, top-k 라우팅, 레이어 레이아웃 같은 세부 제원은 가중치 공개(2026년 10월 말 예정) 시점까지 비공개로 유지된다. 운영 관점에서 이 차이는 작아 보이지만, 가중치가 풀려도 라우터 동작과 expert 편중을 독립 검증하려면 라우팅 로그를 별도로 적재해 두는 것이 안전하다. 라우팅 분포가 한쪽 expert로 몰리는 현상은 throughput은 정상으로 보이는데 특정 expert의 응답만 품질이 들쭉날쭉해지는 형태로 나타나기 쉽고, 사후 디버깅 비용이 매우 비싸다.
비전 인코더는 1.6B 파라미터로 분리돼 네이티브 이미지 입력을 받는다. 별도 멀티모달 어댑터를 붙이지 않고도 텍스트·이미지를 단일 모델이 처리하기 때문에 RAG 파이프라인에서 OCR 단계를 거치지 않고 문서 QnA를 구성할 수 있다. 다만 비전 토큰이 컨텍스트 1M 안에 함께 잡히는지, 아니면 별도 슬라이스가 있는지는 모델 카드 본문으로 확인이 필요하다(공개된 자료만으로는 단정하기 어렵다).
API 가격과 즉시 사용 가능 범위
공개 시점 API 가격은 입력 $1.36, 출력 $4.18, 캐시 입력 $0.14 per 1M 토큰이다. 1M 컨텍스트 풀 윈도우를 매 호출마다 새로 결제하지 않고 캐시된 prefix를 $0.14/1M로 재사용할 수 있다는 점은 에이전트 루프에서 단가를 결정적으로 낮춘다. 매 턴마다 800K 토큰짜리 코드베이스와 대화 이력을 함께 넘기는 코딩 에이전트는 캐시 가격이 전체 비용의 70% 이상을 좌우하기 때문이다.
API 스펙은 함수 호출, 구조화 출력(JSON Schema 강제), 문서 QnA, 배치 처리, 그리고 Agents·Conversations 엔드포인트를 한 API 키로 묶어서 제공한다. 즉시 가능한 통합 흐름은 다음과 같다.
curl -s https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {"role":"system","content":"You are a SOC analyst."},
      {"role":"user","content":"Summarize the last 24h of alerts."}
    ],
    "tools": [{"type":"function","function":{
      "name":"open_ticket",
      "parameters":{"type":"object","properties":{
        "severity":{"type":"string","enum":["low","med","high","crit"]},
        "cve":{"type":"string"}},
        "required":["severity"]}}}],
    "response_format":{"type":"json_schema","json_schema":{"name":"alert","schema":{...}}}
  }'
위 호출에서 response_format으로 JSON Schema를 강제하면 파이프라인 다운스트림에서 Pydantic 모델로 바로 검증할 수 있어, 후속 Airflow/Dagster 태스크로 그대로 흘려보내기 좋다. 다만 셀프 호스팅은 10월 말 가중치 공개 전까지 막혀 있으므로 API 종속성을 처음부터 인정하고 리전별 failover 경로를 확보해 두는 편이 운영상 안전하다.
사이버보안 성능과 폐쇄형 모델의 task refusal
Cybench 93%, CyberGym-E2E 82%를 기록해 Artificial Analysis Cyber Index 글로벌 톱5에 진입했다. Mistral은 이 결과를 근거로 일부 폐쇄형 프론티어 모델들이 exploit PoC나 권한 상승 코드를 생성해 달라는 요청에서 task refusal로 점수가 사실상 0에 가깝다고 명시했다. 실무에서 가장 흔히 놓치는 함정은, 보안 자동화 에이전트에서 LLM이 정당한 payload 생성을 거절하면 그 뒤 단계인 exploit 검증, 로그 분석, IOC 추출까지 연쇄적으로 멈춘다는 점이다.
운영 환경에서 이 갭이 체감되는 지점은 멀웨어 샌드박스 자동 트리아지다. Cuckoo Sandbox 결과를 받아 디코딩된 페이로드를 요약하고 YARA 룰 후보를 뽑는 워크플로우에서 모델이 응답을 거부하면 룰 생성 단계가 비어 버려 결국 사람이 직접 룰을 짜게 된다. 정당한 분석 결과를 거부 없이 제공할 수 있다는 점은 SOC 운영 비용에 직접 영향을 준다. 다만 가중치 공개 전까지는 동일 시나리오에서 API 모드와 셀프 호스팅 모드의 출력 차이가 존재할 수 있으므로, 보안 정책상 폐쇄망 배포가 필수인 조직은 가중치 공개 일정을 검토 체크포인트에 박아 두는 것이 좋다.
코딩·일반 품질과 재현성 이슈
에이전틱 코딩 벤치마크에서 DeepSWE v1.1 61.7%, SWE-Atlas-QnA 59.4%, Terminal-Bench 4.0 28.3%를 기록했고, 이를 묶은 Artificial Analysis Coding Agent Index는 49.8%다. Surge AI 블라인드 인간 평가에서는 5점 만점에 3.74로 5개 모델 중 2위를 차지해 Claude Opus 5(4.22) 뒤, GLM-5.3(3.60)과 Kimi K3(3.59) 앞선 위치를 보였다. 코딩 에이전트 하네스 측면에서 같은 매체에서 다룬 엔비디아 SoL-Pi 하네스 4종 정밀 해부와 비교하면, 이 모델이 하네스 단에서 토큰을 절약하기보다 모델 자체의 코드 이해 능력에 방점을 두고 있음을 짐작할 수 있다. 반대로 말하면 코딩 에이전트 토큰비를 우선시하는 팀이라면 모델 선택 이전에 하네스 최적화를 먼저 보는 편이 효과적일 수 있다.
| 벤치마크 | 미스트랄 라지4(Le Chonk) | 작업 유형 |
|---|---|---|
| Cybench | 93% | 사이버보안 에이전트 |
| CyberGym-E2E | 82% | 취약점 분석 end-to-end |
| DeepSWE v1.1 | 61.7% | 에이전틱 코딩 |
| SWE-Atlas-QnA | 59.4% | 저장소 QnA |
| Terminal-Bench 4.0 | 28.3% | 터미널 작업 |
| Surge AI 블라인드 | 3.74 / 5 | 5개 모델 중 2위 |
| Lakera B3 | 93.3% | 프롬프트 인젝션 저항 |
다만 모든 수치는 사전 비공개 평가로 수집된 것이며 독립 재현은 가중치 공개 이후에나 가능하다는 점을 명심해야 한다. 운영팀이 벤치마크 수치만 보고 도구를 교체했다가 내부 레퍼런스 셋에서 다른 결과가 나오는 일은 흔하다. 첫 2주 동안은 기존 모델과 A/B 라우팅을 켜 두고 미스트랄 라지4 호출 비율을 점진적으로 끌어올리는 방어적 도입이 안전하다.
안전성 지표와 비교군
안전성 측면에서 Lakera B3 벤치마크에 93.3% 저항률을 기록했고, KORABench는 1.691 / 2.0을 받았다. 프롬프트 인젝션 저항률은 폐쇄형 프론티어 모델들과 비슷한 수준으로, 도구 호출형 에이전트에서 외부 페이로드가 섞이는 시나리오에 그대로 투입해도 1차 방어선 역할은 할 수 있다는 의미다. 다만 Lakera B3는 단일 벤치마크이므로, 운영 환경에서는 사내 RAG 데이터셋에서 별도의 인젝션 회귀 테스트를 돌려 보는 편이 신뢰도를 크게 올린다.
아직 공개되지 않은 정보와 후속 일정
전문가 수, top-k 라우팅, 레이어 레이아웃은 가중치 공개 시점에 풀릴 예정이다. 10월 말 공개 직후 커뮤니티에서 라우팅 편중, expert dropout, fine-tuning 안정성 등이 빠르게 보고될 가능성이 크고, 그 결과에 따라 셀프 호스팅 TCO가 결정된다. 1M 컨텍스트를 그대로 쓰는 대신 슬라이딩 윈도우나 hierarchical compression을 함께 적용할지, 캐시 prefix 만료 정책을 어떻게 둘지도 같은 시점에 정해 두는 것이 합리적이다. 미스트랄 라지4는 가격·성능·거부 정책 세 축에서 동시에 옵션을 넓혔고, 도입 여부의 결정은 이 세 축의 가중치를 조직이 어디에 두느냐에 따라 갈린다.
지금 바로 해볼 것
- Mistral 대시보드에서 API 키를 발급하고
curl로response_format을 강제하는 문서 QnA 호출을 1회 돌려 토큰 단가를 측정한다. - 기존 SOC 페이로드 생성 워크로드 50건을 추출해 동일 프롬프트로 모델 응답 거부율을 카운트한다.
- Airflow/Dagster에 모델 응답을 Pydantic으로 검증하는 태스크를 추가해 JSON Schema 강제 호출과 레거시 자유 출력 호출의 다운스트림 실패율을 비교한다.
- 1M 컨텍스트 + 캐시 prefix 조합의 비용 시뮬레이션을 사내 가격표에 반영하고, 동일 입력 기준으로 기존 모델과 미스트랄 라지4의 1만 회 호출 단가를 역산한다.
- 가중치 공개(10월 말) 일정에 맞춰 폐쇄망 PoC 슬롯을 예약하고, 라우팅 로그 적재와 expert 편중 모니터링 템플릿을 미리 작성한다.
자주 묻는 질문
가중치 공개 전이라도 사내 평가용으로 도입해도 되나?
API 종속성을 수용할 수 있는 워크로드라면 즉시 도입해도 무방하다. 다만 평가 단계에서 API와 셀프 호스팅의 응답 편차가 생길 수 있으므로, 1차 도입 후 두 번째 스프린트에서 가중치 공개 일정과 함께 내부 회귀 테스트를 다시 돌려야 한다.
사이버보안 워크로드의 refusal이 줄면 책임 소재는 어떻게 되나?
모델이 거부해서 사고를 막아 주는 영역과, 거부 없이 응답해서 분석 파이프라인이 굴러가는 영역의 경계가 분명해진다. 운영팀은 refusal이 줄었을 때의 secondary safety net(예: Trivy로 생성 YARA 룰 정적 검증, Semgrep 룰로 PoC 코드 정적 스캔)을 명시적으로 설계해 두는 것이 안전하다.
1M 컨텍스트 호출이 실패하면 비용이 어떻게 청구되나?
공식 가격표상 캐시 prefix를 활용한 호출은 $0.14/1M로 청구되고, 컨텍스트 처리 실패는 일반 입력 단가($1.36/1M)로 정산된다. 트래픽 폭주 시 fail-open 정책이 적용될 수 있으므로, 비용 알람은 캐시 적중률과 실패율을 분리해서 걸어 두는 편이 운영상 안전하다.
참조: MarkTechPost의 Mistral Large 4 (Le Chonk) 출시 보도
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Mistral AI Releases Mistral Large 4 (Le Chonk): A 1.05T Parameter Multimodal MoE Model