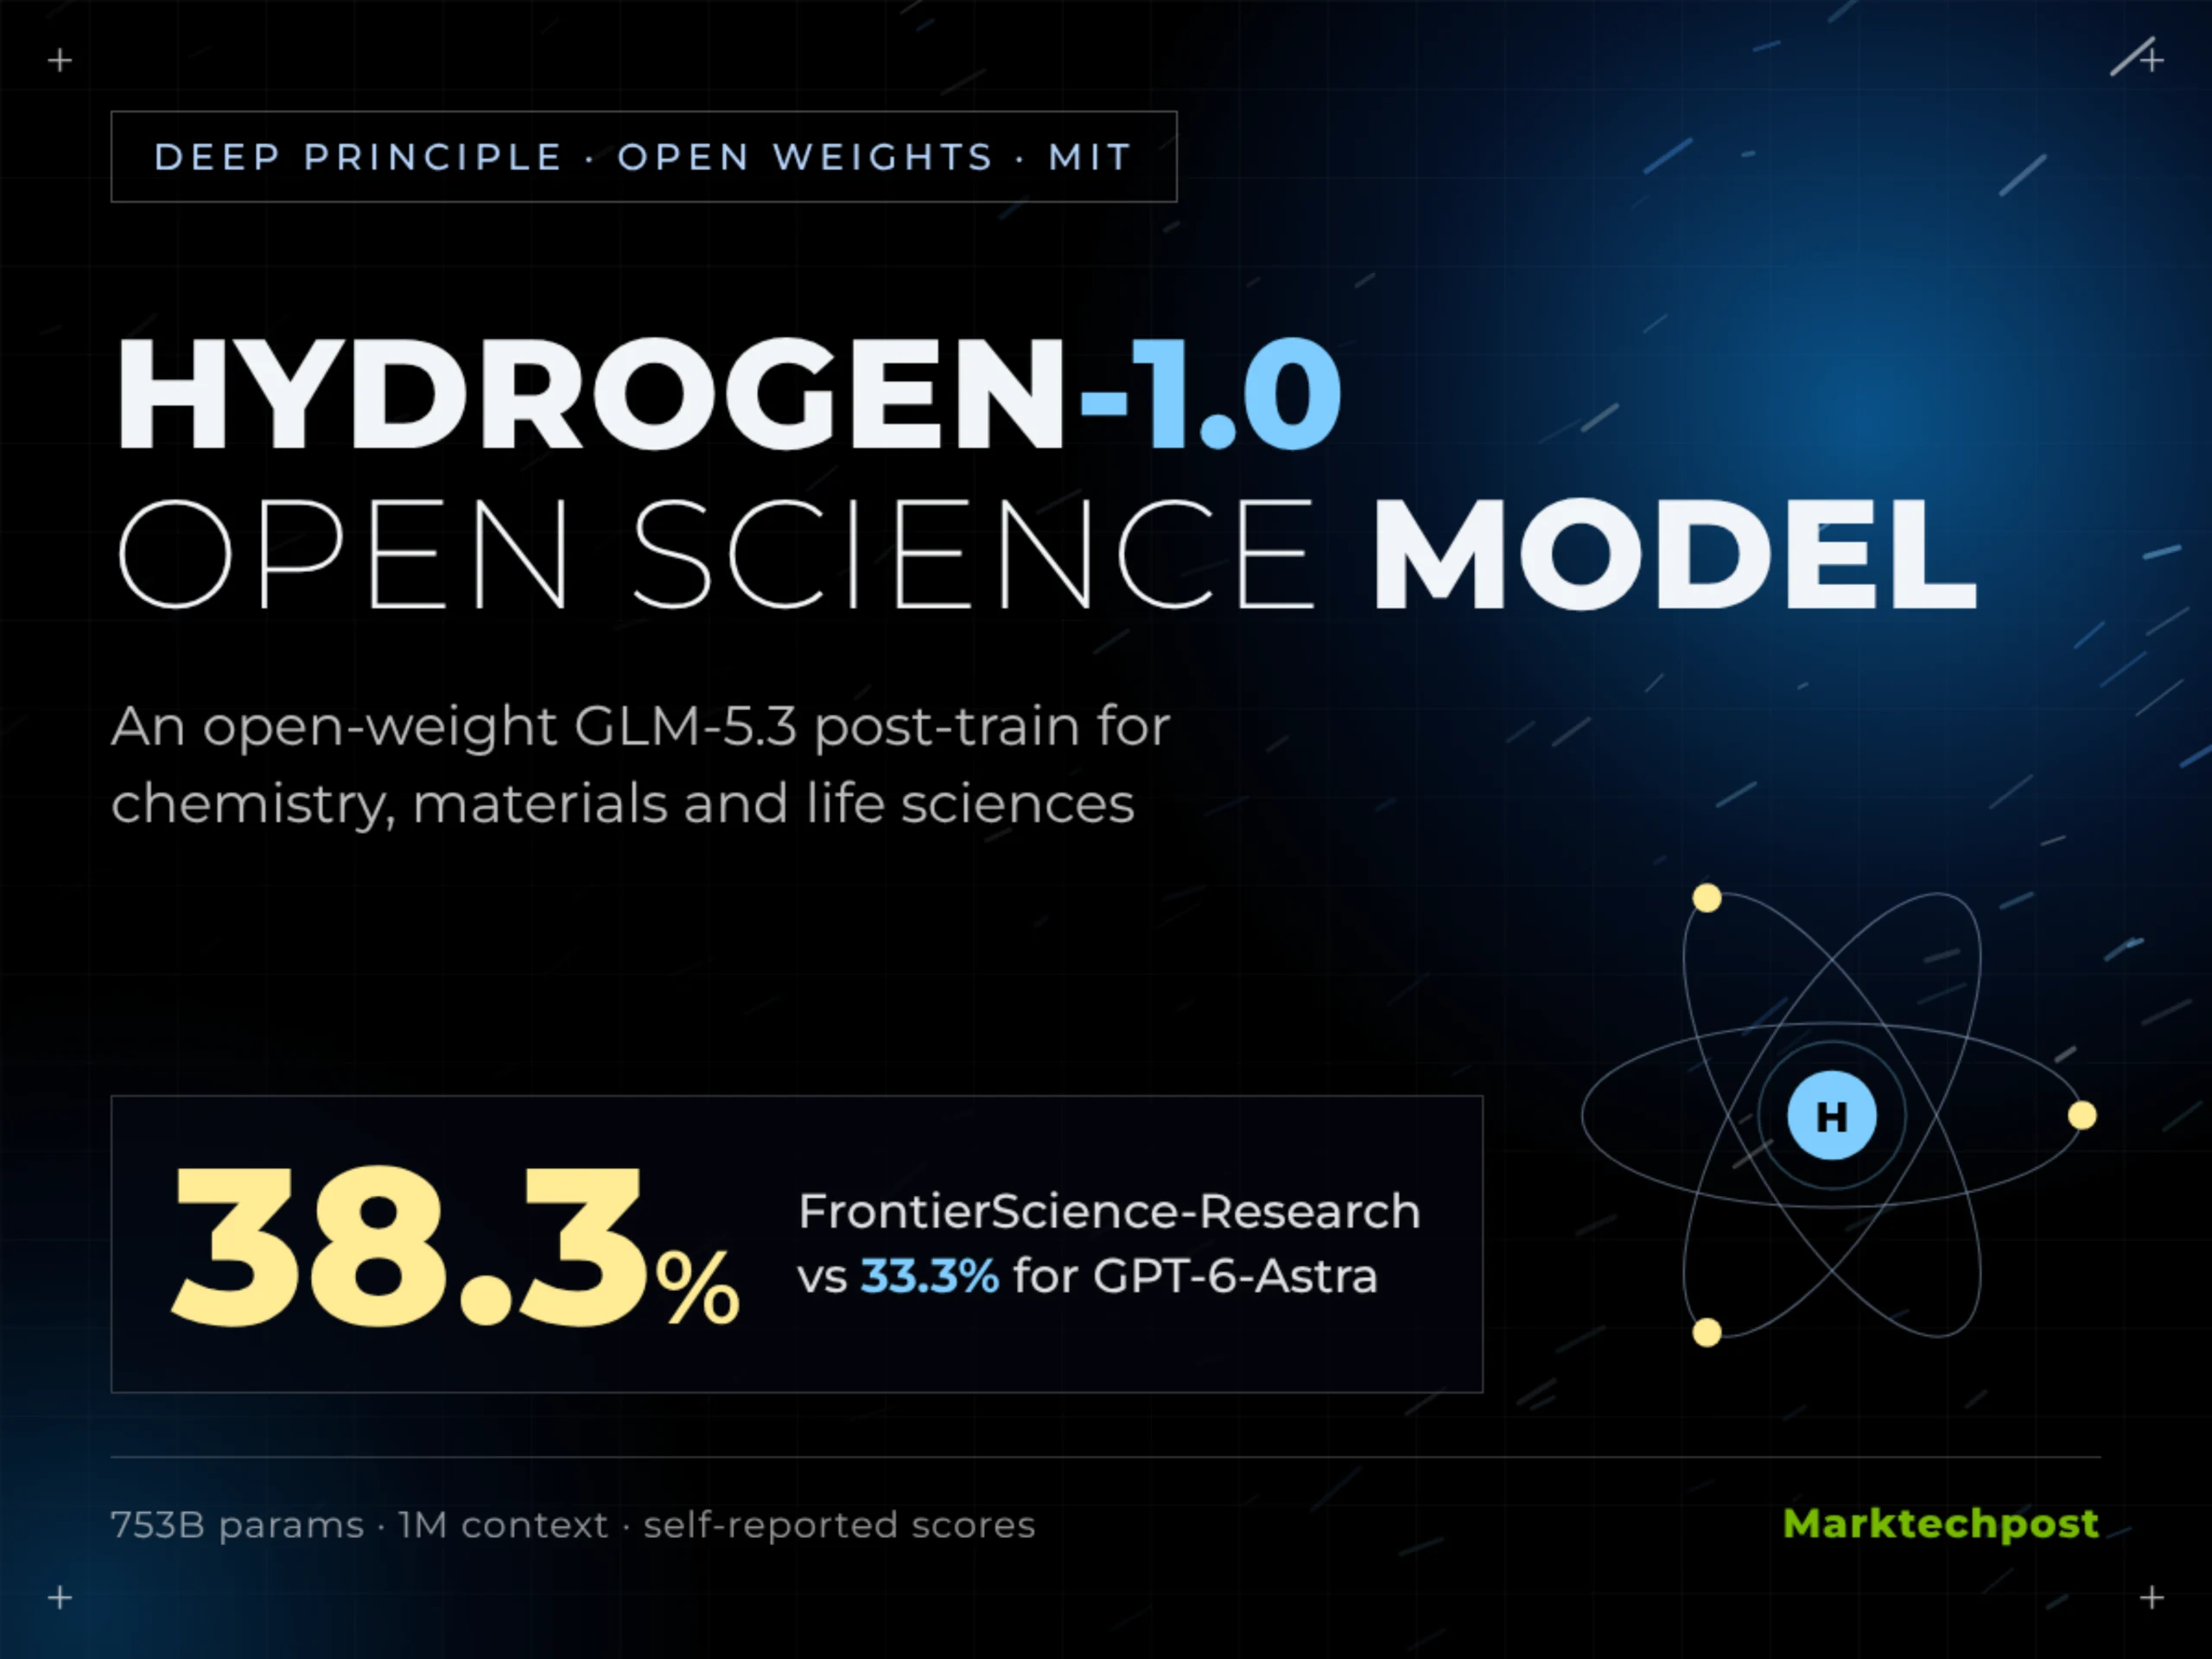
Deep Principle가 화학·소재과학·생명과학을 위한 과학 오픈 모델 Hydrogen-1.0을 공개했다. GLM-5.3을 기반 모델로 삼아 일반적인 논문 질의뿐 아니라 실험 설계와 결과 분석까지 겨냥했으며, 가중치는 MIT License로 배포됐다. Deep Principle는 자체 평가에서 FrontierScience-Research 성적을 GPT-6-Astra보다 높게 기록했다고 보고했지만, 전체 데이터와 학습 레시피가 공개되지 않아 제시된 수치를 독립적으로 재현할 수 없는 상태다.
논문 문답을 넘어선 과학 탐색 모델
Hydrogen-1.0은 Z.ai의 GLM-5.3을 후학습한 753B 파라미터 MoE 모델이며, 활성 파라미터는 약 40B다. 컨텍스트는 1M 토큰, 최대 출력은 128K 토큰으로 소개됐다. 활용 범위는 질문 설정, 실험 계획, 결과 분석과 개방형 탐색으로 제시됐다.
모델은 과학자 과업 피드백, Mira로 수집한 전자 실험 노트, 성공과 실패를 포함한 발견 궤적을 학습 데이터에 활용했다. 학습에는 supervised fine-tuning과 reinforcement learning이 결합됐고, 분산 환경은 NVIDIA CUDA와 AMD ROCm을 지원하는 Megatron 및 SGLang 기반이다. Muon optimizer state는 백엔드에 따라 CPU·GPU·디스크 사이에서 이동하며, RL rollout은 재개 가능하도록 구성됐다. Layout adapter는 학습 체크포인트를 BF16과 128×128 blockwise FP8 추론 가중치로 변환한다.
자체 평가 성적과 과제별 격차
Deep Principle가 공개한 내부 연구 과제 평가에서 Hydrogen-1.0은 과학 연산에서 GPT-6-Astra보다 5.13%포인트, 정반응 예측에서 4.76%포인트 앞섰다. 반면 NMR 구조 elucidate에서는 GPT-6-Astra가 3.33%포인트 높은 성적을 냈다. 즉, 성능 우위를 모든 과학 영역으로 확대해 해석하기보다는 과제별 결과를 분리해 확인해야 한다.
| 평가 과제 | Hydrogen-1.0 | 비교 결과 |
|---|---|---|
| FrontierScience-Research | 38.3% | GPT-6-Astra 33.3%보다 높음 |
| GPQA-Diamond | 93.0% | Kimi-K3와 대체로 비슷한 수준 |
| 과학 연산 | 차이 기준 | GPT-6-Astra보다 5.13%포인트 높음 |
| 정반응 예측 | 차이 기준 | GPT-6-Astra보다 4.76%포인트 높음 |
| NMR 구조 elucidate | 차이 기준 | GPT-6-Astra보다 3.33%포인트 낮음 |
전이 금속 착체 설계에서는 모델들이 5라운드에 걸쳐 더 큰 HOMO-LUMO 간격을 추적했다. 5라운드에서 Hydrogen-1.0의 평균 최적 간격은 4.318 eV, GPT-6-Astra는 3.689 eV, Kimi-K3는 3.353 eV였다. 실험 계획 문항 117개에서는 Hydrogen-1.0이 Kimi-K3보다 높은 점수를 받았지만, GPT-6-Astra와 Opus-5.5는 요청 절반 이상을 거부해 비교에서 제외됐다. 해당 성적은 Deep Principle의 자체 보고이므로 동일 조건의 독립 검증이 함께 필요하다.
실험실 자동화 데모가 드러낸 가능성과 위험
공개된 기술 자료에는 모델이 실제 연구 흐름에 결합되는 과정이 담겨 있다. Hydrogen-1.0은 Python 코드와 GROMACS를 이용해 폴리에틸렌 용융체를 구성하고, topology 오류를 찾아 수정했으며, 보정된 40 ns 궤적을 분석했다. Ireland-Claisen 반응에서는 30개의 반응 후보를 통해 27개 구조의 반응 네트워크를 생성했고, 2-bromonaphthalene의 1H NMR trace에서는 단일 formylation 생성 후보 7개를 정렬했다. Suzuki 결합 연구에는 12개 바이알을 다루는 JSON 프로토콜을 작성했으며, 실행 전 aspirate 작업에서 새 팁이 없는 사례를 가상 실험실 검증 단계가 잡아냈다.
이런 데모는 과학 오픈 모델의 강점이 답변 정확도를 넘어 실행 가능한 작업 절차와 중간 검증에 있다는 점을 보여준다. 다만 프로토콜 작성, 시약 안전, 분석 결과의 물리적 타당성은 서로 다른 검증 문제이며, 모델이 절차를 생성했다는 사실만으로 실제 실험의 신뢰성이 보장되지는 않는다. 실패한 시도를 포함한 탐색 기록을 학습에 넣었다는 점도, 편향된 성공 사례만 학습하는 방식과 구별해 평가할 필요가 있다.
오픈 배포와 실제 도입 사이의 검증 구간
가중치는 Hugging Face와 ModelScope에 공개됐고, Deep Principle는 SGLang에서 8개 GPU와 tensor parallelism 8을 적용한 BF16 서빙을 시험했다. NVIDIA B200·B300에는 NVFP4, AMD Instinct MI350X·MI355X에는 MXFP4 구성이 제시됐다. 서버는 OpenAI 호환 API를 제공하며 reasoning_effort 설정도 노출한다. NeuroSpark 기준 API 가격은 공개되지 않았다. Deep Principle의 Hydrogen-1.0 공개 자료를 통해 공개 범위와 배포 조건을 확인할 수 있다.
실제 도입 전에는 자체 평가의 재현 여부, 조직의 실제 연구 데이터에서의 정확도, 코드 실행과 합성·분석 오류율, 장기 탐색 과정의 안정성을 별도로 확인해야 한다. 753B MoE 구조와 8 GPU 서빙 조건은 운영 자원에도 부담을 줄 수 있으며, NeuroSpark 가격처럼 아직 제시되지 않은 비용 정보는 도입 계획에 빈칸으로 남는다. 오픈 웨이트와 MIT License는 모델의 내부 동작과 가중치를 직접 검토할 수 있는 기반을 제공하지만, 비공개 학습 데이터가 만드는 검증 공백까지 해소하지는 않는다.
참고 원문
이 기사는 다음 원문을 확인해 작성했습니다: MarkTechPost — Deep Principle Releases Hydrogen-1.0: A 753B Open-Weight Model for Scientific Discovery